Среда исполнения JavaScript в браузере по стандарту HTML: агенты, event loop, task'и и микрозадачи
Это продолжение статьи «Модель исполнения JavaScript по спецификации ECMAScript: call stack, контексты, окружения и замыкания». Если ты её не читал, лучше начать с неё: агент, Realm Record, execution context, execution context stack и Job здесь заново не объясняются.
Обычно браузер представляют так: у каждой вкладки свой поток и свой event loop, а промис срабатывает раньше таймера, потому что микрозадачи приоритетнее макрозадач. На практике этого хватает, но в стандарте HTML всё устроено иначе. Вот три примера:
Зависшая вкладка может подвесить соседнюю, например ту, которая открыла её через
window.open().Один и тот же код может выдать разный порядок вывода, и всё зависит от того, кто его вызвал.
Слова «макрозадача», которое звучит на каждом собеседовании, в стандарте нет: то, что им называют, - просто обычная task.
В стандарте ECMAScript ответов нет. Прошлая статья закончилась на границе: синхронная модель обрывается на пустом стеке, дальше начинаются Job’ы. А кто и когда их запускает, кто создаёт агента и откуда берётся realm, ECMA-262 оставляет хосту. В браузере всё это описывает HTML Standard (дальше просто HTML). Это стандарт WHATWG, по которому браузеры реализуют веб-платформу. Его мы сегодня и разберём: в основном раздел Scripting, но заглянем и в соседние.
Карта статьи:
Агенты в браузере - кто их создаёт и сколько их на самом деле.
Environment settings object - браузерная половина realm’а.
Event loop - одна итерация цикла: task, task queue, microtask queue и checkpoint.
Макротаски и микротаски: почему промисы раньше таймера.
Hooks - куда попадает каждый Job.
Spin и pause - где хост сам ломает правила.
Агенты в браузере
В прошлой статье агент был абстракцией: ECMA-262 говорит, из чего он состоит, но не говорит, откуда он берётся. HTML описывает его как «архитектурно-независимый идеализированный поток», в котором бежит JS. Звучит абстрактно, но этот поток легко повесить. Две страницы одного сайта:
<!-- b.html -->
<script>
  setTimeout(() => { while (true) {} }, 1000); // через секунду вешаем страницу
</script>
// a.html
button.onclick = () => window.open('/b.html');
// через секунду после клика перестанет отвечать не только новая вкладка, но и эта
А если открыть ту же страницу с noopener - window.open('/b.html', '', 'noopener'), - обычно повиснет только новая вкладка. Код тот же, страницы те же, а результат разный.
Разберём по порядку: что создаётся, кто и когда это делает, какие агенты получаются, куда их кладут и сколько их в итоге. К концу раздела станет ясно, почему повисли обе вкладки.
Создание агента
Создаёт агента короткий алгоритм create an agent. Он принимает один параметр, canBlock, и делает пять шагов:
завести новый уникальный [[Signifier]];
завести [[CandidateExecution]] для модели памяти;
выставить [[CanBlock]] из параметра;
привязать к агенту новый event loop;
вернуть агента.
Первые три шага заполняют часть полей Agent Record из прошлой статьи. А четвёртый добавляет уже HTML: поля для event loop в Agent Record нет, поэтому HTML просто привязывает цикл к агенту: «у каждого агента есть связанный event loop, уникальный для этого агента».
Кто вызывает этот алгоритм? Напрямую из JS его не вызвать: агента создаёт сам браузер - и только тогда, когда ему нужен новый глобальный объект.
Когда браузеру нужен новый глобальный объект
новая вкладка,
<iframe>,window.open()- начальныйabout:blank, ещё до загрузки чего-либо;навигация: пришёл ответ, создаётся новый
Document;new Worker()илиnew SharedWorker(), если такого shared worker’а ещё нет;создание глобального scope worklet’а;
запуск service worker’а (сам запуск описан уже в спецификации Service Workers).
Всего HTML определяет пять типов агентов. Поля «тип» у агента при этом нет ни в Agent Record, ни в HTML: тип определяется тем, какой глобальный объект живёт внутри.
Агент | Его глобальные объекты | Где исполняется код |
|---|---|---|
Similar-origin window agent (оконный агент) |
| страница во вкладке или iframe |
Dedicated worker agent |
| worker, созданный через |
Shared worker agent |
| один worker, к которому подключаются несколько страниц ( |
Service worker agent |
| посредник между страницами и сетью; описан в спецификации Service Workers |
Worklet agent |
| код, который браузер вызывает сам: отрисовка (CSS Paint), звук (AudioWorklet) |
Кроме глобального объекта, типы различаются ещё одним: можно ли агенту блокироваться. Это тот самый [[CanBlock]] из третьего шага create an agent: блокироваться разрешено только dedicated и shared worker’ам, у остальных трёх типов он равен false.
Что общего у глобальных объектов
Глобальные объекты складываются в три семейства - window, worker и worklet, и внутри семейств у них много общего:
у трёх worker’ов одна база,
WorkerGlobalScope:self,location,navigator,importScripts(). Объектаdocumentу них нет;таймеры (
setTimeout,setInterval),queueMicrotask,structuredCloneи ещё несколько методов есть у window и у всех worker’ов, а у worklet’ов их нет;у каждого есть и своё: у
Window-document,history,alertи всё про страницу; у dedicated worker’а -postMessage()для связи с создателем иrequestAnimationFrame; у shared worker’а - событиеconnect, через которое каждая страница получает свой порт; у service worker’а - события вродеfetch. А уWorkletGlobalScopeв HTML своего API нет: его добавляют спецификации конкретных worklet’ов.
Кластеры: куда агента кладут
Тип агента решает не только, что он умеет, но и с кем окажется рядом. Каждый созданный агент сразу попадает в agent cluster. HTML называет кластер «идеализированной границей процесса», и главный практический смысл у него такой: внутри кластера агенты могут делить память через SharedArrayBuffer, между кластерами - нет.
Какой кластер достанется агенту, зависит от его типа:
dedicated worker и worklet - кластер того, кто их создал;
shared и service worker - новый собственный кластер;
similar-origin window - кластер, найденный по ключу.
Кластеры из спецификации обычно строже настоящих процессов браузера. Как браузер раскидывает вкладки по процессам - его дело. Стандарт фиксирует только ту границу, которую видит код.
Как window получает агента
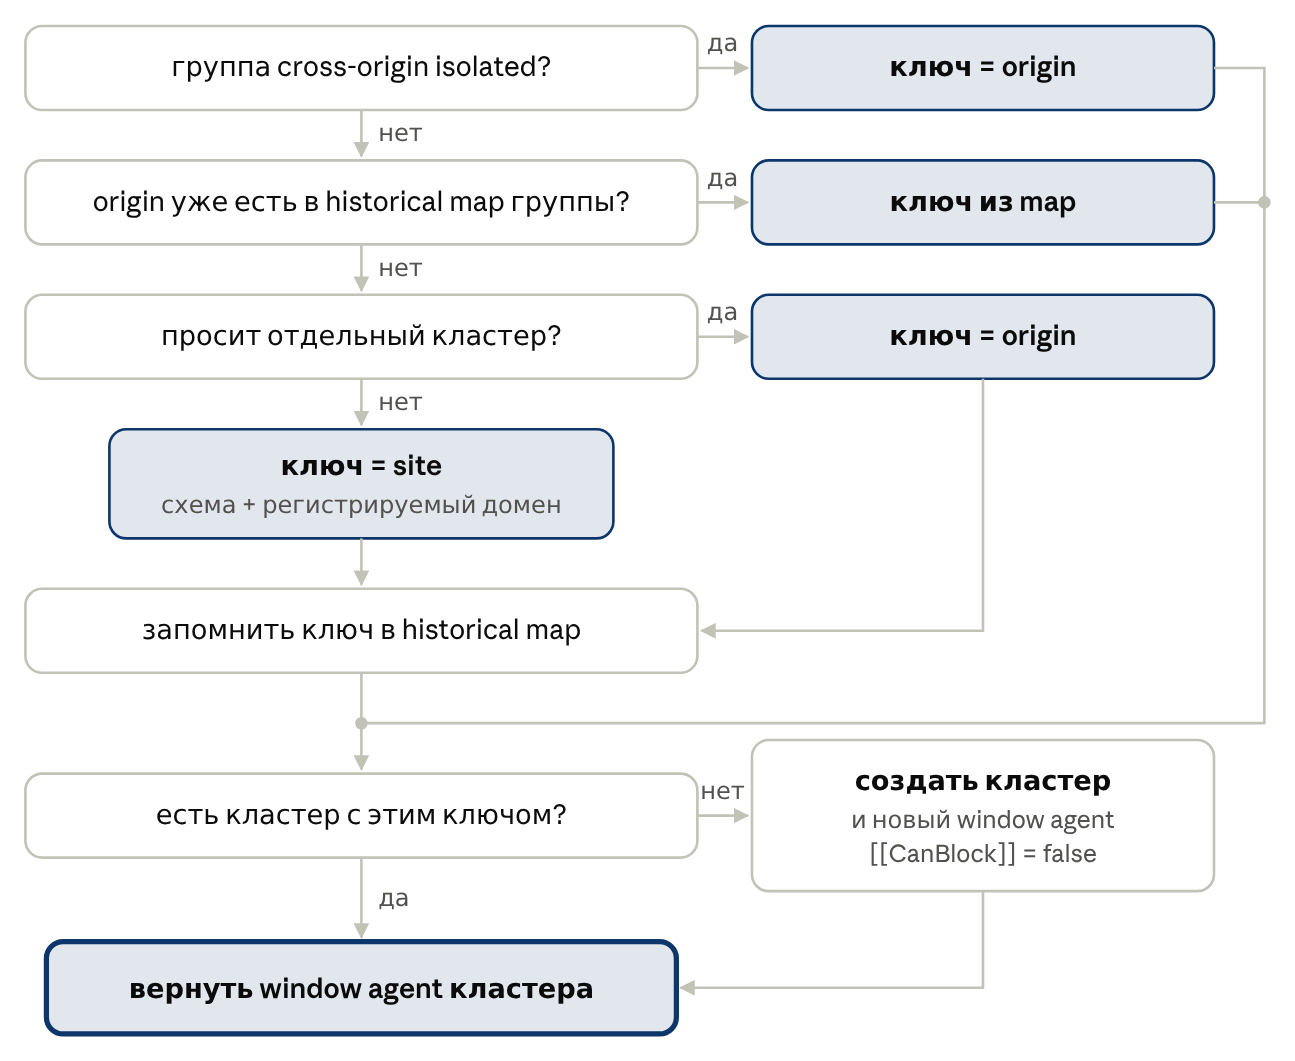
Для worker’а агент всегда новый. Со страницами так не получится: иногда страницы одного сайта обязаны работать в одном агенте. Поэтому для нового Window браузер сначала ищет подходящего агента и создаёт нового, только если не нашёл. Этим занимается алгоритм obtain a similar-origin window agent, а ищет он по ключу. По умолчанию ключ - site.
Site - это схема плюс регистрируемый домен, без поддоменов и порта. У IP-адреса site - это схема и сам адрес, а у sandbox-iframe с его уникальным opaque origin - он сам. У https://a.example.com:8080 и https://b.example.com site один и тот же - https://example.com, поэтому iframe с b.example.com внутри страницы a.example.com по умолчанию окажется в том же агенте, хотя origin у них разные.
Правда, Chrome с версии 115 по умолчанию делит кластеры по origin, отступая от стандарта ради безопасности, а Firefox и Safari пока следуют ему.
Почему не origin? Из-за старого API document.domain. Страницы https://a.example.com и https://b.example.com имеют разные origin. Но если обе выполнят document.domain = 'example.com', они смогут обращаться к объектам друг друга напрямую: iframe вызовет функцию родительской страницы, как свою. Такой синхронный вызов возможен только внутри одного агента, с общим потоком и execution context stack (дальше просто стек). Договорятся страницы или нет, заранее не известно, поэтому стандарт сразу кладёт в одного агента всех, кто может договориться. А договориться могут только страницы одного site: document.domain разрешено сменить на родительский домен, но не выше регистрируемого. example.com можно, com нельзя.
Отсюда главное следствие, которое обычно удивляет: один оконный агент обслуживает сразу несколько страниц. Агента ищут не по всему браузеру, а внутри browsing context group. В неё входят вкладка, вкладки, которые она открыла через window.open() или ссылкой с target, и те, что открыли её, по цепочке, плюс все iframe внутри них. Вывести вкладку в отдельную группу может флаг noopener (у ссылки с target="_blank" он включён по умолчанию) или заголовок Cross-Origin-Opener-Policy.
Страницы одного site внутри группы по умолчанию получают одного агента, а значит общий стек и общий event loop. Глобальные объекты и realm’ы у каждой страницы свои, общий только исполнитель. Доступа к чужим объектам он не даёт: для этого страницы всё равно должны быть same origin-domain.
Теперь понятно, что произошло в эксперименте. Зависшая b.html заняла общий цикл, и вместе с ней встала a.html, а с noopener b.html попала в отдельную группу и получила своего агента. Это и есть первое расхождение из вступления: зависшая вкладка подвешивает ту, что её открыла, и наоборот.
Сузить ключ до origin страница может сама, заголовками ответа. Агент выбирается при создании Document, раньше любого JS страницы, поэтому из скрипта на это уже не повлиять:
Origin-Agent-Cluster: ?1просит отдельный кластер для своего origin. Просьбу учтут только в защищённом контексте и только если этот origin ещё не встречался в группе: внутри группы один origin всегда получает один и тот же ключ;Cross-Origin-Opener-Policy: same-origin, кроме того что отделяет страницу в свою группу, вместе с совместимымCross-Origin-Embedder-Policyвключает cross-origin isolation, и ключом внутри группы становится origin.
Когда ключ - origin, document.domain перестаёт работать: присваивание ничего не меняет. А от cross-origin isolation зависит ещё и SharedArrayBuffer: без неё его нет среди глобальных объектов, а передача через postMessage заканчивается ошибкой DataCloneError.
Особый случай: когда алгоритм не вызывается вовсе
Если вкладка или iframe ещё стоит на начальном about:blank, а новая страница с ним same origin-domain, новый Document забирает старый Window, а вместе с ним realm и агента.
Целиком алгоритм obtain a similar-origin window agent выглядит так:
Сколько агентов и сколько потоков
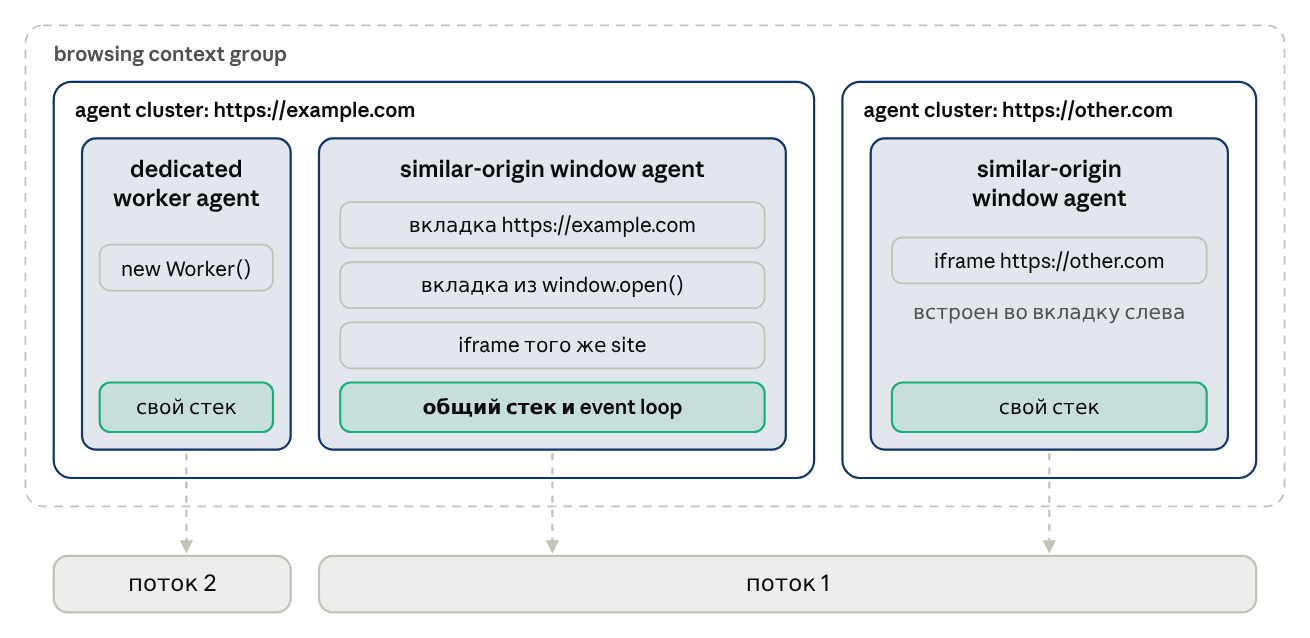
Теперь понятно, кто создаёт агентов и как страница находит своего, и их можно пересчитать. В прошлой статье ответ на вопрос «сколько их» был коротким, а точный такой:
worker и worklet - по агенту на каждый глобальный объект;
window - по агенту на каждый ключ в каждой browsing context group. Несколько вкладок и iframe могут делить одного агента, а одна вкладка с iframe чужого сайта живёт на двух.
Агентов и потоков тоже не обязательно поровну. Несколько оконных агентов браузер может крутить в одном потоке - это тот самый общий поток для вкладок из прошлой статьи (executing thread). Dedicated и shared worker’ам блокироваться можно, поэтому каждому нужен свой поток: иначе, заблокировавшись, worker остановил бы и соседей. А worklet блокироваться не может, и браузер вправе запускать его в любом потоке, даже в главном. Так что несколько вкладок в одном потоке стандарт прямо разрешает.
Environment settings object - браузерная половина realm’а
Агент отвечает на вопрос, кто исполняет код. Но внутри агента код всегда работает в каком-то realm’е, а у realm’а в браузере есть вторая половина, о которой ECMA-262 ничего не знает.
В Realm Record из прошлой статьи лежат встроенные объекты языка ([[Intrinsics]]), глобальный объект и глобальное окружение. Языку этого хватает, но браузеру нужно больше: URL документа, origin, CSP. Для таких данных в Realm Record есть поле [[HostDefined]], которое в прошлый раз мы только упомянули как «данные хоста». В браузере в нём лежит environment settings object.
Роли делятся так: Realm Record отвечает за окружения и встроенные объекты и ничего не знает про браузер, а settings object хранит в основном браузерные данные.
И главное правило: realm, глобальный объект и settings object всегда идут тройкой: на один realm приходится ровно один глобальный объект и ровно один settings object. Из любой вершины можно дойти до двух других. Создаются они тоже вместе: когда браузеру нужен новый глобальный объект, он создаёт для него realm, а следом собирает settings object.
Что лежит в settings object
Settings object задаёт:
realm execution context - контекст, общий для всех скриптов realm’а;
module map - уже загруженные модули, чтобы второй
importтого же URL не грузил их заново;API base URL - относительно чего разбирать относительные URL в API;
origin и has cross-site ancestor - для проверок безопасности;
policy container - CSP, referrer policy и прочие политики;
cross-origin isolated capability - можно ли трогать API, требующие изоляции;
time origin - точка отсчёта для временных меток производительности.
Settings object и environment
Формально стандарт определяет settings object как расширенную версию более простой структуры - environment (не путай с Environment Record из прошлой статьи). Обычно отдельно её никто не создаёт: браузер сразу собирает settings object. Главный пример, когда её заводят отдельно, - навигация. Запрос за новой страницей уходит, когда ни документа, ни realm’а ещё нет, поэтому браузер заранее заводит для будущей страницы environment. Когда ответ пришёл, новый settings object берёт из него id, target browsing context и active service worker. Если навигация сорвалась, этот environment выбрасывается, а при редиректе на другой origin его заменяют новым.
Полей у environment семь:
id - уникальная строка;
creation URL - адрес ресурса, с которым связана среда;
top-level creation URL - то же для среды верхнего уровня; у worker’а и worklet’а null;
top-level origin - origin среды верхнего уровня. У будущей среды верхнего уровня, пока нет ответа, - null; у dedicated worker’а и worklet’а - как у создателя; у shared и service worker’а значение зависит от браузера;
target browsing context - куда идёт навигация;
active service worker - service worker, который управляет средой;
execution ready flag - готова ли среда к исполнению.
Realm execution context - кто кладёт первый кадр
Из всех полей settings object подробнее разберём первое, realm execution context. Из прошлой статьи мы знаем, что Job запускается только на пустом стеке. Но кто кладёт на пустой стек самый первый кадр, когда браузер запускает скрипт или обработчик? Ответ - как раз realm execution context.
Сначала - зачем вообще нужен такой кадр? Операции языка по умолчанию создают функции и объекты в realm’е того кадра, что лежит наверху стека. На пустом стеке ему неоткуда узнать, в каком realm’е работать. Значит, перед запуском JS на стек нужно положить кадр нужного realm’а, даже если самого скрипта ещё нет. Например, когда браузер превращает атрибут onclick в функцию, он сначала кладёт такой кадр страницы - иначе функция появилась бы не в том realm’е.
Такой кадр у каждого realm’а заготовлен заранее. Создавая realm, HTML вызывает InitializeHostDefinedRealm из ECMA-262, и та кладёт на стек новый контекст с Function = null и ScriptOrModule = null - тот самый первый контекст из прошлой статьи, который создаётся вместе с realm’ом и в котором ещё нет никакого кода. HTML сразу снимает его со стека и сохраняет в settings object. Это и есть realm execution context.
Дальше браузер достаёт его при каждом запуске JS: скрипта со страницы, обработчика события, колбэка таймера. До запуска и после него выполняются два шага:
prepare to run script - кладёт realm execution context на стек. Поверх него ляжет уже контекст самого скрипта или функции;
clean up after running script - снимает его, и если стек после этого пуст, сразу запускает microtask checkpoint.
Поэтому первым на пустой стек ложится не кадр скрипта, а realm execution context. Но пустым стек бывает не всегда. Если скрипт вызывает, например, input.focus(), браузер прямо внутри этого вызова запускает обработчик focus, и его realm execution context ложится поверх кадров скрипта. Тут он нужен уже не потому, что стек пуст: он отмечает, где начался новый запуск JS и в каком realm’е. Обработчик ведь может быть и из другой страницы.
Чей это realm: entry, incumbent, current и relevant
Кадры на стеке не обязаны принадлежать одному realm’у. Стоит скрипту одной страницы вызвать функцию из другой, и в одном вызове участвуют сразу несколько realm’ов. Алгоритмам HTML тогда приходится уточнять, какой из них брать, и стандарт выделяет как минимум четыре роли:
entry - realm скрипта, с которого браузер начал текущий запуск JS. Формально это Realm ближайшего к вершине стека realm execution context, обычно того, что кладёт prepare to run script;
incumbent - realm автора, который последним вошёл в код: ближайшая к вершине авторская функция или скрипт на стеке, а для колбэка - тот, кто его когда-то запланировал;
current - realm функции, которая выполняется прямо сейчас, в том числе встроенной. Это current Realm Record из ECMA-262, то есть Realm у running execution context;
relevant - realm, в котором создан конкретный объект платформы. Обычно важен realm у
thisвызванного метода.
Пример из стандарта. Есть страница a.html, в ней iframe b.html, а в b.html ещё два iframe: c.html и d.html. По клику a.html вызывает функцию hello из b.html, а та выполняет c.print.call(d): берёт метод print у Window страницы c.html и вызывает его так, что this - это Window страницы d.html. Во время этого вызова роли распределяются так:
entry - a.html: запуск JS начался с её обработчика клика;
incumbent - b.html:
hello- последний авторский код на стеке;current - c.html: выполняется её
print;relevant - d.html: метод работает с её
Window, переданным какthis.
Пример из стандарта целиком
c.html и d.html могут быть пустыми страницами.
<!-- a.html -->
<!DOCTYPE html>
<html lang="en">
<title>Entry page</title>
<iframe src="b.html"></iframe>
<button onclick="frames[0].hello()">Hello</button>

<!-- b.html -->
<!DOCTYPE html>
<html lang="en">
<title>Incumbent page</title>
<iframe src="c.html" id="c"></iframe>
<iframe src="d.html" id="d"></iframe>
<script>
  const c = document.querySelector("#c").contentWindow;
  const d = document.querySelector("#d").contentWindow;

  window.hello = () => {
    c.print.call(d);
  };
</script>
Новым спецификациям стандарт советует брать relevant, а entry и incumbent не использовать: называет их «чрезмерно сложными» и постепенно убирает почти все места, где они нужны.
Среда собрана: агент, realm и settings object. Теперь можно вернуться к вопросу, на котором остановилась прошлая статья: Job запускается на пустом стеке, но кто его запускает и когда? В браузере это делает event loop - тот самый, который HTML привязал к агенту на четвёртом шаге его создания. И Job для него - лишь один из видов работы: скрипт страницы, обработчик клика и колбэк таймера почти всегда попадают на стек тоже через него.
Event loop - одна итерация цикла
Раз цикл привязан к агенту, то и вид его зависит от агента: у оконного агента это window event loop, у dedicated, shared и service worker’ов - worker event loop, у worklet’а - worklet event loop. Дальше речь в основном про оконный.
Чем три вида цикла отличаются
Алгоритм у всех один: взять task’у, выполнить, прогнать checkpoint. Разница в том, что цикл делает сверх этого.
window event loop. Task привязаны к документам. Когда делать нечего (idle period), свободное время отдаётся колбэкам
requestIdleCallback. Отрисовка приходит отдельной task’ой.Worker event loop. Документов нет, idle period нет. У dedicated worker’а обновление его отрисовки идёт шагом самого цикла. Цикл уничтожается, когда task’ов не осталось, а worker закрывается.
Worklet event loop. Самый простой: в нём бывают только task’и от
addModule(), вызовы методов, которые определил автор, и микрозадачи.
Сам цикл - не функция, которую кто-то вызывает, и не JS-код на стеке, а алгоритм браузера на потоке агента. По стандарту цикл «непрерывно выполняет шаги, пока существует», то есть работает всё время, пока жив его агент, а если task’ов нет, просто ждёт следующую.
Важно не путать цикл со стеком. Цикл выбирает task’у и выполняет её шаги, а если в них есть JS - скрипт, обработчик, колбэк, - этот JS исполняется на стеке. JS есть не в каждой task’е: часть из них делает только работу браузера.
Шаг 1: взять task’у
Первое, что делает цикл, - берёт одну task’у и выполняет её. Разберём, что такое task, где она ждёт и какую из них цикл возьмёт.
Task - это единица работы, которую браузер откладывает, чтобы выполнить позже: запустить скрипт со страницы, отправить событие клика, вызвать колбэк таймера, обработать ответ сети. Цикл выполняет task’и по одной, и пока task не закончилась, следующая не начнётся.
Формально у task’и четыре поля:
steps - что сделать;
source - её task source;
document - к какому документу она относится;
script evaluation environment settings object set - нужен для отчёта о длинных task’ах.
Ждут task’и в task queue - очередях задач. По очередям их раскладывает источник - task source, метка, которая говорит, откуда task’а пришла. Часть источников общая для всего стандарта:
user interaction - мышь и клавиатура;
networking - ответы сети;
DOM manipulation - реакции на изменения DOM;
rendering - отрисовка.
Другие заводят отдельные API, например timer для таймеров.
Сколько будет очередей, решает браузер. Правило одно: все task’и одного источника попадают в одну и ту же очередь, но в одной очереди могут лежать task’и разных источников. На каждой итерации браузер сам выбирает, из какой очереди взять task’у: стандарт так и пишет - «способом, определяемым реализацией».
Из выбранной очереди цикл берёт не просто первую task’у, а первую готовую к выполнению (runnable). Готовность зависит от поля document. Если документа нет, как у task’и из worker’а, task готова всегда. Если есть, task готова, только пока этот документ остаётся текущей страницей своей вкладки или iframe, а не страницей, с которой уже ушли. Для iframe есть ещё одно условие: страница, в которую он встроен, тоже должна оставаться текущей, и так по всей цепочке вверх до вкладки. В стандарте такой документ называется fully active.
Например, после перехода на другую страницу старая может остаться в bfcache - кэше страниц для кнопок «назад» и «вперёд». Её task’и остаются в очереди, но цикл их пропускает, пока страница не вернётся. Если же её вытеснят из кэша, эти task’и удалятся, так и не выполнившись. Поэтому стандарт и называет task queue не очередью, а множеством: «task queues are sets, not queues».
Отсюда единственная гарантия порядка: task’и одного источника лежат в одной очереди, поэтому готовые из них выполняются в порядке постановки. Между разными источниками порядок не гарантирован: таймер, сетевой ответ и клик, готовые одновременно, могут отработать в любом порядке.
Шаг 2: microtask checkpoint
Второй шаг разбирает другую очередь - microtask queue. Делает это алгоритм perform a microtask checkpoint (дальше просто checkpoint). Выполняется он сразу после task’и - на каждой итерации, где task была взята. Если готовых task’ов не нашлось, checkpoint’а на этой итерации нет.
Сами микрозадачи стандарт определяет так: «микрозадача - это разговорное название task’и, созданной через алгоритм queue a microtask». Структура та же самая: steps, source (microtask task source), document и script evaluation environment settings object set. Главное отличие - куда она кладётся:
у каждого event loop есть ровно одна microtask queue, и это уже настоящая очередь, строгий FIFO;
стандарт отдельно подчёркивает: microtask queue - это не task queue. Поэтому на первом шаге цикл её не рассматривает: микрозадачи достаёт только checkpoint.
Значит, микрозадача - не отдельный тип работы. Тип один - task, а мест, где они лежат, два: task queue и microtask queue. И два разных шага цикла, которые их оттуда достают.
Сам checkpoint выполняет микрозадачи одну за другой, от самой старой, пока очередь не опустеет.
Именно «пока не опустеет», а не «те, что были на момент запуска». Микрозадача, поставленная из микрозадачи, отработает в том же checkpoint’е, и та, что поставит она, тоже. Цикл не перейдёт к следующей task’е, пока очередь не окажется пустой. Поэтому бесконечная цепочка микрозадач не пускает цикл ни к следующей task’е, ни к отрисовке - вкладка висит ровно так же, как от while (true).
Кроме как сразу после task’и, checkpoint срабатывает ещё в нескольких местах:
Внутри task’и, как только опустел стек. Это clean up after running script из главы про settings object: сняв realm execution context после очередного запуска JS, он проверяет стек и, если тот пуст, запускает checkpoint, не дожидаясь конца task’и. А одна task’а может запускать JS несколько раз.
В частных случаях, обычно тоже при пустом стеке. Например, парсер HTML, дойдя до закрывающего тега
</script>, запускает checkpoint и только потом подготавливает скрипт к выполнению.
Зачем тогда нужен checkpoint после task’и, если микрозадачи и так разбираются на каждом опустевшем стеке? Бывают task’и, в которых JS не запускался вовсе, а микрозадачи появились. Например, пришёл ответ сети: браузер ставит task’у и в ней сам разрешает промис fetch: реакции промиса встали в microtask queue, но clean up after running script не вызывался - скрипта не было. Такие микрозадачи и подбирает checkpoint после task’и.
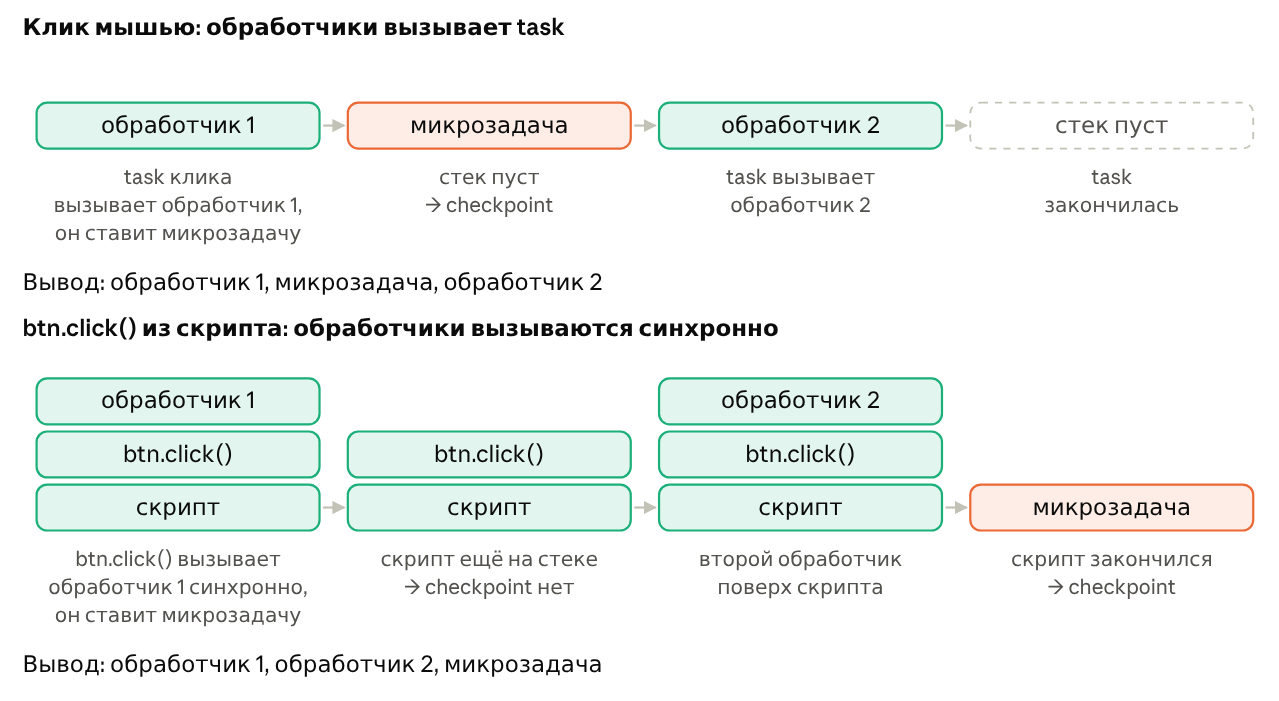
А первое из этих мест лучше всего видно во втором расхождении из вступления. Это классика, на которой спотыкается больше людей, чем на любой задачке про setTimeout, - два обработчика одного клика:
btn.addEventListener('click', () => {
  Promise.resolve().then(() => console.log('микрозадача'));
  console.log('обработчик 1');
});
btn.addEventListener('click', () => console.log('обработчик 2'));

// клик мышью:
// обработчик 1
// микрозадача
// обработчик 2

// клик из js btn.click():
// обработчик 1
// обработчик 2
// микрозадача
Вся разница в том, что лежит на стеке под обработчиком. Клик мышью браузер отправляет из своей task’и, и под обработчиками JS нет: каждый из них - отдельный запуск. Вернулся обработчик 1, clean up видит пустой стек и сразу запускает checkpoint, поэтому микрозадача выполняется до обработчика 2.
btn.click() - это вызов из JS: он отправляет то же событие синхронно, как обычная функция, и обработчики вызываются поверх скрипта, который его вызвал. Clean up после обработчика 1 тоже срабатывает, но под ним на стеке ещё лежит скрипт. Стек не пуст, checkpoint не запускается, и микрозадача ждёт, пока закончится сам скрипт.
Особого правила для нативных событий и событий из JS нет: всё решает одна проверка в clean up - пуст ли стек.
У этой проверки есть неожиданное следствие. Микрозадача - тоже запуск JS, и браузер так же оборачивает её в prepare to run script и clean up after running script. Когда реакция промиса заканчивается, стек снова пуст, и clean up пытается запустить checkpoint, хотя один уже идёт. Возьмём скрипт:
Promise.resolve().then(() => {
  console.log('A');
  Promise.resolve().then(() => console.log('B'));
});
Скрипт закончился, стек опустел, и checkpoint выполняет колбэк с A. Колбэк ставит микрозадачу с B и заканчивается. Стек снова пуст, и clean up after running script запускает checkpoint ещё раз - хотя первый ещё не закончился.
Чтобы checkpoint’ы не вкладывались друг в друга, у цикла есть флаг «checkpoint уже идёт». Checkpoint поднимает его в начале и опускает в конце, а вложенный запуск, увидев поднятый флаг, сразу выходит. Микрозадача с B не теряется: её выполнит внешний checkpoint, ведь он крутится, пока очередь не опустеет.
После checkpoint’а в итерации остаются ещё служебные шаги. Сначала цикл замеряет, сколько шла task’а вместе со своими микрозадачами, и отчитывается в API Long Tasks и Long Animation Frames. Следующий шаг есть только у оконного цикла: если готовых task’ов не осталось, свободное время отдаётся колбэкам requestIdleCallback. Последний шаг есть только у цикла worker’а: dedicated worker может здесь выполнить колбэки requestAnimationFrame и обновить свою отрисовку, а если worker закрывается и task’ов в очередях не осталось, цикл уничтожается.
На этом итерация заканчивается, и цикл возвращается к шагу 1. Но где же отрисовка? Отдельного шага «отрисовать страницу» в цикле нет. Параллельно с циклом браузер ждёт момента, когда может показать новый кадр, и ставит в очередь обычную task’у «обновить отрисовку». Цикл берёт её на шаге 1, как любую другую.
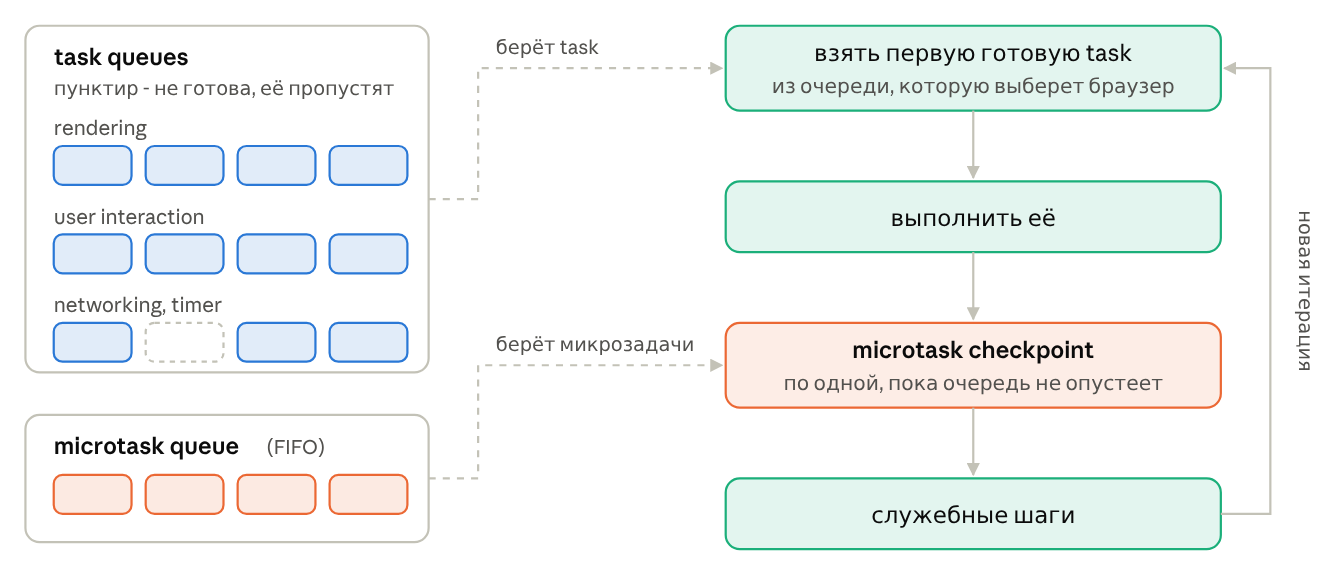
Мы прошли всю итерацию, и макротаски в ней так и не встретились: есть task’и и микрозадачи, больше ничего. Куда же они делись?
Макротаски и микротаски: почему промисы раньше таймера
Начнём с примера из прошлой статьи. Всё, кроме последней строки, объясняла уже ECMA-262: промис-Job запускается только на пустом стеке, поэтому сначала доигрывает весь скрипт, а потом промис-Job’ы идут в порядке постановки. А последнюю строку стандарт языка объяснить не мог: setTimeout в нём не описан вовсе.
console.log('sync 1');
setTimeout(() => console.log('таймер'), 0);
Promise.resolve().then(() => console.log('промис 1'));
Promise.resolve().then(() => console.log('промис 2'));
console.log('sync 2');
// sync 1, sync 2, промис 1, промис 2, таймер
Теперь её можно объяснить. Весь скрипт выполняется внутри одной task’и, от первой строки до последней. setTimeout при этом ничего в очередь не кладёт, а только заводит отсчёт: когда он истечёт, task’а с колбэком ляжет в timer task source. Два .then ставят две микрозадачи. Скрипт закончился, стек опустел, и clean up сразу запускает checkpoint: выполняются оба промиса. А task’у таймера цикл возьмёт только на какой-то из следующих итераций.
Никакого приоритета тут нет: промис и таймер лежат в разных очередях и друг друга не обгоняют. Просто микрозадачи разбираются ещё внутри текущей task’и, а таймер - это уже следующая. Хорошо видно на двух таймерах:
setTimeout(() => {
  console.log('таймер 1');
  Promise.resolve().then(() => console.log('промис из 1'));
}, 0);
setTimeout(() => {
  console.log('таймер 2');
}, 0);
// таймер 1, промис из 1, таймер 2
Микрозадача из первого таймера выполнилась раньше второго таймера, хотя его task, скорее всего, уже ждала в очереди. Механизм тот же, что в примере с кликом: колбэк первого таймера вернулся, стек опустел, и checkpoint сработал ещё внутри его task’и. Второй таймер - это уже следующая task.
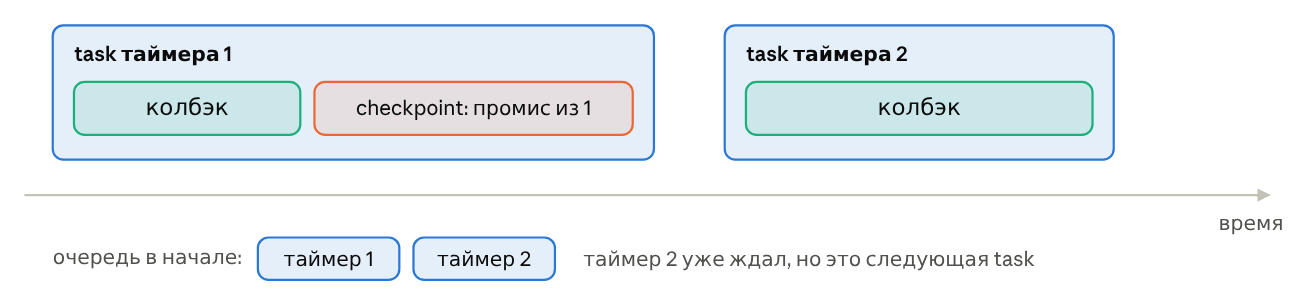
Отсюда и ответ на вопрос, куда делись макротаски. Это и есть третье расхождение из вступления: такого слова в стандарте нет, есть только task’и и микрозадачи. «Макротаской» в статьях называют обычную task’у: таймер, клик, ответ сети. А реакции промиса - микрозадачи, и лежат они в microtask queue.
Сам setTimeout - обычный синхронный вызов: он заводит отсчёт и сразу возвращает id. Время считает браузер параллельно с циклом и вправе растянуть его от себя, например у фоновых вкладок. Когда время вышло, браузер ставит task’у с колбэком в timer task source, и дальше она ждёт, как любая другая, пока цикл её не возьмёт. Поэтому timeout - не время срабатывания, а минимальная задержка: стандарт прямо пишет, что точного расписания таймеры не гарантируют. Гарантия одна: в пределах одной страницы таймер, поставленный раньше с такой же или меньшей задержкой, сработает раньше, так что два setTimeout(f, 0) подряд всегда идут в порядке вызова.
Hooks - куда попадает каждый Job
Осталось понять, как в эти две очереди попадают Job’ы из прошлой статьи. ECMA-262 сама их никуда не ставит: она вызывает hook HostEnqueue…Job, а что делать с Job’ом, решает хост. Таких hook’ов четыре, и HTML каждый реализует просто: кладёт Job либо в microtask queue, либо в task queue.
Hook ECMA-262 | Что его вызывает | Куда HTML кладёт Job |
|---|---|---|
HostEnqueuePromiseJob | реакции промиса ( | в microtask queue |
HostEnqueueGenericJob | разрешение промиса | как task’у |
HostEnqueueTimeoutJob |
| как task’у, после ожидания |
HostEnqueueFinalizationRegistryCleanupJob | колбэки | как task’у |
Микрозадачей становится только промис-Job. Остальные три - обычные task’и в источнике JavaScript engine task source, в одном ряду с кликами и таймерами.
Как выполняется промис-Job
Микрозадача, которую ставит HostEnqueuePromiseJob, делает четыре шага:
если у Job’а есть realm - prepare to run script с его settings object;
вызвать сам Job;
если realm был - clean up after running script с тем же settings object;
если сам Job завершился исключением - report an exception: событие
errorна глобальном объекте а если его не отменили, браузер может вывести сообщение в консоль (исключение из обработчика.thenсюда не попадает: оно просто отклоняет промис).
Realm тут берётся не у того, кто звал .then, а у самого обработчика. Вешаешь на промис функцию из iframe - микрозадача побежит в realm iframe. А если обработчика нет вовсе (p.then(null, null)), realm равен null, и шаги про settings object пропускаются: в обычном случае авторский код там не выполняется.
Как промис «помнит» скрипт
В прошлой статье было сказано, что промис-реакция помнит, какой скрипт был активен, когда её Job поставили в очередь. HTML запоминает его даже раньше, уже в момент .then, и отвечают за это два hook’а: HostMakeJobCallback сохраняет вместе с обработчиком incumbent и текущий активный скрипт, а перед вызовом обработчика HostCallJobCallback временно восстанавливает их. Скрипт при этом хранится не ссылкой, а как execution context с этим скриптом: активным движок считает скрипт ближайшего к вершине такого контекста, поэтому его достаточно положить на стек на время вызова. Обычно это ни на что не влияет. Нужно это в редком случае, когда обработчик - встроенная функция без своего скрипта. Пусть страница /index.html подключает модуль /js/app.mjs, а в нём написано:
Promise.resolve('import("./x.mjs")').then(eval);
eval выполнится позже, в микрозадаче, и своего скрипта у него нет. Благодаря сохранённому скрипту ./x.mjs разрешится относительно /js/app.mjs, то есть в /js/x.mjs. Без него путь считался бы от адреса документа, и вышло бы /x.mjs.
Spin и pause - где хост сам ломает правила
До сих пор правила были жёсткими: task доигрывает до конца, и следующая раньше не начнётся, а оконный агент не может блокироваться ([[CanBlock]] = false). Но у HTML есть два механизма, которые эти правила сознательно нарушают: spin the event loop прерывает task’у посередине, а pause блокирует поток.
Spin the event loop
Иногда алгоритму браузера нужно подождать посреди task’и. Классический пример - HTML-парсер: он дошёл до <script>, а тот ещё не скачан или его блокируют стили. Или конец разбора документа, где нужно дождаться defer-скриптов и всего, что задерживает load. Ждать, блокируя поток, нельзя, а закончить task’у раньше времени тоже нельзя - ей ещё работать. Для этого и есть spin the event loop until условие.
Обычный алгоритм вызывается и возвращает управление, как функция. Spin так не работает, и стандарт оговаривает, что он скорее похож на макрос: его шаги встраиваются прямо в вызвавший алгоритм. Поэтому spin может остановить текущую task’у, а остаток алгоритма доделать уже в другой. Шаги такие:
запомнить текущую task’у и её источник;
скопировать стек и опустошить его;
запустить checkpoint;
запустить в фоне ожидание: когда условие выполнится, браузер поставит в тот же источник новую task’у, и она вернёт сохранённый стек и доделает оставшиеся шаги исходного алгоритма;
не дожидаясь этого, сразу остановить текущую task’у: для цикла она закончилась, и он идёт дальше, берёт другие task’и.
Если spin случился внутри микрозадачи, её продолжение встанет уже в обычную task queue и станет обычной task’ой. Только здесь и пригождаются source, document и остальные поля микрозадачи: ради этого случая они у неё и есть.
Как это выглядит со стороны страницы:
<script>
  setTimeout(() => console.log('таймер'), 0);
</script>
<script src="slow.js"></script> <!-- грузится, скажем, секунду -->
<script>
  console.log('после slow.js');
</script>
Парсер доходит до второго <script>, а файл ещё не скачан, и парсер запускает spin. Разбор оставшейся разметки встаёт, но цикл не стоит и может взять другие task’и, в том числе таймер. Если slow.js грузится дольше, чем ждёт таймер, «таймер» может оказаться в консоли раньше «после slow.js» - и на практике обычно так и будет. Гарантии нет: браузер вправе задержать таймер сверх timeout, а продолжение парсера встанет в очередь, только когда файл загрузится, и что случится раньше, стандарт не определяет.
Как это в браузерах
Я проверил этот пример в Chrome 154, Firefox 157 и Safari 27, с задержкой slow.js в 2 секунды. Во всех трёх, пока парсер ждал, успели выполниться и setTimeout(…, 0), и таймер на 500 мс, и task из MessageChannel. То же с медленными стилями: inline-скрипт после них везде дождался загрузки CSS, а таймеры в это время шли. А вот отрисовка различается: Chrome и Firefox уже через несколько десятков миллисекунд показали разметку до <script>, а Safari не нарисовал ничего, пока скрипт не загрузился. Стандарт допускает оба варианта: когда рисовать кадр, решает браузер.
И тут сюжет замыкается на прошлую статью. Помнишь await? Кадр async-функции снимался со стека, а потом Job возвращал его на вершину стека, хотя функция ещё не закончилась. Spin делает то же самое, только с целым стеком и на уровне хоста: снимает его, пока алгоритм ждёт, а цикл тем временем крутит другие task’и на пустом стеке.
Pause
Pause - это уже настоящая блокировка. Ею пользуются, например, alert, confirm, prompt, print() и диалог beforeunload. Пока task на паузе, цикл не берёт новых task’ов, а скрипт стоит на месте. Стек при этом никуда не снимается - этим pause и отличается от spin.
setTimeout(() => console.log('таймер'), 0);
Promise.resolve().then(() => console.log('микрозадача'));
confirm('продолжить?');
console.log('после confirm');
Пока диалог confirm открыт, в консоли пусто, сколько бы ни прошло времени. Микрозадача ждёт, потому что стек не пуст: скрипт стоит на строке с confirm. Таймер ждёт, потому что цикл не берёт новых task’ов. После ответа порядок такой: «после confirm», «микрозадача», «таймер». Сравни со spin из примера выше: там таймер спокойно срабатывал во время ожидания.
Взял я именно confirm, потому что в его алгоритме пауза не помечена как необязательная. Для alert стандарт её только разрешает.
Вот и нарушение из начала главы. У оконного агента [[CanBlock]] = false, Atomics.wait ему запрещён. А alert делает почти то же самое: синхронно ждёт внешнего события - нажатия кнопки.
Стандарт это противоречие не прячет. Он называет pause наследием, которое нужно «по историческим причинам», и пишет, что она «крайне вредна для пользовательского опыта», особенно когда один цикл делят несколько документов. Браузерам он советует экспериментировать с альтернативами, вплоть до того, чтобы вообще ничего не приостанавливать, если это не ломает существующие сайты.
Как alert, confirm и prompt ведут себя в браузерах
И браузеры этим пользуются. Я проверил alert, confirm и prompt в Chrome 154 и Firefox 157. Chrome ведёт себя ровно по стандарту: пока диалог открыт, не выполняется ничего - ни таймеры, ни fetch, ни MessageChannel, ни requestAnimationFrame. Firefox отступает: во время диалога он выполняет task’и из MessageChannel и BroadcastChannel, а таймеры, fetch, postMessage и XHR при этом ждут. Микрозадачи в обоих браузерах дожидаются конца скрипта, так что пример с confirm выше везде даёт один и тот же результат. А alert из <iframe sandbox> без allow-modals оба браузера просто пропускают: он сразу возвращает управление, как и требует стандарт.
Раз даже стандарт считает pause вынужденным наследием, строить что-то на точном поведении alert не стоит.
Итог
Вот, собственно, и вся модель. ECMA-262 остановилась на том, что Job запускается на пустом стеке, а кто его запускает, решает хост. В браузере это выглядит так: под каждый новый глобальный объект браузер находит или создаёт агента с event loop, рядом с realm’ом собирает settings object, а цикл по одной берёт task’и и после каждой task’и и каждого опустевшего стека разбирает microtask queue. Job’ы из ECMA-262 через hook’и попадают в одну из этих двух очередей. Клики, таймеры, ответы сети, промисы - всё, что принято называть асинхронностью в браузере, это task’и и микрозадачи в этих двух очередях. И только spin и pause сознательно отступают от этих правил.
Отсюда же видно, что не так с правилом, которое повторяют на каждом собеседовании: «сначала синхронный код, потом микрозадачи, потом одна макрозадача». В стандарте такого правила нет, и само по себе оно неточно. Синхронный код - не отдельная ступень: скрипт страницы и сам выполняется внутри task’и. Микрозадачи идут не «после синхронного кода», а каждый раз, когда опустел стек, - поэтому при клике мышью микрозадача первого обработчика выполняется раньше второго обработчика той же task’и. А «макрозадачи» - это просто следующие task’и, и порядок между ними стандарт гарантирует только внутри одного источника. Как запоминалка для простых примеров правило работает, но объясняет их уже то, что мы разобрали: task, пустой стек и checkpoint.
Как и в прошлой статье, это каркас: за каждым шагом цикла стоят десятки алгоритмов HTML, которые я сознательно не разворачивал, а их названия оставил как в стандарте, чтобы нужный раздел находился поиском. И многое стандарт оставляет браузеру: из какой очереди брать task’у, когда рисовать кадр, сколько добавить к таймеру, - здесь Chrome, Firefox и Safari вправе вести себя по-разному.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.