Сколько символов в нике «Аня»? Шесть языков, три ответа, и ни одного правильного
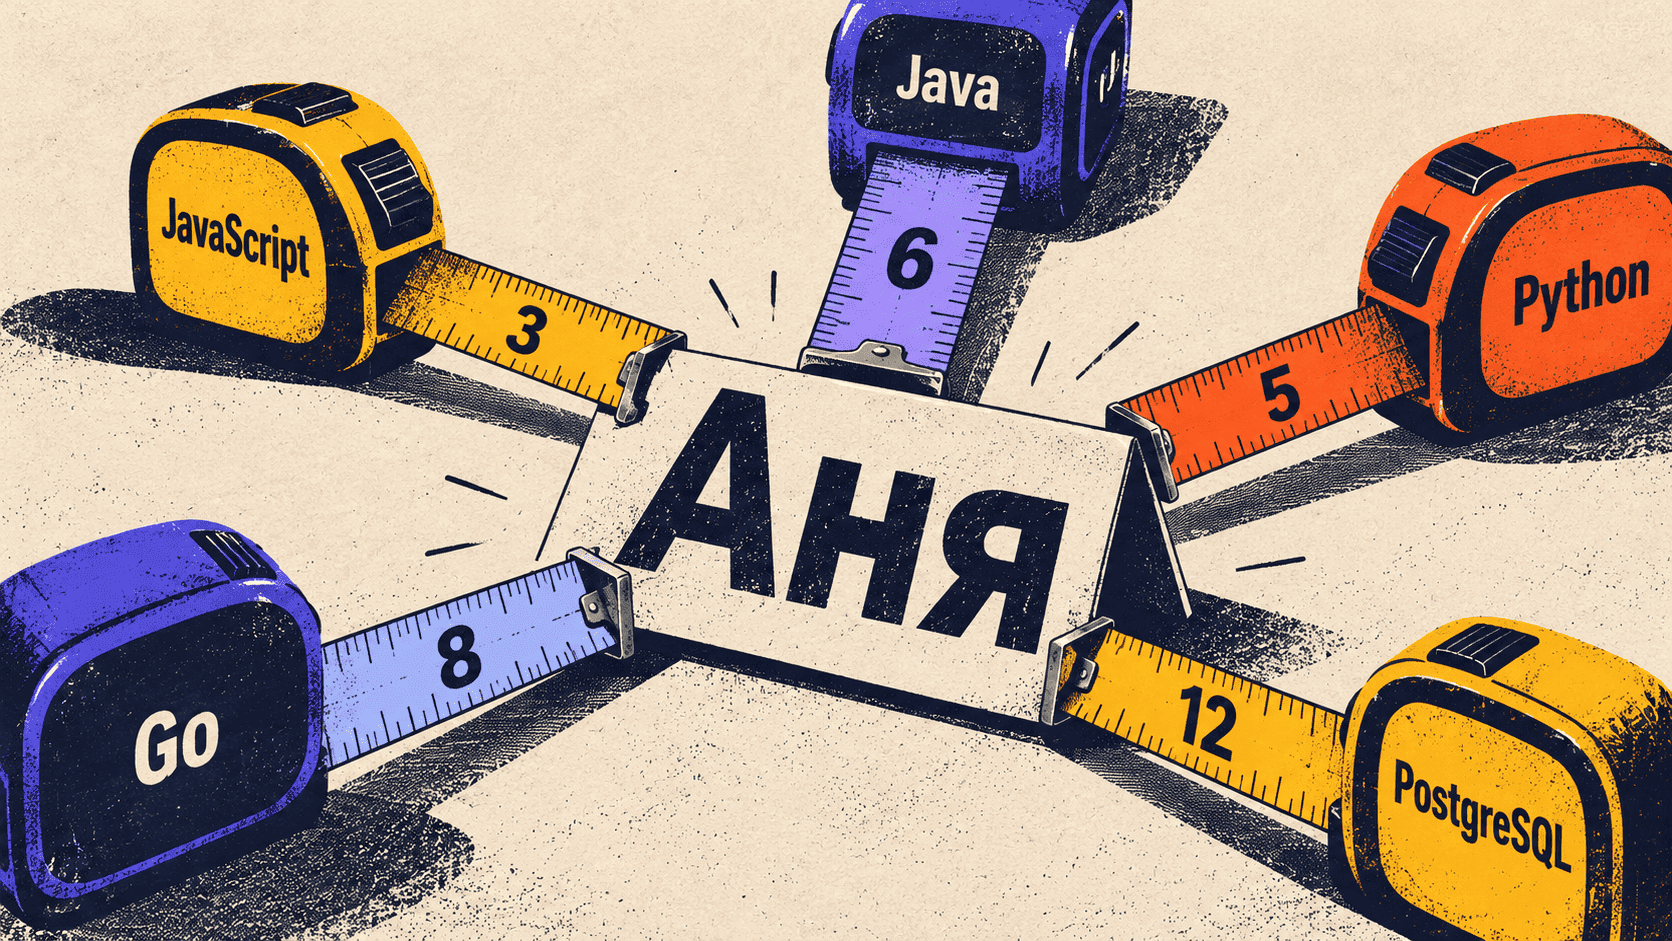
Под полем регистрации написано «ник, не больше 12 символов». Что здесь значит слово «символ»?
Если вы сейчас мысленно ответили «ну, символ», то вы в хорошей компании: браузер, бэкенд и колонка в базе тоже уверены, что знают ответ.
Просто у каждого он свой. Так вышло из‑за возраста языков.
Java и JavaScript проектировали в середине 90-х, когда Unicode помещался в 16 бит, и длину строки они до сих пор считают в 16-битных единицах.
Go и Rust хранят строки в UTF-8 и меряют их байтами.
Python считает кодовые точки, PostgreSQL тоже.
А человек смотрит на экран и видит четвёртую величину, графемы, и для неё долго вообще не было стандартного счётчика.
Пока в нике латиница и кириллица, все четыре числа живут мирно. Потом приходит пользователь с семейным эмодзи и флагом, и ник из 5 видимых знаков внезапно имеет 4 разные длины.
Одно и то же ограничение в 12 символов два слоя системы пропускают, а четыре отвергают. И это мы ещё ничего не обрезали.
Четыре длины одной строки
Вот наш подопытный: Аня👩👩👧🇷🇺.
На экране 5 знаков: три буквы, семья из двух мам с дочкой и флаг.
Семья собрана из трёх эмодзи, которые склеены двумя невидимыми соединителями ZWJ. Флаг состоит из двух букв‑региональных индикаторов.
Кириллица в UTF-8 занимает по 2 байта на букву.
Посчитаем его четырьмя способами, а рядом поставим соседей, на которых каждое расхождение видно отдельно:
байты UTF-16 кодовые точки графемы
Привет 12 6 6 6
café 5 4 4 4 é одной точкой
café 6 5 5 4 e + комбинирующий акцент
👍 4 2 1 1
👍🏽 8 4 2 1 плюс модификатор тона
👩👩👧 18 8 5 1 3 эмодзи + 2 ZWJ
🇷🇺 8 4 2 1 2 региональных индикатора
Аня👩👩👧🇷🇺 32 15 10 5Быстрый словарик, чтобы дальше не путаться.
Байты — это то, что лежит на диске и едет по сети.
Единицы UTF-16 — то, как устроены строки внутри JavaScript, Java и C#: всё, что не влезло в 16 бит, хранится там суррогатной парой из двух единиц. Кодовая точка — номер символа в таблице Unicode.
Графема — то, что человек называет буквой: рисуется одним знаком и стирается одним нажатием Backspace.
Теперь посмотрите на две строки café. На экране они одинаковые, а для компьютера нет.
Первая собрана из готовой буквы
é, вторая изeи комбинирующего акцента, поэтому у них даже длина в кодовых точках разная.Вторую форму можно получить из вполне простых мест: старая файловая система macOS, HFS+, хранила имена файлов в таком виде.
Графем в обеих по 4, и пользователь разницы не увидит никогда.
Что каждый язык называет длиной
Теперь спросим длину строки у шести языков стандартным способом.
JavaScript  s.length                 15   единицы UTF-16
Java        s.length()               15   единицы UTF-16
C#          s.Length                 15   единицы UTF-16
Python      len(s)                   10   кодовые точки
Go          len(s)                   32   байты UTF-8
Rust        s.len()                  32   байты UTF-8
Три разных ответа, и ни один не 5.
Хорошо, а кто умеет считать графемы? Умеют не все и не одинаково давно.
В JavaScript есть
Intl.Segmenter: во всех основных браузерах он доступен с 16 апреля 2024 года, когда поддержку дотянул Firefox 125.В Java символьный
BreakIteratorразбивает строку по расширенным кластерам графем с JDK 20, а до этого обходился упрощёнными правилами.В C#
StringInfoследует правилам Unicode с.NET 5.В Python функция
unicodedata.iter_graphemesпоявилась в 3.15, финальный релиз которого назначен на 9 октября 2026.В стандартной библиотеке Go сегментации нет, есть только таблица свойства
Other_Grapheme_Extend, а в Rust за графемами идут в отдельный крейт.
Где счётчик есть, ответ правильный:
const seg = new Intl.Segmenter('ru', { granularity: 'grapheme' });
[...seg.segment('Аня👩👩👧🇷🇺')].length; // 5import unicodedata
len(list(unicodedata.iter_graphemes('Аня👩👩👧🇷🇺'))) # 5, Python 3.15BreakIterator it = BreakIterator.getCharacterInstance();
it.setText(nick);
int n = 0;
while (it.next() != BreakIterator.DONE) n++; // 5, JDK 20+Все трое сходятся на пятёрке. Python 3.15 к тому же работает с таблицами Unicode 17.0, который вышел 9 сентября 2025 года, так что свежие эмодзи он тоже разберёт.
Даже привычные возможности JavaScript иногда ведут себя неожиданно. Если хотите проверить, насколько хорошо знаете язык и где ещё есть пробелы, пройдите вступительный тест для JavaScript‑разработчиков продвинутого уровня.
Поле ввода теряет флаг
Теперь посмотрим, что происходит с ником по дороге, и первым его встречает поле ввода. <input maxlength="12"> выглядит как самый надёжный фильтр на свете.
Только считает атрибут единицы UTF-16: спецификация HTML отсылает к стандарту Infra, а там строка определена как последовательность 16-битных единиц, и длина у неё — число этих единиц.
Вставляем ник в поле на 12 и смотрим, что осталось в value:
maxlength="12" вставили: Аня👩👩👧🇷🇺 осталось: Аня👩👩👧 .length=11 графем=4
maxlength="8" вставили: Аня👩👩👧🇷🇺 осталось: Аня👩👩 .length=8 графем=4Флаг пропал целиком.
После трёх букв семья с флагом занимает 12 единиц, половина флага дала бы длину 13, и Chromium отбросил весь хвост.
Суррогатные пары он не рвёт, а вот кластеры графем режет, и во втором случае от семьи осталось 👩👩, две женщины вместо двух мам с дочкой.
Это уже другой эмодзи. Пользователь видит его вместо своего ника и не получает ни одного сообщения о том, что с ником что‑то не так.
Может, спасёт validity.tooLong?
Нет, по спецификации флаг поднимается, только если значение длиннее лимита и его изменил сам пользователь. Значение, которое подставил скрипт, проходит эту проверку всегда.
Один лимит, шесть ответов
Браузер к тому же не единственный клиент. Мобильное приложение или интеграция пришлют ник целиком, и дальше всё зависит от того, на чём написан сервис, который примет запрос.
Проверка «не длиннее 12» пишется в каждом слое одинаково, а результат даёт разный:
браузер     maxlength="12"          обрезал до 11 единиц, флаг потерян
JavaScript  s.length <= 12          15 > 12   отказ
Java        s.length() <= 12        15 > 12   отказ
C#          s.Length <= 12          15 > 12   отказ
Go          len(s) <= 12            32 > 12   отказ
Python      len(s) <= 12            10 ≤ 12   принят
PostgreSQL  varchar(12)             10 ≤ 12   принят
Получается система, где один и тот же ник проходит регистрацию через сервис на Python и отлетает от сервиса на Go, а база тем временем спокойно хранит то, что половина бэкендов считает недопустимым.
Неловко становится, когда проверки стоят в нескольких слоях сразу.
Фронт пишет «не больше 12 символов» человеку, у которого на экране 5 знаков, и спорить ему с этим нечем.
База ругается, приведение молчит
PostgreSQL считает varchar(n) в символах, а символ для него — кодовая точка.
Ник из 10 кодовых точек в колонку на 12 ложится без вопросов, в колонку на 8 уже нет:
INSERT INTO users VALUES ('Аня👩👩👧🇷🇺'); -- varchar(8)
ERROR: value too long for type character varying(8)
INSERT INTO users VALUES ('Аня👩👩👧🇷🇺'::varchar(8)); -- то же, с приведением
INSERT 0 1 -- сохранилось: Аня👩👩👧Первая ошибка хорошая. Её видно в логах, её можно поймать.
Со второй хуже: документация так и пишет: явное приведение к character varying(n) обрезает лишнее до n символов без всякой ошибки.
А приведения в коде заводятся сами: их генерируют ORM, их дописывают руками «для защиты от переполнения». И база молча выбрасывает флаг.
Режет приведение по кодовым точкам, кластеры для него не существуют.
На varchar(6) от того же ника остаётся Аня👩👩. Та же пара женщин, что и в браузере, только теперь уже в базе.
Обрезать по индексу нельзя ни в одном языке
Следующий пункт программы — обрезка.
Превью, уведомление, поле «первые 20 символов имени» — обычно это одна строчка со срезом.
Срез режет в своей единице длины, и каждый язык по‑своему обходится с тем, что получилось на месте разреза. Режем наш ник посередине первого эмодзи семьи:
JavaScript s.slice(0, 4) "Аня\ud83d" одинокий суррогат
Java substring(0, 4) → UTF-8 d0 90 … 3f вместо эмодзи знак ?
C# Substring(0, 4) → UTF-8 … ef bf bd вместо эмодзи �
Go s[:8] "Аня\xf0\x9f" невалидный UTF-8
Rust &s[..8] panic: end byte index 8 is not a char boundary
Python s[:6] Аня👩👩 ошибки нет, семья другаяСамая длинная история начинается в браузере. Фронт обрезал ник через slice, JSON.stringify закодировал одинокий суррогат как \ud83d, а Python на бэкенде распарсил JSON и даже не поморщился.
Строка с суррогатом внутри спокойно доехала до записи и только там, при кодировании в UTF-8, упала:
UnicodeEncodeError: 'utf-8' codec can't encode character '\ud83d': surrogates not allowedОшибка вылезает в коде, который к обрезке не имеет никакого отношения, а пользователь видит 500 на сохранении профиля.
Go доносит битые байты до базы как есть, и уже PostgreSQL их отвергает:
ERROR: invalid byte sequence for encoding "UTF8": 0xf0 0x9f (SQLSTATE 22021)Rust паникует сразу, на самом срезе. Из всех вариантов этот, пожалуй, самый адекватный, ведь ошибка всплывает там, где её сделали.
Java и C# не падают вовсе. При кодировании они подменяют половинку суррогатной пары на ? или �, и в базу уезжает ник с мусорным знаком на конце, который никто не заметит до первой жалобы.
А Python?
Python выглядит молодцом, но только выглядит. Суррогатов он не плодит, потому что режет по кодовым точкам, зато спокойно режет внутри кластера: s[:6] превращает семью в двух женщин без единого предупреждения. Строка валидная, просто неправильная.
Резать без порчи можно только по границам графем. В Python 3.15 у каждой графемы из iter_graphemes есть атрибуты start и end, и срез по ним безопасен:
import unicodedata
def cut(s: str, max_graphemes: int) -> str:
end = 0
for i, g in enumerate(unicodedata.iter_graphemes(s)):
if i == max_graphemes:
break
end = g.end
return s[:end]
cut('Аня👩👩👧🇷🇺', 4) # 'Аня👩👩👧' — семья целиком, флаг отброшенВ JavaScript то же самое делается через Intl.Segmenter, в Java через BreakIterator, в C# через StringInfo. В Go и Rust придётся тянуть библиотеку сегментации.
Сколько знаков разрешить
Так какой лимит ставить? Зависит от того, что ограничиваем, а ограничений тут обычно два.
Первое — сколько места строка занимает при хранении. Это вопрос базы и сети, и мерить его надо в той единице, в которой считает хранилище: кодовыми точками для
varchar(n)в PostgreSQL, байтами там, где лимит задан в байтах. Запас нужен большой. Одна графема легко занимает десяток кодовых точек и несколько десятков байт, и колонка впритык под видимую длину рано или поздно встретит строку, которая в неё не влезет.Второе — сколько знаков видит пользователь. Это решает интерфейс, и считать надо в графемах: ни в какой другой единице сообщение «не больше 12 символов» не совпадёт с тем, что человек видит на экране. Проверку видимой длины лучше держать в одном месте. Если каждый сервис напишет её своей функцией длины, они снова начнут отвечать вразнобой.
В браузере это значит перестать считать maxlength главной проверкой. Атрибут можно оставить с большим запасом, чтобы в поле не вставили мегабайт текста, а счётчик под полем и сообщение об ошибке строить на Intl.Segmenter.
Тогда цифра рядом с полем совпадёт с тем, что человек набрал, и флаг не исчезнет посреди ввода. Серверная проверка никуда не девается, просто считает она теми же графемами и с тем же лимитом, что и форма.
И последнее: перед подсчётом и сравнением строку нормализуем в NFC. Помните две café из начала?
После normalize() в PostgreSQL или unicodedata.normalize('NFC', s) в Python они становятся равны.
Без нормализации уникальный индекс по нику пропустит два одинаковых на вид имени.
Если унести из этой статьи одну мысль, то вот она: слово «символ» в требовании к полю звучит как точная величина, а измерить им ничего нельзя.
Браузер и половина бэкендов понимают под ним единицы UTF-16, Go и Rust — байты, Python и PostgreSQL — кодовые точки, человек — графемы.
Пока в строках не было эмодзи, расхождение пряталось, и лимит «12 символов» годами работал одинаково во всех слоях просто потому, что на кириллице и латинице три из четырёх единиц совпадают.
Фиксить все это дело надо с формулировки требования.
Видимую длину задаём в графемах и проверяем в одном месте, лимит хранения задаём в единицах хранилища с запасом, а обрезку по индексу выкидываем из кода совсем, на любом языке.
Если колонка уже объявлена как varchar(12) под требование «12 символов», её лучше расширить раньше, чем первый пользователь с флагом в нике попробует сменить имя.
Ошибки при работе со строками особенно неприятны тем, что обнаруживаются далеко от места, где возникли. Как находить подобные проблемы до того, как их заметят пользователи, разбираем на бесплатном уроке:
5 ноября в 20:00. «Тесты в Go без боли: ловим баги раньше пользователей». Записаться.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.