[ITmedia News] ゼロから声を作れる音声生成モデル「Gemini 3.8 Flash TTS」公開 「Gemini Notebook」でも利用可能に
米Googleは9月23日(現地時間)、テキストから音声を生成するTTS(Text-to-Speech)モデル「Gemini 3.8 Flash TTS」と「Gemini 3.8 Flash-Lite TTS」を発表した。
Flash TTSは、キャラクターの声作りや細かな演出の指示に向き、ゲームやオーディオブック、ポッドキャストなどでの利用を想定する。低価格なFlash-Lite TTSは、大量処理とコスト効率を重視したモデルで、大量の吹き替えや音声コンテンツ制作、音声エージェントなどを主な用途とする。
前世代の「Gemini 3.1 Flash TTS」などGoogleの従来のTTSモデルとの最も大きな違いは、声を選ぶだけでなく作れるようになった点だ。従来モデルでは、30種類の既定音声から選ぶ形だった。新モデルでは、この既定音声に加えて、役柄やアクセント、声質などを自然言語で指定し、新しい声をゼロから生成できる。
対応言語はFlash TTSが130言語、Flash-Lite TTSが101言語で、いずれも日本語に対応する。地域ごとの話し方の違いも含む2000種類以上の音声ライブラリも用意した。作成した声は保存でき、長期のプロジェクトでも同じ声を安定して使える。ライブラリの声の音色や高さ、話す速さ、アクセントをプロンプトで調整する「ボイスリミックス」機能も近く提供する予定だ。公式ブログでは、日本の龍をイメージした(日本語としてはやや不自然な)日本語の声のサンプルを試聴できる。
30秒の音声サンプルから声を再現する「ボイスレプリケーション」機能も備える。対象は自分の声か、利用する権利を持つ声に限る。利用時には声の持ち主が口頭で同意した録音を提出する必要があり、その録音の話者が参照音声と一致するかを確認する仕組みを設けた。なお、Google AI Studioでのボイスレプリケーションは、米国のイリノイ州とテキサス州、欧州経済領域(EEA)、英国、スイス、インドでは利用できない。
両モデルともに演技を指示する機能を搭載する。1行ごとにト書きのような指示を書いて、話すペースや感情を制御できる。数時間に及ぶ長尺の音声でも、声質や自然な間合いを保ったまま生成できるという。1つの台本から2人の話者による会話も生成できる。笑い声やため息、息をのむ音といった言葉以外の音や、「うん」などの相づちを台本中のタグで挿入することも可能だ。
生成した音声には、Googleの電子透かし技術「SynthID」を埋め込む。人の耳には聞こえない透かしで、AIが生成した音声であることを後から検出できるようにする。ボイスレプリケーションには、コンテンツの来歴を示す「C2PA」の認証情報も付与する。
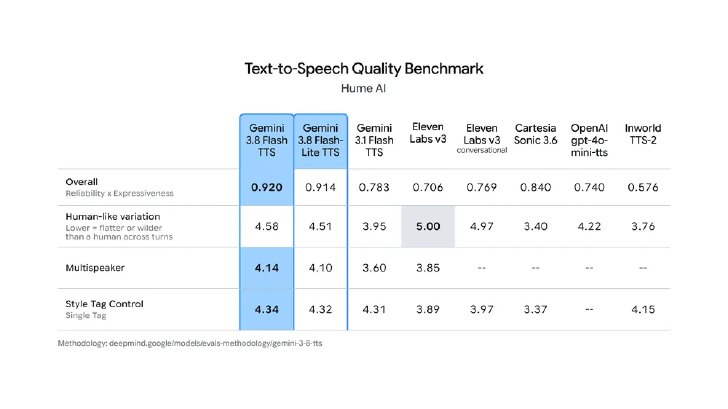
性能面では、米Hume AIが公開する音声デザインのベンチマークで、Flash TTSが総合1位(71.4)となり、アクセント表現でもトップ(60.8)だった。同社の総合品質指標では、Flash TTSが1位、Flash-Lite TTSが2位となった。Gemini 3.1 Flash TTSと比べて、長尺コンテンツや2人の話者による台本の制御が大きく改善したとしている。音声の品質を人が聞き比べて評価する「Voice Arena」では、日本語やポルトガル語、ヒンディー語などの主要言語で上位に入った。
同日から順次提供を始めた。提供範囲はモデルごとに異なる。Flash TTSは開発者向けにGemini APIとGoogle AI Studioで提供し、一般ユーザーは「Gemini Notebook」で利用できる(「Studio」の「音声解説」で設定できるようになる)。Flash-Lite TTSも開発者向けの提供経路は同じで、一般ユーザー向けには「Google Vids」で提供する。企業向けには、両モデルとも「Gemini Enterprise」でAPI経由の提供を近く始める予定だ。開発者向けプラットフォームのAgora、LiveKit、Pipecat、VercelもGemini API経由で対応するほか、Figma、HeyGenなどが自社サービスへの組み込みを進めている。
Gemini APIの有料プランの料金(100万トークン当たり)は、Flash TTSが入力(テキスト)0.5ドル、出力(音声)9ドル。Flash-Lite TTSは入力0.5ドル、出力6ドル。いずれも2026年12月31日までの価格で、2027年1月1日からはそれぞれ2倍になる。無料枠もあり、非同期で処理するBatchとFlexは標準料金の半額で利用できる。
これらのモデルは、Googleが「Gemini Audio」と呼ぶ音声モデル群に加わる。同シリーズには、リアルタイムで音声対話する「Gemini 3.8 Live」、音声を文字に起こす「Gemini 3.5 Transcribe」、音声を同時通訳する「Gemini 3.5 Live Translate」などがある。今回の2モデルは、書かれたテキストを台本どおりに読み上げる音声を生成するもので、声や演技を細かく作り込めるのが特徴だ。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.