Ускорение и автоматизация разработки legacy-прошивки контроллера чистых помещений фармацевтического производства
1. Спагетти код без тестов. Какие решения помогли выйти из тупика и ускорить добавление фич с минимальной регрессией.
2. Автоматизация тестирования: что получилось сделать быстро, а где словили ограничения железа. Что помогло быстро разобраться с ошибками на железе: I²C шина, прерывания и производительность главного цикла.
3. Ускорение за счет использования LLM агента в Firmware DLC. Нюансы агентной разработки firmware: в чем агент был хорош, как работать с ADR и какой feedback loop выстроить
Предметная область
Чистые помещения используются везде, где неконтролируемое загрязнение среды может повлиять на продукт или технологический процесс: от производства лекарств и медицинских изделий до микроэлектроники, оптики и космической техники.
Один из ключевых инструментов поддержания чистоты — управляемый поток воздуха. Воздух проходит через высокоэффективные фильтры и подаётся в чистую зону, часто сверху вниз. Такой поток постоянно вытесняет возникающие в помещении частицы из критической рабочей зоны в сторону вытяжки.
Фильтровентиляционный модуль забирает воздух, пропускает его через фильтр и создаёт направленный поток над рабочей зоной. Автоматика должна поддерживать требуемый режим вентилятора, заслонок, следить за давлением и состоянием фильтра и реагировать на изменение условий. По мере загрязнения фильтра его сопротивление растёт, поэтому для сохранения требуемого воздушного потока режим работы вентилятора приходится корректировать.
Для некоторых производств важно создать однонаправленный, или ламинарный, поток. Так, чтобы частицы, появившиеся, например, от человека, одежды или технологического процесса, не циркулировали по помещению, а уносились в вытяжку.
За несколько лет была разработана экосистему устройств, которые поддерживают ламинарный поток, автоматизируют работу вентиляции, шлюзов и интегрируются с другими системами. Устройства серийные, выпускаются уже несколько лет, поэтому накопился объемный функционал:
контроль давления в помещении и перепада давления на фильтре;
управление вентиляцией / двигателем / заслонкой;
PID-регулирование;
управление дверями и логикой шлюзования;
контроль состояний и аварий;
управление УФ-функционалом для соответствующих исполнений;
Modbus-интеграция с верхним уровнем;
разные режимы одного семейства устройств: активный шлюз, пассивный блок, дверной блок и др.
Задачи и сложности
Я подключился к работе, когда для улучшения качества выпускаемой продукции и ускорение выпуска нового функционала встала необходимость объединения функционала двух прошивок и рефакторинге кодовой базы. Тут было сочетание организационных и инженерных задач:
Качество кода было очень низким, что мешало добавлять новый функционал и чинить имеющиеся баги. При этом бизнес логика не была покрыта тестами и все тестирование велось вручную.
Добавляем к этому отсутствие процесса работы с git. И становится понятно, что весь цикл разработки ПО нужно строить с нуля.
Ко всему прочему добавлялись и другие мелочи, например, разработка велась в старой IDE, которая просто работала только на Windows, соответственно сборка прошивки зависела от платформы и устаревшего ПО.
Небольшой дисклеймер:
В статье описывается применение известных практик. Здесь не стоит цели вывести silver bullet или придумать новую технологию. Более фундаментальное знания и приемы разработки, в том числе с использованием AI агентов советую поискать у Мартина Фаулера и других классиков-методологов разработки ПО.
Постепенное наращивание качества кода и процессов
Обновление процесса разработки шло параллельно с разработкой и налаживалось по ходу. В результате получалось адаптировать лучшие практики под текущую ситуацию и не перегружать внимание нововведениями.
Общий план и итоги
Итерация 1. 1 неделя.
Перенос проекта с Coocox на Segger.
Добавление гит репозитория и формализация работы в ветках.
Добавление в процесс работы агента и ADR. На этом этапе агент не менял исходный код, а лишь покрывал его тестами.
Покрытие юнит тестами и интеграционными тестами.
Создание веб-интерфейса для ручных и полуавтоматических тестов на стенде. Первый шаг к автоматизации предрелизного тестирования.
Ручное тестирование, релиз.
Написание релиз чек-листа по итогам релиза.
Итерация 2. 1 неделя
Объединение двух кодовых баз. Агент переносил код с сохранением логики.
Запуск стенда с Wiren Board для прогона тестов
Ручное тестирование, релиз (уже по чек-листу).
Итерация 3. 1 неделя
Добавление нового функционала. В этот момент начал использовать агента для добавления нового функционала.
Отражение процесса и статуса доработок на Канбан доске
Запуск метрологического стенда на Wiren Board. Нагрузочное тестирование одного сценария.
За 3 недели SDLC начал работать следующим образом:
Постановка задачи (бизнес, инженер)
Написание ADR (инженер-агент)
Создание отдельной ветки (инженер)
Разработка, покрытие тестами (агент)
Отладка производительности и ошибок (агент\инженер)
Код ревью (инженер)
Предрелизное и регрессионное тестирование (автоматические, ручные и полуавтоматические тесты)
Подготовка пул реквеста, документации и пр. (агент)
Релиз (инженер)
Детали и сложности с которым столкнулся
Спагетти код и его покрытие тестами
Первое с чем было необходимо разобраться - риск регрессии после внесения новых изменений. Поэтому первая часть была связана с тем, чтобы покрыть код тестами, без его изменений. Код был достаточно низкого качества, поэтому всю бизнес логику покрыть юнит тестами было невозможно. Прикладная логика была смешана с обработчиками прерываний, регистрами STM32, Modbus, GPIO, таймерами и I2C. Главная цель первого этапа заключалась не в самом рефакторинге, а в фиксации существующего поведения перед изменением уже протестированных версий прошивок, которые работают на большом количестве устройств по всей стране.
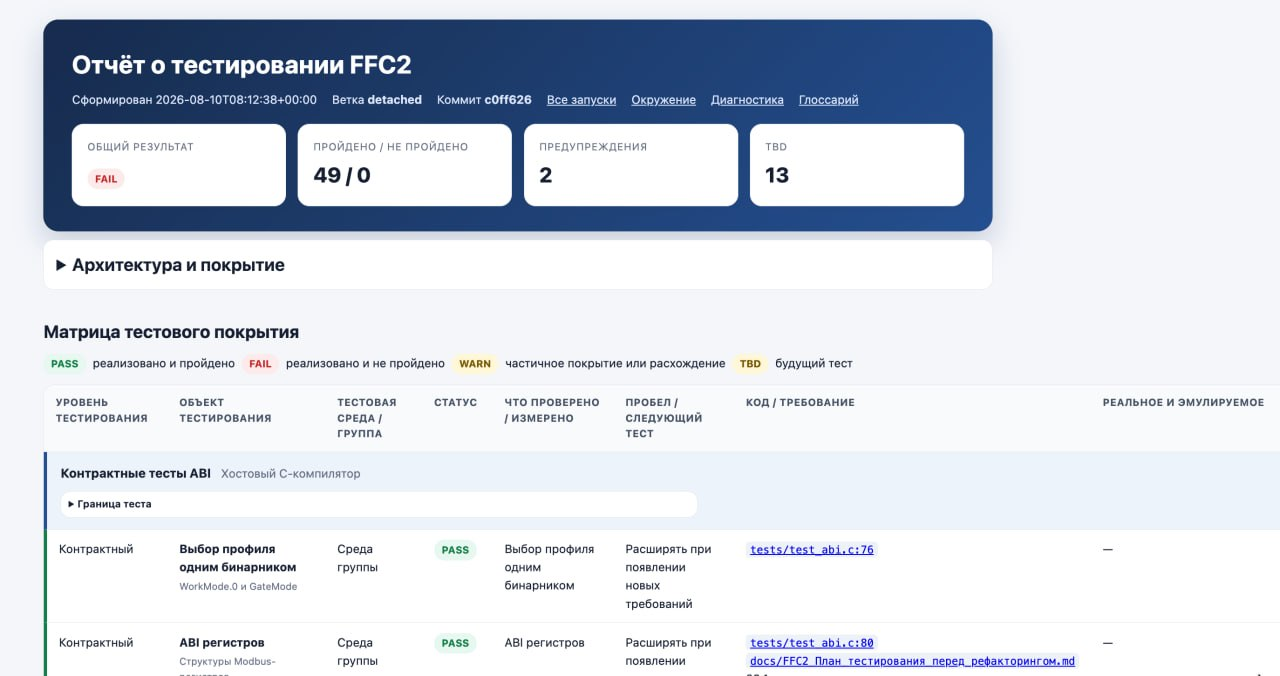
Для максимального покрытия логики использовалось несколько типов тестов.
Тип проверки | Технологический стек | Что проверялось |
ABI и compile-time контракты | C | Размеры структур, смещения Modbus-регистров, совместимость типов |
Characterization-тесты логики | C | ПИД, аварии, основной цикл, продуктовые режимы |
Тесты обработчиков прерываний | C | SysTick, USART2, TIM2, TIM3 |
Драйверные component-тесты | C | EEPROM, XGZP, I2C-транзакции |
State-machine и сценарные тесты | C | Последовательности состояний, таймауты, аварии и восстановление |
Статические архитектурные проверки | Python/pytest | Запрещённые конструкции, порядок инициализации, свойства ISR |
Протокольные интеграционные тесты | Python/pytest | Настоящий Modbus RTU через USB–RS-485 |
Аппаратные write-тесты | Python/pytest | Безопасная запись с проверкой предусловий и восстановлением |
Build/link проверки | shell и Python | Сборка, ISR в map-файле, границы Flash |
Структурное покрытие | LLVM | Строки, функции, регионы и ветви production C |
Для объединения результатов всех тестов был написан свой генератор отчетов и тест runner, о чем. Впоследствии я об этом пожалел: агенту приходилось разбираться не только в самих тестах, но и в дополнительном формате событий, каталоге метаданных, архитектурной модели и HTML-генераторе.
После перехода на стандартные библиотеки pytest, Criterion размер кода для генерации отчетов сократился с 1027 до 193 строк — более чем на 80%. Это позволило сократить расход токенов в отдельных задачах на 38%.
Нагрузочное тестирование
Одной из ключевых задач рефакторинга было объединение двух прошивок в одну. После объединения функциональная регрессия обнаружена не была — во многом благодаря тому, что поведение исходных систем заранее зафиксировали автоматическими тестами. Однако увеличилась нагрузка на главный цикл, что стало закономерным следствием объединения функциональности.
К опросу датчиков добавились обмен с модулем дискретных входов и выходов, обработка Modbus, выполнение продуктового автомата и синхронизация энергонезависимой памяти. В этих условиях критичными стали скрытые дефекты реализации I²C. Показания датчиков поступали нестабильно, а отдельная операция чтения могла блокировать главный цикл более чем на секунду.
Обычные функциональные тесты подобных проблем не показывали. Контроллер правильно выполнял все переходы автомата, отвечал по Modbus, но периодически задерживал обслуживание внешнего watchdog, что перезагружало контроллер. Поэтому потребовалось организовать отдельное нагрузочное тестирование.
Сначала — метрики
Для диагностики медленной работы нужно было добавить различные метрики. Для измерений использовали аппаратный счётчик тактов DWT_CYCCNT, входящий в Cortex-M3. Он позволил измерять время без добавления внешнего таймера и без вмешательства в продуктовую логику.
В прошивку добавили измерение пяти операций:
полного прохода главного цикла;
обработки первого датчика;
обработки второго датчика;
обмена с модулем дискретных входов и выходов (DIO);
синхронизации EEPROM.
Для каждой операции сохранялся максимум после reset. Дополнительно фиксировалась битовая маска операций, выполнявшихся в самом длинном проходе, поскольку задержка могла возникать не из-за одной медленной функции, а из-за неудачного совпадения нескольких операций в одной итерации. Такой подход почти не расходовал Flash и RAM.
Метрики были опубликованы в read-only Modbus-регистрах. Помимо длительностей, прошивка сообщала:
максимальное опоздание heartbeat;
количество пропущенных heartbeat;
операции самого длинного прохода;
число сбросов внешним watchdog;
uptime и состояние автомата состояний перед последним reset;
аппаратные флаги причины сброса.
Часть данных сохранялась в backup-регистрах STM32. Благодаря этому диагностика переживала reset и позволяла понять, что происходило непосредственно перед перезапуском контроллера.
Сценарные и длительные испытания
Нагрузочное тестирование проводилось в двух режимах. Сначала мы последовательно воспроизводили потенциально тяжёлые сценарии: ошибки каждого датчика, восстановление I²C, запись EEPROM, опрос DIO, интенсивный Modbus-обмен и аварийные состояния. Условия изменялись по одному, поэтому измеренный максимум можно было связать с конкретной фазой главного цикла.
Сценарные проверки помогли определить длительность каждой операции и их комбинаций. Запись конфигурации в EEPROM занимала около 99 мс, а её совпадение с ошибкой датчика увеличивало проход примерно до 159 мс. После этого запись EEPROM разбили на отдельные шаги, чтобы она не выполнялась в одной итерации с другими длительными операциями.
Однако наиболее полезным оказался двухсуточный прогон. Он обнаружил редкую комбинацию длительностью около 1,08 секунды, которая не воспроизводилась в рамках единичных сценариев. Причиной оказалось синхронное ожидание готовности датчика: после ошибки I²C цикл продолжал выполнять задержки до тысячи раз. Чтение датчиков перевели на неблокирующую машину состояний, возвращающую управление главному циклу между проверками готовности.
Таким образом, сценарные тесты лучше подошли для оценки отдельных операций и проверки известных гипотез, а длительный прогон — для поиска редких сочетаний событий. На практике наиболее эффективной оказалась их комбинация: сначала управляемые эксперименты задавали ожидаемые границы, затем soak-тест проверял, сохраняются ли они при длительной реальной работе.
Итогом стало не только повышение производительности. За счет метрик, была улучшена наблюдаемость: после редкого сбоя стало возможно определить, какая фаза задержала главный цикл, насколько опоздал heartbeat и что происходило непосредственно перед reset.
Создание харнес для AI агента
Я уже использовал агента для веб разработки и мне очень хотелось попробовать его применение для разработки firmware. В целом, считаю что эксперимент оказался удачным. Я начал с базовой подписки на ChatGPT за $20 и ее мне хватило для аккуратной последовательной работы.
Для создание харнеса использовал подход представленный Birgitta Böckeler и опубликованный на сайте у Фаулера с Guides и Sensors расширяющий spec driven development. Хотя в моем случае я бы заменил guides на enabling constraints - направляющие ограничения (термин из теории комплексных систем). В качестве направляющих ограничений были: 0
ADR. Причем для каждой задачи составлялись свои ограничения. Например, для первой части покрытия тестами было запрещено изменять прошивку.
Задачи с DoD
Список регистров с указанием свободных, занятых, меппинг с переменными в коде и описанием
Размер FLASH памяти доступной для прошивки
Размер FLASH памяти занятой под параметры
В качестве сенсоров были:
Тесты
Стенд со всей периферией (включая вентиляционный двигатель, имитатор фильтров, индикацией дверей и УФ).
Modbus, по которому агент мог понять состояние контроллера на основе информации с регистров
Программатор, который позволял делать дебаг и прошивать контроллер новой прошивкой
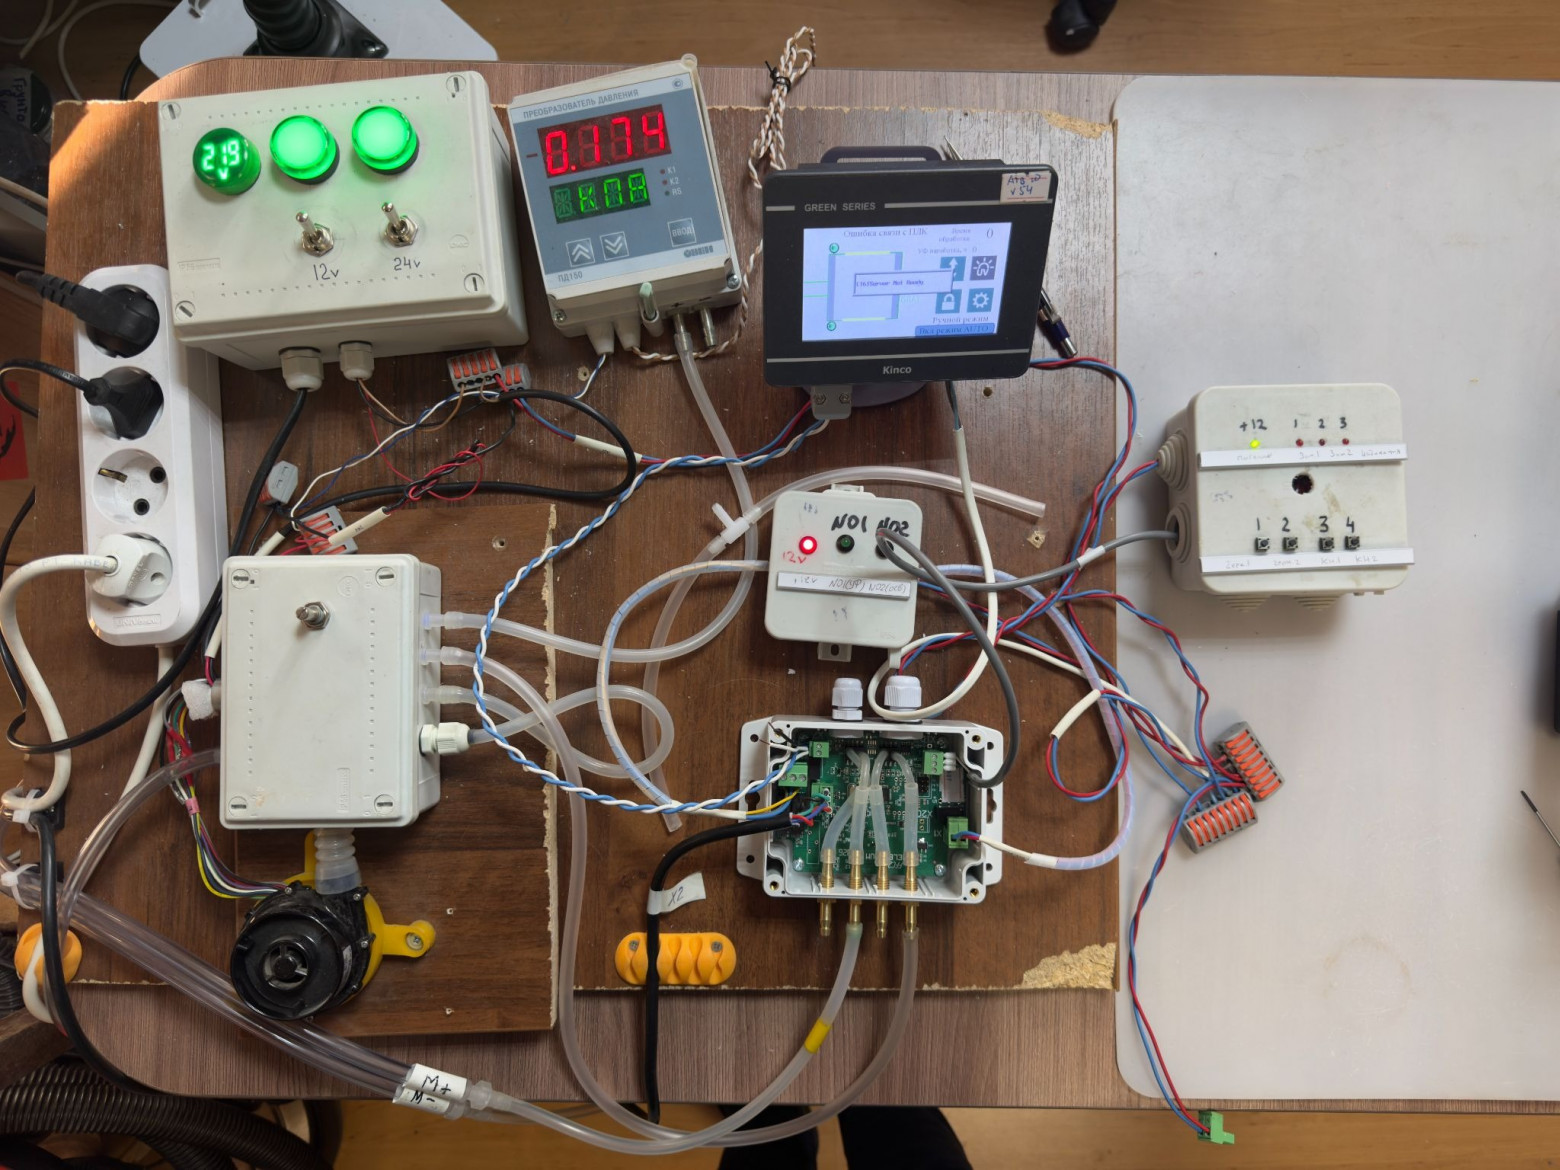
В следующей итерации, мы автоматизировали работу стенда через управление входами и мониторингом выходов на Wiren Board, но это заслуживает отдельной статьи.
Эксперименты с агентной разработкой
Задачи сделать работу полностью автономной не стояло. Мне было важно понять на каждом этапе что происходит и с каким этапом разработки агент справляется лучше всего и как он может ускорить мою собственную работу. Ниже расписал опыт использования агента в разных частях SDCL и отдельные эксперименты с TDD и оптимизацией токенов
Сбор требований
В моем случае, агент ускорял сбор данных о системе и позволил очень быстро въехать в проект. В былые времена(тут прям ностальгией запахло), мне на то чтобы разобраться с новой технологией, требованиями и дать первый результат потребовался бы месяц. Тут получилось реализовать первый этап за одну неделю.
ADR
Составления ADR - собрать структуру и данные в одном месте у агента получается хорошо. А вот предложить подходящее решение и выбрать технологический стек - это уже получается не очень. На написание требований уходило 1-2 часа, основу писал агент - у него хорошо получалось собрать структуру и данные в одном месте. А дальше важно было убрать оверинжениринг и закрыть пробелы в требованиях. Задача выбора подходящей визуализации, детализации остается за инженером.
Кодинг
Больше всего агент ускоряет кодинг. Но даже там, он может быстро запутаться, если имена переменных выбраны неудачно. И да, сам выбирать имена переменных и имена для функций он умеет на уровне мидл разработчика. Даже элементарное правило функция - глагол не всегда выполняет. А naming является критичным для качества работы LLM.
Создание инструментов вокруг разработки
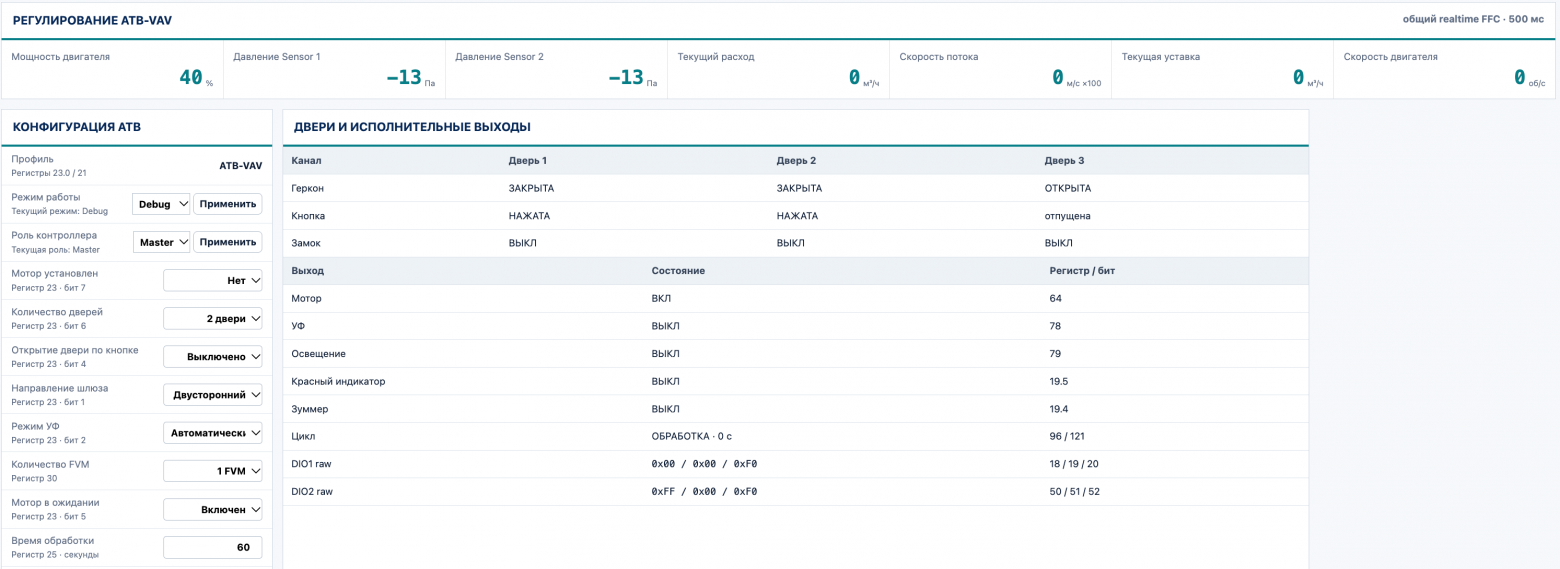
Низкоуровневая разработка сложна в том, что без периферии сложно увидеть готовый результат. Поэтому для тестирования и проверки я написал отдельный веб-сервис, который, помимо значений всех регистров дает человеко понятный интерфейс. Он показывал выдаваемую мощность мотора, его обороты, показания датчиков в паскалях, включение, выключение света, ультрафиолета. И самым полезным, был вывод состояние машины состояний. К написанию прошивки агента подпускать рискованно, а вот создание подобных инструментов, которые сильно упрощают жизнь, является хорошей задачей.
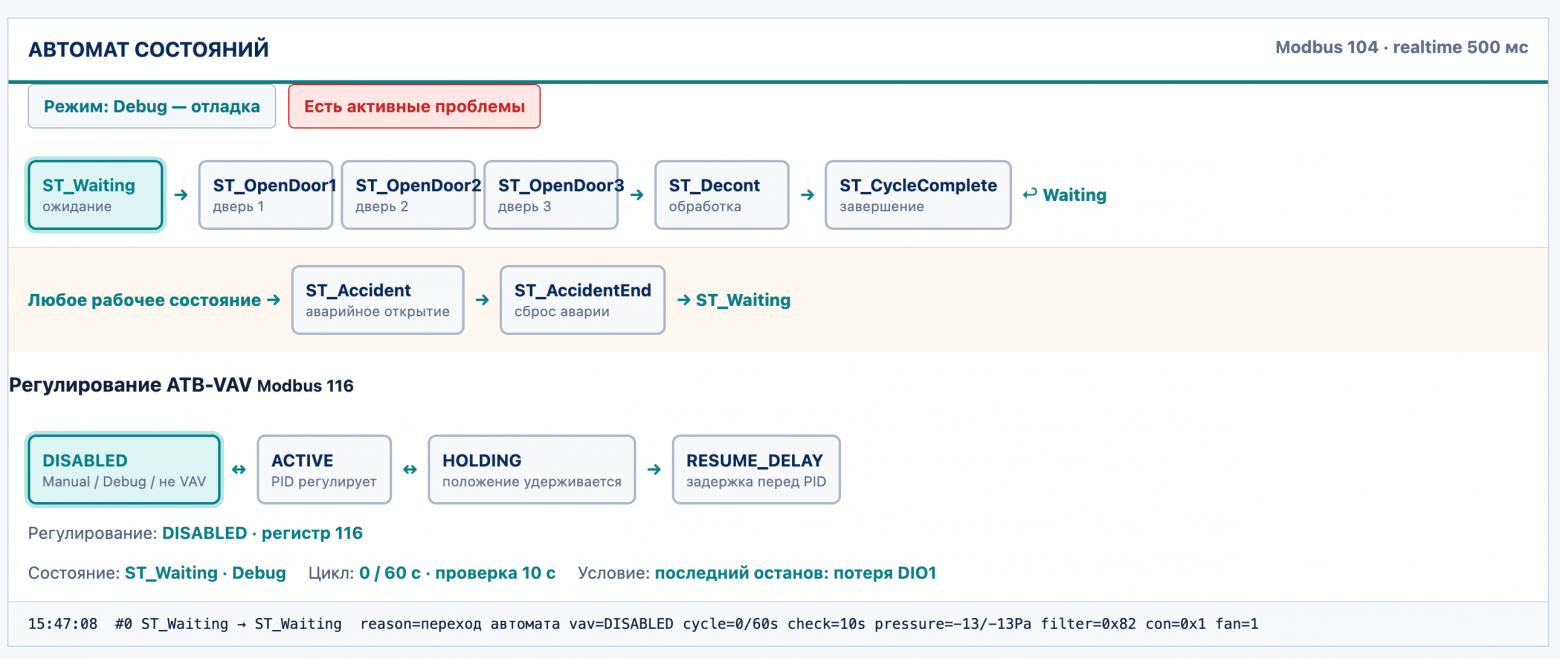
В ходе активной разработки, такие инструменты отлаживаются и потом хорошо перекрывают функционал верхнего уровня АСУ ТП.
Тесты, документация
Тесты пишет быстро, но частенько описывает несуществующие сценарии работы системы. Документацию тоже генерирует быстро, но порой там слишком много текста, хотя можно было сделать таблицу, схему. Текст бывает понятен пока работаешь над задачей, а потом через неделю читаешь и понимаешь, что там половину можно убрать, либо написано так неграмотно, что глаз дергается. Задача выбора подходящей визуализации, детализации - все на инженере.
Рефакторинг
Пожалуй, лучше всего агент показывает себя, когда надо поработать с текущим кодом. Для объединения двух кодовых баз, я выбрал путь, где переносилась только одна функциональность и тестировалась. Задача нарезать работу на небольшие тестируемые куски - тоже задача инженера. Чем больше объем задачи, тем больше риск, что что-то забудется.
TDD
Была одна задача, для которой TDD оказался очень в тему - нужно было дописать логику машины состояний. Сперва, совместно с агентом, составили список всех пользовательских сценариев. И, уже по ним, покрыли код сценарными тестами, которые охватывали не одно состояние, а целые пользовательские сценарии. Следующим шагом мы добавили тесты на новые сценарии, которые упали и после этого агент быстро реализовал логику, имея хороший feedback loop в качестве тестов. При этом, я считаю что постоянное использование TDD не оправдано и некоторые коллеги со мной согласны.
Оптимизация токенов
Мое внимание привлекли некоторые инструменты, которые обещали сократить расход токенов. Я провёл A/B-тестирование, используя новые сессии Codex и сравнивая медианные значения фактического расхода токенов.
Меня удивила разница между тем что написано в README репозиториев и фактическими цифрами. Ниже название инструментов и процент показывающий изменение расхода токенов.
RTK: −9,9%
Graft (структурный): +23,9%
Graft (семантический): −4,1%
FastCtx: +60,6%
Локальная маршрутизация через AGENTS.md: +10,0%
Большинство попыток «оптимизировать контекст» на практике привели к большему расходу.
Самым показательным примером стал FastCtx: он успешно заменил обычные операции с файлами и поиском на более компактные, адресные чтения, но общий расход токенов вырос на 60,6%. Это произошло за счет того что у Codex есть своя оптимизация, ведь это не голый LLM, а среда разработки. И у OpenAI, как я потом увидел, есть прямая рекомендация использовать минимум расширений.
Структурный Graft увеличил расход на 23,9%.
RTK — единственный инструмент, который показал заметную экономию в моём тестировании (−9,9%). Хотя я бы всё равно назвал результат неоднозначным: общее время выполнения задачи увеличилось, а измеренное самим инструментом сокращение объёма вывода команд оказалось незначительным для этой задачи.
С этой точки зрения, в разработке ничего не поменялось: всё по-прежнему сводится к поддержанию чистой структуры проекта, точному неймингу с использованием DDD и рефакторингу больших файлов и функций. Старый добрый Чистый код.
И есть один скилл, который себя зарекомендовал: ponytail. Я не измерял разницу по расходу токенов, потому что польза от него видна в другом срезе, он добавляет хорошие constraints и тем самым убирает overengineering и локализует изменения кода.
Итоги и планы
За 3 недели получилось хорошо продвинуться по инженерным задачам и закрыть некоторые организационные. Удалось перенести и повысить качество большой части legacy кода, добавить ровно столько лучших практик, сколько будут полезны для общего результата. Добились хорошего покрытия тестами кода и общей логики контроллера.
Файл | Назначение | Строки | Функции | Ветви |
main.c | Основной цикл прошивки, планирование задач, регулирование и обработка аварий | 62,94% · 496/788 | 96,15% · 25/26 | 60,23% · 212/352 |
uart.c | Обмен по UART/Modbus и расчёт CRC16 | 93,94% · 31/33 | 100% · 3/3 | 90% · 9/10 |
i2c.c | Низкоуровневый драйвер I²C: транзакции, переключение каналов и восстановление шины | 32,40% · 81/250 | 31,25% · 5/16 | 17,27% · 19/110 |
x.c | Драйвер датчиков X: запуск измерений, ожидание готовности и получение давления и температуры | 50% · 62/124 | 66,67% · 2/3 | 30,88% · 21/68 |
eeprom.c | Драйвер внешней EEPROM: чтение и запись данных через I²C | 62,69% · 42/67 | 66,67% · 4/6 | 44,12% · 15/34 |
eeprom_storage.c | Хранение конфигурации: загрузка, проверка валидности и синхронизация параметров с EEPROM | 92,34% · 217/235 | 95,45% · 21/22 | 81,58% · 93/114 |
Итого | 62,06% · 929/1497 | 78,95% · 60/76 | 53,63% · 369/688 |
Главным показателем качественного покрытия было то, что после объединение кодовых баз практически не возникло регрессии.
Стало понятно что топовые LLM сильно ускоряют разработку firmware опытным инженерам, однако масштабирование этого ускорения требует большой зрелости в процессах.
На момент написания статьи, уже есть чем похвастаться в плане дальнейшего ускорения выпуска серийных устройств с помощью стенда автоматического тестирования. Надеюсь в скором времени поделить и этим опытом.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.