[Перевод] Выжимаем максимум из BERT: токенизация в 50 раз быстрее
Статья о том, как отказ от лишней обработки ASCII ускорил токенизатор BERT в 50 раз
Последние несколько месяцев мы активно возвращаем к жизни библиотеку tokenizers. Наша цель — ускорить токенизацию и снизить потребление ресурсов. Сейчас мы готовим эти улучшения к стабильному релизу v1.0.0.
Главным ориентиром для нас стала скорость токенизации в МБ/с исходного текста, прежде всего для BPE (Byte‑Pair Encoding) — алгоритма, который используется в большинстве токенизаторов LLM.
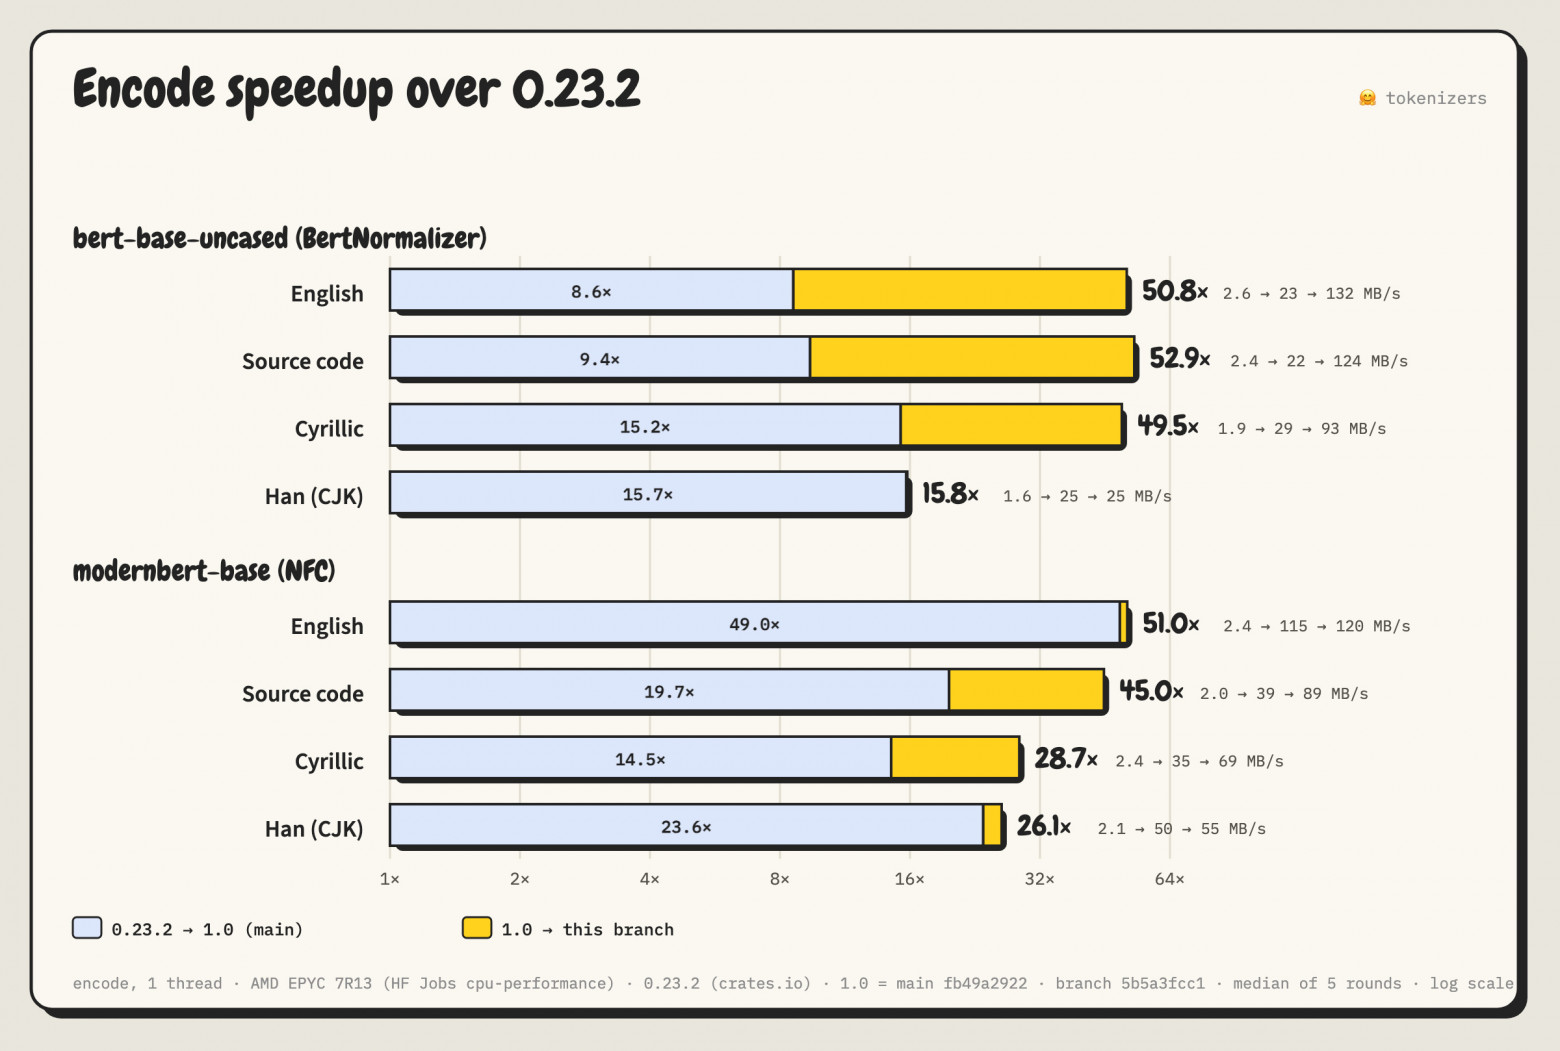
Теперь классические BPE‑токенизаторы обрабатывают текст до 30 раз быстрее, чем в tokenizers 0.23.
Токенизаторы других типов тоже ускорились, но меня не устраивал результат старого доброго bert-base-uncased, который теперь работал всего примерно в 8,6 раза быстрее.
В этой статье расскажу, как нам удалось ускорить токенизатор BERT ещё в 5,7 раза и добиться суммарного ускорения примерно в 50 раз по сравнению с версией 0.23. На момент написания статьи изменения пока находятся на стадии пул‑реквеста.
BERT? Серьёзно?
Зачем вообще возиться с BERT, спросите вы? Его выпустили ещё в 2018 году, задолго до появления ChatGPT (!!!). Казалось бы, он уже давно неактуален, правда?..
Не совсем. BERT‑подобные модели используются повсюду. Они служат энкодерами для создания эмбеддингов, поиска и RAG, лежат в основе реранкеров и классификаторов. А по количеству скачиваний с ними могут сравниться лишь немногие LLM.
Более того, три самые скачиваемые модели на всём Hugging Face Hub используют нормализатор BERT:
all-MiniLM-L6-v2— 218 млн скачиваний в месяц;кросс‑энкодер
ms-marco-MiniLM-L6-v2— 79 млн;bge-small-en-v1.5— 59 млн.
Сам bert-base-uncased занимает шестое место с 34 млн скачиваний.
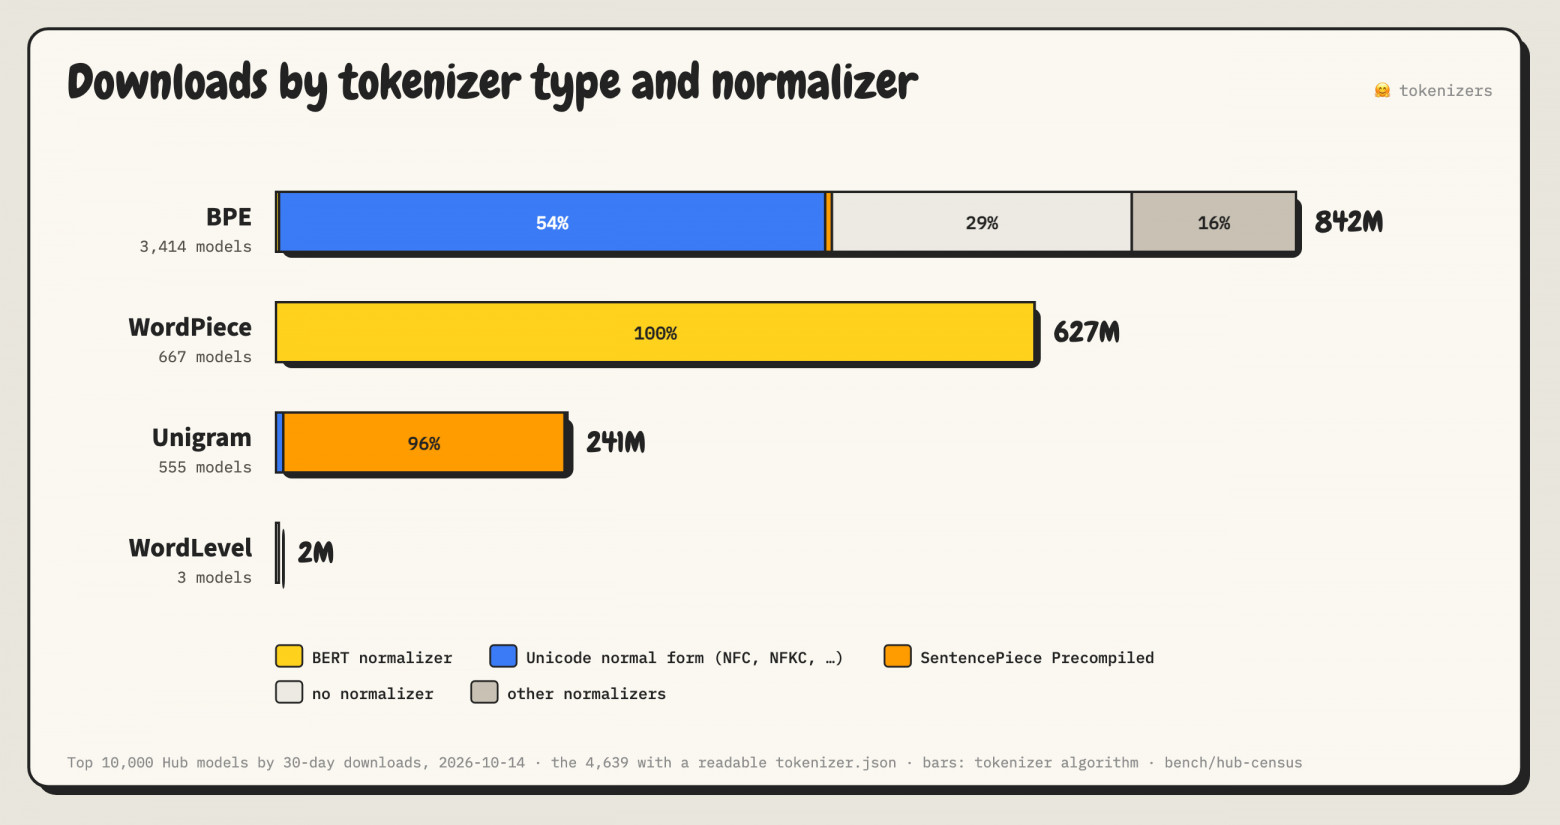
Если взять 10 000 самых скачиваемых моделей на Hugging Face Hub, то на BPE‑токенизаторы (которые используются в большинстве LLM) приходится 842 млн скачиваний в месяц. На WordPiece, алгоритм токенизации BERT‑подобных моделей, — 627 млн. И во всех этих случаях текст проходит через нормализатор BERT.
Причём нормализация нужна не только BERT: больше половины скачиваний BPE‑моделей приходится на токенизаторы, использующие одну из форм нормализации Unicode (чаще всего NFC, как в Qwen или ModernBERT). Наши улучшения ускоряют и эту обработку.
Почему так медленно
Когда занимаешься оптимизацией производительности, одна из самых полезных вещей — это профилирование.
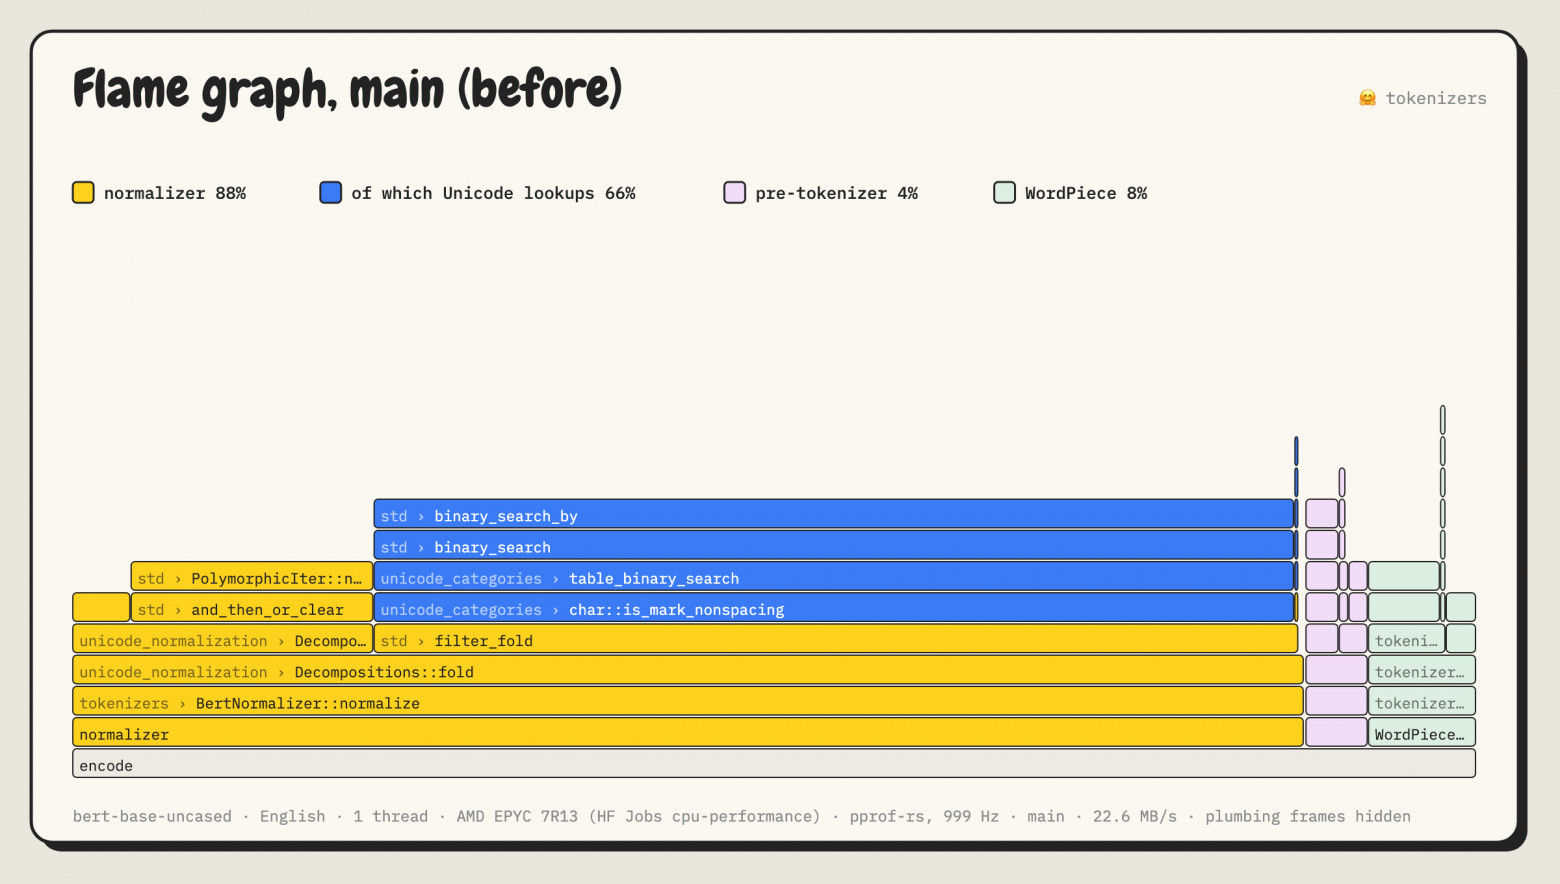
Именно этим мы и занялись: запустили профилирование токенизации английского текста с помощью bert‑base‑uncased на версии 1.0, предварительно прогрев систему.
Вы можете повторить эксперимент самостоятельно с помощью нашего репозитория для воспроизведения результатов.
Вот получившийся флеймграф:
Если вы впервые видите такой график, ничего страшного. Сейчас разберёмся:)
Как читать флеймграф
Представьте, что мы тысячу раз в секунду делаем снимок состояния программы. Каждый снимок показывает, какая функция сейчас выполняется и кто её вызвал. Например: «encode вызвала normalize, а та, в свою очередь, вызвала is_mark_nonspacing».
Теперь соберём все снимки вместе и посчитаем, какие функции встречаются чаще. Если функция присутствует на большинстве снимков, значит, именно на неё уходит основная часть времени.
Флеймграф наглядно показывает эту статистику:
Каждый прямоугольник соответствует функции. Чем он шире, тем чаще функция встречалась на снимках и тем больше времени заняло её выполнение.
Прямоугольники располагаются над функциями, которые их вызвали.
encodeнаходится в самом низу, поскольку все остальные функции выполняются в рамках её вызова.Ищите самые широкие прямоугольники ближе к верхней части графика. Именно там программа тратит больше всего времени.
Горизонтальная ось не показывает ход времени — это просто способ расположить прямоугольники. Цвета обозначают разные этапы обработки: жёлтый — нормализатор, синий — обращения к таблицам Unicode внутри него, фиолетовый — предварительное разбиение текста, зелёный — WordPiece.
Из графика можно сделать несколько важных выводов:
88% времени токенизации уходит на нормализацию текста. На сам WordPiece, который непосредственно выбирает токены, приходится всего 8%.
Примерно две трети всего времени токенизации съедает загадочная функция
binary_search_by. Она вызывается изchar::is_mark_nonspacing()библиотекиunicode_categories, которая проверяет, относится ли символ к неинтервальным комбинируемым знакам. Почему эта проверка настолько дорогая, разберёмся чуть ниже.
Итак, мы нашли узкое место — нормализацию текста. Дальше расскажу, как нам удалось заставить этот этап работать на совершенно другой скорости.
Норма... что?
Бро, что за нормализация текста вообще?
Кажется, именно это вы сейчас и спрашиваете, глядя в экран. Постараюсь объяснить как можно понятнее, только наберитесь терпения!
Прежде чем разбить текст на токены, токенизатор выполняет нормализацию: приводит текст к единой форме, чтобы строки, которые выглядят одинаково для человека, обрабатывались одинаково.
Вот какой путь проходит предложение через токенизатор bert-base-uncased — от исходного текста до идентификаторов токенов, которые получает модель:
И зачем вообще всё это нужно??
Если вы задались этим вопросом, придётся прочитать следующий раздел. Правда, он довольно насыщенный, так что не обижусь, если вы его пропустите.
Нормализация Unicode за три минуты
Unicode — это способ представления текста с помощью чисел. Текст состоит из кодовых точек: буквы a, цифры 5, буквы с диакритическим знаком è, иероглифа 中, эмодзи 🤗.
Каждой кодовой точке соответствует число от 0 до 0x10FFFF — всего около 1,1 млн возможных значений. В Unicode 17.0 задействована 159 801 кодовая точка.
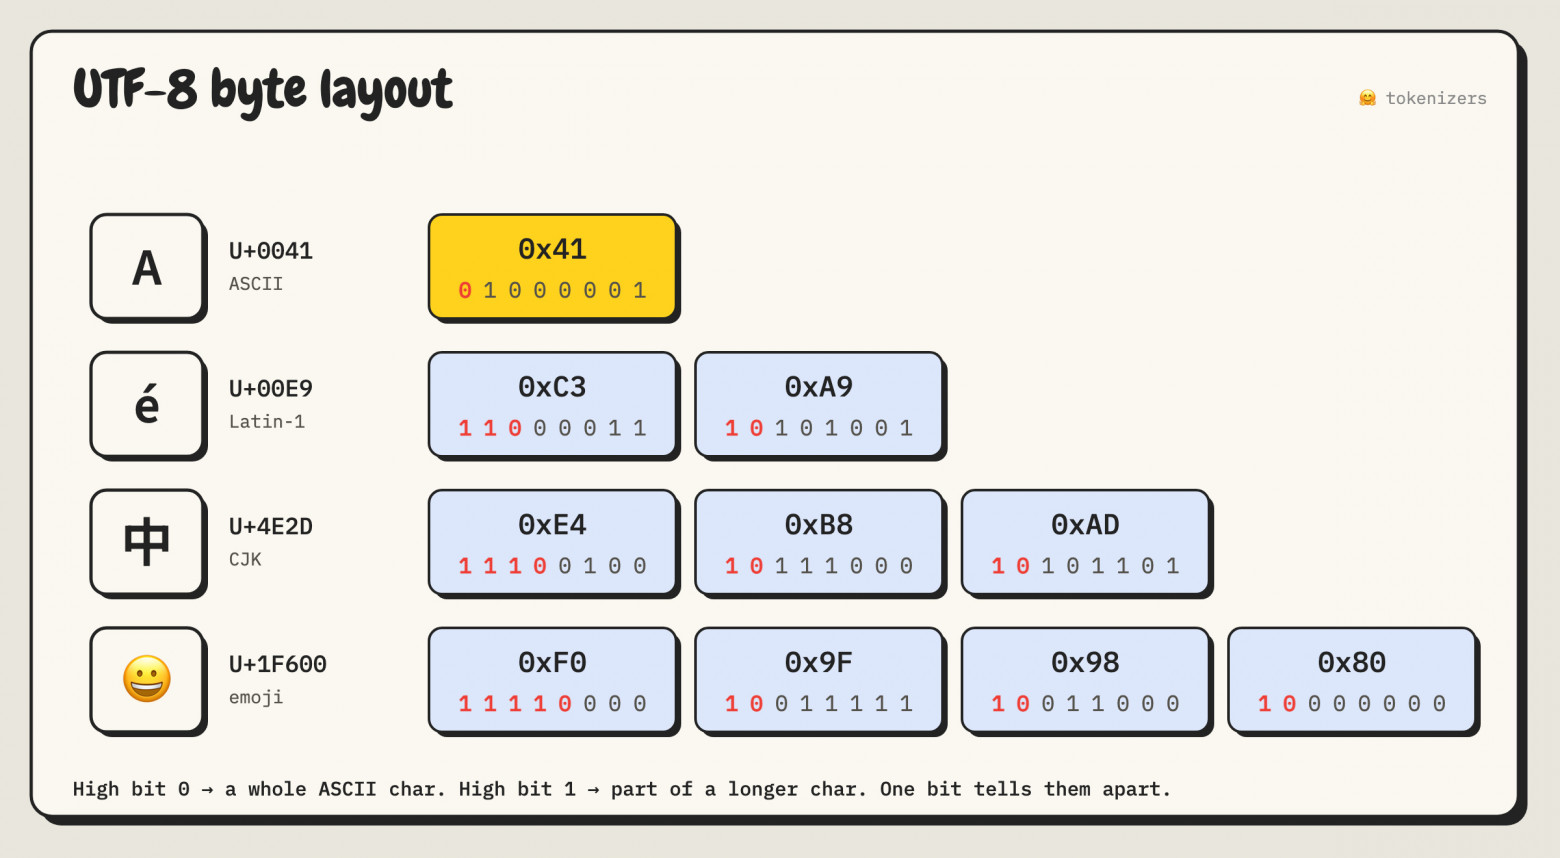
В UTF-8 каждая кодовая точка занимает от 1 до 4 байт. Эта кодировка используется практически повсеместно. Все 128 символов ASCII в ней представлены одним байтом с нулевым старшим битом, а остальные кодовые точки кодируются последовательностями из 2–4 байт, у которых старший бит первого байта равен 1. Запомните этот бит — мы к нему ещё вернёмся.
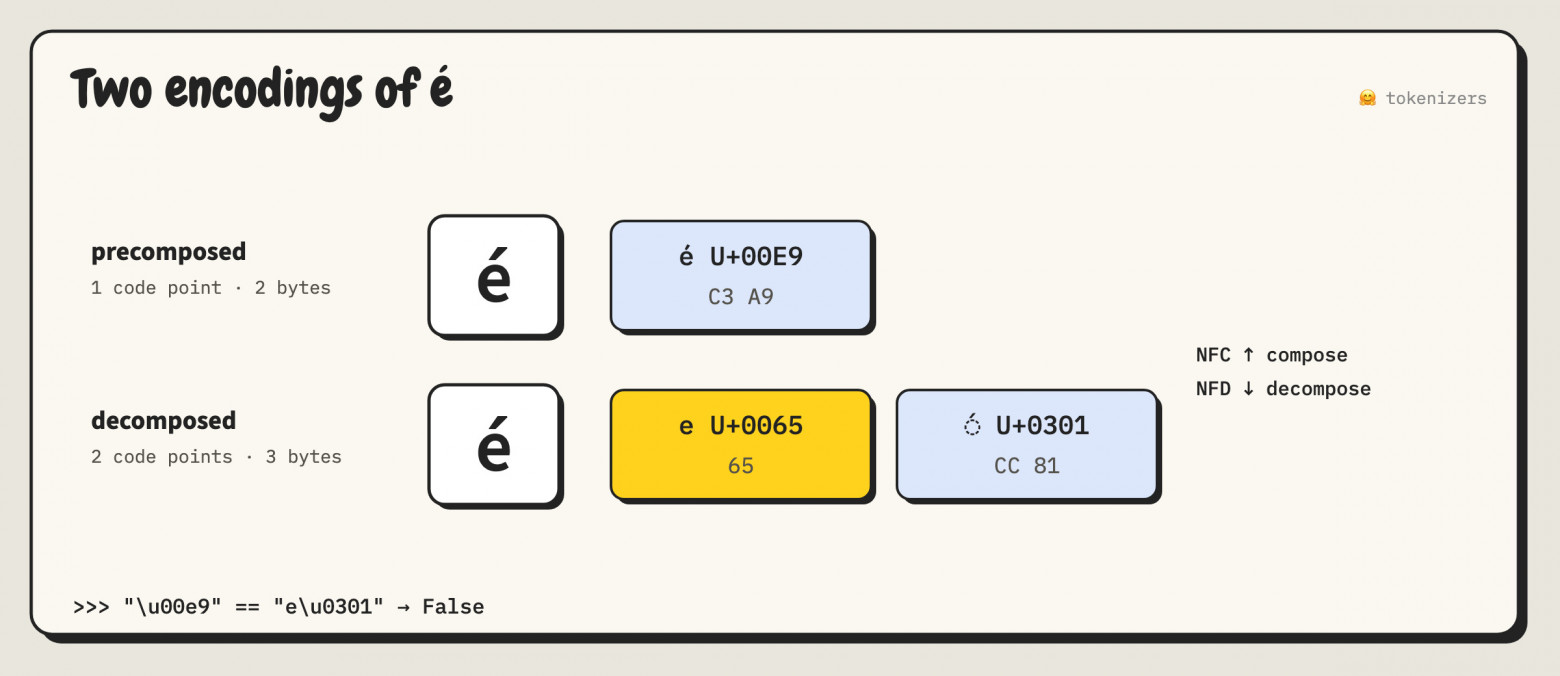
Один и тот же символ на экране может быть представлен по‑разному. То, что читатель воспринимает как один символ, называется графемным кластером. Он может состоять из одной или нескольких кодовых точек. Например, é можно записать одной кодовой точкой U+00E9 или двумя: e и следующей за ней U+0301 — комбинируемым знаком ударения.
К сожалению, é — простейший случай. Графемный кластер может состоять из гораздо большего числа компонентов:
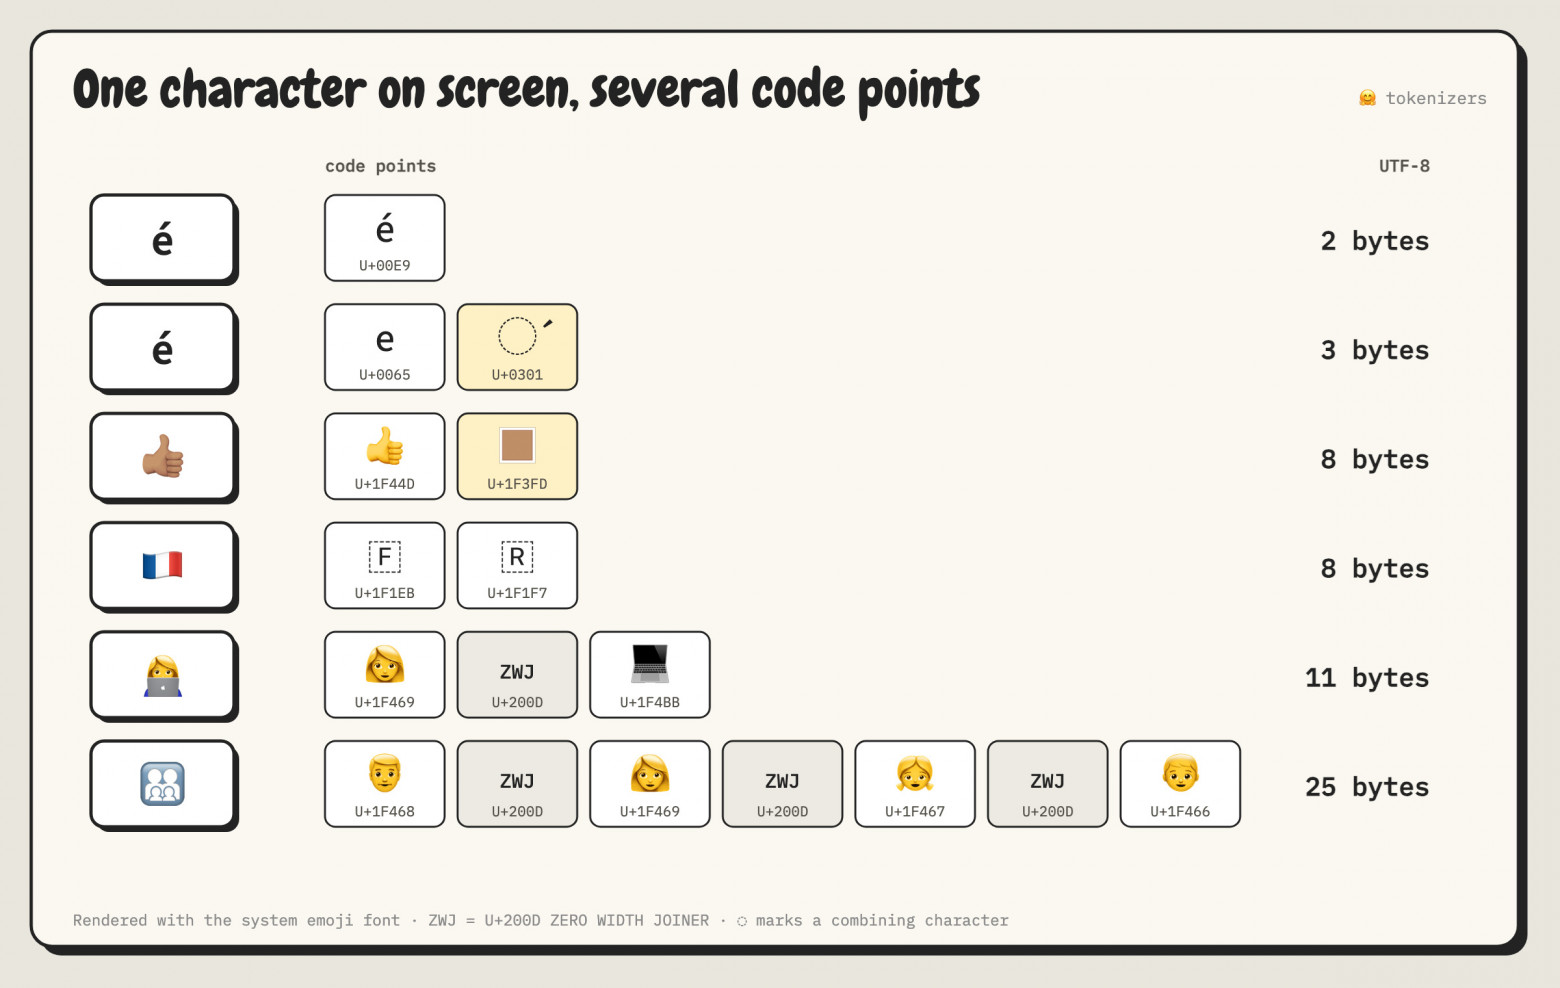
Для языковых моделей это проблема: две строки, которые выглядят для нас одинаково, могут превратиться в разные токены. Для этого и нужна нормализация — она выбирает один способ записи. Unicode определяет четыре стандартные формы нормализации:
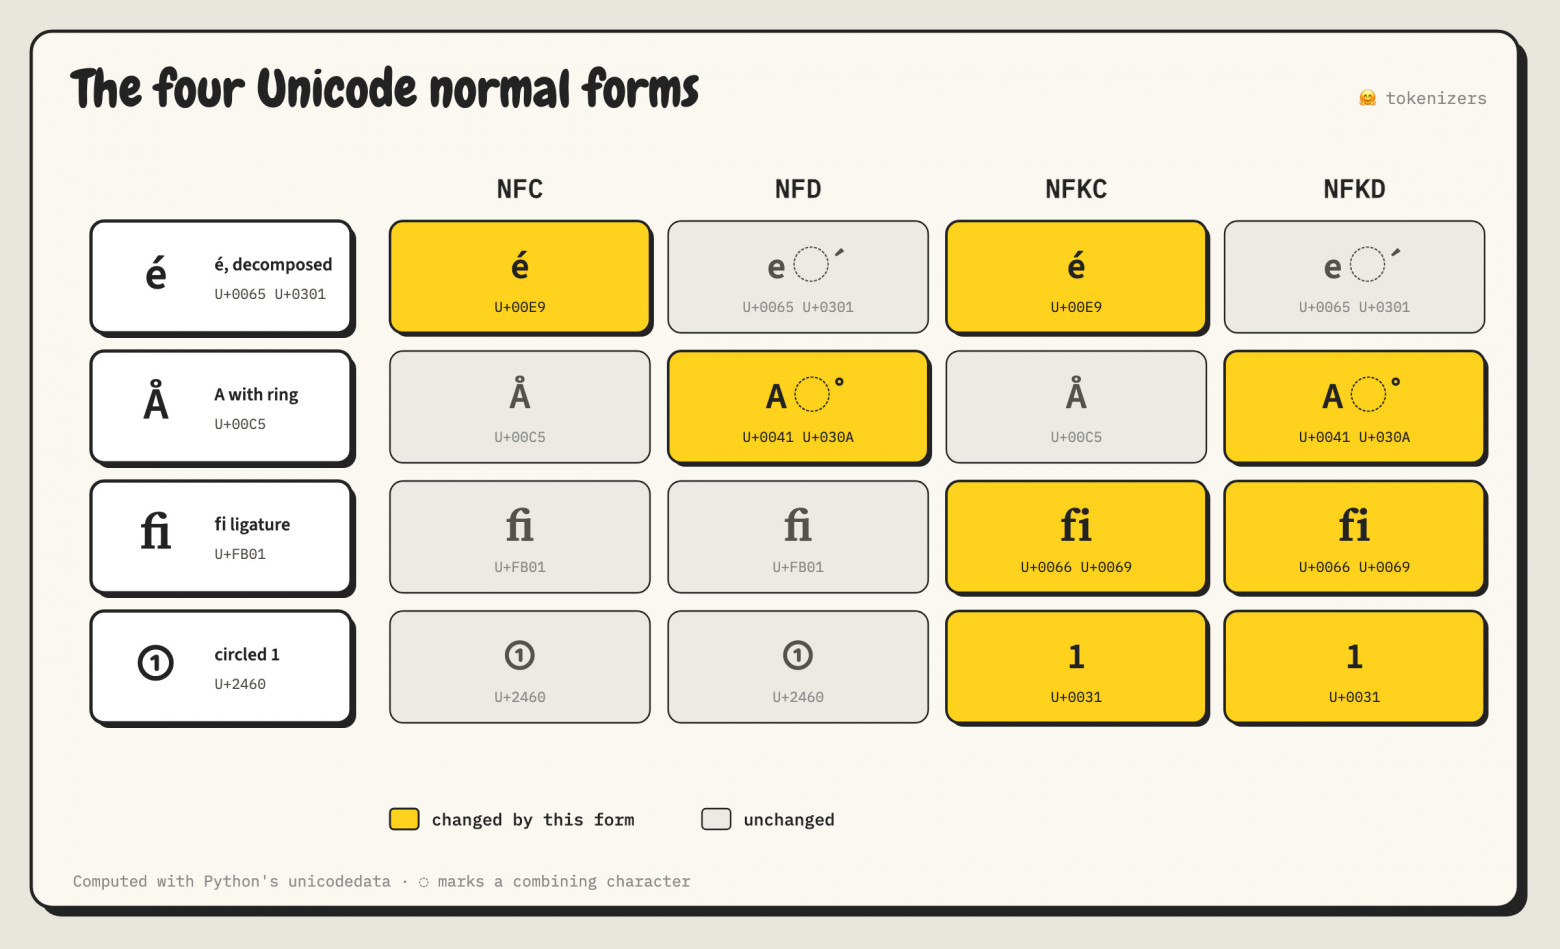
Нормализация BERT
Отлично, с нормализацией разобрались. Но почему BERT тратит на неё 88% времени?
BertNormalizer (с параметром lowercase=True, как в bert-base-uncased) выполняет пять операций в следующем порядке:
Очистка: удаляет управляющие символы и заменяет все пробельные символы (табуляции, переводы строк, пробелы Unicode) обычным пробелом
0x20.Китайские иероглифы: добавляет пробел с обеих сторон каждого идеографического символа CJK.
NFD: раскладывает каждый символ на составляющие (подробнее об этом в предыдущем разделе).
Удаление диакритических знаков: убирает комбинируемые знаки, выделенные при декомпозиции NFD.
Приведение к нижнему регистру.
Рисунок 9. Пять этапов нормализации BERT без учёта регистра, используемой в bert‑base‑uncased, all‑MiniLM и bge‑en.
В версиях 0.23 и 1.0 всё это реализовано как единый конвейер обработки символов (tokenizers/tk-encode/src/normalizers/bert.rs в ветке main, упрощённый вариант):
input.chars()
    .filter(|&c| !clean_text_removes(c)) // is_control(c): обращение к таблице Unicode
    .map(clean_text_map)                 // пробельные символы → ' '
    .flat_map(pad_chinese_char)          // ' ', c, ' '
    .nfd()                               // unicode-normalization
    .filter(|c| !c.is_mark_nonspacing()) // удаление диакритики: обращение к таблице Unicode
    .flat_map(char::to_lowercase)        // обращение к таблице Unicode
Для NFD и проверки диакритических знаков используются внешние зависимости: unicode-normalization и unicode_categories. Вот что происходит внутри is_mark_nonspacing():
pub static MARK_NONSPACING: &'static [char] = &[
    '\u{0300}', '\u{0301}', '\u{0302}', '\u{0303}',
    '\u{0304}', '\u{0305}', '\u{0306}', '\u{0307}',
    // … всего 1567 элементов, по одному на символ
];

fn table_binary_search(target: char, table: &'static [char]) -> bool {
    table.binary_search(&target).is_ok()
}
Это двоичный поиск по отсортированному массиву из 1567 символов (6 КБ). На каждую проверку приходится примерно 11 сравнений, и каждое сопровождается непредсказуемым для процессора ветвлением и переходом к другому участку памяти.
А код версий 0.23 и 1.0 выполнял такой поиск для каждого. Без. Исключения. Символа. Даже для букв s, l, o и w!
Как же это ускорить?
Профилируем данные
Профилирование кода показывает, на что уходит время. А профилирование данных помогает понять, какую работу вообще можно не выполнять.
Рассмотрим несколько особенностей реальных текстов в Unicode, которые помогут нам ускорить нормализацию.
Большая часть текста — ASCII
ASCII охватывает первые 128 кодовых точек, от 0x00 до 0x7F: цифры, знаки препинания, привычные пробельные символы и латинские буквы без диакритики. Вот как выглядит доля ASCII в текстах, на которых мы проводили бенчмарки:
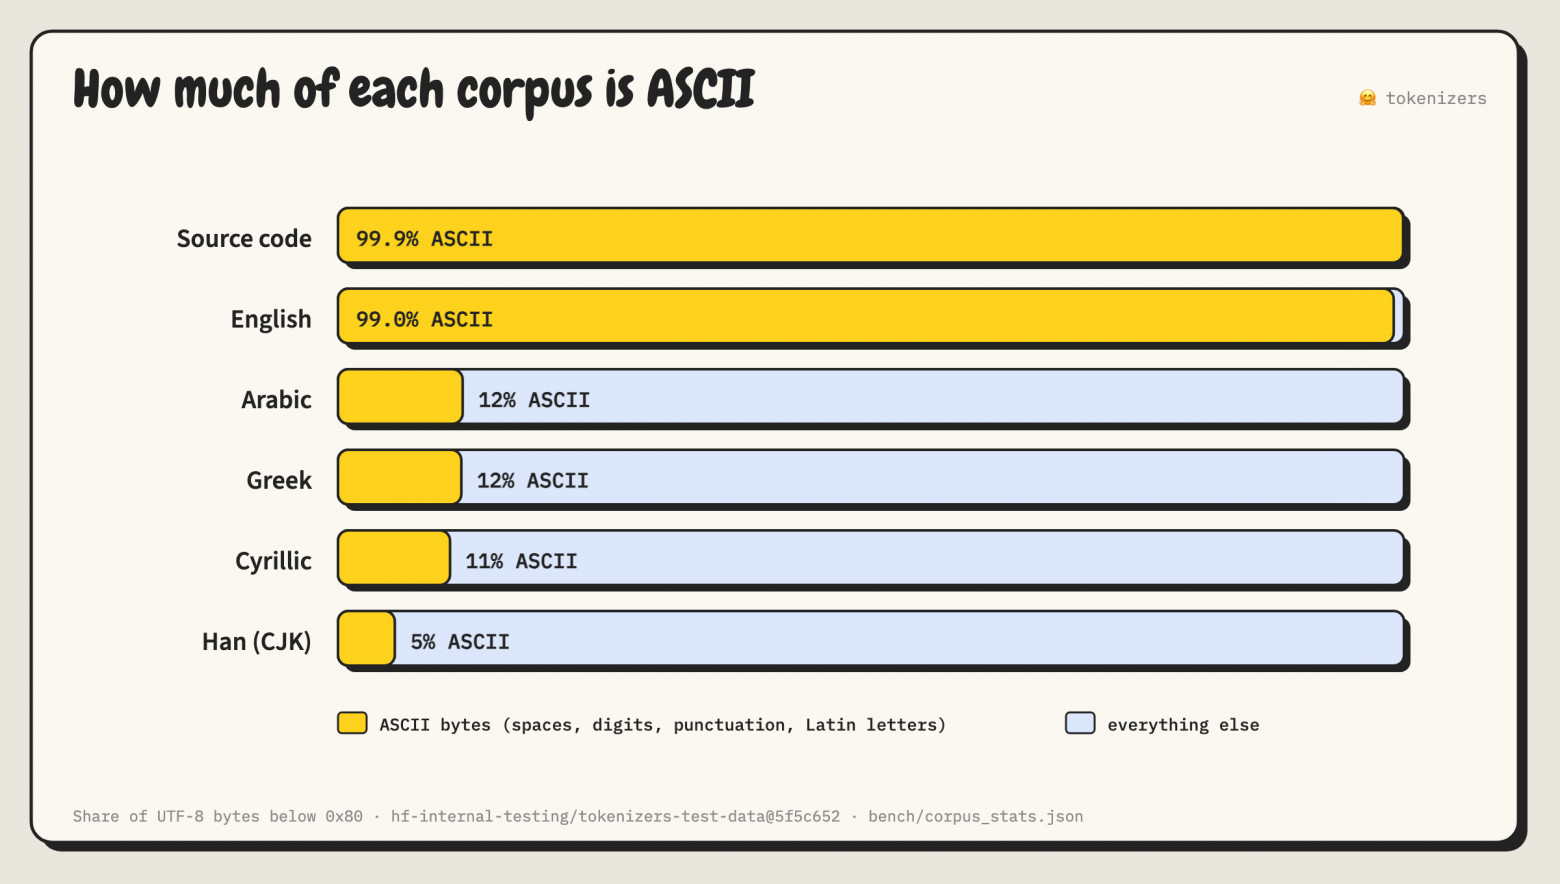
У ASCII есть несколько полезных для нас свойств:
Ни одна из форм нормализации не изменяет ASCII‑символы, а диакритический знак не может присоединиться к символу через ASCII‑символ. Поэтому при нормализации Unicode последовательные ASCII‑символы никогда не меняются и не переставляются местами.
ASCII‑символы легко приводить к нижнему регистру. Прописные и строчные буквы отличаются всего одним битом.
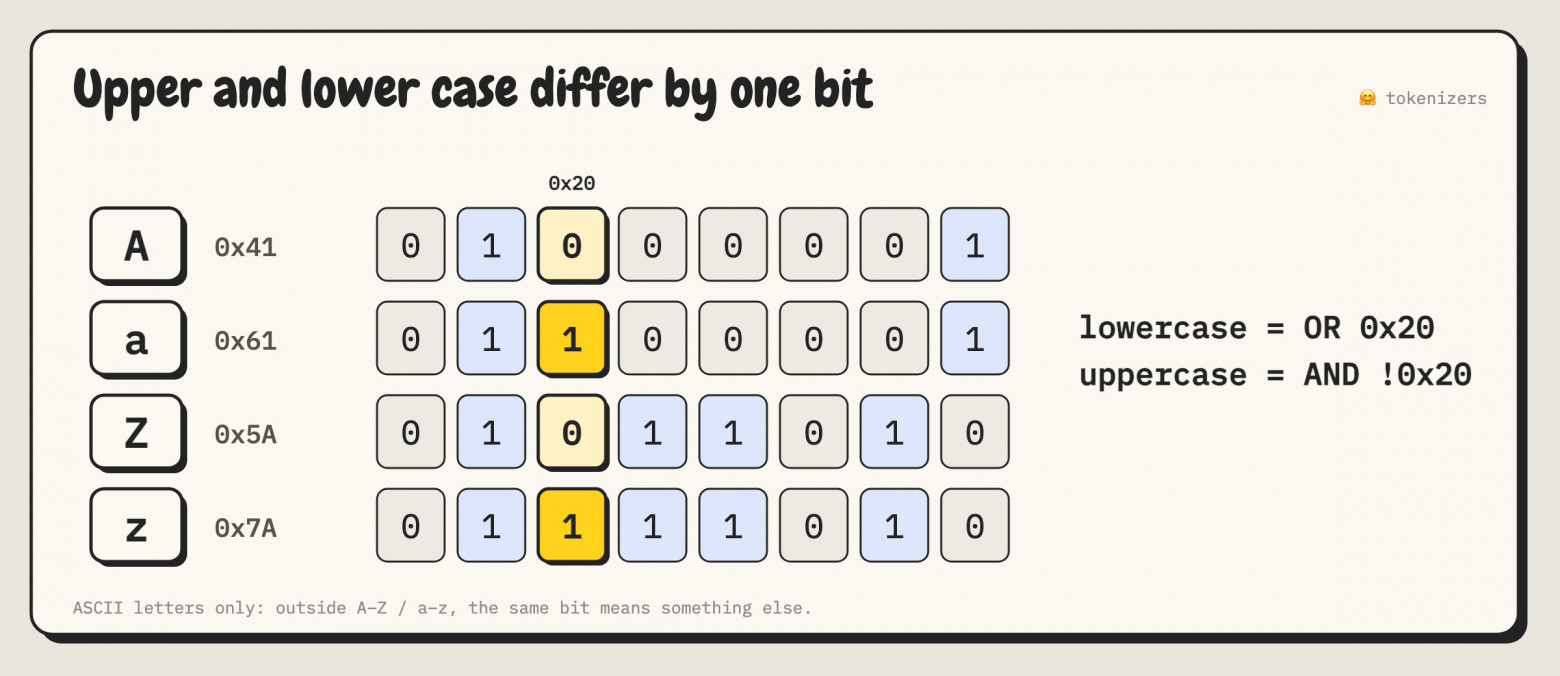
ASCII‑символы легко находить. В UTF-8 байт принадлежит ASCII тогда и только тогда, когда его старший бит равен нулю. Проще некуда!
А значит, непрерывные участки ASCII‑текста можно просто пропускать при нормализации. В английских текстах уже одно это позволяет избавиться почти от всей лишней работы.
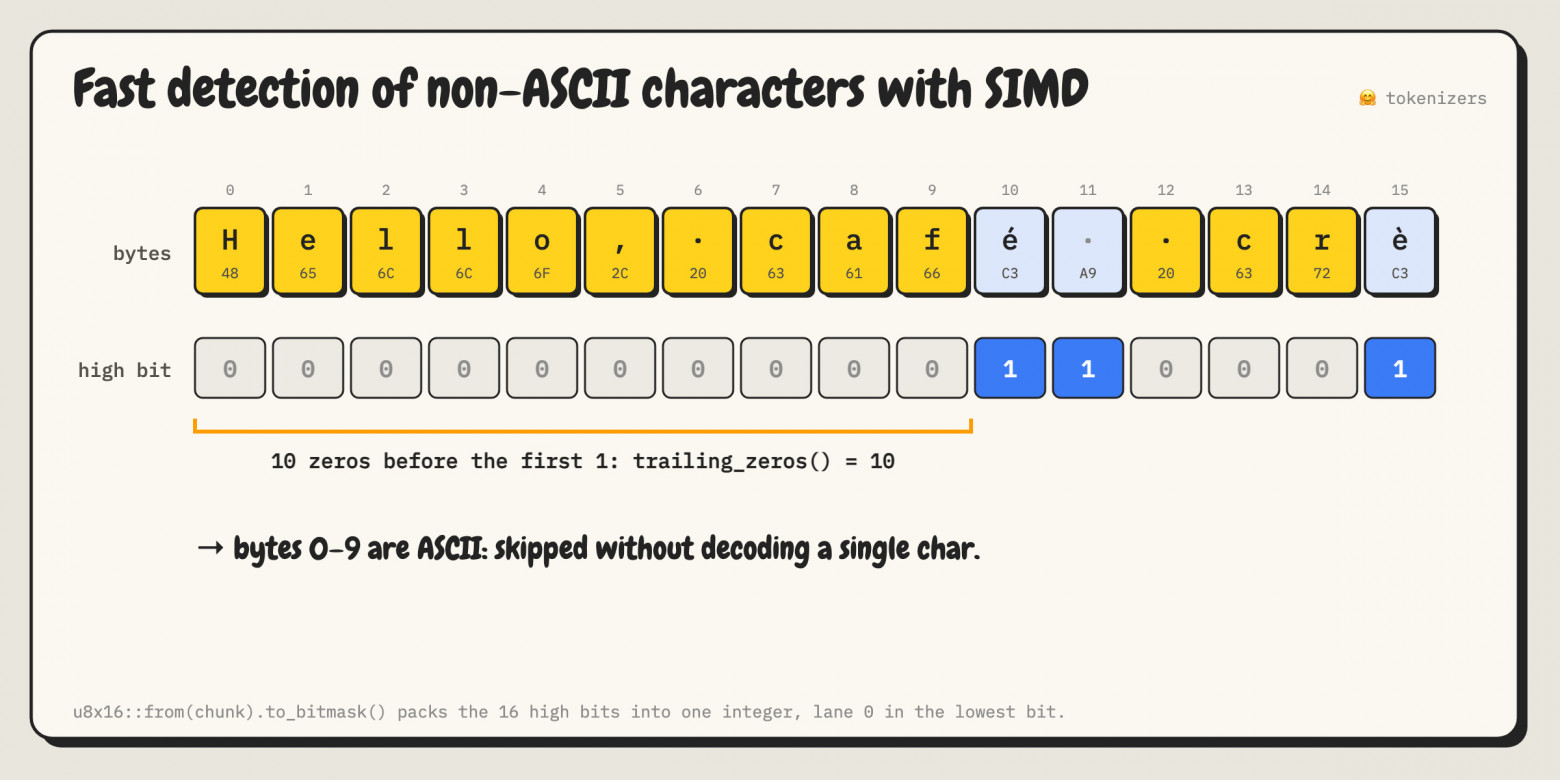
Чтобы пропускать такие участки максимально быстро, мы используем векторные инструкции процессора (SIMD, Single Instruction, Multiple Data), которые позволяют проверять сразу 16 байт:
Небольшое отступление про SIMD
Современные процессоры часто поддерживают операции со 128-битными регистрами, вмещающими 16 байт, и инструкции, которые обрабатывают все 16 байт одновременно. Нормализатор загружает 16 байт, одной инструкцией собирает их старшие биты в одно целое число и проверяет результат:
Если число равно нулю, все 16 байт относятся к ASCII. Весь блок можно пропустить: не декодировать, не обращаться к таблицам Unicode и даже не копировать.
Если число не равно нулю, ещё одна инструкция (подсчёт конечных нулевых битов) позволяет найти позицию первого байта, не относящегося к ASCII.
let mask = u8x16::from(chunk).to_bitmask(); // 16 старших битов, собранных в одно целое число

if mask != 0 {
    return offset + mask.trailing_zeros() as usize; // позиция первого байта вне ASCII
}
Примерно три инструкции на 16 байт вместо посимвольного декодирования и поиска в таблицах, как в старой реализации. Специфичные для BERT преобразования ASCII (обработка пробелов, управляющих символов и букв A‑Z) выполняются аналогично: сравниваем сразу 16 байт, а затем применяем одну операцию побитового ИЛИ с 0x20 к прописным буквам.
Остальные символы тоже идут группами
Причём в двух смыслах:
Кодовые точки одной письменности обычно расположены рядом. Например, кириллице соответствует диапазон из 256 последовательных кодовых точек:
U+0400–U+04FF.В одном фрагменте текста обычно используется очень мало письменностей. Русский абзац — это кириллица плюс пробелы и знаки препинания ASCII. Французский — преимущественно ASCII с небольшим количеством букв с диакритическими знаками.
А это отличная возможность для мемоизации (то есть кеширования результатов).
Всё, что нормализатору нужно знать о символе, — может ли нормализация как‑то на него повлиять: изменить сам символ или объединить его с соседним.
Поэтому при первой встрече с символом из определённого блока мы вычисляем ответ сразу для всех 256 кодовых точек этого блока и сохраняем 256 значений «да/нет».
После этого для любого символа из того же блока достаточно одного чтения из памяти вместо двоичного поиска. Магия!
Благодаря тому, что в тексте символы одной письменности обычно идут рядом, мы получаем высокий процент попаданий в кеш.
А компактное расположение данных в памяти делает каждое обращение к нему быстрым: один блок занимает четыре строки кеша по 64 байта, которые остаются в самом быстром кеше рядом с ядром процессора.
Большая часть текста уже нормализована
И последнее, но не менее важное. Даже символы, которые могут измениться при нормализации, обычно остаются прежними. Например, модель, использующая NFC, чаще всего получает текст, уже приведённый к NFC.
Поэтому мы решили немного «полениться»:
Быстро пропускаем неизменяемые участки: если с фрагментом текста ничего делать не нужно, мы даже не копируем его.
Выделяем память только при необходимости: если ничего не изменилось, возвращаем исходную строку без выделения дополнительной памяти. При первом реальном изменении выделяем память под результат один раз, а неизменённые участки копируем целыми блоками.
Интерактивная демонстрация
Ладно, технических подробностей было немало. Теперь можно посмотреть, как всё работает на практике. Мы подготовили интерактивную демонстрацию, в которой можно пошагово проследить весь процесс на собственном тексте прямо в браузере и увидеть, что происходит до и после нормализации.
Демонстрация использует настоящий Rust‑код, скомпилированный в WebAssembly.
Результаты
Итак, мы разобрались, почему BERT работает медленно, что можно ускорить и за счёт чего. Теперь посмотрим на результаты.
Флеймграф
Для начала взглянем на обновлённый флеймграф (если забыли, как его читать, вернитесь к разделу «Почему так медленно»).
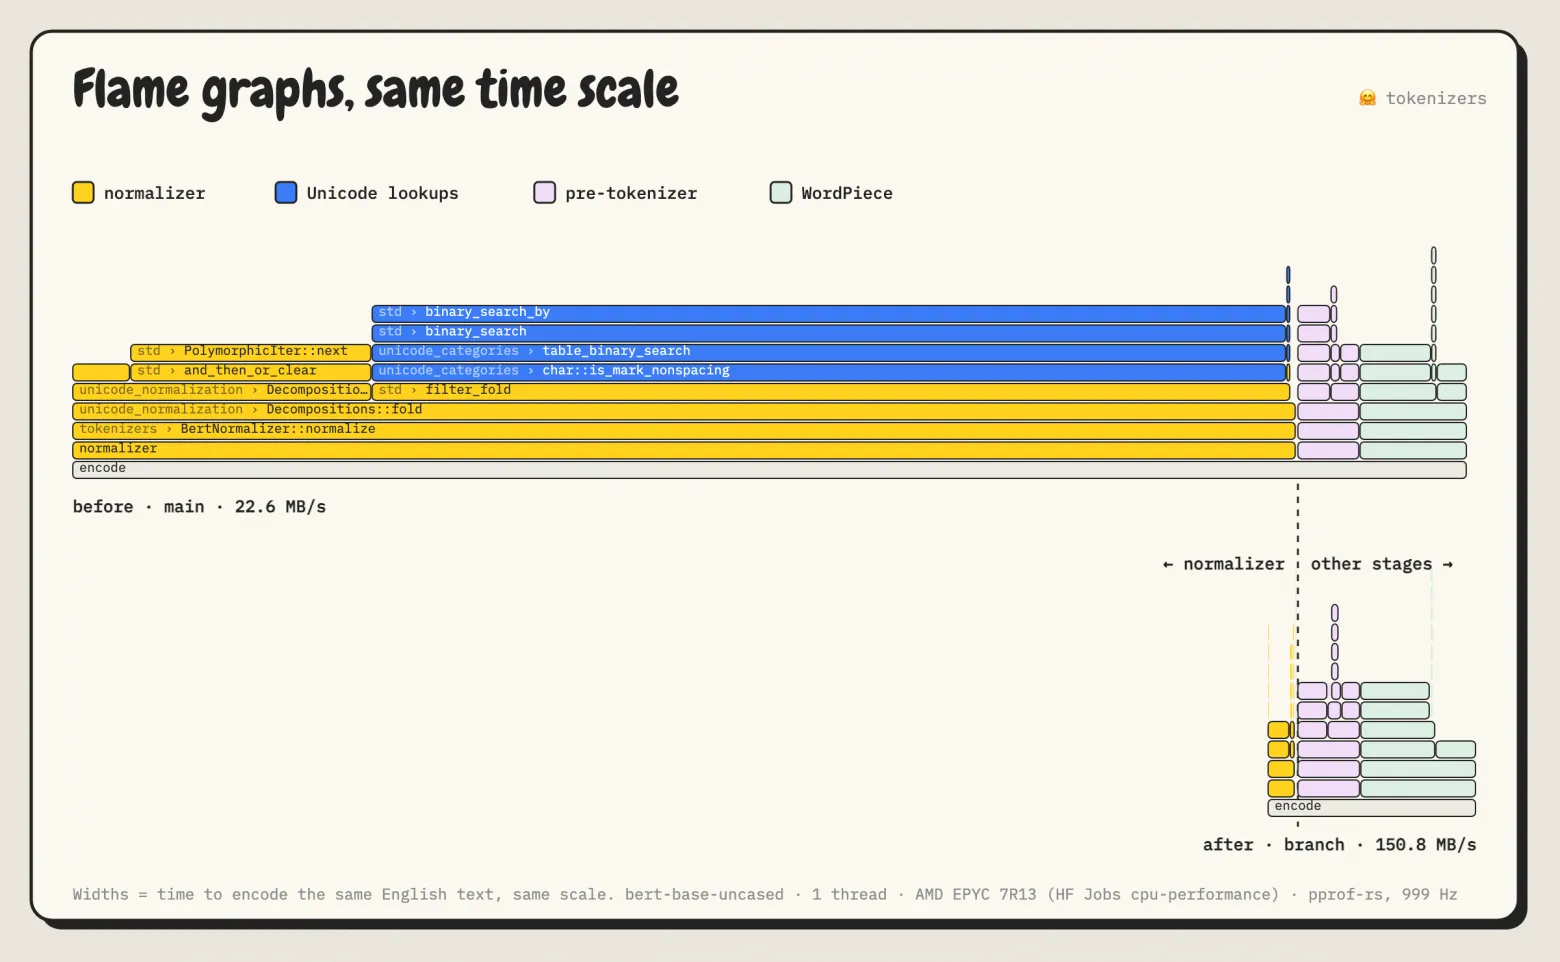
Приятная картина, правда? Тот же текст, тот же масштаб, но теперь на нормализатор приходится всего 13% времени токенизации вместо 88%.
Ускорение полного процесса токенизации
BERT
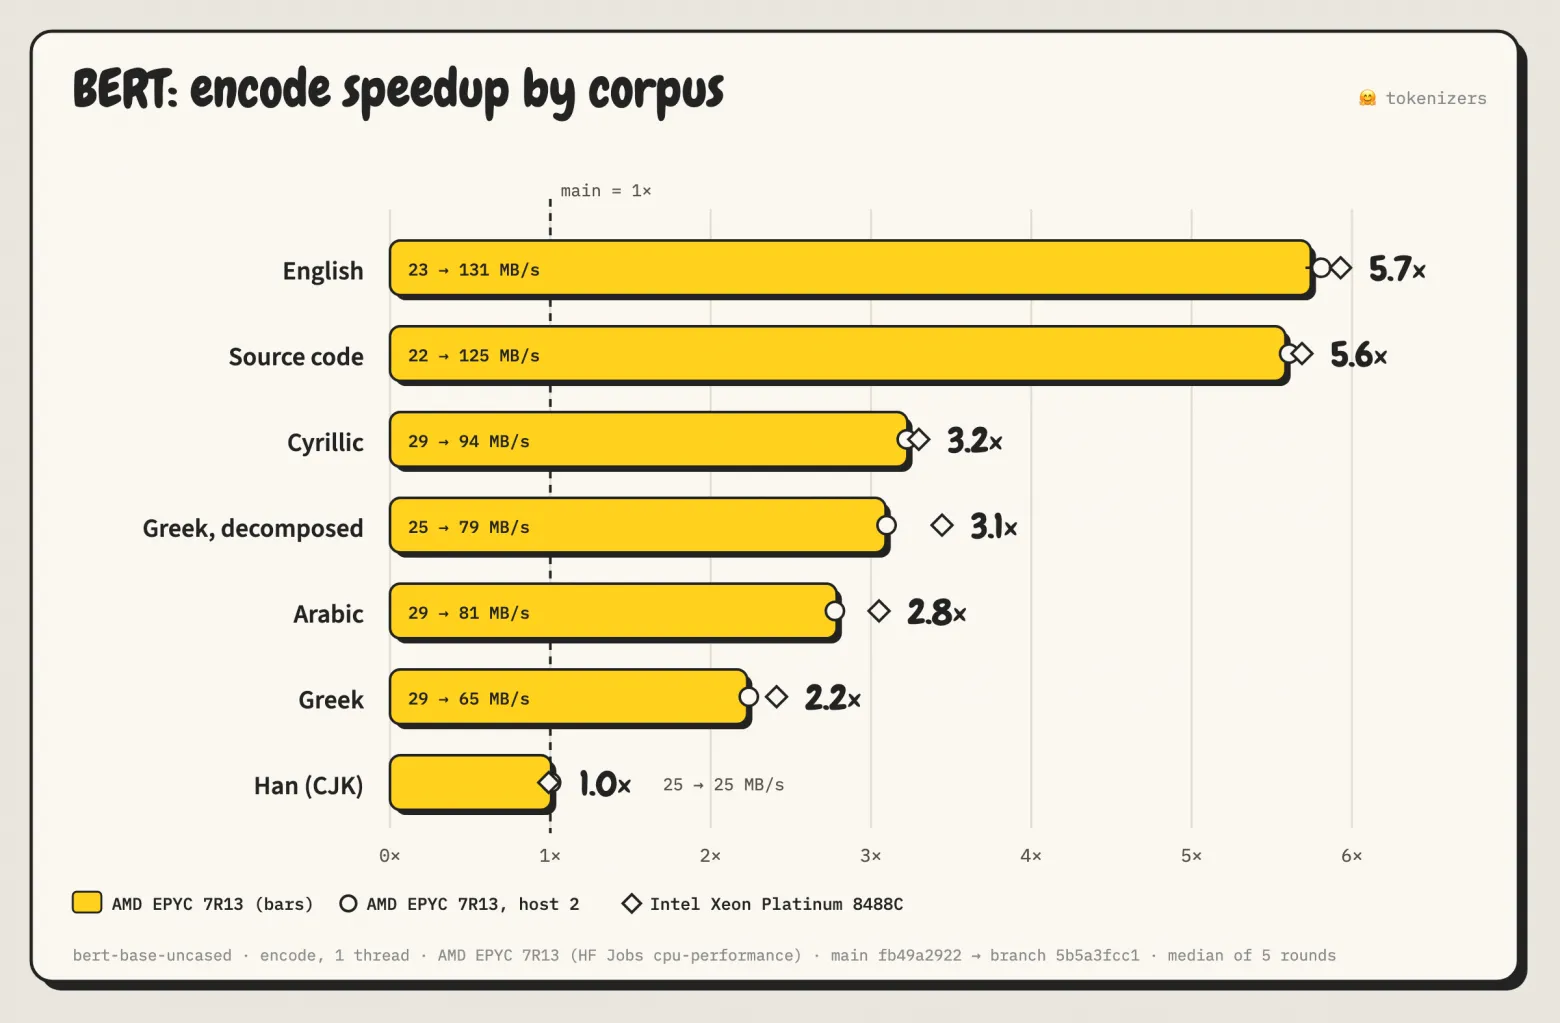
Чем больше в тексте ASCII, тем заметнее ускорение:
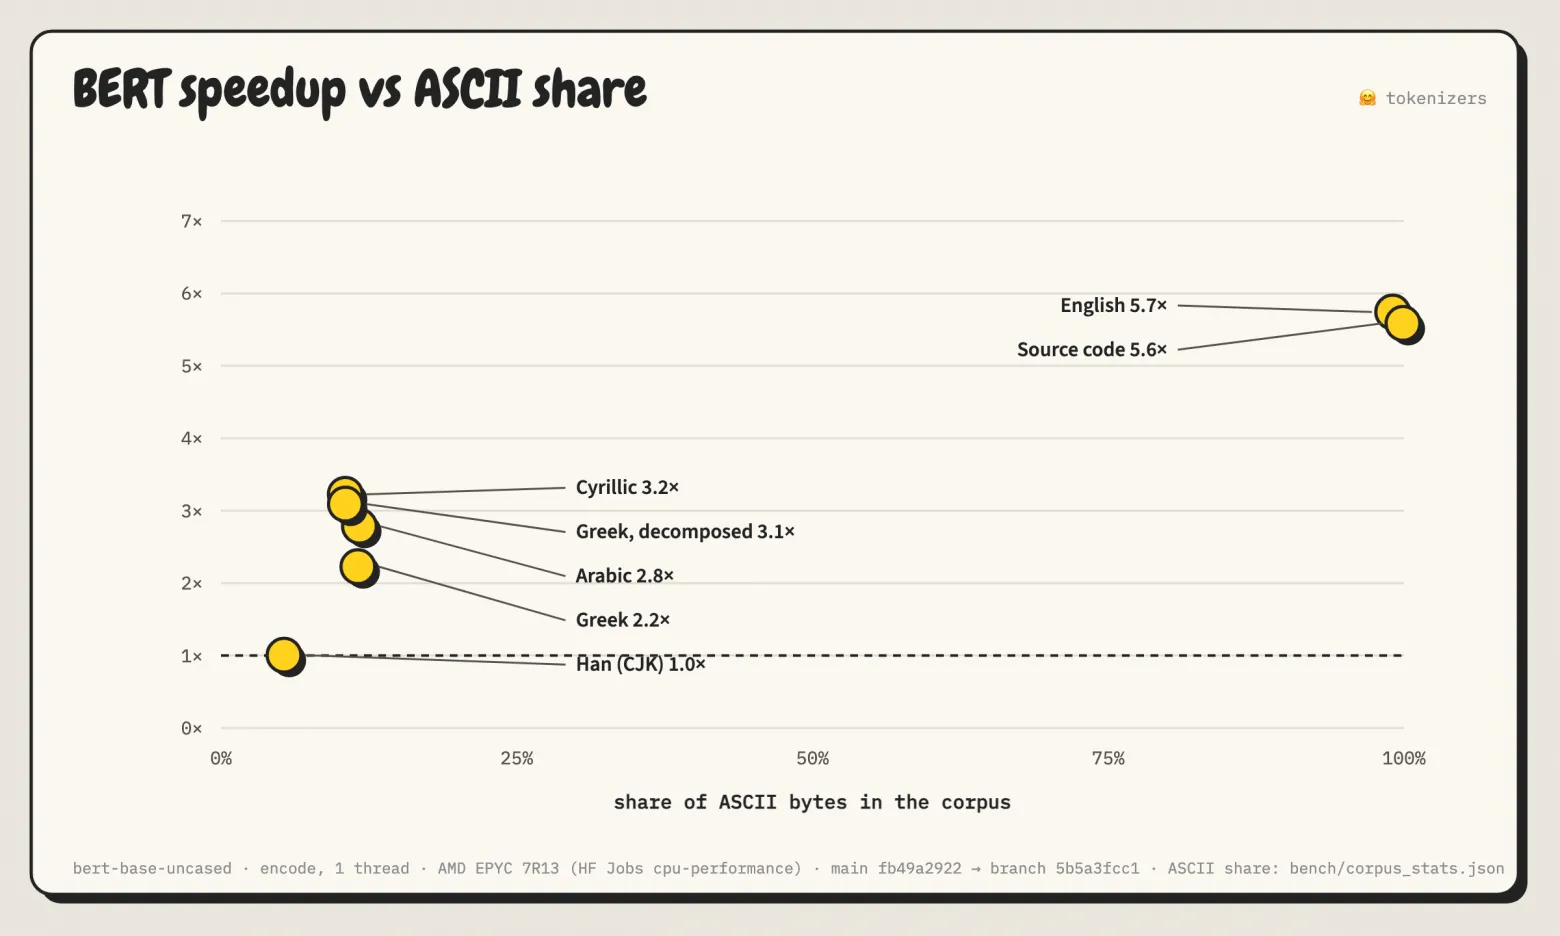
Сильнее всего ускорилась обработка английского текста и исходного кода, главным образом благодаря пропуску участков ASCII. В русских, греческих и арабских текстах доля ASCII составляет всего около 11%, но даже здесь мы получили ускорение в 2,2–3,2 раза — уже за счёт кеша блоков кодовых точек. А вот китайский текст вообще не ускорился. Почему так получилось, разберём ниже, в разделе об ограничениях.
ModernBERT (NFC)
ModernBERT использует стандартную нормализацию NFC:
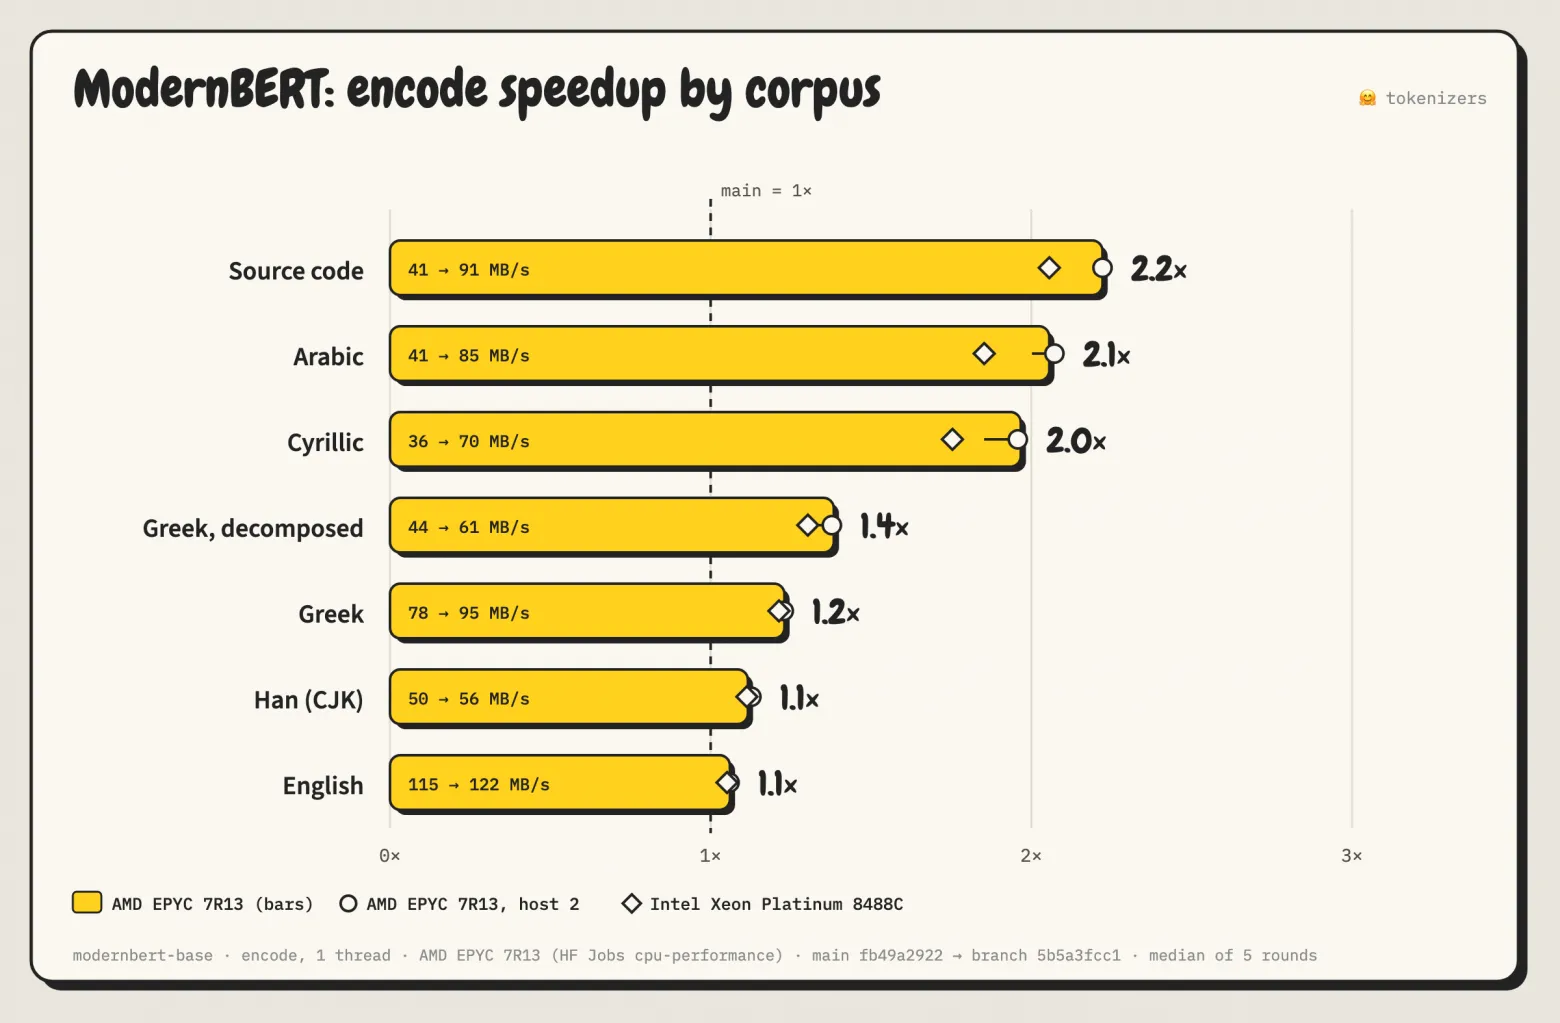
Здесь ускорение достигается главным образом за счёт кеша. В ветке main нормализатор NFC уже умел пропускать ASCII, поэтому обработка английского текста почти не ускорилась (1,06 раза), зато исходный код, арабский и русский тексты стали обрабатываться примерно вдвое быстрее.
Ограничения
Мы добавили дополнительные механизмы оптимизации, но на очень коротких строках накладные расходы на них могут оказаться выше выигрыша.
Некоторые письменности, например CJK, тоже почти не ускорились: ASCII в них очень мало, а в BERT каждый китайский иероглиф всё равно нужно окружать пробелами.
В результате дополнительные операции выполняются, а пользы от оптимизаций почти нет.
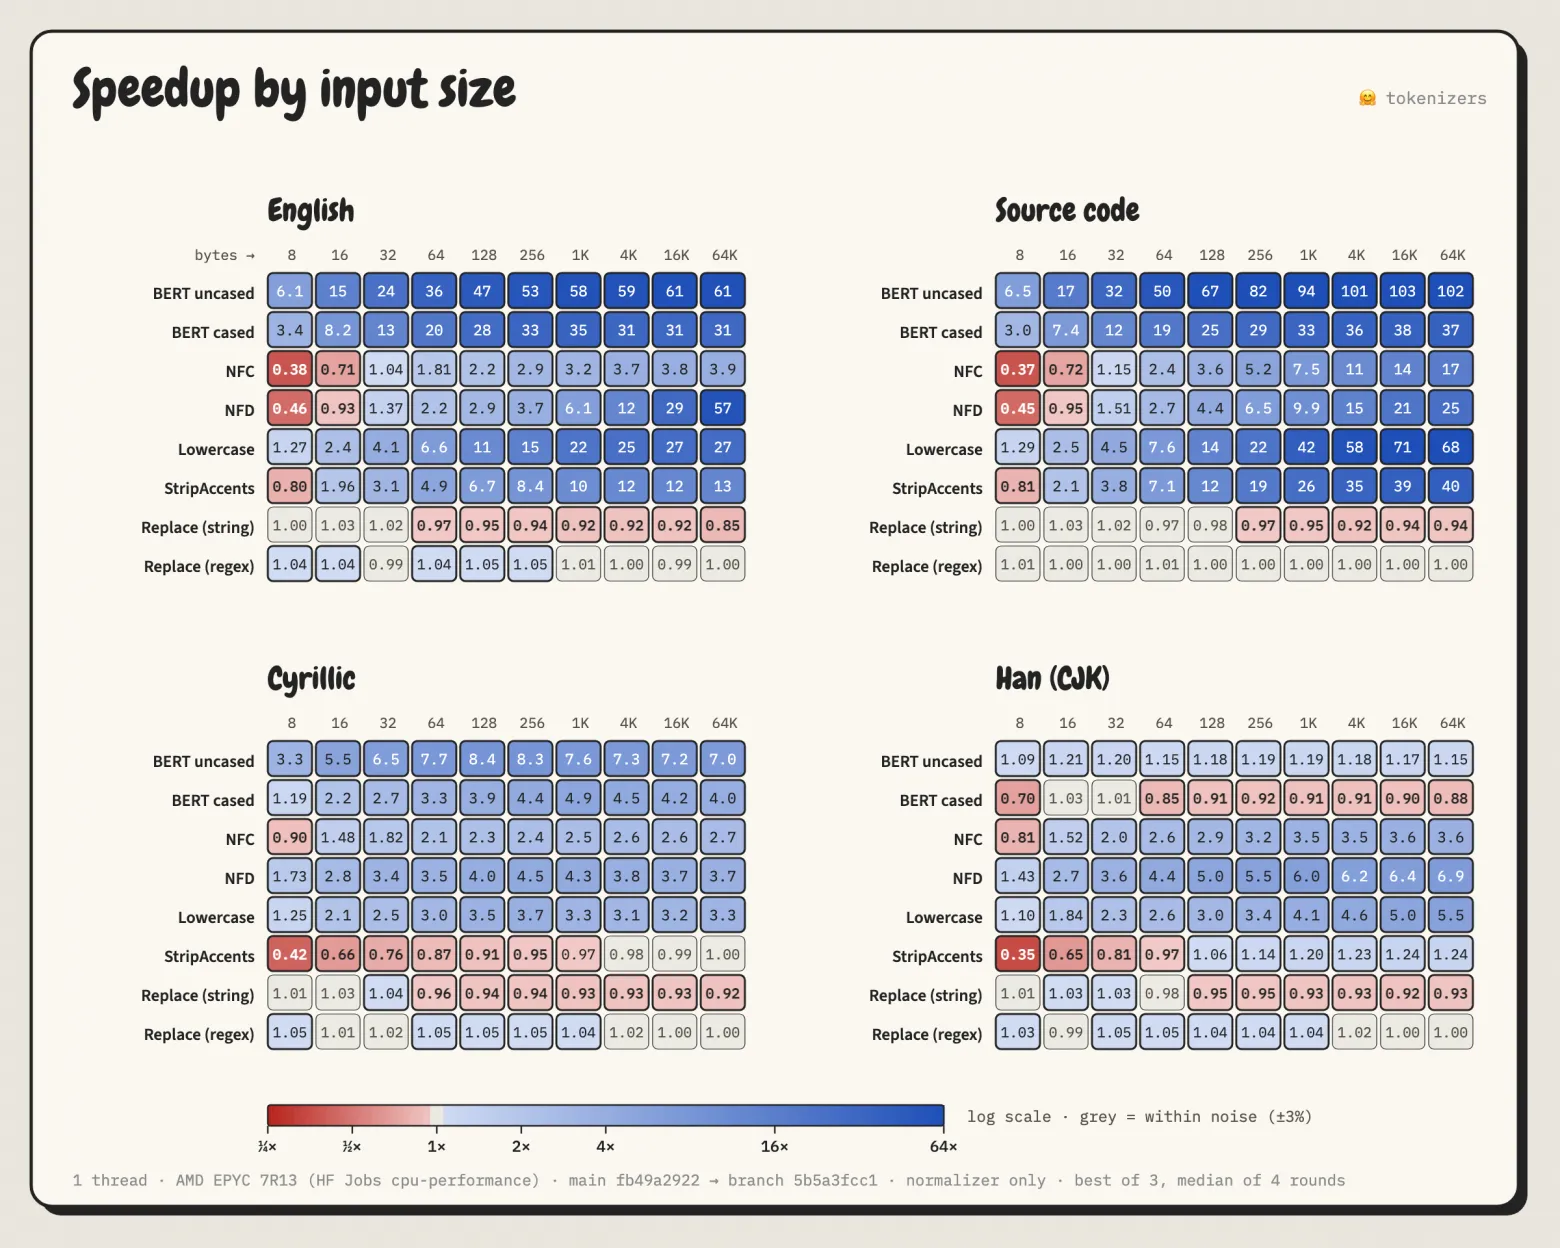
Очень короткие строки (≤ 32 байт) могут обрабатываться медленнее. В худшем случае, при удалении диакритических знаков (
StripAccents) из 8 байт китайского текста, скорость падает до 0,35 от исходной.BERT с учётом регистра обрабатывает китайский текст на 8–15% медленнее при размере входных данных от 64 байт.
Приложения
A. Уровни памяти процессора и задержки доступа
Процессор не читает данные из памяти по одному байту. Он загружает целые строки кеша по 64 байта в небольшие быстрые кеши рядом с ядром.
Чтение из кеша L1 занимает около наносекунды, а обращение к оперативной памяти — примерно 90 наносекунд.
Именно поэтому кеш блоков кодовых точек, описанный в разделе «Остальные символы тоже идут группами», работает так быстро.
Двоичный поиск по таблице размером 6 КБ требует переходов между разными участками памяти, причём каждое сравнение сопровождается ветвлением, которое процессору трудно предсказать.
А блок из 256 готовых ответов занимает всего четыре строки кеша, которые остаются в L1, пока в тексте продолжают встречаться символы той же письменности.
B. Как воспроизвести измерения
Скажу очевидную вещь, но всё же: скорость в МБ/с зависит от железа. Причём результаты могут отличаться не только между компьютерами, но и на одной машине в зависимости от того, что на ней запущено.
Абсолютные значения пропускной способности будут меняться в зависимости от модели процессора, состояния подсистемы памяти и даже от того, не играете ли вы параллельно в свежую Call of Duty на ультранастройках...
А вот коэффициенты ускорения куда надёжнее. Мы провели измерения на двух машинах с AMD EPYC 7R13 и одной с Intel Xeon Platinum 8488C (разные машины обозначены маркерами на графиках), используя по одному потоку. Результаты по коэффициентам ускорения различались всего на несколько процентов.
Чтобы эксперимент можно было воспроизвести, я подготовил весь необходимый код и выложил его в репозиторий на GitHub.
Вот полная конфигурация, которую мы использовали для получения результатов на графиках этой статьи:
Машины. Мы запускали бенчмарки через Hugging Face Jobs на двух машинах с AMD EPYC 7R13 (конфигурация
cpu-performance), а также на одном внутреннем сервере с Intel Xeon Platinum 8488C. Прежде чем доверять результатам, мы сравнили одну и ту же бинарную сборку с самой собой, чтобы оценить разброс измерений из‑за работы системы. На машинах с EPYC результаты между прогонами различались на 0,35%, на Xeon — примерно на 2%.Что сравнивали. Ветку
mainбиблиотекиtokenizers(на несколько коммитов позже1.0.0-rc2, коммитfb49a29) и ветку с оптимизациями (5b5a3fc). Обе версии собирались из исходников одним и тем же компилятором (rustc 1.99.0) с параметрамиlto = "fat"иcodegen-units = 1. Для графика сравнения релизов версию 0.23.2 брали изcrates.io.Как измеряли. Один поток, закреплённый за одним ядром процессора. В каждом измерении корпус текста размером 5–6 МБ многократно токенизировался в цикле в течение 5 секунд. Сначала выполнялся один прогревочный прогон, затем ещё пять прогонов, в которых
mainи ветка с оптимизациями чередовались. Так постепенные изменения производительности системы одинаково влияли на обе версии. В качестве итогового результата использовали медиану коэффициентов ускорения, рассчитанных для каждого прогона. Доля процессорного времени, отобранного другими пользователями сервера, не превышала 0,002%.Одинаковые токены на выходе. При каждом запуске вычислялся хеш полученных идентификаторов токенов. Для всех тестовых корпусов хеши полностью совпадали между
main, веткой с оптимизациями и версией 0.23.2.Тестовые корпуса. Данные из
hf-internal-testing/tokenizers-test-data, ревизия5f5c652: тексты на английском, русском, греческом, арабском и китайском языках, а также смешанный исходный код. Отдельный корпус греческого текста с декомпозицией представлял собой тот же греческий текст, приведённый к форме NFD.Размеры входных данных. Для отдельных замеров производительности нормализатора (раздел «Ограничения») использовались фрагменты от 8 байт до 64 КБ. На каждую комбинацию условий приходилось около 4 МБ обработанных данных. Из трёх измерений выбирался лучший результат, всего проводилось четыре раунда. Контрольное сравнение бинарной сборки с самой собой позволило определить погрешность измерений (±3%).
Профилирование. В контейнерах Hugging Face Jobs не удалось запустить
perf, поэтому флеймграфы строились с помощьюpprof-rs, который собирал данные профилирования непосредственно внутри процесса с частотой 999 Гц. Результаты дополнительно проверили по количеству выполненных инструкций, измеренному черезcallgrind, исключив затраты на загрузку токенизатора. При токенизации 1 МБ английского текста число инструкций сократилось с 482 млн до 72 млн (в 6,7 раза), а доля инструкций нормализатора снизилась с 87% до 12%.
Если вы работаете с языковыми моделями, важно понимать, как они обрабатывают текст ещё до того, как начинают строить эмбеддинги или генерировать ответы. Разобраться в устройстве LLM и принципах их работы поможет бесплатный урок:
12 ноября, 20:00. «Что надо знать про работу LLM моделей». Записаться
Больше открытых уроков ноября по искусственному интеллекту, разработке и не только смотрите в дайджесте.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.