Нужен ли Kubernetes сервису с одной базой данных? Четыре способа запуска и границы между ними
У вас небольшой сервис в облаке. Он работает, но проект растет: в команде больше разработчиков, появляются фоновые задачи, пользователи ждут стабильной работы. Пора менять инфраструктуру или текущая схема еще справится?
В статье решил сравнить четыре способа запустить одно и то же приложение — от обычной виртуальной машины до managed-платформы. Посмотрим, что команда делает сама, что берет на себя провайдер и когда нужен Kubernetes.
Эта статья для бэкенд-разработчиков, DevOps, SRE и тимлидов. Если вы работали с виртуалками и Docker, но пока присматриваетесь к Kubernetes — велком под кат.
Исходная ситуация: что нужно нашему сервису
Возьмем один сервис и одинаковые требования к его работе. Так мы сможем сравнить схемы на одном примере.
В нашем сервисе есть:
HTTP API на Python, Go или Node.js;
PostgreSQL для данных;
Redis для кеша и очереди фоновых задач;
один или несколько воркеров, которые забирают задачи из очереди.
Что требуется от сервиса:
Перезапуск после сбоя. Если процесс упал, он должен подняться автоматически.
Предсказуемые релизы. Хотим обновлять приложение без простоя; допустимый перерыв определяют требования продукта.
Отдельный staging. Тестовое окружение не должно зависеть от production или влиять на него.
Рабочие бэкапы. Делаем резервные копии PostgreSQL и регулярно проверяем, что можем восстановить базу.
Мониторинг. Следим, доступен ли API, как быстро он отвечает и сколько возвращает ошибок 5xx.
Разберем, как выполнить эти требования в каждой схеме: что уже умеют инструменты, что нужно настроить и что команде придется поддерживать.
Сравним четыре схемы:
А. API, воркеры, PostgreSQL и Redis — на одной VM без контейнеров.
Б. Те же компоненты — в Docker Compose на одной VM.
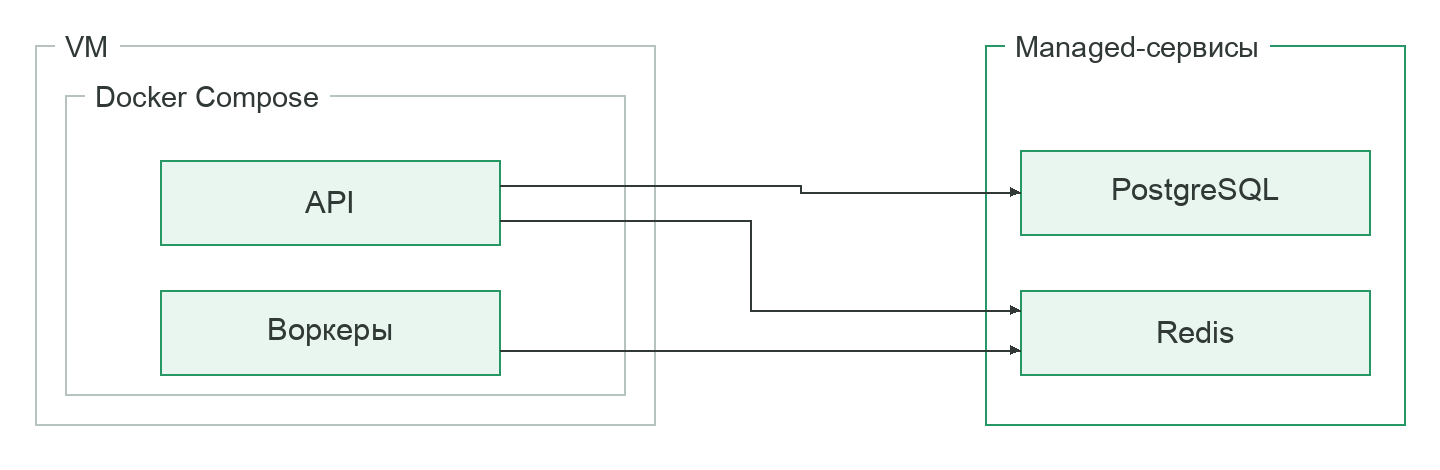
В. API и воркеры — в Compose, PostgreSQL и Redis — в managed-сервисах.
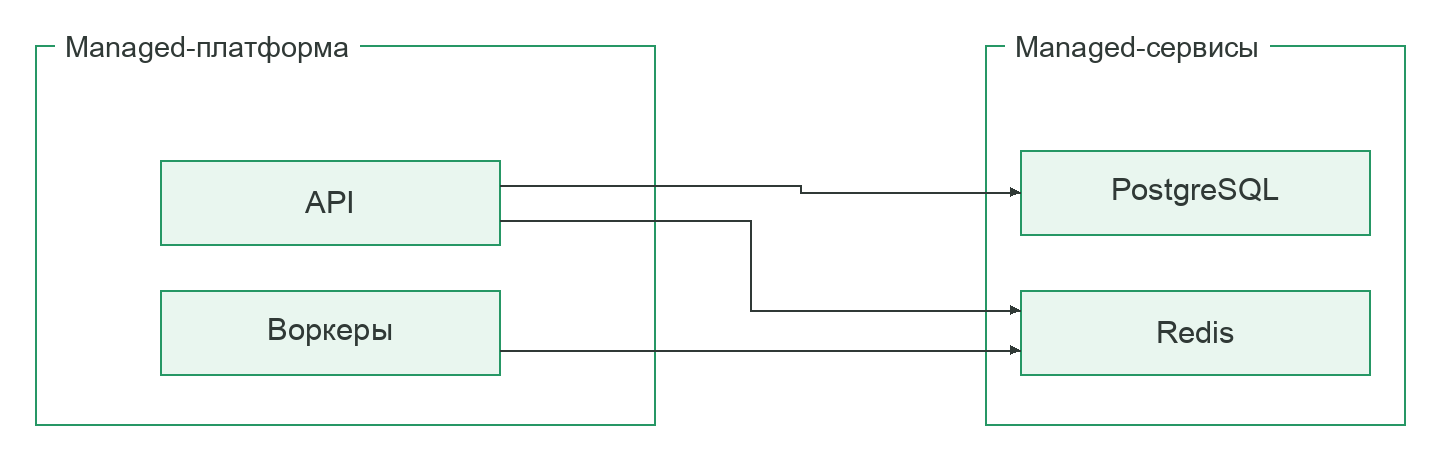
Г. API и воркеры — на managed-платформе, PostgreSQL и Redis — в managed-сервисах.
Это самостоятельные варианты, а не ступени роста. Решения можно сочетать: например, подключить managed-базу к приложению на VM без контейнеров.
Схема А. Все на одной виртуальной машине без контейнеров
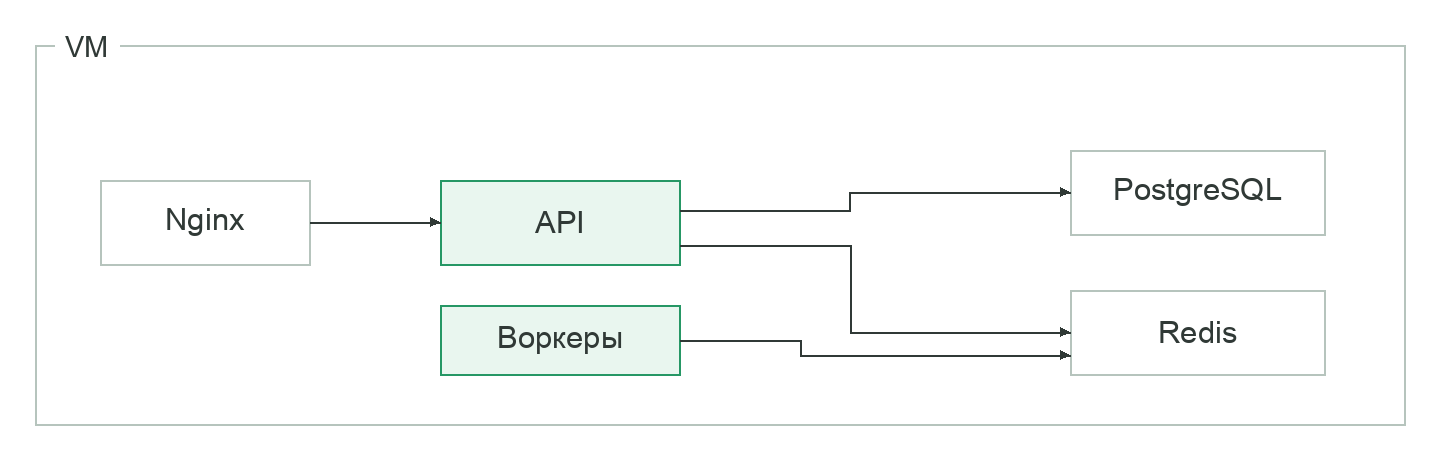
Берем виртуальную машину, например Evolution Compute. Ставим зависимости, runtime приложения, PostgreSQL и Redis. Systemd запускает процессы и следит за ними, Nginx принимает запросы перед приложением.
Настройки описываем в Ansible, сборку и деплой запускаем через CI/CD. Команда обслуживает ОС, зависимости и службы, а также готовит и проверяет сценарий восстановления после сбоя.
Что с требованиями
Автоматический рестарт. В unit-файле systemd задаем Restart=on-failure или Restart=always — в зависимости от того, когда нужно перезапускать процесс. Но запущенный процесс еще не означает рабочий сервис: если API не может подключиться к PostgreSQL, один рестарт проблему не решит.
Релизы без простоя. На одной VM можно настроить blue-green-деплой: запустить новую версию на другом порту, проверить ее, переключить Nginx и остановить старую. Команда сама пишет и поддерживает этот сценарий. Отдельно нужно продумать миграции БД и совместимость версий.
Staging. Выделяем отдельную VM и настраиваем ее теми же Ansible-плейбуками, что и production. Так проще сохранять одинаковые настройки. Плейбуки и процесс деплоя поддерживает команда.
Бэкапы. Для PostgreSQL делаем логические дампы через pg_dump или физические резервные копии. Чтобы вернуть базу к конкретному моменту, нужны физические копии и архив WAL — журнала изменений.
Храним копии вне production-машины. Бэкап на том же диске пропадет вместе с ним.
Ограничения
Если нагрузка вырастет, можно добавить экземпляры приложения, балансировщик и сбор логов, настроить обновления без простоя. Виртуальные машины это позволяют, но каждый компонент команда настраивает и обслуживает сама.
За одинаковыми настройками на разных машинах тоже нужно следить. Ansible помогает, но плейбуки не поддерживают себя: их придется обновлять, а изменения — проверять.
Когда оправдано
Одна VM подойдет для небольшого внутреннего сервиса, прототипа или приложения с невысокой нагрузкой. Особенно если команда знает Linux и умеет автоматизировать рутину.
Менять схему пора, когда команда тратит слишком много времени на сервер или не может обеспечить нужную доступность и справиться с нагрузкой.
Схема Б. Все в Docker Compose на одной виртуальной машине
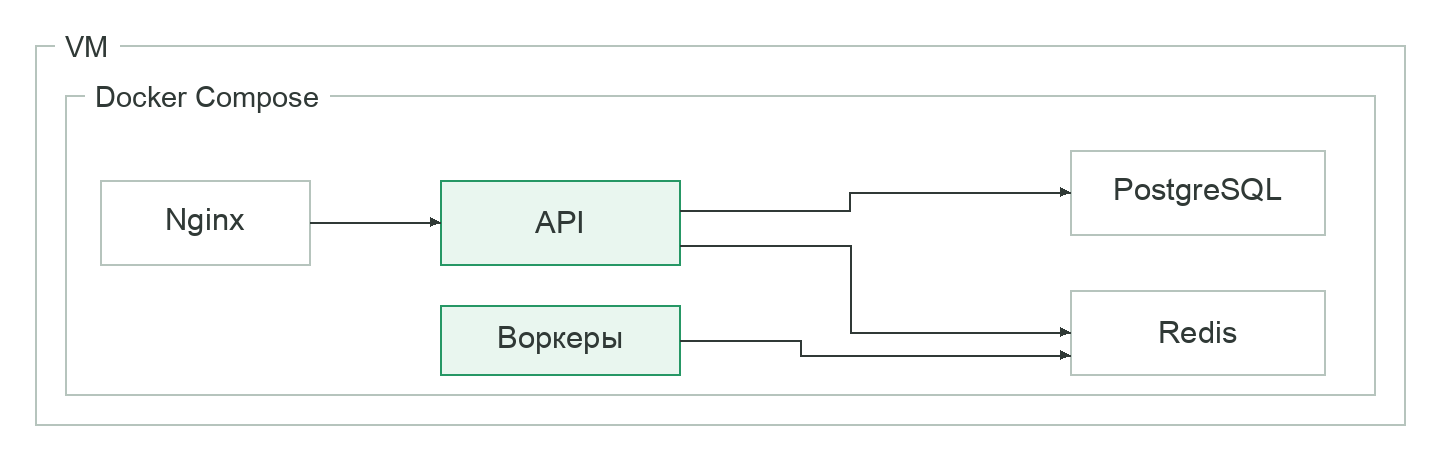
На той же VM запускаем API, воркеры, PostgreSQL и Redis в контейнерах. Версии образов, зависимости и параметры запуска описываем в compose.yaml. Один файл помогает развернуть похожий стек локально, на staging и в production.
Граница отказа прежняя: упала VM — остановился весь стек. Compose не перенесет контейнеры на другую машину.
Что с требованиями
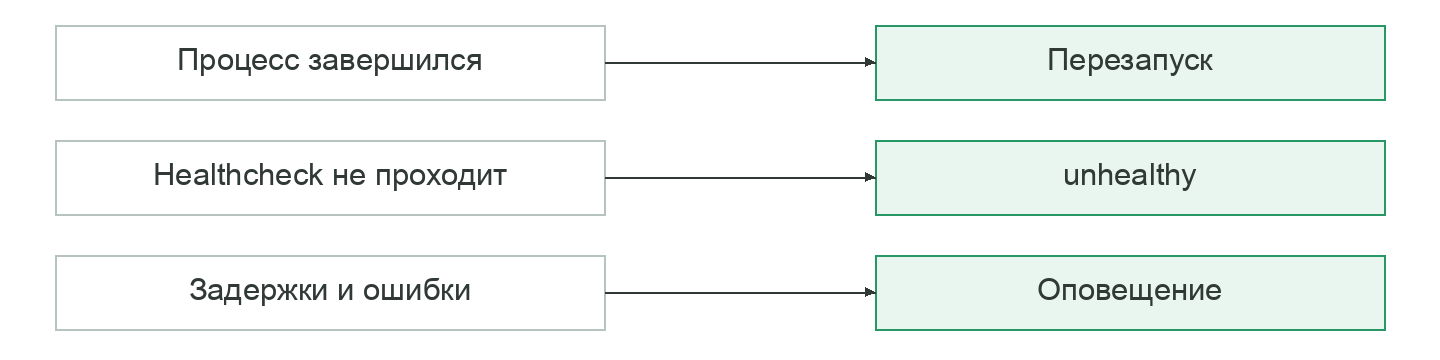
Автоматический рестарт. С политикой restart: unless-stopped Docker перезапустит контейнер, если его основной процесс завершится. Но процесс может работать, а API — уже не отвечать. Такую ситуацию помогает заметить healthcheck.
Healthcheck периодически проверяет приложение: например, запрашивает HTTP endpoint или пробует подключиться к PostgreSQL. Если проверки не проходят, Docker помечает контейнер как unhealthy. Сам по себе этот статус не запускает рестарт: restart policy реагирует на завершение процесса.
Реакция зависит от сбоя. Процесс упал — перезапускаем. Экземпляр временно не готов принимать запросы — убираем его из балансировки, если такой механизм настроен. Выросли задержки или ошибки — отправляем оповещение и разбираемся. Эти действия не стоит подменять одним рестартом.
Staging. Поднимаем отдельную VM с тем же Compose-файлом, но своими переменными окружения и данными. Секреты храним и передаем безопасно, отдельно от общей конфигурации.
Релизы без простоя. Команда docker compose up -d их не гарантирует. Можно запустить новую версию рядом со старой, проверить ее и переключить трафик через Nginx. Настройки и скрипты для этого пишет команда.
Что остается на команде
Команда обслуживает VM и Docker Engine, настраивает сеть и Nginx, выпускает и откатывает релизы. Она же делает бэкапы PostgreSQL, проверяет их, собирает логи и следит за метриками.
Контейнеры помогают заново развернуть стек после сбоя, но для работы на другом хосте нужен отдельный механизм.
Когда оправдано
Compose удобен для небольших production-сервисов и внутренних инструментов: несколько контейнеров можно описать в одном файле и запускать похожим образом в разных окружениях.
Проект может расти и оставаться на Compose, пока одной машины достаточно. Другие варианты стоит рассмотреть, когда команде уже сложно размещать контейнеры, обновлять их и поддерживать нужную доступность на нескольких узлах.
Схема В. Compose для приложения и managed-сервисы для PostgreSQL и Redis
API и воркеры оставляем в Compose на VM. PostgreSQL и Redis переносим в managed-сервисы, например Evolution Managed PostgreSQL и Evolution Managed Redis. Приложение обращается к ним по сети, провайдер обслуживает их в рамках выбранного сервиса.
Команда запускает приложение привычным способом и меньше занимается базой и кешем.
Что меняется
На своей VM команда сама настраивает бэкапы PostgreSQL, обновляет СУБД, следит за метриками и готовит резервные узлы. В managed-сервисе часть этой работы берет на себя платформа. Какая именно — зависит от конфигурации кластера.
Например, Evolution Managed PostgreSQL поддерживает бэкапы и восстановление к выбранному моменту. Расписание, срок хранения копий и параметры отказоустойчивости нужно проверить для своего кластера.
Функция может быть доступна в сервисе, но выключена в вашей конфигурации.
RPO и RTO: что произойдет при сбое
Перед выбором базы ответьте на два вопроса:
RPO (Recovery Point Objective) — изменения за какой период допустимо потерять?
RTO (Recovery Time Objective) — как долго сервис может оставаться недоступным, пока вы его восстанавливаете?
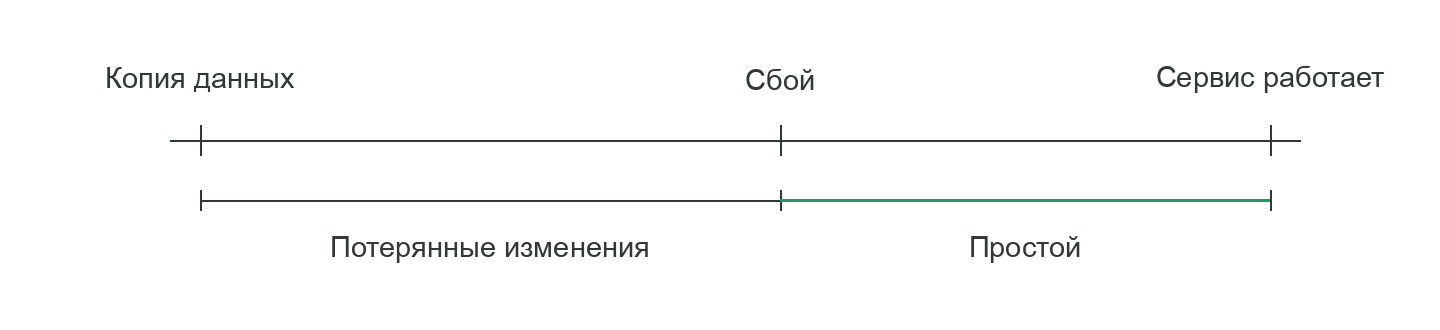
Единых RPO и RTO для managed PostgreSQL нет: результат зависит от конфигурации, репликации, бэкапов и самого сбоя. Резервный узел может сократить простой, но не заменяет копии данных. Например, случайный DELETE может попасть и на реплики.
Проверьте, какие сбои покрывает выбранная конфигурация, как вернуть данные и сколько это займет. Сопоставьте ответы с требованиями продукта.
Что остается на команде
Managed-база не устраняет сбои на стороне приложения.
VM с Compose остается единой точкой отказа для API и воркеров. Команда по-прежнему настраивает релизы и отдельный staging. Если понадобятся экземпляры приложения на разных машинах, придется решить, как их запускать и балансировать трафик.
За соединение приложения с managed-сервисами тоже отвечает команда: она настраивает сеть, доступ и секреты, обрабатывает обрывы соединений и повторяет запросы там, где это уместно.
Когда оправдано
Схема подойдет, если команду устраивает Compose, но много времени уходит на PostgreSQL и Redis: бэкапы, обновления и резервные узлы.
Если приложение помещается на одной VM и ее ограничения приемлемы, переходить на Kubernetes не обязательно.
Схема Г. Managed-платформа для приложения и managed-сервисы для данных
Упаковываем API и воркеры в контейнеры и запускаем на managed-платформе провайдера. PostgreSQL и Redis тоже используем как managed-сервисы.
Платформа может управлять экземплярами, перезапускать их, менять число реплик, настраивать HTTPS и собирать метрики.
Проверьте, какие функции есть в выбранном сервисе и включены ли они у вас. Слово managed само по себе не обещает ни автоскейлинга, ни релизов без простоя.
Что меняется в разработке
Чтобы платформа могла заменять и масштабировать экземпляры, приложению часто нужно стать stateless: хранить состояние во внешних системах, а не на локальном диске контейнера.
До переезда проверьте, что позволяет платформа:
какие языки, runtime и форматы контейнеров поддерживает;
как дает доступ к файловой системе и сколько живут локальные данные;
как запускает фоновые задачи и поддерживает долгие соединения;
какие лимиты задает для ресурсов, времени работы и сетевых подключений;
как собирает логи и метрики, как масштабирует приложение.
Допустим, API выполняет долгую задачу внутри веб-процесса. Для переезда ее может понадобиться вынести в отдельный воркер. Загруженные пользователями файлы с локального диска — перенести во внешнее хранилище.
Одного совместимого контейнера мало. Важно проверить, сможет ли приложение работать по правилам платформы и что для этого придется изменить.
Когда оправдано
Managed-платформа подойдет команде, которая хочет меньше обслуживать серверы и готова принять ограничения сервиса. Например, для небольшого API или внутреннего приложения, где важнее выпускать новые функции, чем управлять окружением на низком уровне.
Если нужны особые сетевые настройки или нестандартный способ запуска, проверьте, позволяет ли их платформа. Стоимость считайте на своей нагрузке: при постоянной высокой загрузке VM может обойтись дешевле. В сравнение включайте и время команды на ее обслуживание.
Что происходит с данными при выборе архитектуры
Во всех четырех схемах за PostgreSQL нужно следить отдельно. Вопрос не только в том, где работает база, но и в том, кто делает копии, поддерживает резервные узлы и возвращает данные после сбоя.
PostgreSQL на собственной виртуальной машине
Сначала определите допустимую потерю данных и время простоя — RPO и RTO. Под них выбирайте способ резервного копирования.
Дамп pg_dump помогает восстановить базу из сохраненной копии. Чтобы вернуть ее к выбранному моменту между копиями, нужны физические бэкапы и архив WAL.
Храните копии вне production-машины. Регулярно восстанавливайте из них тестовую базу и замеряйте время: так вы узнаете, укладываетесь ли в требования.
PostgreSQL в managed-сервисе
Провайдер может делать бэкапы, возвращать базу к выбранному моменту, поддерживать реплики и автоматически переключать приложение на резервный узел.
Это разные механизмы. Бэкап возвращает данные, реплика и failover помогают пережить отдельные сбои с меньшим простоем. Проверьте, что доступно и включено в вашем кластере.
Одна логическая база не обязательно работает на одном узле PostgreSQL. За одной точкой подключения могут стоять основной и резервные узлы. Их наличие зависит от конфигурации.
Что нужно проверить в любом случае
Команда должна знать, где лежат копии, как поднять базу, проверить данные и подключить приложение. Регулярно проходите этот путь на тестовом окружении. Только пробное восстановление покажет, сможете ли вы вернуть сервис в работу вовремя.
Что находится между Compose и Kubernetes
Помимо Compose и Kubernetes есть Docker Swarm, Nomad, k3s, Kamal и Uncloud. При этом k3s — дистрибутив самого Kubernetes, а не отдельный от него оркестратор.
Эти инструменты решают разные задачи. Одни распределяют контейнеры по узлам, другие помогают выпускать релизы. Они отличаются тем, что придется изучать и поддерживать.
Подробное сравнение оставлю за рамками статьи. Сначала сформулируйте, чего именно не хватает в текущей схеме, затем ищите инструмент под эту задачу.
Запустить реплики на разных машинах и пережить отказ узла — одна задача. Удобно доставить новую версию на один сервер — другая. Во втором случае полноценный оркестратор может добавить больше работы, чем сэкономит.
Когда Kubernetes действительно нужен
Вернемся к вопросу из заголовка: нужен ли Kubernetes сервису с одной базой?
API, PostgreSQL, Redis и воркеры могут работать без него. Важнее то, как вы выпускаете релизы, справляетесь с нагрузкой и сбоями. Перед переходом ответьте на четыре вопроса.
1. Нужен ли вам оркестратор?
Kubernetes размещает контейнеры на узлах, поддерживает нужное число реплик, обновляет их и проверяет состояние. Это помогает, когда компоненты нужно масштабировать независимо, а вручную управлять экземплярами уже трудно.
Количество сервисов само по себе ничего не решает. Пять приложений могут обойтись без Kubernetes, а одному он может понадобиться. Назовите конкретные задачи, которые должен решить оркестратор.
2. Дает ли декларативное управление практическую пользу?
Compose описывает контейнеры и их настройки. Kubernetes позволяет так же описать более широкий набор ресурсов: развертывания, сетевые сервисы и политики доступа.
Это полезно, если вы храните конфигурацию в Git, используете GitOps и ведете несколько окружений. Но изменения все равно нужно проверять, а результат — сопоставлять с тем, что вы описали.
3. Кто будет эксплуатировать кластер?
Managed Kubernetes снимает часть забот о компонентах управления кластером. Приложения по-прежнему настраивает и обслуживает команда.
Нужны люди, которые понимают рабочие узлы, лимиты контейнеров, сеть, обновления и мониторинг, умеют искать причины сбоев и восстанавливать сервис. До перехода уточните, что делает провайдер, а что остается вам, и оцените, хватит ли на это времени и специалистов.
4. Оправдывают ли требования стоимость перехода?
У Kubernetes есть собственные компоненты, которые нужно оплачивать и обслуживать. Сравните эти затраты с работой, которую он сэкономит.
Переход может окупиться, если нужны реплики на разных узлах, автоматическое размещение контейнеров, управляемые обновления и общий способ запускать приложения.
Если главная боль — бэкапы PostgreSQL, ручной деплой или одна VM, сначала решите ее. Kubernetes сам по себе не обеспечит ни сохранности данных, ни отсутствия простоев.
Часть работы можно отдать провайдеру. Например, Evolution Managed Kubernetes от Cloud.ru берет на себя обслуживание компонентов управления кластером.
За приложения, ресурсы, сеть и рабочие процессы отвечает команда. Перед выбором проверьте границы ответственности в условиях сервиса.
Подытожим
Выбирайте схему под требования сервиса и работу, которую команда готова делать сама.
VM без контейнеров — для небольшого сервиса и команды, которая знает Linux и автоматизирует настройку серверов.
Compose на одной VM — чтобы описать контейнеры в одном файле и проще повторять окружение. Отказ хоста затронет весь стек.
Compose с managed PostgreSQL и Redis — чтобы сохранить привычный запуск приложения и меньше обслуживать базу и кеш.
Managed-платформа с managed-сервисами данных — чтобы передать провайдеру больше работы и принять правила платформы.
Kubernetes — когда задачи оркестрации оправдывают затраты на кластер и команда готова его эксплуатировать.
Для одного API и одной логической базы Kubernetes может быть лишним. Решайте по требованиям к доступности, релизам, нагрузке и работе команды.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.