Корутины в продакшене: как переложить рельсы под идущим поездом
Привет, Хабр! Меня зовут Алексей Макареня, я старший разработчик в «Лаборатории Касперского». Наша команда занимается централизованной системой контроля версий, и это тот самый поезд из заголовка. Через сервер этой системы идет работа с монорепозиторием, где лежит код десятков продуктов, поэтому остановить его на ремонт нельзя.
Сервер годами жил на акторах и дожил до того, что перед мелкой правкой разработчик по нескольку часов восстанавливал в голове поток управления. Под катом рассказываю, как я за восемь месяцев перевел его на корутины C++20 прямо на ходу, зачем для этого понадобилась собственная библиотека на 387 строк и почему иногда полезно сначала написать функцию на 565 строк.
Один большой или много маленьких?
Все мы знаем Git, где у каждого разработчика лежит полная копия проекта. Когда компания делает множество продуктов, удобно держать весь код в одном большом хранилище и не плодить десятки отдельных репозиториев и дополнительную доставку артефактов между ними. Такое хранилище на все называют монорепозиторием. К нему в разное время пришли Google, Microsoft, Яндекс и другие крупные компании.
Главная проблема большого монорепозитория в том, что он и правда очень большой. В докладе Яндекса про его систему Arc фигурировали два терабайта со всей историей. У нас с историей пока чуть больше 200 ГБ, а рабочая копия занимает десятки гигабайт, но хватает и этого. С обычным git за время одного pull успеваешь не только попить кофе, но и пообедать, а switch на ветку полугодовой давности лучше вовсе не запускать.
Поэтому у разработчика локально лежат не все файлы. Виртуальная файловая система показывает репозиторий так, будто он целиком находится на машине, но на деле скачиваются только файлы, с которыми человек работает. Остальное постепенно подгружается с сервера по мере необходимости. Из-за этого сервер становится центральной и очень нагруженной частью системы.
Большая часть нагрузки приходится на ввод-вывод, в пиковые моменты счет запросов у нас доходит до 20 тысяч в секунду и выше. Возьмем самую обычную обработку такого запроса: прочитать его, сходить в базу (один раз будет скучно, так что по разу на каждый ключ из запроса) и записать ответ. Синхронно это выглядело бы очень просто:
Request req = Read();

std::vector<Row> rows;
for (auto& key : req.keys) {
    rows.push_back(db.Get(key));
}

Write(Reply{rows});
Такой код укладывается в восемь строк, читается сверху вниз и отлаживается обычным отладчиком. На вычисления в нем уходит совсем немного, почти все время поток ждет ответа по сети. Если обслуживать много таких запросов отдельными потоками операционной системы, получатся тысячи потоков, которые в основном просто ждут. А потоки, как известно, обходятся недешево.
Как ждать, не занимая поток
Проблему ожидания классически решают колбэками, например в asio. Поток выполняет свою часть работы, доходит до асинхронной операции, возвращается в пул и позже продолжает работу через колбэк. По ресурсам это гораздо выгоднее, но вот во что превращаются наши восемь строк:
// состояние больше негде держать — только снаружи
struct Session {
  Request req;  std::vector<Row> rows;
  size_t i = 0;                       // ← счётчик цикла
};

void FetchNext(std::shared_ptr<Session> s) {
  if (s->i == s->req.keys.size()) {
    Write(Reply{s->rows}, [s](bool) { /* готово */ });
    return;
  }
  db.Get(s->req.keys[s->i], [s](Row row) {
    s->rows.push_back(std::move(row));
    ++s->i;
    FetchNext(s);                     // ← «следующая итерация»
  });
}
Потоки мы освободили, но разорвали структуру программы. Цикл исчез совсем: вместо него функция, которая вызывает сама себя, а счетчик итераций пришлось вынести наружу, в Session. Был простой линейный код с обычными циклами и условиями, появились отдельные обработчики, переходы и дополнительное состояние. У этого эффекта даже есть название: stack ripping, разрыв стека. Вместе со стеком ушла и простота чтения.
Чтобы вернуть коду структуру, мы перепробовали много вариантов. Помимо коллбэков есть много других вариантов. Один из них — акторы: по идее, они должны были все это упростить. Вот тот же пример на акторах:
struct Ctx {
  Request req;  std::vector<Row> rows;
  size_t i = 0;
  response_promise reply;
};

behavior service(event_based_actor* self, actor db) {
  return {
    [=](read_atom, Request r) {
      Ctx c{std::move(r), {}, 0, self->make_response_promise()};
      self->mail(next_atom_v, std::move(c)).send(self);
    },
    [=](next_atom, Ctx c) {                        // ← сам цикл
      if (c.i == c.req.keys.size()) {
        c.reply.deliver(Reply{std::move(c.rows)}); return; }
      self->mail(get_atom_v, c.req.keys[c.i], std::move(c)).send(db);
    },
    [=](row_atom, Row row, Ctx c) {                 // ← тело цикла
      c.rows.push_back(std::move(row)); ++c.i;
      self->mail(next_atom_v, std::move(c)).send(self);
    }};
}
Стало ли проще? Не очень. Цикл стал письмом самому себе, счетчик — полем в Ctx, порядок шагов теперь нигде не записан: чтобы его узнать, надо проследить, кто кому шлет сообщения. Я бы даже и не стал рассказывать ничего про акторы, если бы не одно «но». Сервер, который мне достался, был написан именно на них.
Почему когда-то выбрали именно акторы, я не знаю: проект стартовал четыре года назад, я в нем всего год. Важнее другое: все это работало годами, в проде, и работает прямо сейчас.
Как делать плохо, разобрались, теперь как делать хорошо. Первый вариант — файберы. Они позволяют освободить системный поток посреди выполнения функции, потом продолжить ее с того же места; делается это библиотеками вроде Boost.Context. Код при этом не просто становится лучше, он остается ровно таким, каким был:
// Да, это 100% копия синхронного кода
Request req = Read();

std::vector<Row> rows;
for (auto& key : req.keys) {
    rows.push_back(db.Get(key));
}

Write(Reply{rows});
Кажется, что переписывать вообще ничего не надо. Надо, к сожалению, и начинается все с примитивов синхронизации. Обычный mutex привязан к системному потоку, а файбер может уснуть в одном потоке и проснуться в другом. Отпустить мьютекс из чужого потока — получить дедлок. Значит, все примитивы синхронизации пришлось бы менять на версии, которые знают о файберах.
Со сторонними библиотеками еще хуже. Допустим, внешняя библиотека вызывает ваш колбэк, из него через цепочку вызовов срабатывает обычная функция бизнес-логики. Через полгода стажер добавляет в нее поход в базу, вот только библиотека звала колбэк под своим мьютексом. Получили дедлок из-за правки в файле, никак не связанном с библиотекой, и поди его найди.
До «Лаборатории Касперского» я работал в Яндексе, да и про язык Go слышал: и там, и там широко используют файберы. Но у этого есть причина: и Яндекс, и Go полностью владеют своей инфраструктурой.
В Яндексе нельзя просто взять стороннюю библиотеку: ее нужно согласовать, завести в монорепозиторий и подружить с файберами. Стандартный mutex и блокирующий ввод-вывод там под запретом: их меняют на свои примитивы или уносят в отдельный пул потоков. Когда владеешь всей инфраструктурой, файберы — отличный выбор. В готовом же продукте, который уже живет на сторонних библиотеках, такой путь куда как рискованнее.
И тогда мы приходим к корутинам. По сравнению с файберами поменялось не так уж многое: перед каждым местом, где мы ждем, появилось слово co_await. Всего три слова на функцию:
Request req = co_await Read();

std::vector<Row> rows;
for (auto& key : req.keys) {
    rows.push_back(co_await db.Get(key));
}

co_await Write(Reply{rows});
Но дело не в трех словах. Приостановиться здесь может только корутина и только на co_await, поэтому все места, где может смениться поток, видны прямо в коде. Обычный mutex снова можно использовать, а если его захват все-таки переживет co_await, об этом предупредит clang-tidy. И история со стажером не повторится: корутинный поход в базу из обычной функции просто не скомпилируется. Придется сделать корутиной и ее, потом выяснить, что ее не позвать из колбэка библиотеки, и идти разбираться. Долго и нудно, но в этом и ценность: вся цепочка заражения корутинностью видна в сигнатурах, а не всплывает дедлоком в проде.
При этом я не считаю корутины кратковременной модой. Посмотрите на другие языки. В Python это async/await и asyncio, в JavaScript то же самое поверх промисов, в Kotlin — suspend-функции, корутины прямо в стандарте языка. Rust и Swift тоже пришли к async/await. C# вообще первопроходец: async/await появился там почти 15 лет назад, и с тех пор весь язык на них и живет. Это текущий state of the art. Из всех способов ждать, которые мы перебрали, корутины лучше всего подходили нашей задаче: их можно внедрять постепенно, не переписывая разом всю окружающую инфраструктуру.
С чего начинали: сервер на акторах
Исходный сервер был построен на акторах, и их было много: 73 файла, 16 акторных классов, шесть сервисов. На каждый пришедший запрос создавался свой актор. Внутреннего состояния у него не было. Только этот запрос, поэтому он просто предобрабатывал данные и пересылал их актору сервиса. Тот выполнял бизнес-логику и по пути ходил в базу данных. И у каждого сервиса был файл обвязки строк на триста, в котором нет ни строчки бизнес-логики: регистрация методов, разбор запроса, сборка ответа, протаскивание контекста. Этот файл просто есть, потому что без него gRPC не заведется.
Отдельную роль играл сам gRPC: помимо обычного запроса-ответа, он поддерживает стриминг. И клиент, и сервер могут слать целые потоки сообщений, по несколько и с паузами, итого четыре вида RPC в зависимости от того, кто и как шлет. Для нашего сервера это было важно: поток сообщений — цикл, который в акторной системе превращается в набор обработчиков сообщений и разделяемое между ними состояние.
Контекст операции путешествовал между акторами: в нем хранились индексы циклов и промежуточные поля, одни обработчики заполняли данные, другие читали. Обработчиков много, все разорваны, и в итоге бизнес-логика оказалась размазана по ним.
Любая задача стала занимать вчетверо больше времени. И это если фича вообще укладывалась в существующий дизайн. А переписать сам дизайн акторной системы (какие акторы где возникают, как обмениваются сообщениями) никто даже не хотел. Поэтому новую функциональность продолжали втискивать в старую конструкцию, даже когда она подходила все хуже. Начали с лапши — и лапшу только увеличивали. Рефактор был нужен, это было очевидно.
Как менять систему, которая продолжает работать
Переписать такой сервер разом нельзя. Пока идет рефакторинг, в тот же код продолжают приезжать чужие коммиты: фичи вливаются, баги чинятся. Все это время сервер круглосуточно обслуживает реальных клиентов. Права сломать его у меня не было: это рабочая лошадка. На всю миграцию вышло порядка полусотни PR.
К счастью, система уже была разделена на шесть сервисов: сопоставимых по сложности и объему, независимых друг от друга. Поскольку акторную структуру все эти годы никто не трогал, топология была заморожена: список того, что предстояло перевести, я знал целиком с первого дня. Для миграции это подарок — цель не убегает, пока ты в нее целишься. Мы решили переводить сервисы по одному, отдельным PR каждый: какое-то время старые и новые части живут рядом. Параллельно строилась корутинная инфраструктура, о ней поговорим дальше.
У такого подхода давно есть название: Strangler Fig Pattern, или паттерн «душащий фикус». Название дал Мартин Фаулер. Новая система постепенно обрастает вокруг старой и забирает ее функции, старая часть при этом шаг за шагом исчезает.
Своя библиотека на 387 строк
Дальше нам понадобилась библиотека, которая свяжет корутины с существующим кодом. Ограничения были жесткие: не тащить ради одной задачи монстров вроде Boost или Folly; библиотека должна быть живой — реальная активность за последние полгода; без боли стыковаться с уже написанным кодом на колбэках и акторах; и, кроме Linux под продом, поддерживать Windows и MacOS. Тесты поднимают легкую версию того же сервера под каждую платформу.
Большинство вариантов отпали сами собой. cppcoro и concurrencpp мертвы, последние коммиты у них двух- и трехлетней давности. Boost.Cobalt и folly::coro — монстры. libcoro под Windows превращается в тыкву: ни networking, ни TLS. stdexec вообще другая парадигма, sender/receiver. Оставались asio и async_simple. Последний я нашел уже после рефактора, так что он в отборе и не участвовал. asio казался тогда избыточным — не блокер, но некоторые вещи в нем выходили сложнее, чем хотелось бы.
Обе библиотеки подошли бы, но выбрали мы в итоге третий вариант, мою собственную библиотеку. Хотя ладно, кому я вру: дело не в технических преимуществах, просто любой уважающий себя программист пилит велосипеды. В первой ревизии было 387 строк, сейчас чуть больше тысячи; вся она вычитывается за час. И главное, ее не жалко выбросить: у нас до сих пор в планах заменить самописный YDB-бэкенд на Яндексовый и получить их корутинную реализацию даром, а вместе с бэкендом уйдет и библиотека.
Базовая версия состоит из трех примитивов: Task — сама корутина, Start — запуск из обычного кода и Promise — мостик между корутинным и колбэкным миром. Promise самый важный: даешь функцию, принимающую колбэк, и получаешь значение через co_await. Название и дизайн честно украдены у JavaScript. Объект resume живет прямо в кадре корутины, поэтому указатель на него можно отдать во внешний сервис как есть. Ровно то, что нужно для gRPC и легаси-колбэков. Так существующий асинхронный метод с колбэком вызывается из корутины без переписывания нижнего слоя:
Coro::Task<void> PrintName(Db& db, ObjectId id) {
    auto name = co_await Coro::Promise<std::string>([&](auto& resume) {
        db.GetNameAsync(id, [&](std::future<std::string> value) {
            try { resume(value.get()); }
            catch (...) { resume.SetException(std::current_exception()); }
        });
    });
    std::cerr << "name is: " << name << "\n";
}

Coro::Start(PrintName(db, item_id));   // из main, из насоса очереди — откуда угодно
Первым же коммитом, переведя один сервис из шести, я удалил 954 строки акторной обвязки.
Корутины поверх gRPC
В gRPC для C++ есть целых три модели API. Синхронный читать проще всего: генератор создает интерфейс сервиса, мы реализуем методы и пишем бизнес-логику. Все легко, за исключением одного: потоков нужно очень много, скорее всего, больше, чем операционка вам позволит.
Есть еще callback API с реакторами: по классу на каждый запрос, и реактор подозрительно похож на актора. На каждый асинхронный чих у него вызывается метод. Последний — асинхронный API на Completion Queue: каждой операции отдаешь tag типа void*, а потом достаешь его же из очереди завершений — единого цикла, вокруг которого крутится весь сервер. Мощно и быстро, вот только авторы gRPC про этот API как-то забыли: там даже нет ручки, чтобы посмотреть, корректно завершился поток входящих сообщений запроса или это оборвалась связь.
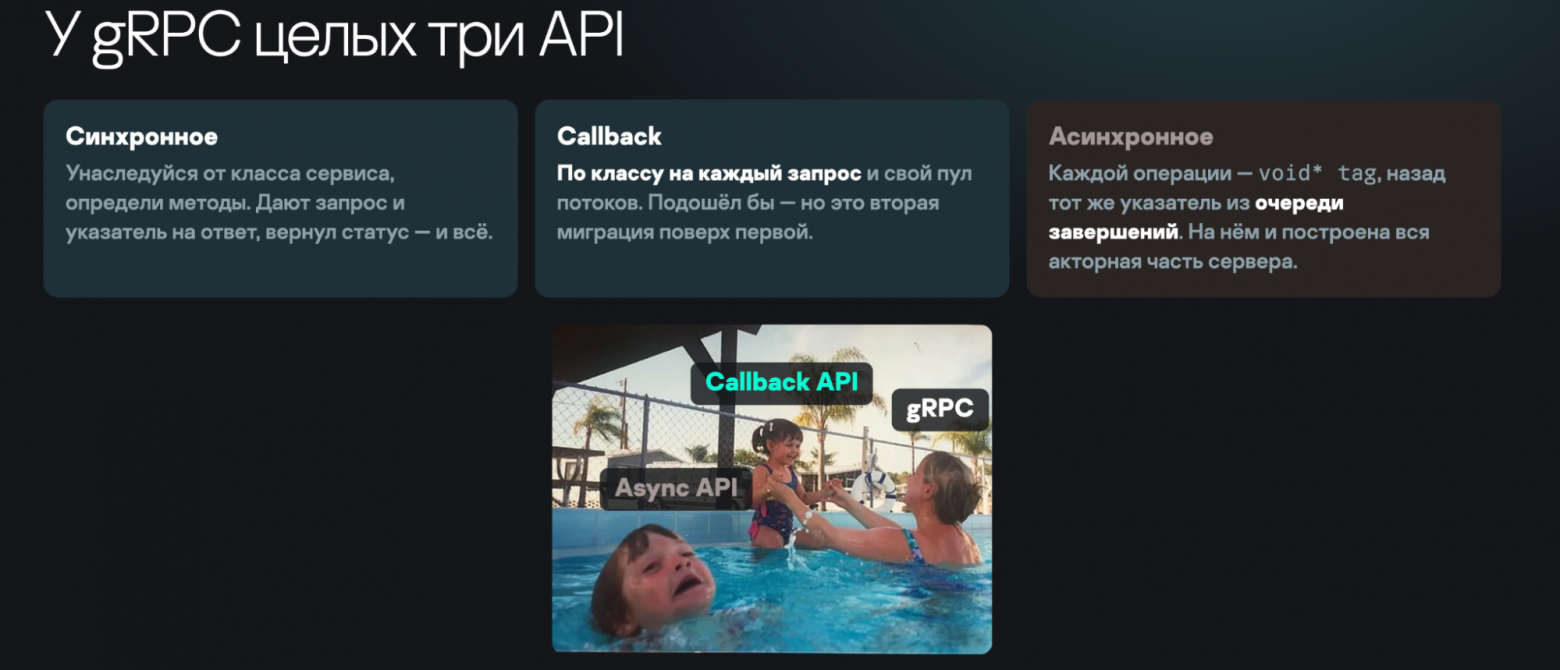
Наш сервер был написан именно на Completion Queue. Колбэчный, честно говоря, тоже подошел бы, и с акторами, и с корутинами, но это два рефактора сразу: при баге не скажешь, какой слой его принес. Поэтому оставили async API как есть и обернули его корутинами.
Обвязка вышла минимальной. Асинхронная операция оборачивается в Promise, а в качестве тега ей отдается сам resume. Он и так лежит в кадре корутины:
co_await Coro::Promise<bool>([&](auto& resume) {
    reader->Read(&request, &resume);
});
Насос очереди приводит указатель обратно к типу и будит корутину:
while (cq->Next(&tag, &ok)) {
    (*static_cast<Coro::Resume<bool>*>(tag))(ok);
}
Ни таблицы соответствий «тег → корутина», ни оберток, ни аллокаций на операцию.
Оборачивать так каждый вызов вручную быстро надоело: вместо одной строки — три, и так в каждом месте.
Дальше напрашивалось само: раз gRPC и так генерирует C++-код из .proto-описания сервиса, пусть рядом генерируется и корутинный. Так появился свой плагин к protoc. Он вызывает штатный генератор, а потом дописывает к его выводу еще один класс: было V1::SomeService, появится V1::CoroSomeService. Интерфейс — калька с синхронного API, только методы возвращают Task<grpc::Status>; генерируются и серверный каркас, и клиентский Stub. Внутри все тот же асинхронный API: бизнес-код выглядит обычным и последовательным, при этом под капотом работает прежний механизм.
// как в синхронном API gRPC
class Service {
  virtual grpc::Status Get(ServerContext* ctx,
                           const Request* request,
                           Response* response) = 0;
};

// как у нас
class CoroService {
  virtual Coro::Task<grpc::Status> Get(ServerContext* ctx,
                                       const Request& request,
                                       Response* response) = 0;
};
Заодно вернули и ту самую потерянную ручку IsCanceled: оборвался поток входящих сообщений или закончился сам. В колбэчном API метод для этого есть, в асинхронный его просто не завезли, так что пришлось лезть во внутренности gRPC core. Наружу эта информация не выставлена вовсе.
Это оказалось выгодно. Помните файл обвязки на триста строк у каждого сервиса, который «просто есть, потому что без него gRPC не заведется»? Руками это шесть раз одна и та же работа и шесть разных опечаток в ней. Плагин и описанный дальше middleware написаны один раз на все сервисы: обвязка перестала существовать как код, который кто-то пишет и кто-то ревьюит. Общее правило: переписываете N однотипных мест — перепишите генератор, а не N мест.
Служебный код в одном месте
В продакшене одного вызова RPC мало: нужно авторизовать клиента, определить его логин, проверить доступ, иногда заблокировать запрос, собрать метрики и обработать результат. Эту логику можно было вставлять в начало и конец каждого метода, но так снова получился бы boilerplate, поэтому в генераторе появился промежуточный слой middleware.
Сгенерированный код зовет метод сервиса не напрямую, а через middleware: тот может сделать что-то до и после вызова, отловить исключения, и он же объявляет, какие аргументы приедут в метод. По умолчанию подставляется ровно то же, что у обычного gRPC, а именно ServerContext*; тогда сервис неотличим от стандартного, только методы корутинные.
Наш middleware идет дальше: разбор контекста и авторизации вынесен в него, и в метод приезжают уже готовый контекст репозитория и учетные данные. Метод начинается сразу с бизнес-логики. Причем разбор асинхронный: middleware может сходить в базу или в кэш прав, и ни одна сигнатура от этого не поменяется.
// middleware выбираешь ты — он и объявляет, что приедет в каждый метод
class SomeService
  : public V1::CoroSomeService::ServiceTemplate<SomeMiddleware> {...};

// подпись метода с middleware по умолчанию — как у обычного gRPC,
// только корутинная
Coro::Task<grpc::Status> Get(
    grpc::ServerContext* ctx,
    const Request& request,
    Response* response);
// авторизация — сам, в каждом методе

// а с нашим middleware метод получает уже готовое
Coro::Task<grpc::Status> Get(
    IRepositoryContext& repo,          // выбранный репозиторий
    std::optional<Credentials> creds,  // кто пришёл
    const Request& request,
    Response* response);
За такую гибкость пришлось поиграть шаблонными шашечками, но оно того стоило: служебный код собрался в одном месте, а сервисы заметно похудели, местами почти втрое.
YDB: обёртка вместо переписывания
С базой данных у нас отдельная история. Доступ к ней спрятан за интерфейсом с несколькими реализациями — для продакшена и для тестов. Сам продакшен-бэкенд написан на акторах. Когда его писали, официального C++ SDK у YDB еще не существовало, и велосипед был не опцией, а жестким требованием. На корутины его переводить мы не стали. За интерфейсом он полностью самодостаточен, акторная модель здесь как раз на месте. Долгоживущий пул соединений к базе и есть их законная территория. К тому же мы все равно планируем заменить его на официальный SDK.
Так что базу хватило обернуть. Рядом с каждым колбэчным методом интерфейса появилась корутинная версия: старый метод не тронут, новый стоит рядом и просто дожидается его результата. У приема, как водится, тоже есть имя: Wrap Method у Физерса.
// было: колбэк в интерфейсе
virtual std::future<void> GetBranch(
    const RepositoryId& repo,
    const std::string& name,
    std::function<void(std::future<Branch>)> on_done) = 0;

// стало: обёртка рядом
Coro::Task<Branch> GetBranchCoro(
    const RepositoryId& repo,
    const std::string& name) {
  co_return co_await Coro::Promise<Branch>(
    [&, this](auto& resume) {
      GetBranch(repo, name, resume);   // ← resume передан как колбэк
    });
}
Вся механика сводится к одной строке: resume уходит старому методу прямо в качестве колбэка. Чаще всего колбэк означает «позови меня, когда будет ответ», и Resume умеет конвертироваться в него сам. Так система менялась слой за слоем, при этом реализации базы не переписывались ни разу.
Мегафункция: сначала собрать разорванный код обратно
Самое сложное началось, когда мы добрались до реального бизнес-кода. Перед глазами был разорванный стек, десятки обработчиков и логика, которая годами росла внутри старого дизайна. Нужно было ее понять, переписать и при этом ничего не потерять. С чего начать, тоже было неочевидно: в этой мешанине не про всякую функцию можно было сказать, что именно она делает.
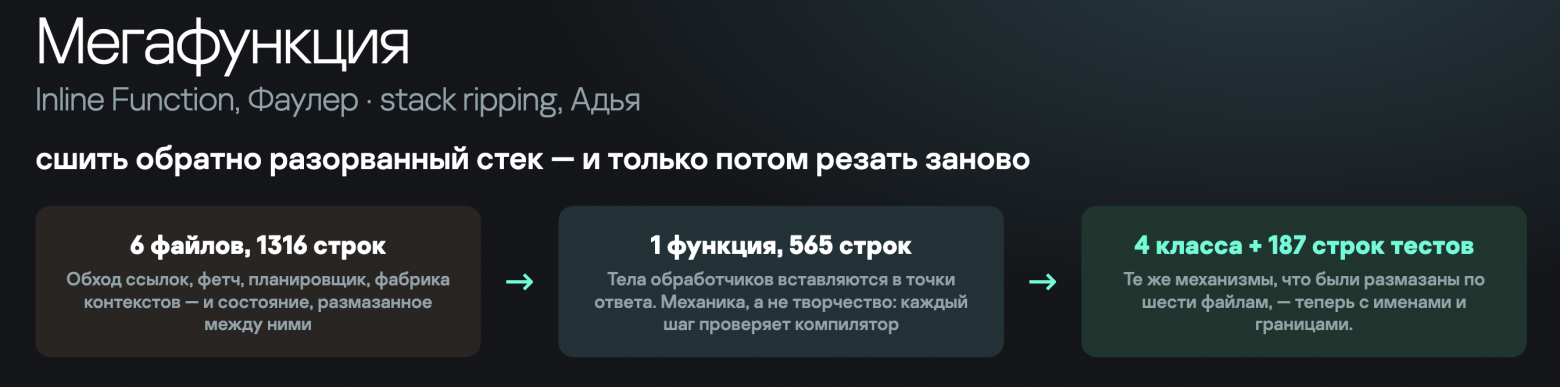
Первый прием я звал мегафункцией. По сути, это Inline Function по Фаулеру, только в масштабе акторной системы: старое разделение на функции и акторы вырывается, код вставляется на место вызовов, и все собирается в одну большую функцию. Работает LSP, где может: где есть inline — он, где нет — хотя бы переименование аргументов так, чтобы совпали с принимающей стороной. Правил два: никакого творчества, только переименования и копипаст, и код обязан собираться после каждого шага. Пока оба соблюдаются, сломать бизнес-логику нечем: любую оплошность ловит компилятор.
Вторая часть творческая: восстановление стека. Вижу, что актору ушло сообщение, позже приехал ответ: на это место встает Promise. Рекурсию, в которую когда-то превратился цикл, оформляю обратно в цикл, те самые места, где разрыв стека убил структуру. На выходе получаем мегакорутину: весь механизм впервые виден целиком, сверху вниз. Собирается все это за один заход: пока смотришь, понятнее, чем было; отвлекся, и перед тобой монстр.
Дальше функцию можно не торопясь вычесывать и делить обратно, по нормальным смысловым границам, маленькими правками и под тестами. Один из механизмов выглядел так: шесть файлов, 1316 строк, состояние размазано между ними. После сборки получилась одна функция на 565 строк, страшненькая, зато вся перед глазами. После вычесывания получились четыре класса и 187 строк тестов: те же механизмы, что были размазаны по шести файлам, только теперь с именами и границами.
Мега-PR, который никто не ревьюит
Второй прием: огромный черновой PR. При серьезном рефакторинге быстро выясняется, что изменение затрагивает десятки мест. Я не пытался сразу нарезать его на аккуратную серию маленьких PR. Сначала собирал большой рабочий черновик, который никто не должен был ревьюить и тем более куда-то вливать: его задача — показать весь фронт работ. Когда за деревьями виден лес, уже можно находить в нем отдельные механизмы, изолировать их и выносить в нормальные небольшие PR.
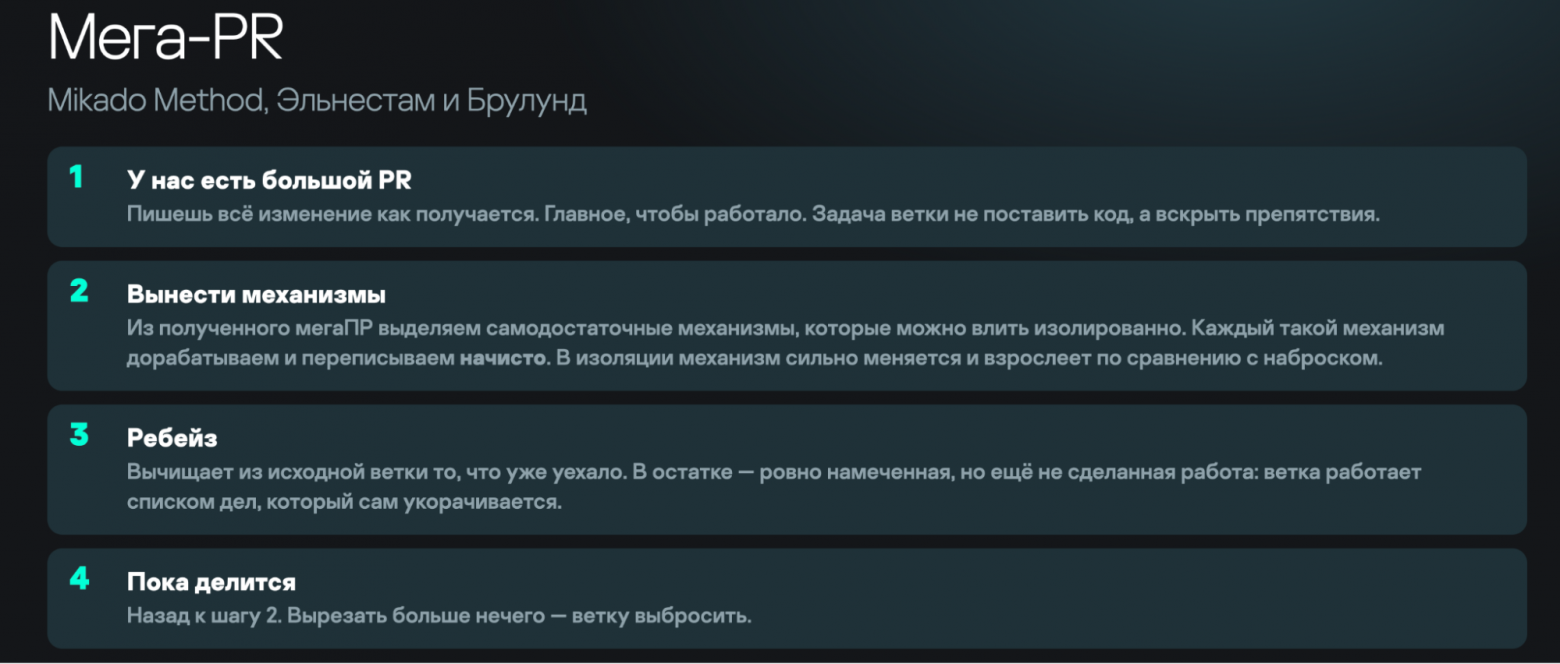
Бывало, три недели от меня не было ни одного коммита и ни одного PR, потом появлялись сразу шесть, и не маленьких. Так и задумано: пока ветка не показала реальные границы, вырезать из нее нечего.
У подхода есть имя: Mikado Method. Пишешь желаемое изменение как получается, наивно: задача ветки не поставить код, а вскрыть препятствия. Дальше из нее вырезаются самодостаточные механизмы, каждый дорабатывается и вливается начисто. Тут важная деталь: в изоляции механизм сильно меняется и взрослеет по сравнению с наброском. Копировать из наивной ветки обычно нечего.
Затем ребейз: он вычищает из ветки все, что уже уехало в мастер, и остается ровно еще не сделанная работа. Ветка начинает работать списком дел, который сам укорачивается. Повторять, пока делится; когда вырезать больше нечего, ветка выбрасывается: все ценное уже в мастере.
Мегаветок за рефактор у меня было четыре. До мастера доехала одна, остальные к этому моменту отдали все свое и были выброшены: это штатный финал метода, а не провал.
Что пришлось доделывать по дороге
Часть проблем была видна до старта. Promise хорош, когда коллбэк срабатывает ровно один раз: сходить в базу и дождаться ответа. Но кое-где API звал коллбэк многократно, а внутри такого коллбэка co_await не написать: цикл ведет вызываемая библиотека, и корутина обязана вести цикл сама.
В таких местах интерфейс менялся заранее: вместо «позови меня на каждом объекте» появлялся итератор, по которому корутина идет обычным циклом и на каждом шаге делает co_await. Кто владеет циклом, тот и решает, можно ли внутри ждать. За приемом стоит имя preparatory refactoring Кента Бека: сделай изменение простым, потом сделай простое изменение. Два таких PR уехали в мастер еще до первой корутины, и оба в минус по строкам.
Заранее видно было не все. Один из API выдавал кипу разнородных объектов через интерфейс с целым набором методов OnSomething: они срабатывали многократно и в разном порядке, и в аккуратный итератор это не сворачивалось. Механизм дожил до середины переезда и получил канал. Коллбэки складывают события в очередь, параллельная корутина читает их по одному и обрабатывает, а queue.Stop() говорит ей «все»: co_await вернет пустой optional.
struct QueueCallback : ICallback {
  void OnObjectOne(int f1, ...) override { queue_->Push(ObjectOne{.field1 = f1, ...}); }
  void OnObjectTwo(bool f1, ...) override { queue_->Push(ObjectTwo{.field1 = f1, ...}); }
  Coro::Queue<std::variant<ObjectOne, ObjectTwo, ...>>* queue_;
};

Coro::Task<void> Enumerate() {
  Coro::Queue<std::variant<ObjectOne, ObjectTwo, ...>> queue;
  auto processor = Coro::Start([&] -> Coro::Task<void> {
    while (auto object = co_await queue) { ... }   // ← корутинная сторона, по одному
  });
  EnumerateObjects(QueueCallback(&queue));         // ← нативная: синхронно и до конца
  queue.Stop();                                    // ← co_await отдаст пустой optional
  co_await std::move(processor);
}
Емкость очереди неограниченная: продюсер ждать не умеет, он бросает данные, пока они у него есть. Забить память этим в принципе можно. Но старая акторная очередь жила ровно по тому же принципу и работала годами, так что и здесь рискнули.
Еще одна вещь, которую я при планировании переезда не предусмотрел вовсе: корутине нужно уметь просто подождать. Поспать до момента X, не занимая поток. Пришлось дописывать шедулер с двумя формами ожидания. Они различаются реакцией на остановку шедулера:
// остановили — исключение
co_await scheduler.Schedule(next_run);

// остановили — false, вышли из цикла
while (co_await scheduler.TrySchedule(next_run)) {
    co_await SendMetrics();
    next_run += period;
}
Для периодических процессов вторая форма идеально подходит. К концу переезда библиотека выросла с 387 строк до тысячи с лишним, и ни одна из них не была написана заранее: каждый примитив датируется местом, об которое споткнулись.
Последняя история из тех, что достаются вместе с собственным рантаймом. У точки приостановки, await_suspend, есть три формы: void, bool и возврат coroutine_handle, а именно symmetric transfer, самый быстрый способ сказать, кого выполнять дальше. Мы выбрали красивую, и она оказалась с подвохом. Корутина считается приостановленной еще до входа в await_suspend и дожить до выхода из него не обязана: ее могут разбудить с другого потока прямо посреди нашей функции. А возвращаемое значение, handle, MSVC в этот момент кладет в кадр корутины. Кадр уже разрушен, пишем в разрушенное. Тот же код clang раскладывал без гонки, MSVC с гонкой.
Самое коварное: прод не падал, так как он только под Linux. Падала автосборка при приемке PR. Она гоняется на всех платформах: около месяца она падала через раз. Ловится такое только нагрузкой: функциональный тест смотрит на результат, а тут все про то, кто кого и когда возобновил. Починка: вернуть bool вместо handle:
// было: symmetric transfer
std::coroutine_handle<> await_suspend(std::coroutine_handle<> h) {
    ...
    if (sync_.exchange(true)) {
      return h;
    }
    return std::noop_coroutine();
}

// стало
bool await_suspend(std::coroutine_handle<> h) {
    ...
    return !sync_.exchange(true);
}
В VS 2026 это починили, оба варианта теперь равнозначны.
Стоило ли писать свою библиотеку
Очевидный вопрос: зачем писать свою библиотеку, если есть готовые решения? Сегодня для нового проекта я бы сначала посмотрел на существующие, но на старте миграции мы сами еще плохо знали корутины. Возьми мы сразу большую внешнюю библиотеку, пришлось бы одновременно разбираться и в механике корутин C++, и во внутреннем устройстве этой библиотеки, чтобы понимать, откуда берутся ошибки.
При этом велосипед оказался не только способом разобраться в технологии. Он почти не оставляет артефактов в окружающем коде, в отличие от акторного фреймворка, который диктовал архитектуру целых сервисов. Если однажды придется переехать на что-то взрослое, тот же Asio, большинство замен сведется к replace in files (замена по файлам): бизнес-код трогать не придется.
Когда библиотека устоялась, вскрылась человеческая проблема: это знаю я, а команда — нет. Пришлось читать внутренний курс по корутинам: пара встреч про механику, времена жизни и правила нашей библиотеки. Сработало наполовину. Корутинные сервисы и бизнес-логику после этого действительно смотрели по существу, а саму библиотеку так никто и не открыл. Честный итог: научить читать корутинный код можно за пару часов, а читать корутинный рантайм — нет.
Зато откатиться назад было нельзя, и это досталось даром. В больших миграциях механизм «назад дороги нет» обычно строят специально: он называется ratchet. Мне достались два, оба бесплатно. Первый — компилятор: если сделал функцию корутиной, то обязан переписать ее вызывающих, иначе не соберется. Второй — та самая замороженная топология: раз в акторную структуру никто не лез, новых акторов за переезд не появилось, цель не убегала. Запрета на новые акторы не было, он и не понадобился.
Что дали восемь месяцев миграции
Главный результат: код снова можно менять. До рефакторинга в некоторые части сервера страшно было пускать разработчика уровнем ниже сеньора. Слишком много неявного состояния и разорванного управления, и задачи под него было попросту некому отдать. Теперь правки приносят люди, которые об акторной модели не знают ничего, вплоть до стажеров.
После миграции многие методы сократились до десятка-полутора строк, половина из которых — заполнение протобуфа. Сложная бизнес-логика сложной и осталась, но ее сложность стала структурированной: обычные циклы, обычные if, последовательные вызовы, явные co_await.
По ходу переезда вскрылись старые ошибки, которые годами прятались в запутанной структуре. Гонка двух соседних битовых полей в рантайме акторов. Разыменование пустого итератора в обходе истории. Ретраи, которые молча не случались. Прод от этого не падал, он иногда странно себя вел, теперь понятно, почему.
Заодно прояснилась история с graceful shutdown. Его не было: объекты и контексты в акторной системе удерживали друг друга по кругу, и сервер в некоторых сценариях просто не завершался штатно, его останавливали kill’ом. До миграции акторную систему допинали до «останавливается в девяти случаях из десяти», проверку «не зависли ли акторы» пришлось понизить с terminate до предупреждения, она срабатывала. Честным останов стал только после переезда: когда владение и жизненный цикл упростились, круги удержания исчезли.
Вся миграция заняла около восьми месяцев, и все это время продукт продолжал развиваться. Упрощение структуры помогло и с наблюдаемостью: метрик стало больше, сервер на графиках понятнее.
И акторы никуда не делись. Из 73 файлов на них осталось около десятка: пул сессий к базе, keep-alive, менеджер узлов. Это места, где нужна долгоживущая сущность с собственным состоянием и почтовым ящиком. Ровно то, для чего акторная модель и придумана. Целью никогда не было «убрать акторы»; нужно было перестать применять их там, где нужна была просто последовательность асинхронных шагов.
В заключение могу сказать, что корутины не серебряная пуля. Они дали форму кода, в которой снова видна последовательность действий, а дальше работали старые добрые правила: по кускам, которые разработка проглотит не заметив, с мостом в обе стороны, пока половина кода уже новая, половина еще старая. Поезд за эти восемь месяцев не остановился ни на день.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.