Режимы работы x86-процессора
Этой статьей я хочу описать часть своих знаний, приобретенных на моем пути в OSDev и системном программировании. Параллельно я буду писать также документацию по CS, которую в скором времени выложу на свой GitHub.
Важно подметить, что мой путь ещё далеко не окончен и я, можно сказать, нахожусь в самом его начале. Зачем тогда я это делаю? Чтобы закрепить уже имеющиеся знания, получить критику от более опытных специалистов, а также, возможно, помочь некоторым новичкам подробно разобраться в теме.
Принцип работы процессора.
Почти все подобные статьи начинаются с краткой, часто даже с переупрощенной схемы «Кнопка запуска ПК -> BIOS -> железо -> загрузчик -> ОС». Я же хочу начать немного с другого: Как вообще работает процессор на базовом уровне?
Конечно, абсолютно все, даже не погруженные в IT люди, знают что такое бит, байт и т.д. Но как именно процессор ими оперирует? Как биты доставляются до самого кремния? Как проходят вычисления? Вот на это мы сейчас и ответим.
Как процессор оперирует битами?
На самом деле, процессор довольно глуп. Нет одной инструкции «найти подстроку». Вместо этого он использует довольно примитивные логические операции. AND, OR, XOR и т.д. Подробно я останавливаться на этом не буду — в интернете об этом достаточно много информации. Так вот, наборы таких логических операций называются инструкциями: они могут быть как сложными и долгими в рамках работы процессора, как INVLPG, так и простыми и быстрыми, как MOV или ADD. За такт ядро процессора может выполнить только 1 инструкцию (современные уже могут, но поскольку статья вводная, думаю, подобное допущение простимо), поэтому настоящего параллелизма на одном ядре не существует, вместо этого во всех современных ОС используется псевдопараллелизм.
Помимо ограничения в виде количества исполняемых за раз инструкций, у процессора есть ограничение на размер данных, которыми он может оперировать за раз. В разных режимах работы это число также разное, а называется оно машинным словом.
Как биты доставляются до процессора?
Своеобразной «дорожкой», по которой ток доходит до процессора, являются шины: шина данных и шина адреса. Как следует из названия, по первой процессору поступают данные, с которыми нужно работать, а по второй — адрес следующей инструкции. Шины бывают разных размерностей, и в силу того, что архитектура x86 довольно стара и сохранила совместимость с предками вплоть до 16-битных процессоров, даже современные 64-битные процессоры по умолчанию стартуют в 16-битном режиме и переключить его — задача загрузчика или ОС. Так вот, это все к тому, что битность шины адреса является одним из следствий режима работы процессора.
Режимы работы процессора.
На данный момент домашние ПК могут находиться в 3 режимах: — 16-битный режим, или же real mode. Для него характерны 16-битные регистры (Это отдельная обширная тема, которой я посвящу отдельную статью), а также 16-битные машинные слова. НО 20-битная шина адреса, об этом ниже. — 32-битный режим, или же protected mode. Для него, что, думаю, очевидно, характерны 32-битные регистры, шина адреса, 32-битные машинные слова — И наконец — 64-битный режим, он же long mode. По аналогии с вышеперечисленными: 64-битные регистры, машинные слова. Физическая шина адреса же тут 52 бита, а виртуально оперирует чаще всего 48 битами иногда — 57 бит (при пятиуровневой страничной адресации, что также — тема отдельной статьи).
Real mode.
Переходим к основной части статьи — режимы работы процессора. И начнем, конечно, с real mode.
Важной особенностью этого режима является то, что из него мы имеем косвенный доступ к BIOS, а точнее, можем обращаться к нему через специальные прерывания. Таким не может похвастаться ни protected, ни long mode в силу архитектурных ограничений.
У многих вероятно уже возник вопрос: почему 16-битный режим использует 20-битную шину адреса, а главное — как? И тут не обойтись без исторической справки. 16-битная шина адреса обеспечивает доступ процессора всего лишь к 64КБ RAM, что почти не давало прироста в сравнении с предыдущими 8-битными ПК. Перед инженерами Intel возникла задача — увеличить это число хоть как-нибудь. И они пришли к идее о сегментации, сделав шину адреса 20-битной, что сразу расширило максимальный объем адресуемой памяти до 1МБ.
Сегментация.
Сегментация — модель адресного пространства, при котором память разделяется на сегменты. Сегмент — непрерывная область памяти, начало которой хранится в сегментном регистре. Нужные данные же хранятся внутри сегмента, а их позиция в нем задается смещением — числом, хранящемся в регистре общего назначения (GPR).
В этой модели памяти адрес задается не прямым “наименованием” байта, как в protected mode, а формулой:
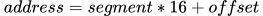
Почему умножаем на 16? Потому что 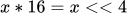 . На деле получается:
Сегмент: 0bXXXX XXXX XXXX XXXX
* 16 (он же << 4): 0bXXXX XXXX XXXX XXXX 0000
Сдвиг: 0b0000 YYYY YYYY YYYY YYYY
Адрес: 0bXXXX XXXX XXXX XXXX 0000 + 0b0000 YYYY YYYY YYYY YYYY
А на конкретных цифрах:
Сегмент: 0b0010 1001 0110 1001
* 16: 0b0010 1001 0110 1001 0000
Сдвиг: 0b0000 1010 0011 1010 0001
Адрес: 0b0010 1001 0110 1001 0000 + 0b0000 1010 0011 1010 0001 = 0b0011 0011 1010 0011 0001
Т.е., как я думаю уже понятно, программе напрямую по конкретному адресу в нужное место не попасть:
bits 16
main:
    mov [0xB8000], 'A' ; На экран ничего не выведется, поскольку архитектура требует адрес вида сегмент:смещение.

	mov ax, 0xB800
	mov es, ax
	mov di, 0
	mov [es:di], 'A' ; На экран выведется A, поскольку 0xB800 * 16 + 0 = 0xB8000, что как раз адрес VGA text buffer.
A20.
Также одной из особенностей архитектуры x86 является наличие адресной линии А20 на шине процессора, которая по умолчанию выключена, а без ее включения любые адреса выше 1МБ будут заворачиваться (wrap-around эффект). Если конкретнее — бит 20 (сама линия А20) и выше. Дальше все просто отбрасывается, и в итоге остаются только младшие 20 бит. Например:
Адрес: 0×10FFFF
Этот же адрес с выключенной A20 процессор читает как: 0×0FFFF
Поэтому, если программе нужен будет доступ к памяти выше 1МБ, эту шину обязательно нужно включить. Самый простой способ: Fast A20 gate, проворачиваемый всего в 3 строчки на ассемблере:
in al, 0×92 ; Сохраняем значение порта 0×92 — порта, 1 бит (если считать от 0) которого как раз и отвечает за нужную нам линию, хотя и другой функционал тоже имеет.
or al, 2 ; Выставляем тот же 1 бит в 1.
out 0×92, al ; Записываем получившееся обратно в порт.
На самом деле, этот вариант хоть и прост, но достаточно ненадежен, поскольку подразумевает, что бит 1 у порта всегда 0, а также не учитывает возможные ошибки. Мы платим надежностью за простоту.
Protected mode.
Protected mode - 32-битный режим процессора. Здесь уже можно линейно обращаться к памяти, в отличие от предыдущего режима. Максимальный объем адресуемой памяти увеличился до 4ГБ, а также появляется возможность включить paging. А теперь подробнее.
Сегментация.
Здесь сегментация из «адресного» принимает защитный характер, отсюда и название режима. В чем заключается «защитная роль»: — Сегментные регистры (CS, DS, ES и т.д.) теперь хранят не адрес, а селектор — ссылку на дескриптор, где теперь записаны база сегмента, лимит, права доступа и т.д. — При каждой загрузке селектора процессор сам проверяет все это и выдает ошибки при несовпадении с ожидаемым. Все без участия ОС. — Это обеспечивает гибкость адресации, когда ОС может менять дескриптор и все селекторы будут автоматически указывать на новые. А также изоляцию, когда никто не может выйти за границы своего сегмента (лимит) или без должных прав делать что-либо.
Дескрипторы — это своего рода «описатели». «Записи», в которых описаны некоторые «правила». В GDT (Global Descriptors Table) — «правила» работы с памятью и сегментами, в IDT (Interrupt Descriptors Table) — «правила» реагирования процессора на те или иные прерывания.
Особенности режима.
Для работы protected mode требует заранее настроенной GDT. Это архитектурное ограничение. Поэтому перед переходом в 32-битный режим нужно настроить хотя бы базовую глобальную таблицу дескрипторов. Каждый дескриптор имеет формат:
Байты 0-1. Limit, “Где заканчивается сегмент”
Байты 2-4. Base, “Где начинается сегмент”
Байт 5. Access byte, права
Байт 6. Флаги (старшие 4 бита) + Limit (младшие 4 бита)
Байт 7. Base Такая “некрасивая” структура обусловлена историей и желанием совместимости новых процессоров со старой архитектурой и программами.
Сама GDT обязана начинаться с нулевого дескриптора. А максимальный размер - 64КБ (65535 байта из-за 16-битного поля лимита), т.е. 8191 дескриптора. И, поскольку первый дескриптор нулевой, в итоге их может быть до 8190. Хотя, на деле редко используется больше нескольких десятков.
Также в этом режиме появляется возможность включить paging — страничную модель адресации памяти. Это тема для отдельной большой статьи, но тут я кратко опишу суть.
Со включением paging (Бита PG в служебном регистре CR0) процессор уже оперирует не физическими, а виртуальными адресами. В системе еще до включения paging должны быть созданы таблицы страниц. Обычно они разделяются на 4 уровня: — PML4 (Page Map Level 4). Самая большая таблица. Её адрес помещается в регистр CR3 и далее все виртуальные адреса будут находиться внутри неё до переключения на другую таблицу того самого регистра. Её записи хранят адреса на следующий уровень таблиц. — PDPT (Page Directory Pointer Table). На неё указывают записи в PML4, а сама она указывает на следующий уровень. — PD (Page Directory). Аналогично PDPT. — PT (Page Table). Записи в ней уже указывают не на следующий уровень таблиц, а на сами фреймы (4КБ) — физические области памяти, где фрейм по размеру равен странице — основной единице разбиения адресного пространства.
Т.е. это своего рода «пакет с пакетами», только в конце тебя ждет не то, что ты ищешь, а адрес того, что ты ищешь.
В каждой таблице может храниться до 512 записей, указывающих на разные таблицы следующего уровня (на фреймы в случае PT). Таким образом каждая PML4 может указывать на 512 таблиц PDPT, каждая из которых может указывать на 512 PD, которые в свою очередь указывают на 512 PT, а каждая из них — на фрейм.
Выше описана схема именно для long mode. В protected mode без PAE адресация двухуровневая (PD -> PT) по 1024 записи, а с PAE — трехуровневая (PDPT -> PD -> PT) по 512 записей.
Это очень упрощенная схема, упускающая кучу деталей, особенностей, оставляющая кучу вопросов, которая просто в общих чертах описывает логику работы. Но в рамках конкретно этой статьи подробностей не будет.
Long mode.
И последнее — 64-битный режим. Сегментация здесь уже практически не используется, а для работы обязателен уже включенный paging. И снова к подробностям.
Сегментация.
Сегментация в Long mode уже фактически не используется. Практически все сегментные регистры, которые использовались ранее, игнорируются процессором. «Активными» остаются только 2: FS и GS. Они нужны для доступа к TLS (Thread-Local Storage) и в разных ОС могут использоваться по разному.
Адресация.
Как я упоминал выше, несмотря на то, что адресная шина тут 52-битная, зачастую для адресации используется только 48 бит. Тут следует еще немного погрузиться в страничную адресацию, поскольку в Long mode используется именно она и только она. Виртуальный адрес выглядит теперь так:
0x0000124836C9BEDF
=
0b0000 0000 0000 0000 0001 0010 0100 1000 0011 0110 1100 1001 1011 1110 1101 1111
Где старшие 16 бит должны быть копией 47 бита (canonical address). Младшие 12 - смещение внутри страницы/фрейма, а каждые 9 между ними - номер записи таблицы в вышестоящем уровне. Т.е.:
0b0000000000000000 000100100 100100000 110110110 010011011 111011011111
 |CanonicalAddress|  PML4  |   PDPT   |   PD    |   PT   |    offset   |
Где трансляция (определение нужного физического адреса из виртуального) выглядит так: PML4[36] -> PDPT; PDPT[288] -> PD; PD[438] -> PT; PT[155] -> Frame; Frame + 3807 = нужный байт.
Canonical address — разделение адресных пространств. Т.е. «нижнее» пространство, где старшие 16 бит =0, принадлежит пользователю, а «верхнее» пространство, где старшие 16 бит =1, принадлежит ядру ОС (higher half). Каноническая дыра, создаваемая таким механизмом, просто огромна и съедает больше 99.99% всех возможных адресов, но даже так каноническая адресация дает 128ТБ на пользовательское пространство и столько же на пространство ядра, итого 256ТБ на всю систему, что уже запас памяти на десятилетия вперед для домашних ПК. Но уже существует 5-уровневая адресация с виртуальным адресом 57 бит, и обсуждается 6-уровневая.
Переход между режимами.
Отдельно распишу специфические условия перехода между режимами: — Для перехода из real mode в protected mode — это валидная GDT, адрес которой помещен в GDTR, а также выставление бита PE в регистре CR0 — Для перехода из protected mode в long mode — это заранее настроенная таблица страниц, валидный адрес PML4 которой помещен в регистр CR3, фактическое «включение» paging выставлением бита PG в том же CR0, установка бита PAE в регистре CR4 и бита LME в регистре EFER. — Финальным шагом каждого перехода является far jump, обновляющий CS.
Заключение.
Опыта в написании подобных статей у меня нет, поэтому, думаю, она довольно дырявая. В будущем, по мере наработки опыта, статьи будут становиться качественнее. Что касается меня, я веду свой GitHub и иногда делаю посты в ТГК. А к “опыту”, который я имею, относятся 2 моих основных проекта:
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.