Внедрение ИИ буксует не из-за модели, главный тормоз — интеграция
Меня зовут Виктор Овчинников, больше двадцати лет я занимаюсь обменом данными между корпоративными системами и сейчас руковожу разработкой интеграционной платформы.
Все эти годы интеграция оставалась скучной технической прослойкой, которую в бюджетах по привычке записывали в строку «поддержка». В 2026 году ситуация изменилась, и не потому, что шины вдруг стали красивее или моднее, а потому, что ИИ-проекты начали массово застревать именно в интеграционном слое.
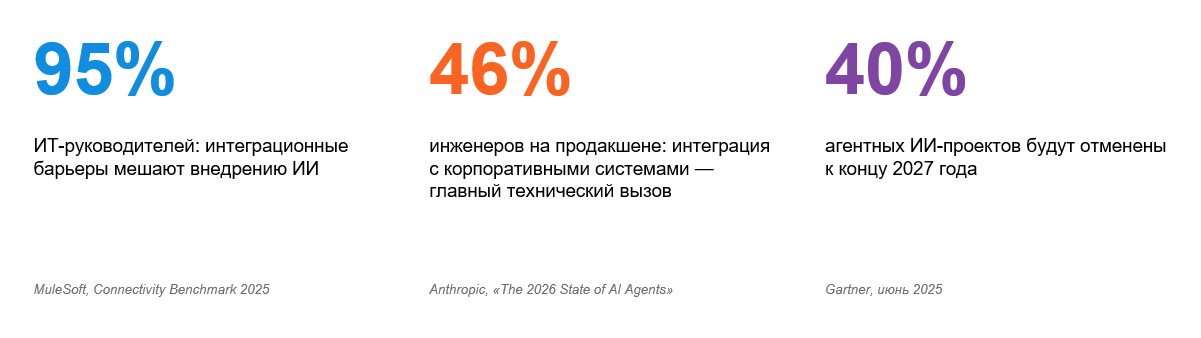
Главный тормоз ИИ-проектов в крупных компаниях в 2026 году - это не выбор модели, не мощности GPU и не цена за токены. Это банальный обмен данными между корпоративными системами. В Connectivity Benchmark Report 2025 компании MuleSoft 95% ИТ-руководителей отметили, что интеграционные барьеры мешают внедрению ИИ. Отчет Anthropic «The 2026 State of AI Agents» фиксирует ту же картину с другого угла: среди инженеров, которые уже строят агентные системы на продакшене, 46% называют интеграцию с существующими корпоративными системами главным техническим вызовом - она обошла и вопросы безопасности с комплаенсом (40%), и качество самих данных (42%).
Агент - не пассивный потребитель отчета, а автономный клиент, который читает и пишет в десятки систем, и каждое его действие должно быть идемпотентным, воспроизводимым и проверяемым постфактум. Ни один из привычных подходов на это не рассчитан.
Отсюда и содержание доклада. Во-первых, я формализую шесть архитектурных свойств интеграционного слоя. Во-вторых, на кейсе покажу, что итоговый time-to-market определяет закрытие именно этих шести свойств, а не выбор платформы. В-третьих, предлагаю архитектуру между двумя доминирующими крайностями - монолитной шиной и децентрализованным API-first, - что отдельно значимо для рынка, лишившегося доступа к классическим ESB. ИИ-узел в этой схеме трактуется как рядовой тип коннектора, а не как надстройка. Тем самым доклад смыкает две области, которые до сих пор развивались параллельно: инженерию корпоративной интеграции и проектирование агентных ИИ-систем, вторая из которых сегодня занята в основном протоколами взаимодействия агентов - MCP, A2A, - но не архитектурой данных, поверх которой эти протоколы вынуждены работать.
И сразу снимаю возможное недопонимание: доклад не про низкий уровень зрелости интеграций. Мы работаем и с крупными энергетическими компаниями, и с небольшими промышленными предприятиями, и с банками. Высокая зрелость - это не защита от проблемы, а как раз то место, где она проявляется. Чем больше в компании систем, шин, коннекторов и лет истории ландшафта, тем острее вопрос, как в этот ландшафт встраивается ИИ. Модель может быть сколь угодно сильной - буксовать она все равно будет на стыке систем.
Почему это стало горячей темой именно сейчас
В 2024-м ИИ-проекты запускались точечно. Команда берет один датасет, один процесс, обучает модель, показывает пилотное демо, получает премии. Интеграция в таком сценарии даже не упоминается в техническом задании: данные выгружаются в CSV раз в сутки, модель живет в отдельном контуре, все счастливы.
В 2025-м начался переход от точечных кейсов к агентам и мульти-модельным архитектурам. Агент, в отличие от чат-бота, должен читать и писать в корпоративные системы, а их у среднего российского банка сто с лишним, у промышленного холдинга иногда больше трехсот. Ему нужен доступ в реальном времени, с гарантированной доставкой, с контролем прав и со сквозной трассировкой. Протокол MCP (Model Context Protocol), появившийся в конце 2024-го, сделал LLM полноценным интеграционным узлом. Следом подтянулись A2A-протоколы, которые завязывают несколько агентов в один рабочий процесс.
И тут выяснилось, что корпоративный ИТ-ландшафт к этой новой жизни не готов. Пока все спорили о выборе модели и тонкостях промптинга, бутылочное горлышко сидело уровнем ниже, в слое, на который годами смотрели по остаточному принципу. Локальный чат-бот на одном хорошо подготовленном датасете работает. Агент, которому нужно собрать контекст из CRM, биллинга, хранилища документов и пары внешних API, ломается на первом же шаге, еще до того, как запрос дойдет до LLM. А пилоты, о которых с гордостью отчитывались на советах директоров, массово застревают в песочнице: Gartner прогнозирует, что более 40% агентных ИИ-проектов будут отменены к концу 2027 года. И не потому, что где-то закончились идеи, а потому, что данные не добрались до моделей.
Четыре подхода к интеграции, и где каждый из них ломается
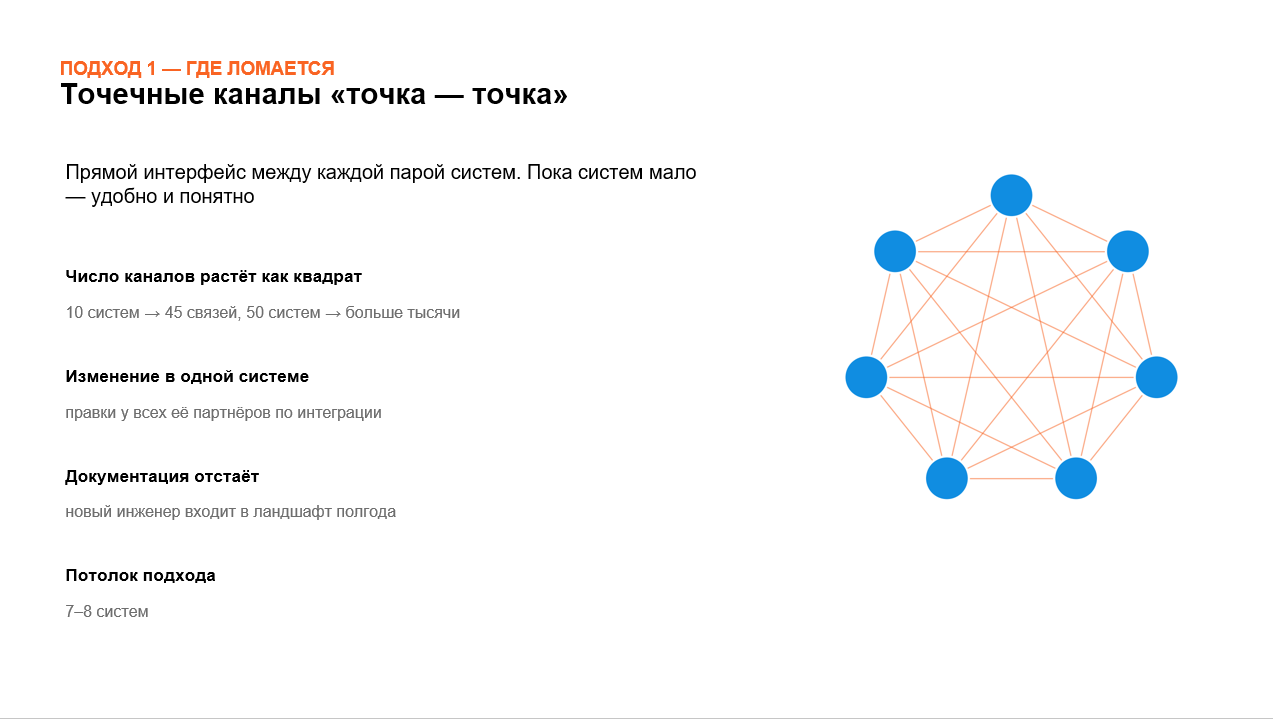
Самый старый и самый очевидный способ связать системы между собой - точечные каналы по принципу «точка-точка». Между каждой парой систем создается прямой интерфейс. Пока систем в ландшафте мало, все хорошо: легко понять, кто с кем общается, быстро починить, быстро добавить новую связь. Проблема в том, что количество каналов растет как квадрат от количества систем. На десяти системах их может быть до сорока пяти, на пятидесяти - уже за тысячу. Любое изменение в одной системе тянет за собой правки у всех ее партнеров по интеграции, тестирование превращается в ад, документация отстает, новый сотрудник разбирается в ландшафте полгода. Подход удобен ровно до того момента, пока систем у вас не больше семи-восьми.
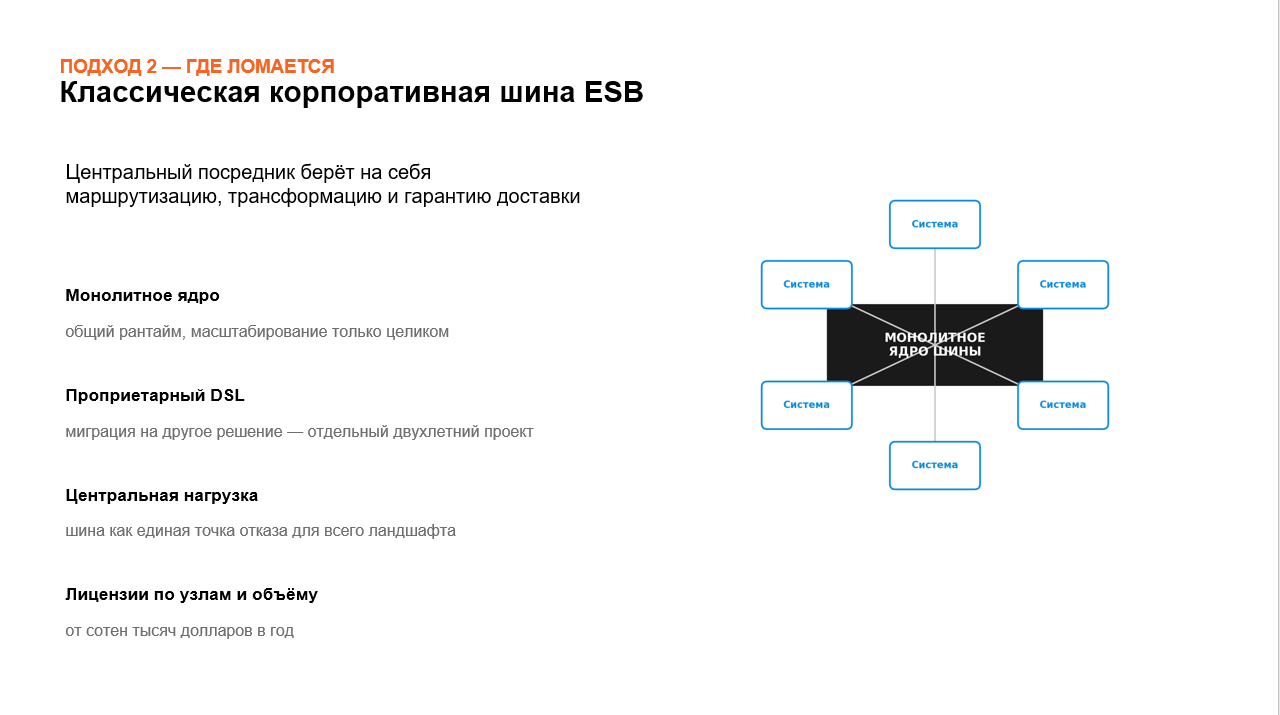
На рубеже нулевых появилась Enterprise Service Bus, классическая шина. Идея красивая: поставить в центр посредника, через которого все системы общаются друг с другом, и взвалить на него маршрутизацию, трансформацию форматов и гарантию доставки. Тогда же расцвели крупные вендоры: IBM WebSphere Message Broker, Tibco ActiveMatrix, Oracle Service Bus, Mule, WSO2. К середине 2010-х стало понятно, что у классической ESB есть свои, уже собственные грабли. Ядро получилось монолитным: все потоки живут в одном рантайме и делят его память, потоки исполнения и пулы соединений. Масштабировать такую шину можно только целиком - выросла нагрузка в паре маршрутов, а наращивать приходится всю установку; и наоборот, тяжелый или сбойный поток отбирает ресурсы у соседних, с которыми у него нет ничего общего. DSL, на котором описывают интеграционные потоки, обычно проприетарный, и команда годами вязнет в экосистеме одного вендора, а миграция на другое решение превращается в отдельный двухлетний проект. Нагрузка оказалась централизованной, и шина стала единой точкой отказа для всего корпоративного ландшафта. Наконец, цена лицензий с привязкой к количеству узлов или объему сообщений легко переваливала за сотню тысяч долларов в год, а для крупных заказчиков уходила в миллионы.
После 2022-го к этому добавилась отдельная российская проблема. Tibco, Mule, WSO2, IBM MQ либо ушли с рынка, либо перестали поставляться и нормально поддерживаться. Нормативная рамка при этом жёсткая: Указ Президента №166 от 30 марта 2022 года запретил субъектам КИИ закупать иностранное ПО для значимых объектов без согласования, а с 1 января 2025 года - и использовать его на этих объектах. Для многих банков и промышленных холдингов это означало простую вводную: интеграционный слой надо переписать или мигрировать за 12–18 месяцев, причем силами команд, у которых весь опыт наработан именно в экосистеме ушедшего вендора.
Параллельно в мире набирал популярность API-first подход. Каждый сервис выставляет наружу REST или gRPC API, все общаются через API-gateway без посредников. Для ландшафтов, собранных с нуля на современном стеке, это работает. Для legacy, где в основе core-банкинг на COBOL, ERP на устаревшем фреймворке и десяток самописных систем без документации, вариант не работает вовсе. Микросервисная архитектура без слоя оркестрации довольно быстро вырождается в ту же «точку-точку», только на более модных протоколах.
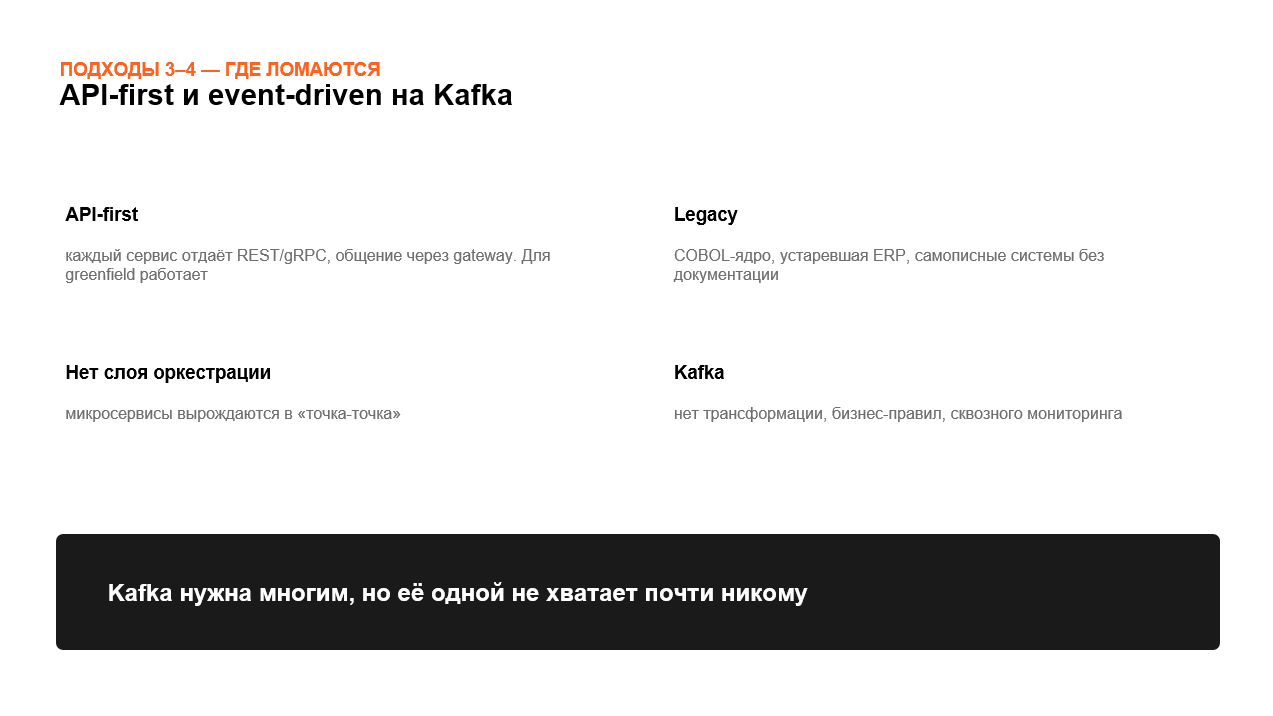
Отдельная история - это event-driven стек на Apache Kafka. Для высоконагруженных сценариев он стал стандартом де-факто: события публикуются в топики, подписчики их читают, производительность уходит далеко за пределы, достижимые для классической шины. Но сама по себе Kafka транспорт, а не интеграционная платформа. Она не решает задач трансформации данных, контроля бизнес-правил, сквозного мониторинга, маппинга семантики. Kafka нужна многим, но ее одной не хватает почти никому.
Чек-лист: готов ли ваш интеграционный слой к агентам
Прежде чем перейти к архитектурным принципам, дам практический инструмент. Все перечисленные подходы ломаются под агентом по одним и тем же причинам, и эти причины удобно свести в короткий опросник. Пройдите по нему для своего ландшафта: если хотя бы один блок закрыт наполовину или не закрыт вовсе, агент застрянет именно там - еще до того, как дело дойдет до модели.
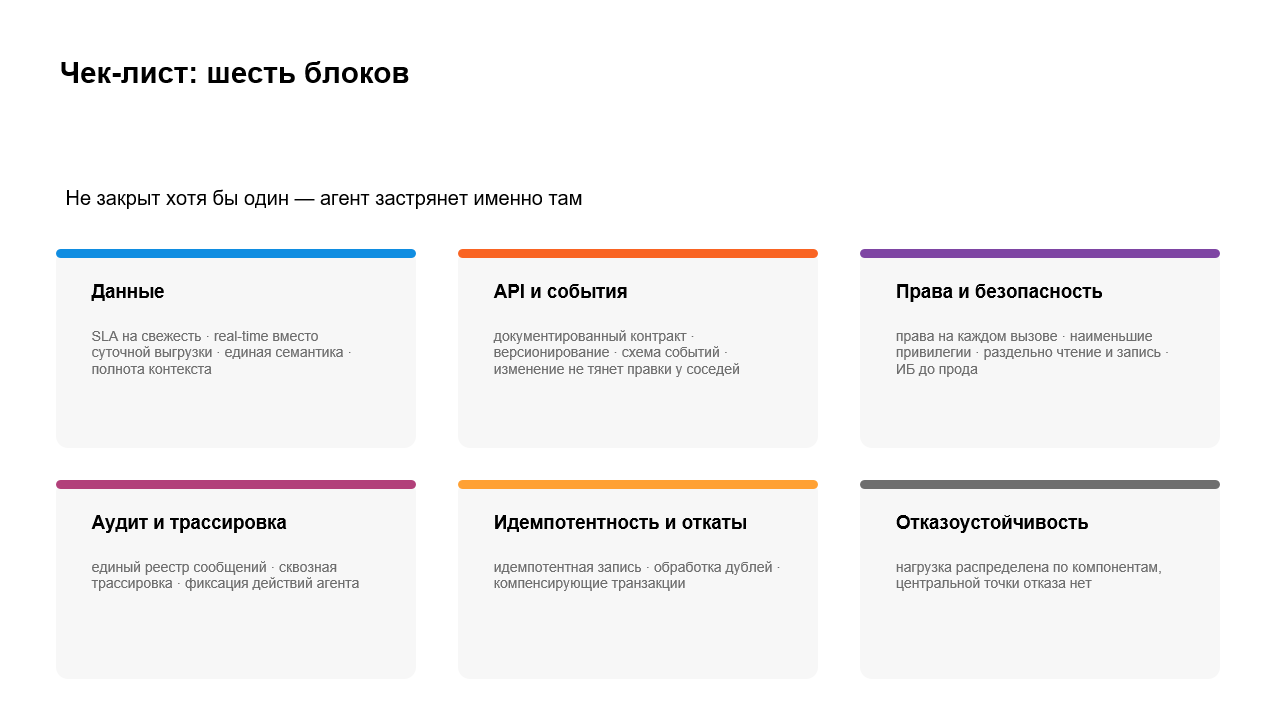
Данные. Определен ли SLA на свежесть по каждому источнику; доступны ли данные в реальном времени, а не выгрузкой раз в сутки; есть ли единая семантика и маппинг полей между системами; проверяется ли полнота контекста перед передачей в модель.
API и события. Есть ли у каждой ключевой системы документированный контракт; есть ли версионирование и обратная совместимость; описана ли схема событий; не тянет ли изменение в одной системе правки у всех ее партнеров.
Права и безопасность. Контролируются ли права агента на уровне каждого вызова, а не «выдан один ключ ко всему»; соблюдается ли принцип наименьших привилегий; разделены ли права на чтение и на запись; проходят ли потоки проверку ИБ до прода, а не после инцидента.
Аудит и трассировка. Есть ли единый реестр всех сообщений; можно ли проследить любое событие от источника до получателя и отмотать историю назад; фиксируются ли действия агента - кто, что и когда прочитал или записал.
Идемпотентность и откаты. Идемпотентны ли операции записи; обрабатываются ли дубли сообщений; реализованы ли компенсирующие транзакции для отката при частичном сбое цепочки. Это критично именно для агентов: они охотно ретраят, и неидемпотентная запись мгновенно превращается в дубликаты в боевых системах.
Отказоустойчивость. Отсутствует ли единая центральная точка отказа; не валит ли сбой в одном канале весь ландшафт.
Чек-лист сознательно сформулирован в терминах свойств, а не продуктов: он одинаково применим и к самописной шине, и к Kafka с обвязкой, и к любой коммерческой платформе. Важен не логотип на архитектурной схеме, а то, закрыты ли эти шесть блоков.
Архитектурный принцип, который закрывает чек-лист
Если посмотреть, что общего у решений, которые эти шесть блоков реально закрывают, вырисовывается один и тот же принцип, независимо от вендора и стека.
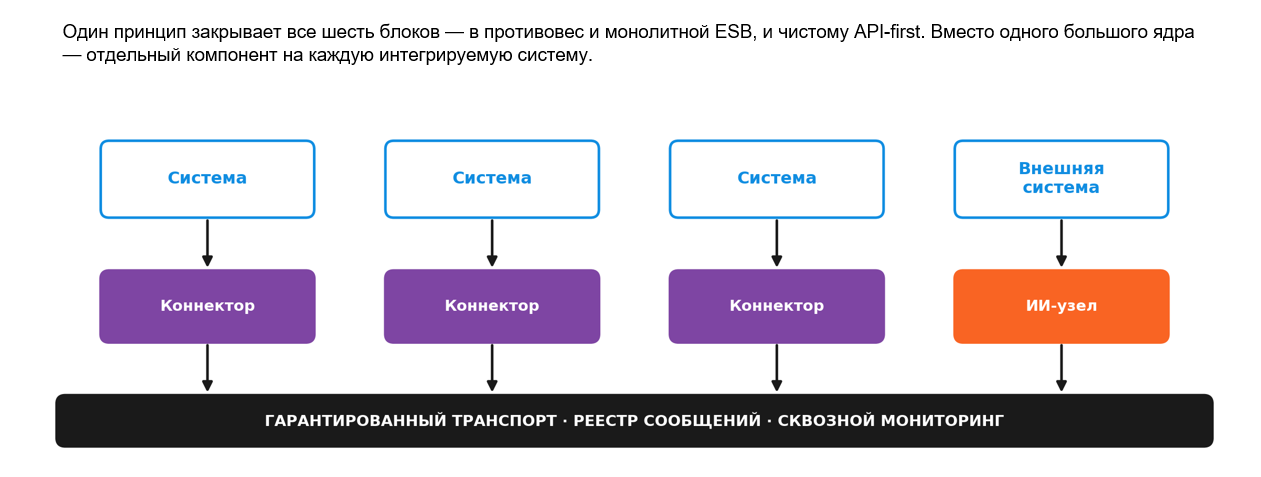
Идея в том, чтобы вместо одного большого ядра для каждой интегрируемой системы держать отдельный компонент-коннектор. Вся логика взаимодействия именно с этой системой - протокол, аутентификация, перевод её формата в общий контракт и обратно, обработка её отказов и ретраи - живет внутри её собственного коннектора. А сами коннекторы общаются между собой через гарантированный транспорт с единым реестром всех проходящих сообщений, сквозным мониторингом и механизмом сверки данных, и логика самих потоков живет в отдельных компонентах-маршрутизаторах.
Из чего собран такой слой
Компонентов в нем два типа, и различать их важно не терминологически, а практически: они появляются в ландшафте по разным причинам и растут независимо друг от друга.
Коннектор отвечает за подключение к конкретной системе: ее протокол и транспорт, аутентификацию, обработку ее отказов - таймауты и повторы подключения. Здесь же, и только здесь, происходит трансформация: из формата системы в канонический контракт на входе и обратно из контракта в формат системы на выходе. И здесь же живет идемпотентность записи, потому что только коннектор знает, что именно его система считает дублем, какой ключ делает операцию повторяемой, где допустим upsert, а где строгая вставка. Коннектор заводится один на одну интегрируемую систему, и вся ее специфика оказывается заперта внутри: снаружи любая система выглядит одинаково.
Адаптер-маршрутизатор работает уже в канонических терминах и о внешних системах не знает ничего. Он решает, куда идет сообщение, применяет бизнес-правила потока, обогащает сообщение данными из смежных систем - оркеструя вызовы через их коннекторы, а не обращаясь к системам напрямую, - и обрабатывает ошибки маршрута: повторы, компенсации, отправку в очередь недоставленных.
Отдельная и недооцененная задача адаптера - сопоставление идентификаторов. Один и тот же клиент существует как номер в CRM, как лицевой счет в учетном ядре и как внешний UUID у партнера. Понимать, что все три записи описывают один объект, не может ни одна из систем по отдельности: у каждой свой идентификатор и своя правда. Это знание принадлежит маршруту и живет в адаптере. Без него агент, собравший контекст из четырех систем, с высокой вероятностью склеит в одну карточку двух разных людей - и это ровно тот класс ошибок, который в пилотах не ловится, а в проде стоит дорого.
Практическое следствие этого разделения простое. Когда в ландшафт добавляется система, растет число коннекторов, а адаптеры не трогаются. Когда бизнес просит новый процесс поверх тех же систем, добавляется адаптер, а коннекторы не трогаются. Именно отсюда берутся точечный деплой и локальное регрессионное тестирование, которых требует второй блок чек-листа: изменение не расползается по ландшафту, потому что ему просто некуда расползаться.
Путь одного сообщения
Система-источник отдает событие своему коннектору. Коннектор проверяет права, переводит данные из формата системы в канонический контракт и кладет сообщение в транспорт. Транспорт хранит его на диске, соблюдает порядок и приоритеты, гарантирует доставку. Адаптер забирает сообщение, сопоставляет идентификаторы, применяет маршрут и правила потока - все это в канонических терминах, о самих системах он ничего не знает - и отдает коннектору получателя. Тот переводит контракт обратно в формат своей системы и пишет с идемпотентным ключом, так что повторная доставка не создаст дубль.
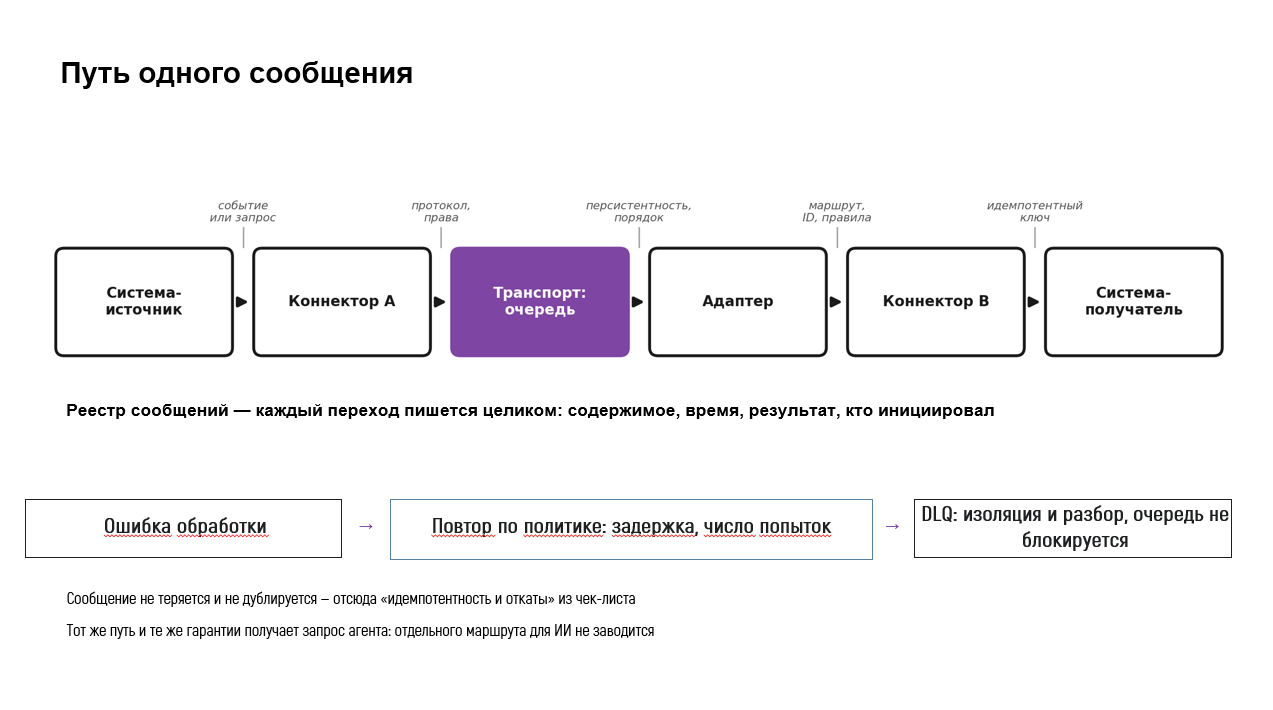
Разделение ответственности здесь принципиально. Гарантия «не задвоим» живет в коннекторе, а не в маршруте: только коннектор знает ключи и семантику записи своей системы. Маршрут отвечает за другое - что делать, если шаг не удался: повторить, компенсировать уже выполненные шаги или отложить сообщение в разбор.
Под всей цепочкой лежит реестр. Каждый переход пишется целиком: что было в сообщении, когда, с каким результатом, кто инициировал. Именно это превращает «где-то потерялся платеж» из расследования на два дня в вопрос на две минуты.
Отдельного внимания заслуживает ветка отказа, потому что в пилотах ее обычно не проектируют вовсе. Если обработка не удалась, включается политика повторов с настраиваемой задержкой и ограничением числа попыток; если и это не помогло, сообщение уходит в очередь недоставленных на ручной разбор. Принципиально то, что проблемное сообщение изолировано и не блокирует очередь для всех остальных: без этого свойства единичный сбой останавливает поток целиком. Каждое из перечисленных свойств закрывает свою строку чек-листа - гарантированный транспорт и идемпотентная запись отвечают за идемпотентность и откаты, единый реестр за аудит и трассировку, изоляция сбойного сообщения за отказоустойчивость.
Ключевой момент для ИИ: в такой архитектуре ИИ-узел подключается как коннектор. Он занимает в схеме ровно то место, где у любой другой системы стоит компонент, отвечающий за взаимодействие с ней, - и раз место то же, то и правила те же. Тот же канонический контракт на входе, те же проверки прав на каждом вызове, то же попадание каждого действия в реестр: на вопрос «что именно агент прочитал и что записал вчера в четырнадцать тридцать» ответ есть по построению, а не потому, что кто-то предусмотрел отдельное логирование для ИИ. Для регулируемых отраслей это часто оказывается решающим аргументом.
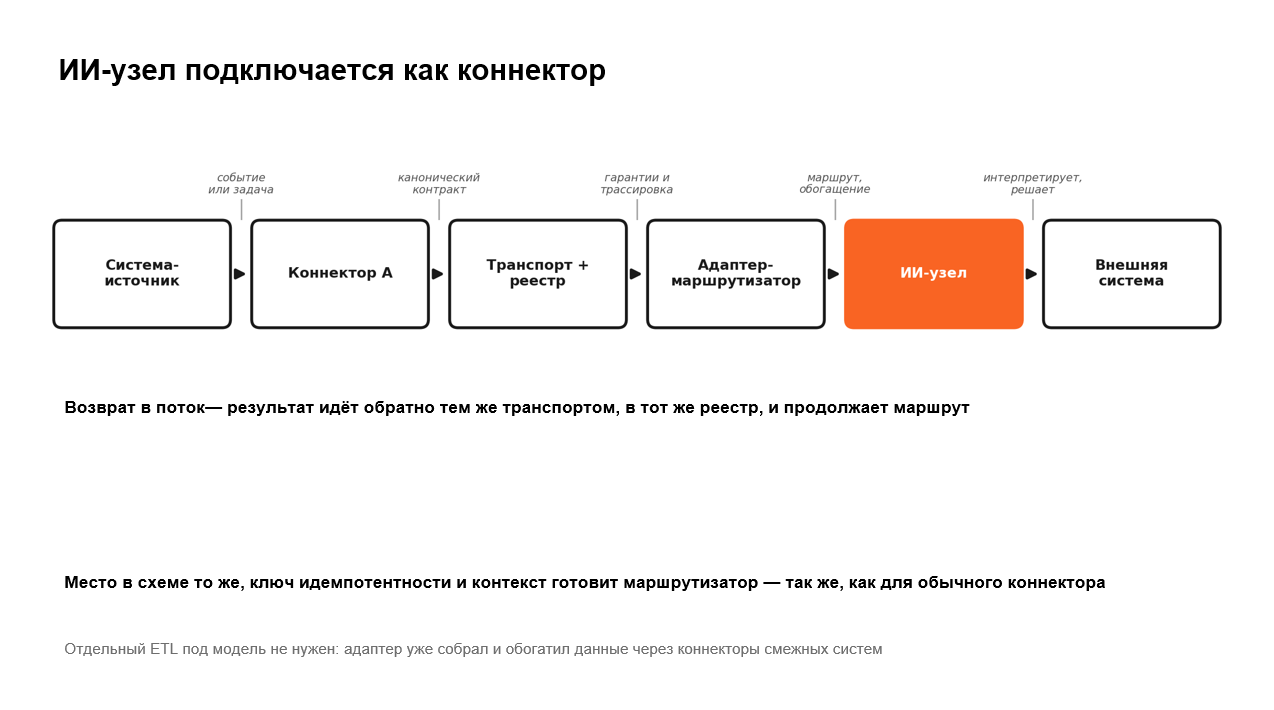
Механика такая. Адаптер-маршрутизатор доводит до ИИ-узла сообщение в каноническом контракте - уже с сопоставленными идентификаторами и обогащенное данными смежных систем. ИИ-узел интерпретирует его, понимает, какое действие требуется, выполняет его во внешней системе и возвращает результат в поток. Дальше маршрут идет своим чередом: для остальных компонентов ничего не изменилось.
Отличие от обычного коннектора ровно одно, но существенное. Обычный коннектор реализует отображение, которое заранее описал разработчик: пришел такой контракт - вызови такой метод с такими полями. Поведение воспроизводимо, и это его достоинство; обратная сторона в том, что изменение API означает доработку и релиз, а каждый нетиповой сценарий - новую ветку в коде. ИИ-узел выводит поведение из задачи и сам решает, какие вызовы выполнить. Цена - недетерминизм, и формулировать это стоит прямо: мы ставим недетерминированный компонент в позицию, которая отвечает за запись в боевую систему. Отсюда практическое правило: чем выше цена ошибки, тем уже коридор. Массовая типовая запись - платежи, проводки, регулярные выгрузки - остается за обычным коннектором; ИИ-узел берет то, что кодом закрывается плохо: системы без внятного API, где остается интерфейс или полуструктурированные документы, и сценарии, которых слишком много, чтобы описать каждый.
Один нюанс, на котором спотыкаются: ключ идемпотентности должен приходить к ИИ-узлу вместе с сообщением из потока, а не придумываться моделью. Если ключ повторяемости генерирует недетерминированный компонент, любой ретрай превращается в дубль платежа. Назначать ключ должен маршрут.
Заодно снимается вопрос, ради которого обычно и затевают отдельный ИИ-проект: контекст для модели готовит маршрутизатор. Отдельный ETL-пайплайн строить не нужно - адаптер уже собрал и обогатил данные через коннекторы смежных систем, это его штатная работа.
Обратное направление: где проверяются права
Коннектор двунаправлен, и до сих пор речь шла об одном направлении - когда маршрутизатор доводит задачу до ИИ-узла. Обратное интереснее: если ИИ-узел стоит на месте коннектора, он может не только принимать задачу из потока, но и запускать поток сам. Внешней системой оказывается сам пользователь с ассистентом. Ценность здесь не в том, что агент получает данные из всех систем сразу: это всего лишь набор обвязок к отдельным системам, собранных в одну точку, и такую обвязку сегодня пишет каждый вендор к своему продукту. Ценность в маршрутах. «Оформить партнерский кредитный продукт» - это пять систем, согласованные контракты, пройденная проверка ИБ, гарантированная доставка и компенсации. Агент получает не данные, а готовые бизнес-операции, которые кто-то уже построил и согласовал.
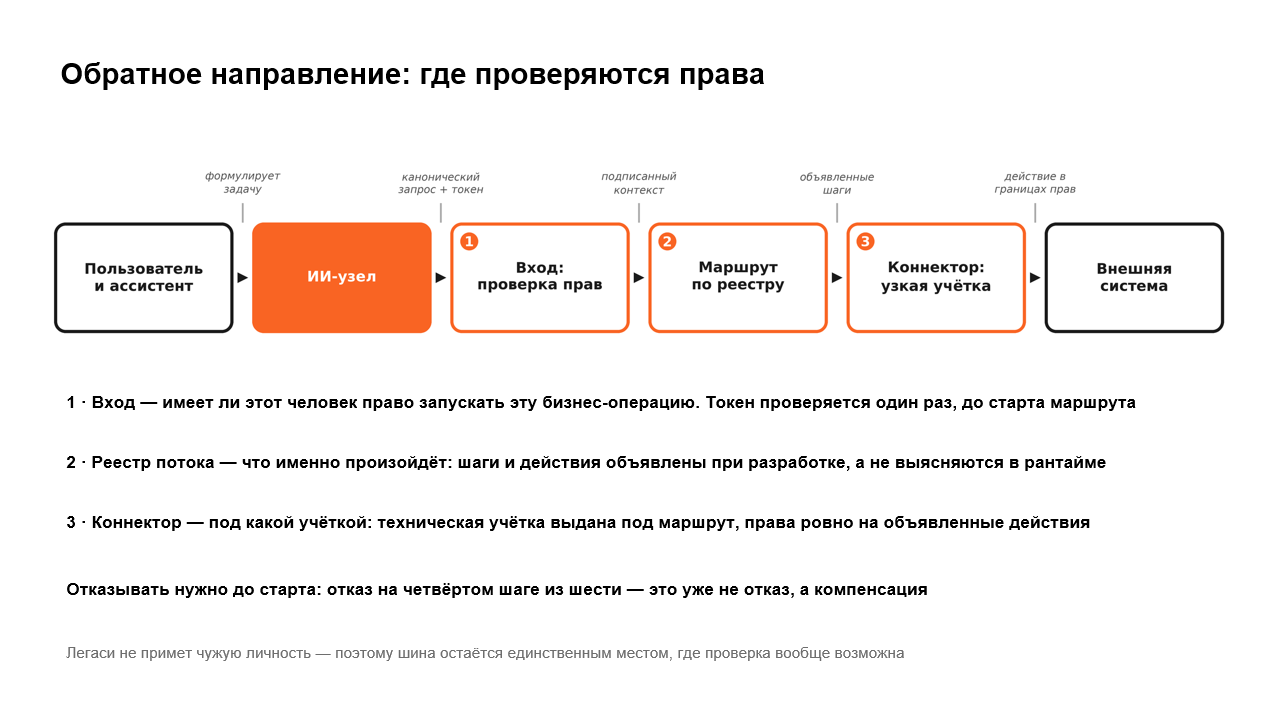
Ровно здесь появляется соблазн, который стоит назвать вслух: чтобы запустить такую операцию, достаточно оформить запрос в канонический контракт и положить его в нужную очередь. Это одновременно описание возможности и описание уязвимости - если знания контракта и имени очереди достаточно, чтобы действовать, то авторизации нет, есть API без замка. Лечится это пробросом личности пользователя, но в асинхронной среде он устроен не так, как в синхронном вызове. Токен проверяется один раз, на входе в маршрутизацию, а дальше по маршруту едет подписанный шиной контекст: кто инициировал, что разрешено, с каким ключом идемпотентности. Иначе пришлось бы хранить в шине ключи обновления всех пользователей: токен доступа живет минуты, а сообщение может дойти до коннектора через час.
Дальше удобно думать о трех уровнях. Первый - вход: имеет ли этот человек право запускать эту бизнес-операцию. Решение принимается один раз, до старта маршрута, и принимает его детерминированный компонент по реестру потоков, а не модель: модель формирует предложение канонического сообщения, а запускать его решают правила, которые она переопределить не может. В реестре потоков для этого появляется явный признак - поток допускает инициацию через ИИ-узел, для таких ролей, с такими параметрами.
Второй уровень - декларация того, что произойдет. Может показаться, что проверять права должен коннектор: только он знает, какие действия будут выполнены во внешней системе. Знает - но на этапе проектирования, а не в рантайме: набор действий шага задан адаптером и не меняется от сообщения к сообщению. Значит, это знание выносится в декларацию потока и используется на входе. Разница в цене ошибки: если решает коннектор в рантайме, отказ приходит на четвертом шаге из шести, а это уже не отказ, а компенсация наполовину выполненной операции. Отказывать нужно до старта.
Третий уровень - границы, в которых работает сам коннектор. Прокинуть токен пользователя в систему-приемник чаще всего нельзя: за интеграционным контуром стоит легаси, которое про токены ничего не знает и живет на одной технической учетной записи. Из этого следует не «значит, проверяет коннектор», а обратное: если целевая система ничего не проверит, шина остается единственным местом, где проверка вообще возможна. Роль коннектора здесь - быть узким. Одна учетка на все маршруты в АБС означает, что любой опубликованный поток может все, что может эта учетка; учетка под конкретный маршрут, с правами ровно на объявленные действия, ограничивает последствия даже при ошибке в маршрутизации.
И здесь стоит сказать вещь, которая переворачивает исходный тезис доклада. Интеграционный слой - не только способ дать агенту данные, но и единственный вменяемый способ дать агенту права. Альтернатива - раздать агенту прямые доступы в тридцать систем, и тогда на вопрос «что агент имеет право делать на предприятии» не ответит никто. Здесь же перечень допустимых операций, проверка прав и аудит живут в одном месте, которое уже построено и уже согласовано с безопасностью.
Реализовать этот принцип можно по-разному: собрать на Kafka с сервисным обвесом, взять один из коммерческих ESB-продуктов из российского реестра (их сейчас несколько, включая решения, лидирующие в отраслевых рейтингах) или, для небольших ландшафтов, вообще обойтись API-gateway. Выбор зависит от размера ландшафта и компетенций команды.
Кейс: розничный банк, который перестал ждать релизов по полгода
Цифры ниже обобщены по нескольким проектам, механика типовая для российского розничного банкинга, и любой архитектор из отрасли ее узнает. Кейс намеренно описан в терминах архитектуры, а не конкретного продукта - те же результаты достижимы на любом решении, которое закрывает чек-лист.
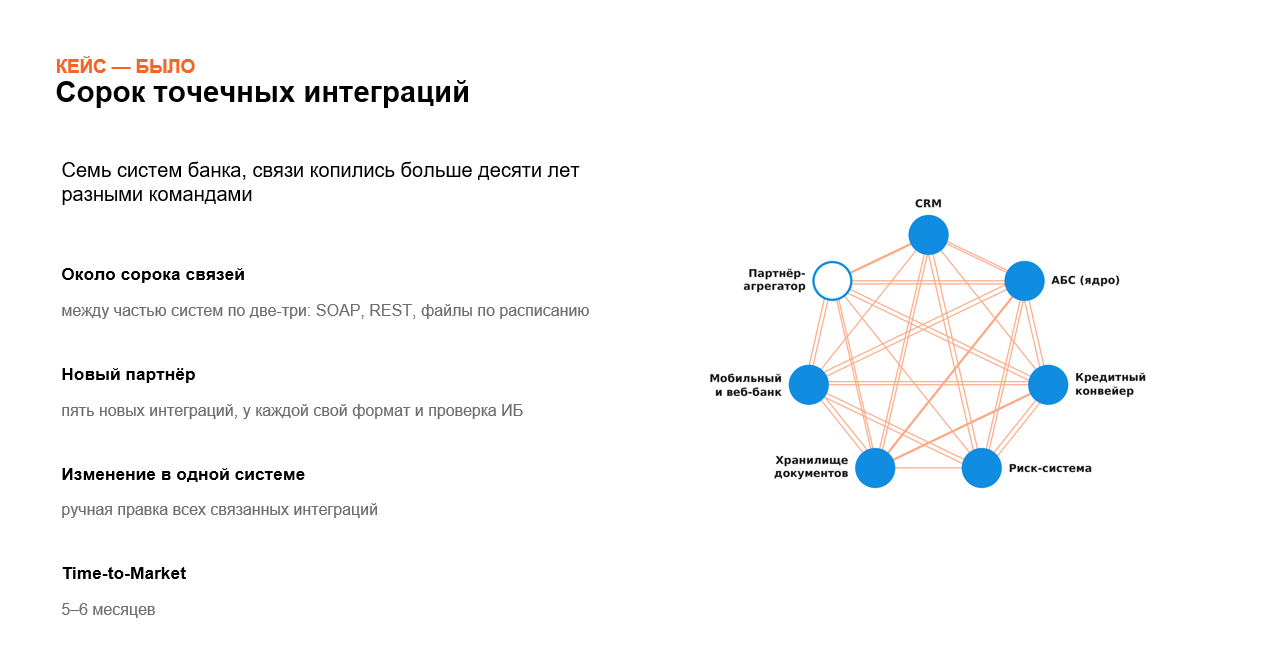
Исходный ландшафт у банка выглядел так. Core-банкинг на импортной АБС, кредитный конвейер собственной разработки, CRM, фронт-офис мобильного банка, веб-канал, риск-система, хранилище документов. Между ними за десять с лишним лет накопилось около сорока точечных интеграций, написанных разными командами в разное время и на разных технологиях. Половина крутилась на SOAP, четверть на REST, остальное ходило через кастомные транспорты и файловый обмен по расписанию. Документация местами отсутствовала вовсе, а ответственных за часть legacy-коннекторов внутри банка было уже не найти. Если приложить к этому ландшафту чек-лист из начала презентации, красным горели почти все строки разом.
Типовая задача, на которой банк регулярно буксовал, - запуск партнерского кредитного продукта с внешним агрегатором. Процесс требовал собрать данные из четырех систем - CRM (профиль клиента), кредитного конвейера (скоринг), ядра (лимиты и остатки), риск-системы (правила отсечения) - и передать результат в канал партнера, то есть закрыть пять интеграционных точек. Для каждой приходилось писать отдельный адаптер, согласовывать форматы, отдельно проходить проверку безопасности. Средний Time-to-Market доходил до пяти-шести месяцев. Поддержка интеграции год от года дорожала: каждое изменение в любой из пяти систем автоматически превращалось в задачу ручной правки интеграций.
Переход на новую архитектуру занял полгода. Параллельно шли три потока работ: создание коннекторов для каждой из систем банка, перенос существующих интеграционных потоков на новый слой без остановки продакшена и внедрение реестра сообщений со сквозным мониторингом.
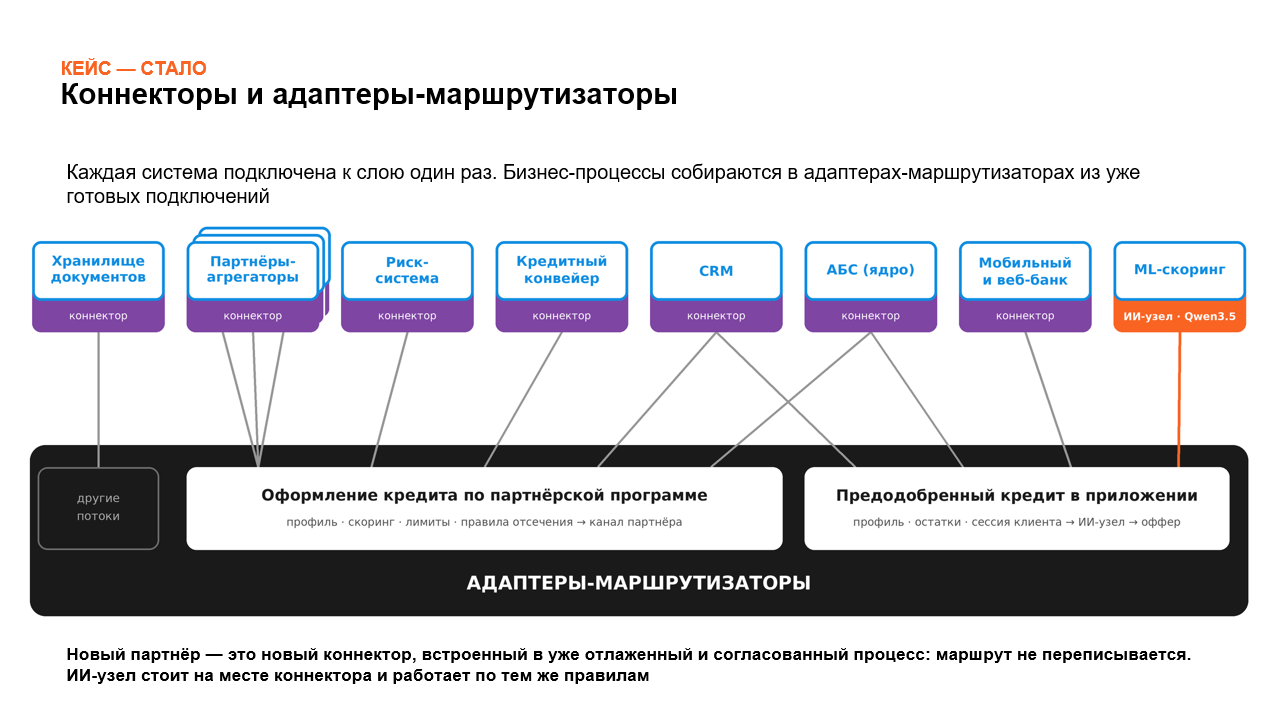
Схема после перехода отличается по самой форме. Каждая система банка подключена к слою ровно один раз - своим коннектором - и напрямую больше ни с кем не связана. Бизнес-процессы собираются уровнем выше, в адаптерах-маршрутизаторах. Оформление кредита по партнерской программе - это маршрутизатор, который берет профиль из CRM, скоринг из конвейера, лимиты из ядра, правила отсечения из риск-системы и отдает результат в канал партнера. Предодобренный кредит в мобильном приложении - другой маршрутизатор: он использует те же коннекторы к CRM и ядру, добавляет контекст сессии клиента и передает собранное ИИ-узлу, который стоит на месте коннектора к ML-модели. Подключение нового партнера в такой схеме - это один новый коннектор к его каналу, встроенный в уже отлаженный и согласованный процесс оформления. Сам маршрут не переписывается и повторно не согласуется: самое большее, в настройках маршрутизации появляется правило, куда отдавать результат. Раньше тот же партнер означал пять новых интеграций.
По итогам запуск нового партнерского продукта, от постановки задачи до релиза в проде, сократился до трех-четырех недель. Цифра не волшебная, а объяснимая: коннектры к пяти системам уже готовы, маршрутизация настраивается в low-code редакторе, тестирование идет на реестре реальных сообщений без подключения прод-систем. Затраты на поддержку интеграционного слоя упали на 40%, и экономия набралась из трех источников: отказа от уникальной разработки под каждого нового партнера, унификации протоколов на стороне адаптеров и автоматического контроля доставки вместо ручного разбора падений.
Самым важным для бизнеса оказался побочный эффект, про который в техническом задании никто не писал. Данные стали доступны для ML-моделей в реальном времени, и банк запустил скоринг второго уровня и персонализацию предложений прямо в момент общения с клиентом. До перехода это было технически невозможно: модель ждала данных из трех разных систем по сорок минут, а к моменту, когда ответ приходил, клиент уже закрывал приложение и уходил к конкурентам. По сути, банк не строил отдельный ИИ-проект - он закрыл строки чек-листа по данным и трассировке, и real-time-скоринг стал возможен сам собой.
Когда интеграционная платформа вам не нужна
Как и обещал в начале, про обратную сторону. Отдельная интеграционная платформа не универсальное лекарство, и есть несколько ситуаций, в которых она лишняя, а иногда и откровенно вредная.
Самый очевидный случай - небольшой ландшафт, в котором всего три-пять систем, у всех современные API и нагрузка низкая. Прямые вызовы через обычный API-gateway тут дешевле и в разработке, и в поддержке, а полноценная платформа превращается в пушку по воробьям и в лишний источник расходов.
Похожая логика работает там, где все ключевые системы уже живут в одной экосистеме одного вендора. Нативные интеграции внутри одной платформы работают без отдельной шины, и добавление слоя сверху значит платить за одну и ту же работу дважды.
Отдельная ситуация - новый продукт, который строится с чистого листа, без legacy. Начинать стоит с event-driven архитектуры на Kafka и API Gateway. К полноценной платформе имеет смысл приходить позже, когда ландшафт вырастет до пятнадцати-двадцати самостоятельных сервисов. Раньше это преждевременная оптимизация, за которую потом платят техдолгом.
Последний и самый неприятный сценарий - когда у команды нет ни бюджета, ни компетенций на эксплуатацию. Интеграционная платформа представляет собой отдельную инженерную дисциплину со своим стеком, своим мониторингом и своими характерными паттернами отказов. Без людей, которые умеют ее сопровождать, вы получите не решение проблемы, а еще одну legacy-систему, только дорогую и с контрактом на поддержку.
Мой практический критерий: если в ландшафте пятнадцать и больше самостоятельных систем и хотя бы у трех из них нет современных API, единый интеграционный слой окупается за 12–18 месяцев. При меньшем размере ландшафта стоит подумать дважды и посчитать TCO на горизонте нескольких лет, не пропуская расходов на людей.
Что в сухом остатке
Когда в 2026-м спросят, почему ИИ-стратегия уехала по срокам, ответ с высокой вероятностью окажется не про выбор модели и не про мощности GPU. Он будет про то, что данные не доехали до модели в нужное время и в нужном формате, а корпоративный ландшафт никто заранее не готовил к тому, что в нем заведутся автономные агенты, которым разом нужен real-time доступ к полутора десяткам разных систем. Инвестиции в LLM без инвестиций в интеграционный слой - это оплата билета на поезд, на который вы не сможете сесть, потому что вокзал еще не построили.
Прежде чем закладывать в стратегию агентов, прогоните свой ландшафт по чек-листу - данные, API и события, права, аудит, идемпотентность, отказоустойчивость. Там, где горит красным, и лежит ваш реальный срок запуска ИИ. И еще раз подчеркну: важен не конкретный продукт, а закрытые свойства.
Если эта публикация вас вдохновила и вы хотите поддержать автора — не стесняйтесь нажать на кнопку
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.