Peut-on vraiment rendre une IA parfaitement sûre ? Asimov avait déjà compris pourquoi c’est impossible
Selon eux, les bénéfices des IA ne peuvent être mis en doute, mais il y a un risque non négligeable, environ 10% selon l'estimation stratosphérique de Hinton, que cela conduise à des catastrophes : virus biologiques et informatiques, désinformation massive, et même... fin de l'humanité.
À plusieurs reprises, j'ai montré que l'alignement total d'une IA n'est pas possible. Pour rendre cela plus concret, prenons un exemple simple avec les fameuses trois lois de la robotique d'Isaac Asimov (1920-1992). En effet, elles représentent une version littéraire et prémonitoire du problème de l'alignement qui passionnait Asimov.
Les trois lois de la robotique d’Asimov représentent une version prémonitoire du problème de l’alignement.
1. Un robot ne peut porter atteinte à un être humain ni, restant passif, laisser cet être humain exposé au danger ;
2. Un robot doit obéir aux ordres donnés par les êtres humains, sauf si de tels ordres entrent en contradiction avec la première loi ;
3. Un robot doit protéger son existence dans la mesure où cette protection n'entre pas en contradiction avec la première ou la deuxième loi.
Si l'on remplace le robot par un grand modèle de langage (LLM), cela donne une petite idée des règles en langage naturel qui sont intégrées dans son systèmes de sécurité.
Sur le papier, les trois lois semblent cohérentes et protègent les humains de tout acte potentiellement dangereux. C'est vrai dans une majorité de scénarios simples, mais aussi solides qu'elles paraissent, elles ont des failles. Ainsi, si le robot se trouve dans une situation où il doit secourir deux personnes, mais qu'il ne peut en pratique n'en sauver qu'une, cela entraine un conflit avec la première loi. Il en résulte alors une impossibilité d'action.
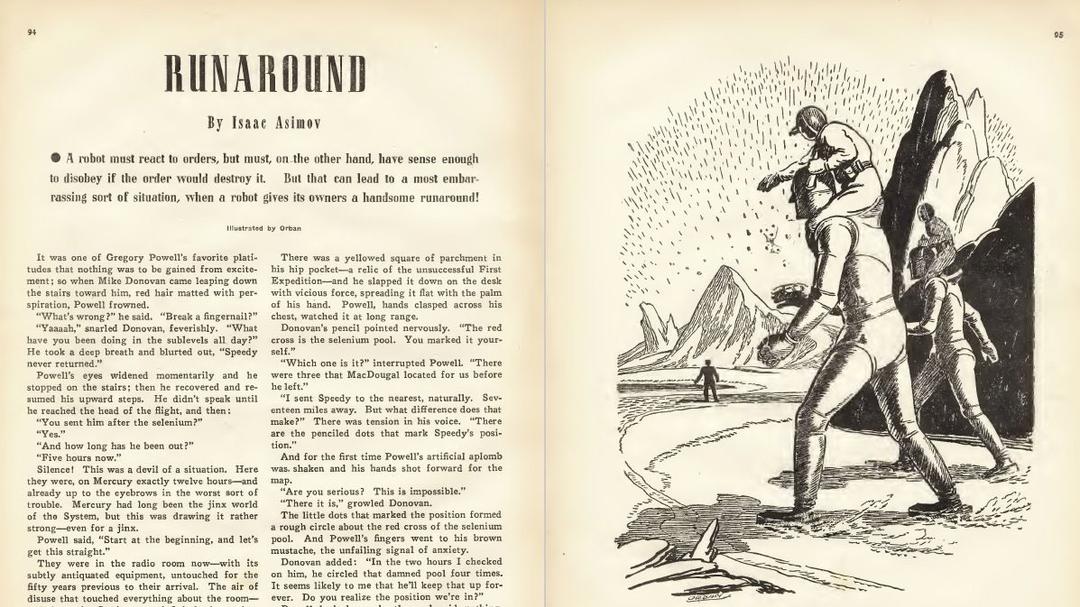 Les trois lois de la robotique apparaissent pour la première fois en mars 1942 dans la nouvelle « Runaround » parue dans la revue Astounding Science Fiction. (C) Analog Science Fiction and Fact.
Dans un autre exemple, Asimov place son robot dans une situation où celui ci doit sacrifier un humain pour sauver un grand nombre d'entre eux. Là encore, les trois lois trouvent leurs limites. Une nouvelle loi est alors ajoutée, plus forte que les précédentes, qui tente de placer la sécurité de l'humanité avant celle d'un individu.
Le problème de l’alignement est une tâche sans fin.
Dans ses romans, Asimov en vient donc à la conclusion qu'il est nécessaire d'ajouter de nouvelles règles pour tenter de gérer les cas compliqués. C'est exactement ce que font les développeurs des LLMs : limiter les risques en tentant de gérer les cas potentiellement dangereux. Malheureusement, le théorème de Gödel, comme celui de Rice, que nous avons déjà évoqués, montrent que c'est une tâche sans fin.
Faut-il renoncer aux IA à cause des dangers potentiels ?
La réponse est évidement non, mais « prudence est mère de sûreté », dit un ancien dicton. Par conséquent, il ne faut pas prendre à la légère les dangers potentiels et poursuivre sans relâche les travaux sur l'alignement, et surtout empêcher toute intrusion sur les systèmes sensibles et infrastructures critiques. En effet, le plus grand danger ne vient pas des IA elles-mêmes, mais plutôt des humains qui peuvent les utiliser pour des applications malveillantes.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.