Как ML‑модели ломаются в продакшене и что с этим делать
Меня зовут Андрей Бирюков. Я — независимый эксперт в области ИТ и ИБ, преподаю в учебных центрах и пишу статьи и книги.
Существует фундаментальное заблуждение, которое преследует индустрию машинного обучения с самого её зарождения, заключающееся в том, что успех ML‑проекта определяется только качеством модели.
Но на практике всё не так просто, потому что подавляющее большинство моделей, показавших блестящие результаты в Jupyter Notebook, либо никогда не доходят до пользователя, либо деградируют в течение нескольких недель после запуска.
И причина здесь кроется не в алгоритмах, а в инженерии, а точнее — в том разрыве, который есть между исследовательским прототипом и работающим продуктом.
Почему ноутбук и продакшен это два разных мира
В Jupyter Notebook, который, как правило, используют для обучения и разработки, данные статичны, чисты и уже загружены в память. Вы контролируете окружение, версии библиотек и порядок выполнения ячеек, и модель обучается один раз, при этом вы измеряете её accuracy на отложенной выборке.
Получается такой идеальный, стерильный мир, в котором все компоненты хорошо подогнаны друг под друга.
Но в продуктивной среде всё совсем иначе. Здесь данные приходят потоком, их схема меняется безо всякого предупреждения, а входные признаки могут содержать пропуски там, где вы их не ожидали.
И «немножко потормозить» не получится, так как модель должна выдавать предсказания за миллисекунды, а не за минуты.
Вот небольшой пример того, как бывает на самом деле.
Команда дата‑сайентистов обучила модель прогнозирования оттока клиентов телеком‑оператора.
В ноутбуке ROC‑AUC (метрика, которая показывает, насколько хорошо модель способна ранжировать положительные примеры выше отрицательных, независимо от выбранного порога классификации) составила 0.92 — отличный результат.
Естественно, после этого модель выкатили в продактив.
Однако через две недели бизнес заметил, что кампания по удержанию клиентов, запущенная на основе предсказаний, работает хуже, чем случайный обзвон.
Оказалось, что при обучении использовался признак «количество дней с последнего обращения в поддержку», который в исторических данных был финальным значением.
В продуктиве же модель запрашивала этот признак в момент предсказания, и для клиентов, которые ещё не звонили, значение было пустым. Модель заполняла пропуск нулём, интерпретируя это как «звонил только что», что давало прямо противоположный смысл.
Исправление потребовало пересборки пайплайна признаков и переобучения всей модели.
Data Drift и Concept Drift
Теперь давайте познакомимся с двумя врагами, которые у нас появятся, когда мы запустим модель в продуктиве.
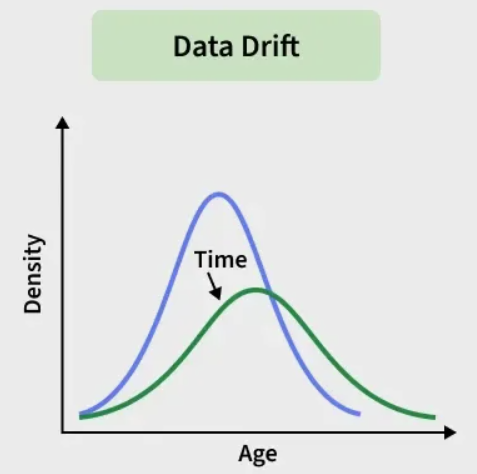
Первый оппонент — Data Drift, или сдвиг данных, когда распределение входных признаков меняется, но связь между признаками и целевой переменной остаётся прежней.
И второй враг — Concept Drift, или сдвиг понятия. Здесь меняется сама зависимость между признаками и целевой переменной.
Разберёмся с ними на примерах и начнём с Data Drift.
Пример Data Drift
Модель кредитного скоринга банка была обучена на данных клиентов из Москвы и Санкт‑Петербурга. Через полгода банк запустил региональную экспансию, и в потоке появились заявки из малых городов.
Распределение признака «средний доход» сместилось влево, а «возраст», наоборот, вправо. Модель продолжала работать, но её предсказания стали менее уверенными, и доля отказов выросла.
Детекция через тест Колмогорова — Смирнова показала, что p‑value для признака «доход» упал ниже 0.01.
Решением здесь стало переобучение с добавлением региональных данных и введение признака «тип населённого пункта».
Пример Concept Drift
А вот уже другой случай с Concept Drift.
Сеть продуктовых магазинов использовала модель прогнозирования спроса на основе истории продаж, дня недели, погоды и промоакций.
Модель стабильно показывала MAPE около 8%, но в марте 2020 года началась пандемия.
Признаки остались теми же, но поведение покупателей изменилось, так как люди перестали ходить в магазины каждый день и начали закупаться раз в неделю большими объёмами.
Соответственно, MAPE выросла до 35% за неделю, и никакой статистический тест на входных признаках этого не поймал бы, так как сдвинулось само понятие «спрос».
Здесь наилучшим решением стало всё то же экстренное переобучение на свежих данных и добавление признака «локдаун в регионе».
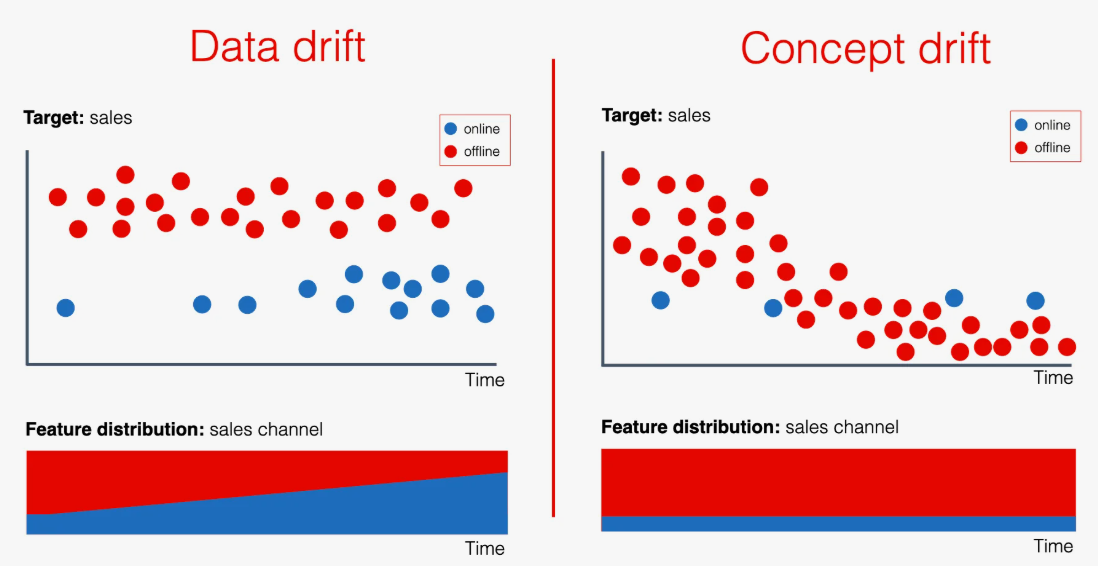
Как можно увидеть из этих примеров, сдвиг данных и изменение понятия могут привести к тому, что модель начнёт работать хуже, и для исправления потребуется не только переобучение, но и изменение структуры входных данных.
CI/CD для машинного обучения
В классической разработке ПО непрерывная интеграция и доставка означают, что код автоматически тестируется и (в идеальном мире) разворачивается при каждом коммите.
В ML этого недостаточно, потому что артефактов становится больше, так как у нас есть не только код, но и данные, модель и конфигурация окружения.
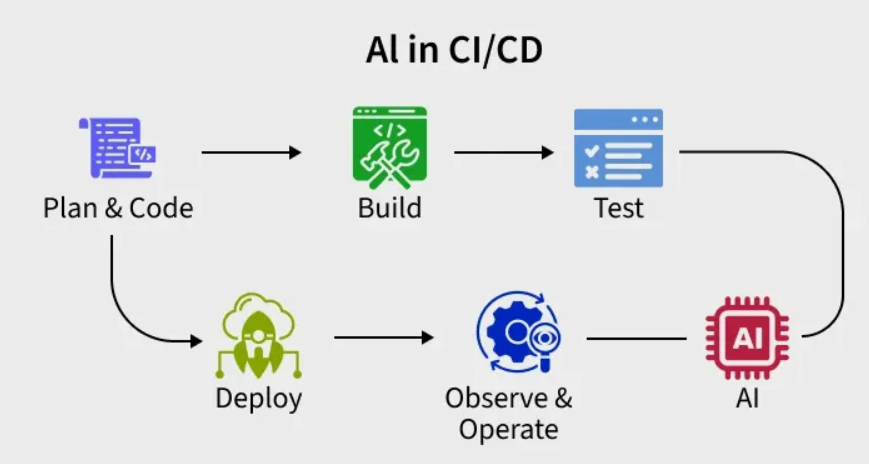
Например, в MLflow одной компании было настроено автоматическое сравнение новой версии модели с используемой в продуктивной среде по метрике F1 на отложенной выборке.
Если новая версия показывала F1 ниже на 2% и более, деплой блокировался.
Однажды инженер случайно обучил модель на данных без учёта сезонности, и в результате F1 упал с 0.81 до 0.74.
CI/CD заблокировал продвижение по конвейеру, и проблема была обнаружена до того, как попала к пользователям.
Поэтому важно, чтобы компоненты CI/CD контролировали процесс обработки данных ML для предотвращения получения некорректных результатов.
Централизованное управление признаками
Одна из самых коварных проблем в машинном обучении — это утечка данных, или Data Leakage.
Она возникает, когда при обучении модель получает доступ к информации, которая не будет доступна в момент предсказания.
Для того чтобы избежать подобных проблем, можно воспользоваться инструментами для централизованного хранения признаков, такими как Feature Store.
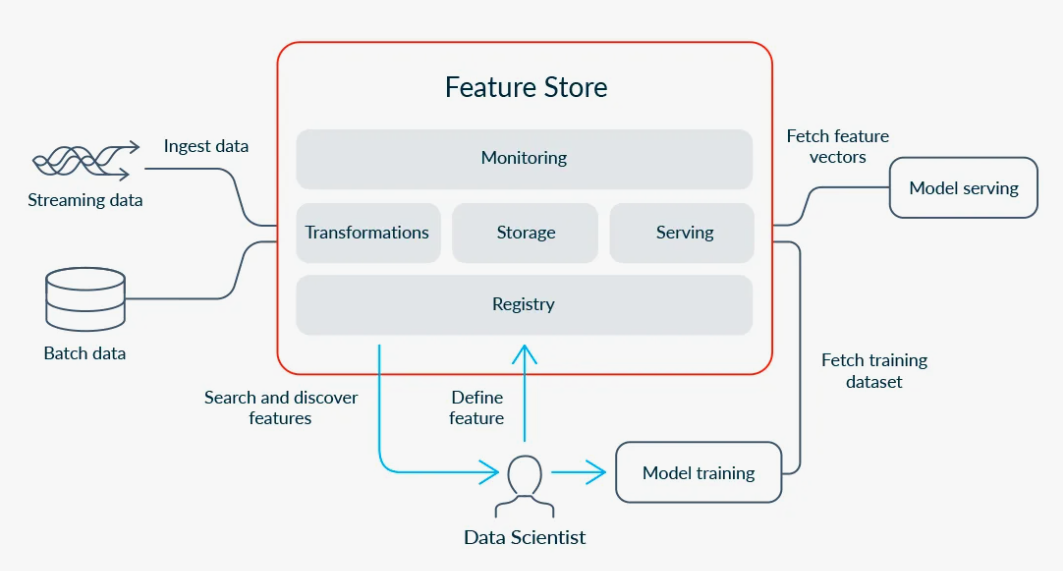
Например, компания использовала модель для выдачи рекомендаций на основе категорий:
«средний чек за 30 дней»;
«количество покупок за 7 дней»;
«любимый тип товаров».
Все необходимые данные вычислялись в offline‑хранилище (BigQuery) для обучения и в online‑хранилище (Redis) для инференса.
Feast гарантировал, что оба значения совпадают, но когда команда маркетинга попросила добавить признак «отклик на последнюю рассылку», он был добавлен один раз в Feature Store и сразу стал доступен и для обучения, и для инференса, и для аналитики.
В этом примере Feature Store не устраняет проблему утечки данных автоматически, но он создаёт структурные предпосылки для того, чтобы она была обнаружена и предотвращена.
Более того, правильное использование Feature Store заставляет инженера явно задуматься о временных аспектах признаков, что само по себе снижает риск утечки.
Дублирование кода и его последствия
Когда две команды пишут код для одного и того же признака независимо, возникает не только дублирование, но и дивергенция.
Код неизбежно расходится со временем, потому что команды решают разные задачи и вносят изменения, не зная о правках друг друга.
Например, команда Fraud detection обнаружила, что при расчёте признака нужно исключать транзакции с флагом «тестовая». Они добавили соответствующее правило в свой код.
Команда кредитного скоринга о такой необходимости не знала и продолжала учитывать тестовые транзакции.
В результате для клиентов, у которых в системе есть тестовые операции, значения признака стали различаться. То есть модели принимают разные решения, и никто не понимал, почему.
Более того, каждая команда должна писать тесты, документацию, поддерживать код. А дублирование умножает стоимость поддержки на количество команд, использующих признак.
Feature Store позволяет решить эту проблему, превращая признак в единый артефакт с одной кодовой базой, общими тестами и документацией.
Изменение вносится один раз и автоматически становится доступно всем потребителям, благодаря чему дивергенция становится невозможной.
Невозможность аудита
Когда признак реализован в двух местах, возникает вопрос: какое из значений считать «правильным»?
Если fraud detection и кредитный скоринг дают разные результаты, кто в этом виноват?
Так как без единого источника истины ответить невозможно, нам приходится поднимать код обеих команд, сравнивать логику и искать расхождения, тратя уйму времени.
При наличии Feature Store у нас есть единая точка истины, позволяющая посмотреть определение признака, его версию и историю изменений.
И если значение кажется неправильным, есть одно место для проверки. В результате аудит становится тривиальным.
Скрытая связь через признаки
Здесь есть тонкий аспект, который часто упускают.
Fraud detection и кредитный скоринг представляют собой разные модели с различными целями. Но если они используют один и тот же признак, между ними возникает неявная связь.
Так, если команда fraud detection изменит логику расчёта признака, это повлияет на кредитный скоринг, даже если команда кредитного скоринга об этом не знает.
Без Feature Store такое изменение происходит «молча», то есть каждая команда правит свой код, и никто не отслеживает кросс‑командные эффекты.
С Feature Store изменение признака становится явным событием с версионированием, и все потребители могут быть уведомлены и протестированы.
Невозможность переиспользования для новых моделей
Наконец, самый прагматичный довод в пользу Feature Store из всего перечисленного.
Когда признак вынесен в Feature Store, новая команда, которая хочет построить, скажем, модель прогнозирования оттока, может просто взять существующий признак и использовать его.
Не нужно писать код, не нужно разбираться в деталях, не нужно ждать, пока кто‑то реализует вычисление.
Признак доступен через API, документация прилагается, тесты уже написаны.
Это существенно сокращает цикл разработки новой модели с недель до дней.
Важно понимать, что переиспользование признака через Feature Store применяется не только для удобства, но и для корректности.
Когда признак реализован один раз, он описан с чётким определением временного окна и с поддержкой point‑in‑time correctness.
Все команды, использующие его, автоматически получают корректное поведение:
При обучении — это исторические значения на момент предсказания.
При инференсе — текущие.
Если бы каждая команда реализовывала признак сама, каждая могла бы допустить свою ошибку с временными метками, и утечки возникали бы независимо в разных моделях.
При этом Feature Store не устраняет утечку автоматически, но он делает правильную реализацию признака переиспользуемой.
Одна команда потратила время на корректную реализацию с point‑in‑time join — все остальные получают её бесплатно.
Это радикально снижает вероятность того, что где‑то в компании появится модель, обученная на утекающих признаках.
Заключение
ML System Design — это не история про то, как построить лучшую модель. Вместо этого мы говорим о том, как построить систему, остающуюся полезной во времени.
Ключевыми элементами здесь являются:
понимание и детекция сдвигов данных;
автоматизация пайплайнов от обучения до деплоя;
централизованное управление признаками;
всесторонний мониторинг.
Инженер, который владеет этими практиками, стоит на порядок дороже того, кто умеет только обучать модели.
Именно поэтому эта тема заслуживает отдельного глубокого гайда, основные идеи которого мы рассмотрели в этой статье.
Даже после успешного деплоя ML‑модель может начать терять точность из‑за изменений во входных данных. Как вовремя обнаружить такие изменения и предотвратить деградацию модели, разберём на бесплатном уроке 26 октября в 20:00 — «Data Drift в машинном обучении: почему модели деградируют в продакшене и как это контролировать». Записаться на урок.
Больше практических вебинаров по ML, разработке и другим IT‑направлениям собраны в дайджесте октября.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.