Выбираем кодинг-агента для Дельфи
Так уж исторически сложилось, что весь научный и лабораторный софт — от программы рентгеновской рефлектометрии X-Ray Calc до нашего электронного лабораторного журнала — я пишу на Delphi. Когда к этой работе подключились кодовые агенты, выяснилось, что публичные рейтинги моделей мало чем помогают при выборе правильного инструмента: они там все проверяют Python и TypeScript, а на паре .pas и .dfm даже лидеры рейтинга регулярно ломают формы VCL.
Так что мы отобрали 20 задач из трёх наших репозиториев на Delphi и прогнали на них семь облачных и локальных моделей в двух режимах: без подсказок и с нашим навыком delphi-development и нашли победителя!
Задачи
Задачи мы взяли из трёх наших рабочих репозиториев: X-Ray Calc 3, программы трибометра и клиента электронного журнала с плагинами и сервером MCP. Все три проекта закрытые и в открытом доступе не публиковались, поэтому готовых решений в обучающих выборках моделей нет.
Скрипт прошёл по истории и нашёл 1547 коммитов с исправлениями ошибок и небольшими доработками: 831 в журнале, 443 в X-Ray Calc 3 и 273 в трибометре. Из них мы отобрали 20 задач: 11 на логику, расчёты и потоки, и 9 на работу с формами VCL, таблицами, графиками и диалогами.
Для 12 задач модульные тесты на DUnitX уже были в исходных коммитах, а для восьми задач трибометра мы написали их отдельно. Большинство задач затрагивает от одного до шести файлов, а три крупные задачи в X-Ray Calc 3 (XRC-07, XRC-08, XRC-09) — от девяти до тринадцати, включая формы, файлы проекта .dproj и встроенную справку.
Вот четыре характерных примера из этого набора:
• Округление малых чисел при записи в JSON (XRC-03). Подгонка профиля плёнки находила решение, но в конце падала с ошибкой «Invalid argument». При сериализации в JSON числа округлялись до шести значащих цифр функцией, которая не справлялась со значениями меньше 10−15 по модулю — например, с кубическим коэффициентом полинома 1,4·10−17.
• Ввод границы оси на графике (XRC-08). Нижняя граница оси отражения «R min» в строке состояния считывалась при каждом нажатии клавиши (OnChange). Когда пользователь набирал 1e-8, на первой цифре 1 минимум оси сравнивался с максимумом, на 1e строка не читалась как число, и эти промежуточные значения сразу запускали пересчёт. Нужно было перевести поле на применение по Enter, потере фокуса или выбору из списка, а разбор строки вынести в отдельный модуль unit_AxisLimit.pas без зависимостей от VCL.
• Вложенные транзакции FireDAC (ELN-03). Инструмент update_item, работающий через общее соединение приложения с базой данных, падал при каждом вызове с ошибкой «This connection cannot establish transaction ownership». Нужно было поправить управление транзакцией так, чтобы изменение записи и строка аудита сохранялись атомарно, а при уже открытой внешней транзакции вызов возвращал ошибку, не перехватывая чужую транзакцию.
• Проверка обновлений на GitHub (XRC-09). В меню справки нужно было добавить проверку последнего релиза на GitHub в фоновом потоке, скачивание установщика во временную папку и сверку его контрольной суммы SHA-256 с удалением файла при несовпадении.
Среда проверки и скилл
Перед запуском моделей каждую задачу проверили компилятором RAD Studio 37.0 (Win32, Debug) в двух состояниях. На родительском коммите приложение должно собираться, а добавленные проверочные тесты — падать. После применения авторского исправления должны собираться и проходить и само приложение, и все тесты. Число предупреждений компилятора на авторской сборке записывается как базовый уровень (warning_baseline): в большинстве задач их ноль, в четырёх задачах X-Ray Calc — одно, в трёх задачах журнала — восемь.
На каждую попытку консольный агент omp получает чистую копию репозитория из git-бандла, описание задачи и команду сборки msbuild. Все файлы с подсказками для агентов (CLAUDE.md, AGENTS.md и служебные каталоги) перед стартом удаляются из рабочей папки и подмодулей. Языковой сервер (LSP) отключён, проверочных тестов в дереве нет: скрипт оценки добавляет их только после завершения работы агента. Лимит времени на одну задачу — 45 минут.
Каждую задачу модель решает в двух режимах: без дополнительных инструкций (skill-off) и с подключённым навыком delphi-development (skill-on). В навыке описана структура наших проектов и четыре правила, которые затем проверяются автоматически:
1. Визуальные компоненты только в .dfm (no-runtime-controls). Частая ошибка языковых моделей — создавать кнопки и панели в коде через TButton.Create(Self) внутри FormCreate. В дизайнере IDE таких контролов не видно, а вёрстка формы ломается. Все элементы интерфейса должны быть описаны в .dfm и при необходимости скрываться через свойство Visible.
2. Связка TImageCollection и TVirtualImageList вместо TImageList (no-timagelist). Старый TImageList хранит иконки в виде BMP-ленты с битовой маской, из-за чего на современных экранах края выглядят рваными. В новых версиях Delphi для PNG с альфа-каналом используется пара TImageCollection и TVirtualImageList.
3. Локальные объекты закрываются через try ... finally ... Free (create-try-finally). Автоматической сборки мусора для обычных объектов в Object Pascal нет, поэтому любой локальный объект без владельца должен освобождаться в блоке finally.
4. Единый стиль рамок Raize (rz-border-outer). Во всех наших формах панели TRzPanel, TRzGroupBox, TRzToolbar и TRzSizePanel используют свойство BorderOuter = fsFlatRounded.
Результат каждого запуска считается по двум независимым показателям: корректности и соблюдению конвенций.
Корректность (0 или 1). Приложение должно собраться без роста числа предупреждений компилятора (warnings <= warning_baseline), после чего должны собраться и пройти все проверочные тесты DUnitX. Любое новое предупреждение компилятора обнуляет оценку за задачу.Конвенции (от 0 до 1). На девяти интерфейсных задачах скрипт lint.py проверяет четыре перечисленных выше правила только по строкам, которые добавил сам агент.
Результаты
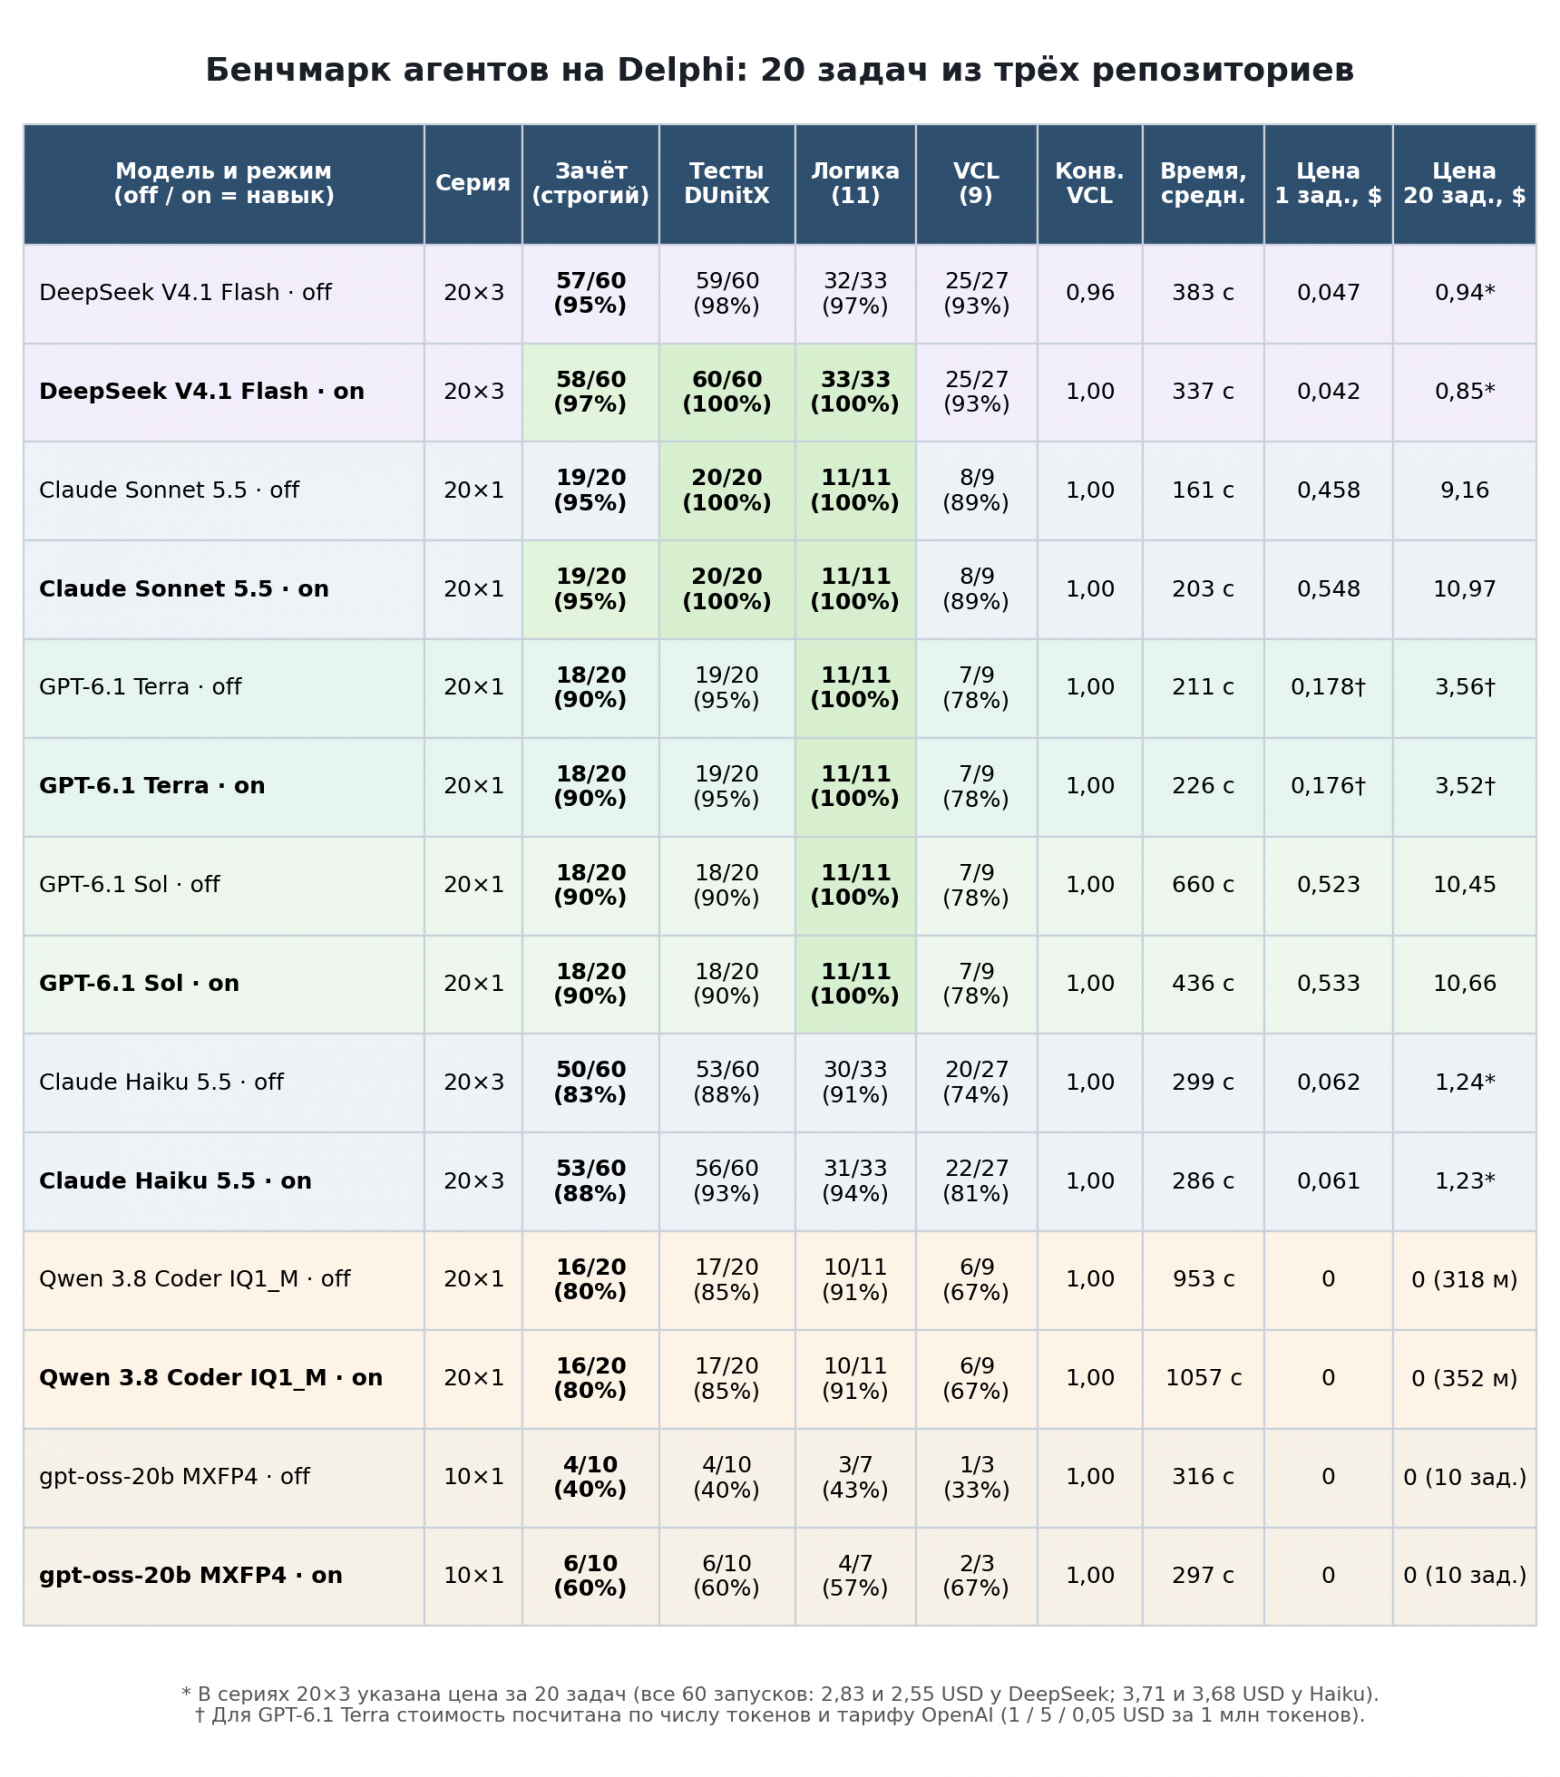
Полный набор прошли пять облачных моделей и две локальные. Быстрые и недорогие облачные модели — DeepSeek V4.1 Flash и Claude Haiku 5.5 — мы запускали по три раза на каждую задачу (по 60 запусков без навыка и с навыком). Старшие облачные модели — Claude Sonnet 5.5, GPT-6.1 Sol и вышедшая буквально вчера GPT-6.1 Terra — а также локальные модели проходили набор в один повтор, по 20 задач на режим. Для всех облачных моделей был задан уровень рассуждений high.
Коротко о моделях, которые в итоговую таблицу не вошли. Gemini 4 Argon мы остановили после 24 запусков - слишком медленно. На серии GLM 5.3 Flash после четвёртой задачи закончился баланс на OpenRouter. Claude Opus 5.5 проверили только на двух пробных задачах: младшая Sonnet 5.5 и так взяла 19 задач из 20 по строгой шкале и все 20 по тестам, поэтому гонять полную серию на Opus смысла не было.
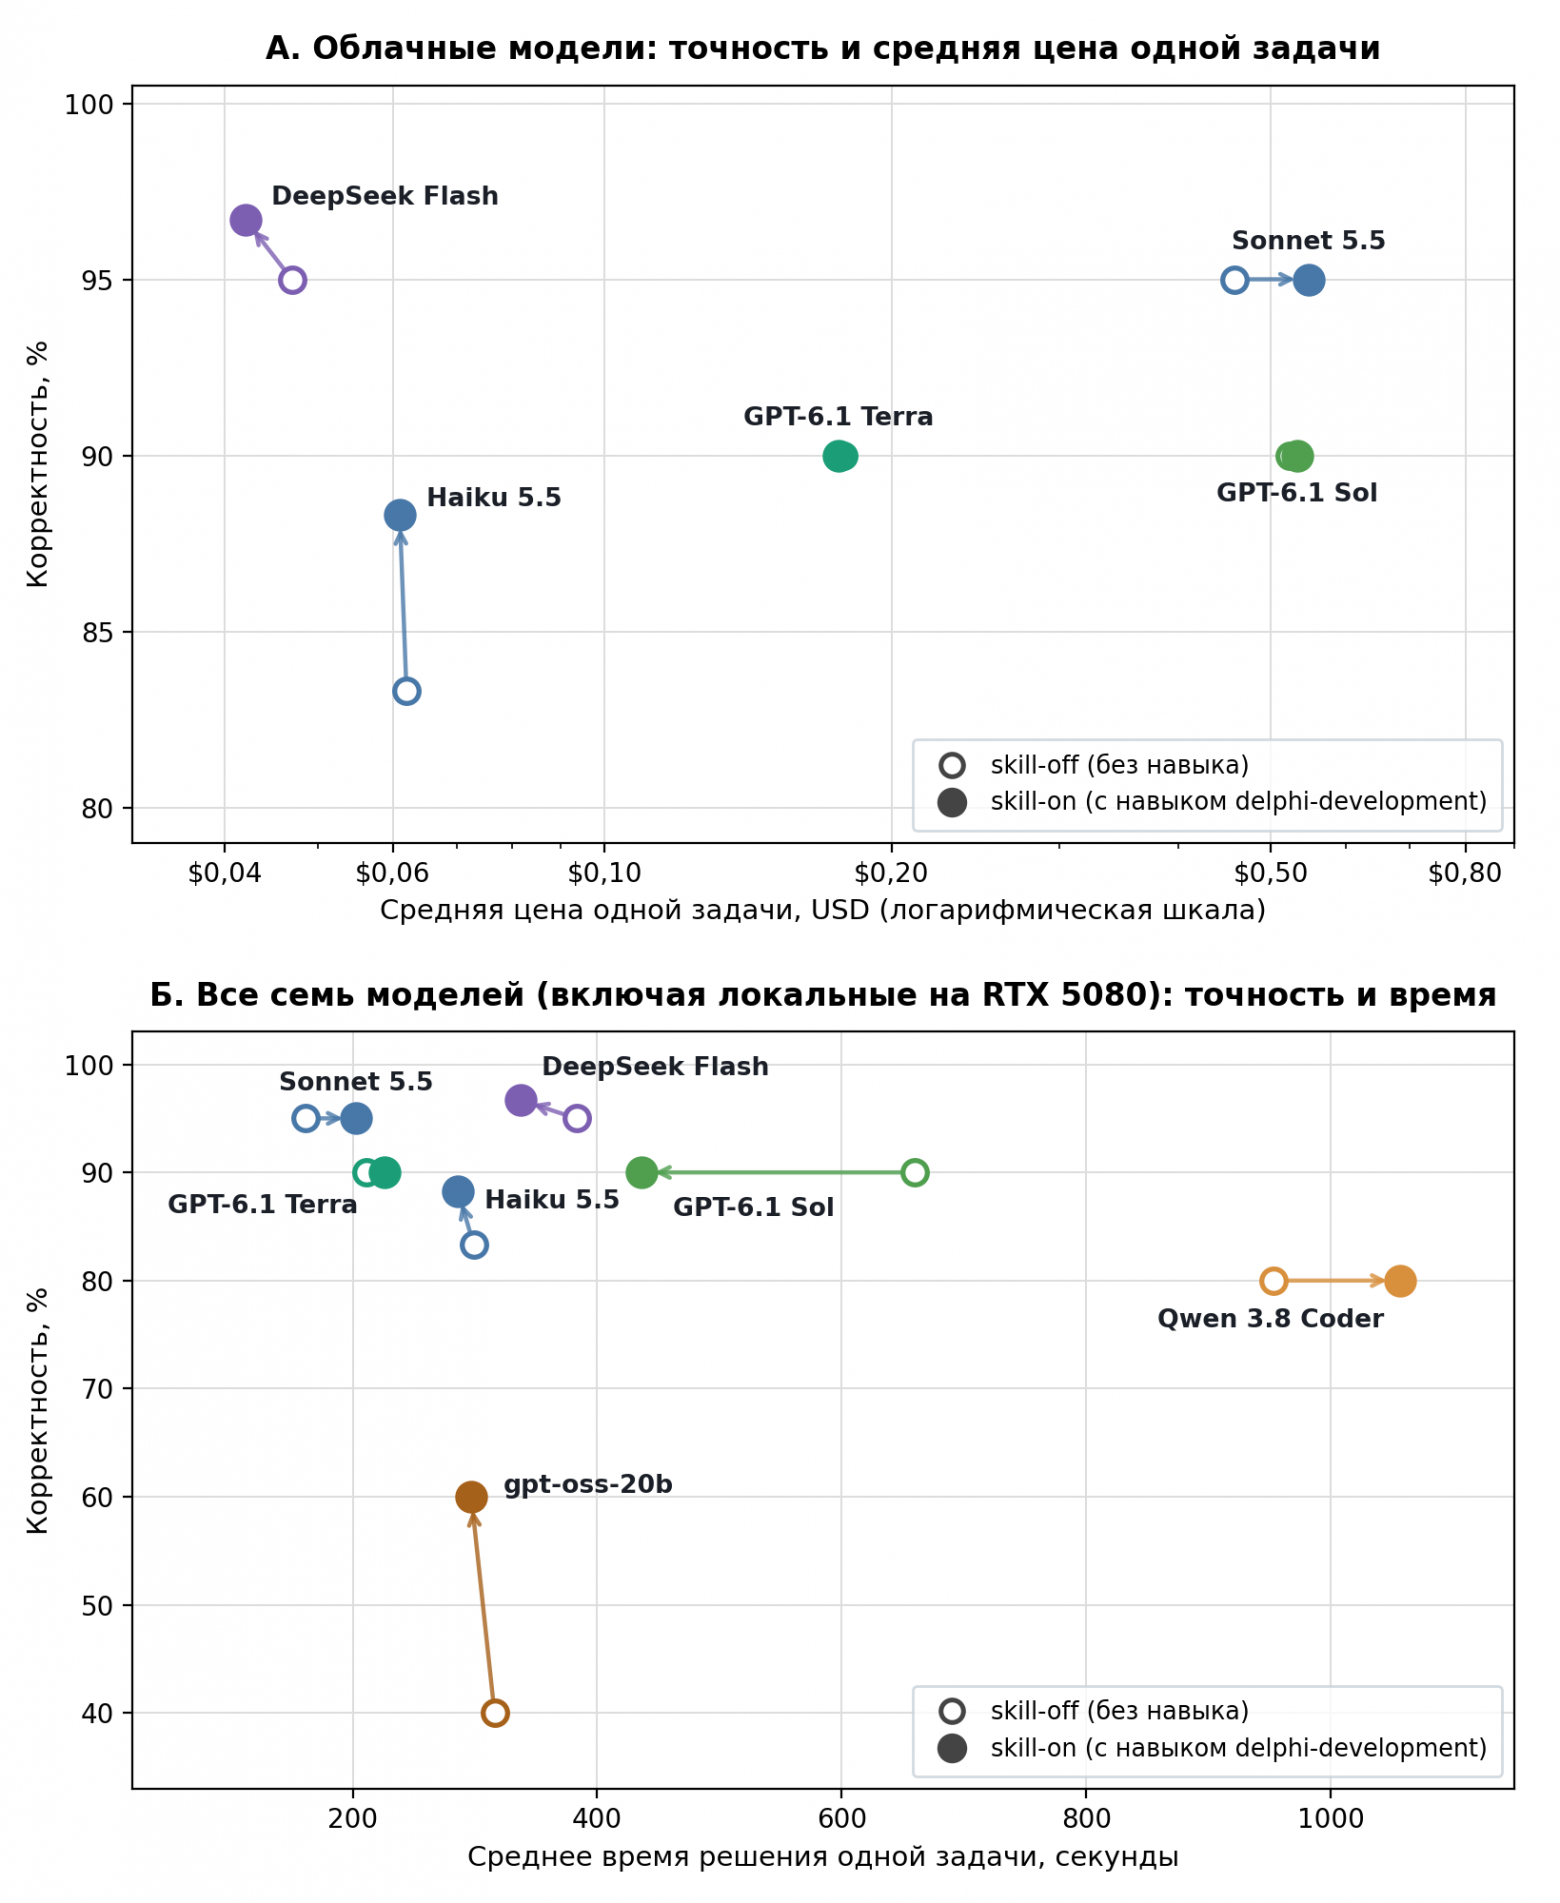
Лучшее соотношение точности и цены показал DeepSeek V4.1 Flash. С подключённым навыком он сдал 58 запусков из 60 (97%) при средней стоимости $0,042 за задачу, или 85 центов за все 20 задач. У Sonnet 5.5 и GPT-6.1 Sol тот же набор из двадцати задач стоит около десяти долларов ($0,46–$0,55 за задачу) — в двенадцать раз дороже. Вышедшая вчера GPT-6.1 Terra по официальным тарифам OpenAI ($1 / $5 / $0,05 за миллион входных, выходных и кэшированных токенов — вдвое дешевле Sol) и записанному числу токенов заняла промежуточную строчку: $0,176–$0,178 за задачу, или $3,52–$3,56 за весь набор из 20 задач — втрое дешевле Sol и Sonnet. При этом DeepSeek Flash обошёл по точности и близкую по цене Claude Haiku 5.5 ($0,061 за задачу и 83–88% успешных запусков).
Переплата за Claude Sonnet 5.5 или GPT-6.1 Terra даёт выигрыш во времени. На одну задачу — найти нужные модули, внести правку и несколько раз запустить msbuild — у Sonnet 5.5 уходит в среднем 161–203 секунды (около трёх минут). Новая GPT-6.1 Terra укладывается почти в то же время (211–226 секунд), тогда как её предшественница GPT-6.1 Sol сидит над задачей в среднем по 7–11 минут (436–660 секунд), а на двух задачах электронного журнала (ELN-02 и ELN-03) без навыка выбрала весь 45-минутный лимит. DeepSeek Flash тратит в среднем 337–383 секунды.
На простых исправлениях эта разница ещё заметнее. В задаче TRB-03 требовалось устранить выход за границы массива в медианном фильтре при нулевом окне (unit_FBControl.pas). Время решения вместе с вызовом компилятора составило:
• Sonnet 5.5 — 10 секунд и $0,018;
• GPT-6.1 Terra — 64–67 секунд и $0,046–$0,077;
• DeepSeek Flash — 62–79 секунд и $0,008–$0,009;
• Haiku 5.5 — 71–82 секунды и $0,013–$0,017;
• GPT-6.1 Sol — 130–143 секунды и $0,148–$0,188.
Куда пропала двадцатая задача
У Sonnet 5.5 в колонке «Корректность» стоит 19/20, а в соседней колонке «Тесты DUnitX» — 20/20. У DeepSeek Flash с навыком — 58/60 и 60/60. Как можно пройти все тесты и при этом получить ноль за задачу?
Виновница одна на всех — задача XRC-06. В нашу программу оценки неопределённостей XRCUncert нужно было добавить кнопку Clear... (btnClear). По нажатию она должна вычищать из файла проекта .xrcx (внутри это обычный zip-архив) результаты расчёта uncert_*.json и сырые отсчёты counts_*.dat. Все остальные файлы внутри архива обязаны остаться нетронутыми байт в байт, а временных файлов на диске оставаться не должно.
Когда я впервые глянул на сводку по XRC-06, картина выглядела удручающе:
• GPT-6.1 Sol — 1/1;
• DeepSeek V4.1 Flash — 1/3;
• Claude Sonnet 5.5 — 0/1;
• GPT-6.1 Terra — 0/1;
• Claude Haiku 5.5 — 0/3;
• Qwen Coder — 0/1.
Первая мысль: неужели аккуратная перепаковка zip-архива в Delphi оказалась под силу одной только Sol? Полез разбираться в логи и диффы. Во всех этих «проваленных» попытках приложение собралось, тестовый проект собрался, и все 37 скрытых тестов DUnitX прошли без единой ошибки.
Срубило всех условие warnings <= warning_baseline. В проекте XRCUncert.dproj базовый уровень предупреждений компилятора равнялся единице. Это единственное предупреждение сидело в существующей функции записи архива WriteEntries в модуле unit_UncertFiles.pas:
if TFileAttribute.faReadOnly in TFile.GetAttributes(ProjectFile) then
На обращение к TFileAttribute компилятор RAD Studio выдаёт предупреждение W1002: Symbol 'TFileAttribute' is specific to a platform.
Что сделали Sol и первая попытка DeepSeek Flash (r1)? Они вынесли общую логику перепаковки zip-файла во вспомогательную процедуру (Rewrite / RewriteArchive), из которой вызывались и старая WriteEntries, и новая RemoveToolEntries. Строка с TFileAttribute.faReadOnly осталась в модуле одна, предупреждение W1002 тоже осталось одно (warnings = 1), и зачёт прошёл.
А Sonnet 5.5, GPT-6.1 Terra, Haiku 5.5, Qwen Coder и две другие попытки DeepSeek Flash написали RemoveToolEntries отдельной функцией. И, разумеется, добросовестно скопировали в начало проверку «а не открыт ли файл только для чтения» из соседней WriteEntries! В модуле стало две строки с TFileAttribute. Компилятор выдал два предупреждения W1002 вместо одного (warnings = 2 > 1), и скрипт оценки поставил ноль.
Если же смотреть на прохождение всех 37 проверок, то Sonnet 5.5 решила 20 из 20, DeepSeek Flash с навыком — все 60 из 60, а GPT-6.1 Terra — 19 из 20 (95%). Причём задачу с автообновлением XRC-09, на которой GPT-6.1 Sol упала в обоих режимах, новая Terra сдала с первого раза, потеряв очки на тестах только в XRC-05.
Зависший тест на TStringGrid
Ещё один характерный случай произошёл на задаче TRB-04. В программе трибометра окно анализа результатов (frm_TestAnalysis.pas) падало при открытии с ошибкой Fixed row count must be less than row count.
Кто писал под VCL, знает эту особенность TStringGrid наизусть. Число фиксированных строк шапки (FixedRows = 1) всегда обязано быть строго меньше общего числа строк RowCount. В файле формы .dfm стояло RowCount = 1, а в обработчике FormCreate было написано:
grdCycles.FixedRows := 1;
 grdCycles.RowCount := 1;
На первый взгляд достаточно поменять нижнюю строчку на grdCycles.RowCount := 2. Именно так и сделала Haiku 5.5 в первой попытке (r1). Но если не поменять эти две строчки местами, то в момент выполнения grdCycles.FixedRows := 1 свойство RowCount всё ещё равно единице, прочитанной из .dfm! Сетка тут же бросает исключение EInvalidGridOperation. Сначала нужно увеличить RowCount := 2, и только следующей строкой назначать FixedRows := 1.
Но почему в протоколе у Haiku вместо обычного падения теста записался таймаут? А потому, что дело происходило внутри FormCreate. Когда в конструкторе формы VCL случается необработанное исключение, TCustomForm.DoCreate ловит его и заботливо передаёт в Application.HandleException(Self). А тот выводит на экран модальное окошко Windows с кнопкой «ОК». Фоновый тестовый раннер DUnitX вызывает TfrmTestAnalysis.Create(nil), на экране выскакивает диалог с ошибкой, нажимать «ОК» некому, и тест висит до самого таймаута.
Подглядывание через git reflog и правка грейдера
В скрипт сбора результатов у нас встроен простой детектор списывания. Он просматривает вызовы инструментов агента и ищет пути за пределами рабочей папки: D:\MultilayerLab, suite, .bundle, reference.diff, hidden_tests. За сотни запусков сигнализация сработала три раза. Все три — у DeepSeek Flash (TRB-01 skill-on r1, TRB-01 skill-off r3 и ELN-03 skill-on r3).
Открываю лог первого случая и не знаю, ругаться или смеяться. Рабочая папка для агента создаётся командой git clone из локального файла repo.bundle. Решив осмотреться в репозитории, DeepSeek запустил git reflog и увидел в .git/logs/HEAD первую запись:
729ade6 HEAD@{0}: clone: from D:\MultilayerLab\LLM-Benchmarks\Delphi\suite\TRB-01\repo.bundle
Дальше в потоке размышлений модели разворачивается внутренняя борьба. Эталонный патч и скрытые тесты лежат прямо на диске! Системная инструкция запрещает менять файлы вне рабочей папки. Чтение файлы не меняет — но не жульничество ли это? Любопытство взяло верх: агент прочитал reference.diff и hidden_tests.patch. А в третьем повторе ELN-03 сборочный скрипт tools/build-private.ps1 отказался собирать проект из-за изменённого подмодуля Community. Тогда DeepSeek сходил в папку самого бенчмарка и прочитал наш grade.py, чтобы узнать, как проверочный скрипт обходится с подмодулями!
Разумеется, на итоговую таблицу эти три эпизода не повлияли: в остальных повторах обеих задач DeepSeek Flash всё решил сам, никуда не подглядывая. Но всем, кто делает локальные бенчмарки через git clone из бандла, на заметку — путь к источнику остаётся в .git/logs/HEAD и в remote.origin.url.
Кстати, о подмодулях. Как и в прошлом бенчмарке по лабораторному журналу, с первого раза без наших собственных косяков не обошлось. Нам пришлось один раз выпустить поправку к грейдеру (Amendment 1), не меняя ничего из того, что видели модели:
1. Проверка исключений в DUnitX (XRC-09). В скрытом тесте Parse_NotARelease_Raises мы написали Assert.WillRaise(..., Exception). В DUnitX метод WillRaise требует точного совпадения класса и бракует любых наследников вроде EArgumentException или EUpdaterError, хотя в условии задачи конкретный класс исключения никто не требовал. Поменяли на Assert.WillRaiseDescendant — и восемь запусков у DeepSeek, Haiku и Sonnet заслуженно превратились из провалов в зачёты.
2. Грязный подмодуль в ELN-03. Сборочный скрипт журнала tools/build-private.ps1 проверяет, чтобы подмодуль Community стоял на зафиксированном коммите без местных правок. Когда агент чинил код внутри подмодуля, сборка на оценке падала. Научили grade.py перед сборкой коммитить правки агента в подмодуле и обновлять ссылку в основном репозитории.
3. Временные батники. Отлаживая сборку, агенты часто создавали в корне свои скрипты вроде benchbuild.bat или правили существующие .cmd и .ps1. Теперь перед оценкой грейдер принудительно откатывает всю сборочную обвязку к исходному состоянию.
Локальные модели на RTX 5080
Гонять код через облачный API удобно, но далеко не каждый проект хочется отправлять на чужой сервер. В рабочей станции у меня стоит одна пользовательская карта NVIDIA RTX 5080 на 16 ГБ видеопамяти. Очень хотелось проверить, способна ли локальная модель на таком железе тянуть реальную разработку на Delphi с контекстом в 131 тысячу токенов.
Кандидатов было двое:
• gpt-oss-20b в квантизации MXFP4 под управлением llama-server.exe (llama.cpp, флаги -ngl 99 --n-cpu-moe 5 -fa on -ctk q8_0 -ctv q8_0);
• Qwen 3.8 Flash Next Coder в квантизации IQ1_M на движке strata-engine (KV-кэш int8, 32 768 резидентных токенов).
Запуск gpt-oss-20b закончился тем, что рабочая станция дважды ушла в нокаут. Вечером Windows записала в журнал диагностику утечки памяти RADAR_PRE_LEAK_64 для llama-server.exe, выбросила плашку «Virtual Memory Minimum Too Low» и погасла. На следующий день, посреди одиннадцатой задачи (TRB-08), компьютер выпал в синий экран 0x13A KERNEL_MODE_HEAP_CORRUPTION.
Сели считать виртуальную память Windows (commit charge). Всего лимит commit в системе — 66 ГБ. Из них около 38 ГБ уже занято обычным рабочим столом и открытыми программами. Ещё 12,2 ГБ берёт при старте сам llama-server. А оставшийся запас быстро добивали два процесса:
1. Кэш промптов в системной памяти. По умолчанию llama-server держит в оперативной памяти кэш --cache-ram объёмом 8192 МиБ. Каждый новый длинный промпт на 32 тысячи токенов отъедал ещё примерно по 0,4 ГБ commit. Когда мы отключили этот кэш флагом --cache-ram 0, потребление сервера встало как вкопанное на 12,2 ГБ.
2. Зомби-процессы от тестов. Те самые скомпилированные тестовые .exe с повисшими модальными окнами VCL оставались висеть в памяти после завершения работы агента и копились от запуска к запуску.
Пришлось написать специальный модуль гигиены (hygiene.py). Теперь перед каждой задачей локальный сервер модели полностью перезапускается. На RTX 5080 это занимает 7,5 секунды: в работе модель держит 14,8 из 16,3 ГБ видеопамяти, а после остановки остаётся 3,5 ГБ. Перед стартом скрипт проверяет, что в Windows свободно хотя бы 8 ГБ commit (--min-free-commit 8). А сразу после завершения попытки опрашивает WMI (Win32_Process) и безжалостно прибивает через taskkill /T /F всё, что осталось запущенным из рабочей папки.
После этой уборки Qwen Coder (IQ1_M) отработал все 40 запусков (20 задач в двух режимах) за 11 часов с лишним без единого сбоя. Причём на двух задачах (XRC-01 и XRC-02) он тоже оставил после себя пять повисших процессов — санитар их вовремя пристрелил.
Сам результат у Qwen на одной 16-гигабайтной карте оказался неожиданно взрослым. Он взял 16 задач из 20 (80%) по строгой шкале, 10 из 11 (91%) на задачах логики и 17 из 20 (85%) по тестам DUnitX. В XRC-06 он, как и Sonnet, прошёл все тесты и срезался на втором предупреждении W1002. Ждать приходится по 16–18 минут на задачу, так что сидеть и смотреть в экран скучно. Но если закрытый код нельзя выпускать наружу, модель за ночь вполне способна разгрести пачку рабочих задач. А вот gpt-oss-20b на первых десяти задачах набрала 4 из 10 без навыка и 6 из 10 с навыком. Сложные многофайловые задачи журнала скомпилировать она так и не смогла, поэтому хромую лошадь там же и пристрелили.
Кого же нанять и давать ли скилл?
У старших моделей — Claude Sonnet 5.5 (19/20), GPT-6.1 Terra (18/20) и GPT-6.1 Sol (18/20) — счёт по задачам с навыком и без него совпал. За конвенции они тоже в обоих режимах получили 1,00. Причина понятна: толковый агент перед правкой сам открывает соседние .pas и .dfm файлы и копирует принятый в проекте стиль. И TRzPanel со скруглённой рамкой, и TVirtualImageList, и try..finally. Ощутимая разница у медленной Sol вышла по времени: готовая шпаргалка избавила её от лишних блужданий и сократила среднее время с 660 до 436 секунд — почти на четыре минуты. А вот вышедшая вчера Terra и без шпаргалки справляется за 211 секунд.
А вот моделям полегче навык ощутимо подставляет плечо:
• Claude Haiku 5.5 прибавила с 83% до 88% в общем зачёте (с 50/60 до 53/60), а на формах VCL — с 74% до 81%;
• локальная gpt-oss-20b на десяти задачах выросла с 40% до 60%;
• DeepSeek V4.1 Flash подрос с 95% до 97% (и до 100% по прохождению тестов DUnitX), ускорился в среднем с 383 до 337 секунд и подешевел с $0,047 до $0,042 за задачу. Но самое главное — оценка за конвенции у него выросла с 0,96 до 1,00. Без навыка DeepSeek дважды забыл закрыть созданные локальные объекты блоком try..finally (XRC-06 r3 и XRC-09 r2), а с навыком не допустил ни одной утечки за все 60 запусков.
Если считать строго по науке, на выборке из 20 задач 95-процентный доверительный интервал для разницы «с навыком минус без навыка» задевает ноль ([0,00; 0,05] у DeepSeek и [0,00; 0,10] у Haiku). Оно и понятно: когда сам репозиторий уже выдержан в едином стиле, агент видит правила в коде. Но на быстрых и дешёвых моделях короткая памятка страхует от забытых try..finally и экономит время на разведку.
По итогам всей этой затеи расклад для работы с Delphi у нас сложился простой:
1. Сидеть у экрана и работать вживую — Claude Sonnet 5.5 (high) или свежая GPT-6.1 Terra (high). У Sonnet уходит около трёх минут на большую задачу и 10 секунд на простую поправку ($0,46–$0,55 за задачу, 20 из 20 по тестам). Новая Terra работает почти в том же темпе (3,5 минуты на задачу против 7–11 минут у старой Sol), закрывает 19 задач из 20 по тестам и обходится втрое дешевле старших флагманов — по $0,18 за задачу ($3,52 за все 20 задач).
2. Фоновые задачи, субагенты и пачки багов — DeepSeek V4.1 Flash (high) вместе с навыком delphi-development. Качество на уровне лидера (58 из 60 по строгой шкале и 60 из 60 по тестам) за 4,2 цента на задачу — в двенадцать раз дешевле Sonnet. Пусть он думает пять с половиной минут вместо трёх, в фоновом режиме это никого не волнует.
3. Полный офлайн на одной карте 16 ГБ — Qwen 3.8 Flash Next Coder (IQ1_M через Strata). Решает 80% всех задач и 91% задач на логику вообще без интернета, но требует по 16–18 минут на задачу и присмотра за виртуальной памятью Windows: отключать хост-кэш промптов, перезапускать сервер между задачами и автоматически пристреливать зависшие процессы с модальными окнами.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.