Как мы делали «золотой датасет» для оценки агентов
Однажды мы решили сделать золотой датасет. Он был нам нужен для улучшения и масштабирования МВП, прошедшего пилот. Мы думали, что сделать его будет также просто как и МВП, и отправили первую версию в работу к нашим разметчикам.
Мы верили что это будет быстрое приключение на 15 минут туда и обратно (ведь мы хотели разметить всего 5000 диалогов), но никогда так не ошибались. Оказалось, что живые люди понимают ТЗ творчески, а я расскажу, с чем мы столкнулись, когда, наконец-то дождались своей разметки.
Первые шаги
Разметка данных — это процесс добавления меток к данным, впоследствии используемым для обучения моделей машинного обучения. Разметка необходима, чтобы модели могли различать классы объектов, выявлять закономерности и предсказывать результаты.
Разметка может сильно различаться в зависимости от типа размечаемых данных (текст/аудио/изображения/видео), постановки задачи и требуемого качества. К примеру, если мы хотим обучить нейронную сеть определять различных животных на фотографиях, то для этого мы возьмем много фотографий с коровами, зебрами, кошками и другими, просмотрим все эти снимки и присвоим каждому из них нужный класс — вид животного. А ещё лучше, если выделим небольшую область на снимке, где находится нужный нам объект и присвоим класс именно этой области, чтобы модели было проще понять, куда смотреть.
В нашем случае речь шла о RAG-системе. Мы работали над сервисом‑помощником для операторов чата‑поддержки. Идея максимально простая — модель получает на вход запрос пользователя, а именно последние несколько сообщений, которые дошли до оператора, обращается к начанкированным статьям из внутренней базы знаний (которую мы называем ABook) и найдя наиболее релевантные фрагменты текста — генерирует подсказку, которая должна помочь оператору. Именно так выглядел наш MVP.
Для чего же здесь нужна разметка? Сама модель может иметь плохое представление о том, что такое «релевантный» кусок текста и как его искать. Для этого нам нужно показать ей примеры хороших и плохих фрагментов. А также хочется иметь возможность не только показывать модели, что такое хорошо, а что такое плохо, чтобы она училась, но и самим проверять качество работы системы. Так, можно сформулировать задачу следующим образом: нам нужна разметка, которая входному запросу клиента сопоставит статью и фрагмент этой статьи из внутренней базы знаний. Именно с такой задачей предстояло справится разметчикам.
Но, чтобы они поняли, что мы от них хотим, нам было необходимо составить для них ТЗ — или же методологию разметки. Первая версия методологии выглядела так:
Методология 1
Цель: получить эталонные чанки для ответа на вопросы
Описание
Разметку проводим в разрезе 2х сегментов:
Актуальные статьи A-Book, по которым можно правильно ответить на вопрос
Конкретные фрагменты из статей выше, которых достаточно, чтобы правильно, полноценно, достоверно ответить на вопрос
Шаг 1. Определить статьи, в которых содержится ответ
Данная часть разметки необходима, чтобы понять, в каких статьях есть ответ на вопрос/вопросы клиента
Описание:
Внимательно изучаем вопрос/вопросы клиента и указываем статьи из abook, при помощи которых можно полноценно ответить на вопрос/вопросы клиента.
Если одна и та же информация дублируется в разных статьях, указываем самые актуальные/стабильные статьи
Шаг 2. Указать конкретные фрагменты из статей из предыдущего шага
Данная часть разметки необходима, чтобы понять, какие конкретно фрагменты статей нужно использовать для ответа
Описание:
!ВСЕ ФРАГМЕНТЫ ВМЕСТЕ ДОЛЖНЫ БЫТЬ МИНИМАЛЬНЫМИ, НО ДОСТАТОЧНЫМИ, ЧТОБЫ ПРАВИЛЬНО, ПОЛНОЦЕННО, ДОСТОВЕРНО ОТВЕТИТЬ НА ВОПРОС/ВОПРОСЫ КЛИЕНТА!
Указываем минимальные фрагменты (ctrl+c, ctrl+v) из статей выше, которых необходимо и достаточно, чтобы ответить на вопрос/вопросы клиента. если фрагментов несколько, разделяем их тремя символами @ ( @@@ ).
Шаг 3. Указать, хватит ли только информации из A-Book
Данная часть разметки необходима, чтобы понять, Достаточно ли информации в A-Book.
Описание:
Указать, нужна ли дополнительная информация, чтобы ответить на вопрос/вопросы клиента или информации из A-Book достаточно
Но не прошло и недели, как у нас набрался пакет проблем:
Разметчики, должны были определять статьи, в которых содержится ответ, и это они делали. Но, ссылаясь на верную статью, они ссылались на неверный фрагмент
Разметчики склеивали разные фрагменты текста, либо наоборот произвольно сокращали их.
В размеченных фрагментах встречались опечатки или прочие модификации.
Разделители отдельных кусков вставлялись посреди предложений.
Вместо указанных разделителей (@@@) использовалось что-то авторское.
В описание мы указали, что фрагменты должны быть минимальными, но деление на фрагменты было слишком мелким.
Вместо «отказа от ответа» разметчики вставляли: пробел (или несколько), звёздочку (*), прочерк (-) или “0”.
Вызывала вопросы и сама работа контрагентов: в одном случае разметчик постарался найти как можно больше статей релевантных запросу, потратив 243 секунды. В другом случае указал только одну ссылку, потратив 19 секунд. А самое главное, никаких ограничений разметчиком дано не было, каждый выполнял работу, как считает нужным.
Работа над ошибками
Мы были сильно недовольны качеством и согласованностью, но больше всего нам было больно оттого, что мы сами подложили себе свинью, не подумав о том, что при такой методологии все чанки получились разного размера и разного формата и теперь было совершенно непонятно, как считать метрики качества нашего ретривера, ведь чанки не пересекаются добуквенно, даже если информация найдена правильно.
Однако мы не стали унывать, — результаты анализа первой итерации разметки для ретрива дали понимание дальнейшего направления работ.
Стало ясно следующее: чем больше степеней свободы у разметчиков, тем вариативнее результаты разметки.
Необходимо сформировать как можно более точное и формализованное ТЗ, которое смогло бы ещё на моменте прочитывания исключить любые двусмысленные трактовки. Вот к чему мы пришли:
№1. Сформировать глоссарий
Взаимодействие с разметчиками (а иногда даже с коллегами по несчастью) очень быстро может превратиться в сломанный телефон. особенно если дело касается понятий, специфичных для конкретной корпоративной среды. Поэтому стоит сразу в процессе работы постараться зафиксировать основной набор терминов, которые используются наиболее часто.
Диалог, коммуникация, блок реплик, документ, статья, фрагмент — вокруг этих понятий выстраивалась вся работа, и не раз и не два мы сами путались в них. Поэтому стоит заранее подумать о том, на каком языке будет выстраиваться коммуникация внутри команды.
№2. Продумать формат используемых чанков
Если уж мы решили размечать не только статьи, но и конкретные полезные чанки, возникает вопрос — как обеспечить удобство и долговечность последующего использования результатов разметки. Здесь мы столкнулись с несколькими проблемами:
Фрагменты, которые разметчик найдёт, выделит и вставит из доступной ему UI базы знаний, могут отличаться от того, с чем работаем мы как дата сайентисты на своей стороне (чаще всего выгрузки в формате markdown).
Свобода в выборе источника информации приводит нас к тем же проблемам, что были описаны после апробации первой версии методологии (ошибки, опечатки и произвольный пересказ статей из базы знаний).
База знаний не статична, она обновляется и меняется, наполнение одних статей модифицируется, другие удаляются, третьи создаются.
Как в таких условиях настроить процесс разметки? Мы нашли рецепт успеха. Раз мы опираемся на то, с чем работаем мы как дата сайентисты, почему бы не дать разметчикам ровно тот источник данных, который есть у нас? Мы долго думали, как настроить достаточно удобную и надёжную коммуникацию с разметчиками в плане передаче нашей предобработанной выгрузки базы знаний.
И после нескольких попыток пришли к решению — «архив с текстовыми файлами»!
Да, возможно, решение довольно старомодное. Однако в условиях тех сред разработки и разметки, которые были нам доступны, мы не нашли ничего лучше. Прикладывать тысячи статей вместе с проектом разметки было бы не очень практично, это могло бы замедлить навигацию по проекту разметки, да и удобного способа для осуществления такой затеи не было. Формировать единый файл, например, эксель, со всей метадатой для каждой статьи тоже оказалось неудачной затеей: в экселе есть внутреннее ограничение на длины текстовых последовательностей.
Поэтому мы решили для каждой статьи сформировать свой текстовый файл с её Markdown наполнением, а сами текстовые файлы назвать по айдишнику статьи. Разметчики могут обращаться к UI базы знаний для поиска нужной статьи, но выделение фрагмента происходит только из файла.
Этот же подход вкупе с уточнением методологии и более строгим определением понятия «фрагмент» решает проблему с ошибками и опечатками в разметке.
Собственно, а что такое фрагмент? Вроде бы все понимают, какой должна быть выдержка из текста, отвечающая на вопрос и подходящая для ретрива, но как описать это в словах? Мы определили «хороший» фрагмент через 4 критерия:
Минимальность. Фрагмент должен быть минимальным по символам. Не нужно копировать лишнюю информацию.
Целостность. Фрагмент должен содержать законченные предложения.
Непрерывность. Фрагмент должен быть непрерывным выделением из статьи. Прерывающиеся фрагменты — разные фрагменты.
Оригинальность. Фрагмент должен быть точной копией из статьи. Не нужно ничего дописывать.
Эти 4 свойства + множество примеров того, как должны и не должны выглядеть фрагменты гарантируют минимальную вероятность совершения ошибок при разметке.
С актуальностью труднее.
Дело не только в том, что статьи меняются, и разметка одного среза A-Book может быть неприменима к другому. Диалог, посвященный акции, доступной сегодня, может быть не разрешаем для версии базы знаний через месяц. Решение простое: хранить информацию о том, какой временной срез базы знаний и коммуникаций с клиентом был взят в каждую итерацию разметки.
Мы решили придерживаться такого правила: для каждого среза базы знаний собирать диалоги не более чем 2-месячной давности. То есть, если актуальный срез A-Book взят за 15 сентября, то диалоги берутся за период с 15 июля по 15 сентября. Это обеспечивает достаточное количество диалогов и даёт пространство для манёвра в плане актуальности выгрузки базы знаний.
Полученные в процессе разметки чанки можно сопоставить с более крупными фрагментами статей через проверку вхождения подстроки, так как мы уверены, что то, что выделили разметчики точно содержится в нашей выгрузке.
И когда казалось, что финишная прямая уже близко и мы нашли ту самую «золотую» методологию «золотой разметки», мечты разбиваются о реальность: мы кое-что упустили. В процессе размышлений стало ясно, что в погоне за разметкой для ретрива, мы совсем забыли про бизнесовую часть системы.
Наш поток неоднородный, и не всё можно покрыть RAG-ом. Некоторые вопросы требуют обработки мультиинтента, другие непонятны без доспрашивания. И если мы хотим серьезно посмотреть на работу системы, нужно понимать, где плохое качество объясняется нецелевым потоком, а где действительно находится зона роста. И так возник другой очень важный вопрос: а с каким потоком мы вообще работаем?
Знай целевой поток в лицо
Мы понимали, что RAG по статьям базы знаний не покрывает весь поток, но никогда до этого не пробовали посчитать, какую именно долю входящего потока мы покрываем. И с планами расширения агентского функционала стало ясно, что без подробной аналитик потока мы не справимся.
Как можно характеризовать входящие нам запросы клиента?
№1. Способны ли мы понять, что хочет клиент?
RAG ничего не сможет ответить на «Добрый день, оператора пожалуйста», а на «Какие условия по кредитной карте 30 дней» — вполне. Нам нужно уметь отличать «мусорные запросы» от понятных.
Но и здесь не всё так просто! Коммуникация не всегда «цельная». Сессия одного и того же клиента с оператором может прерываться, если клиент долго не отвечает. Что если мы потеряем важный контекст, который сможем получить из предыдущих ближайших коммуникаций. Расширим варианты ответа на поставленный вопрос и получим:
Да, запрос понятен. нужна история.
Да, запрос понятен, не нужна история.
Нет, запрос не понятен.
И дадим разметчикам предыдущие коммуникации, чтобы они смогли посмотреть доступный модели контекст
№2. Сколько намерений содержится в вопросе клиента?
Мультиинтентные запросы как известно требуют отдельной обработки. Если клиент хочет за один запрос и кредитку закрыть, и тариф поменять, и вклад открыть — возможно его стоит притормозить. Но как надёжно описать, что такое «намерение»?
Методом проб и ошибок мы пришли к определению, которое работает достаточно хорошо для наших нужд:
«Намерение — это вопрос по одному банковскому продукту и одной банковской тематике»
И когда счастье было так близко, клиент спрашивает «Здравствуйте, как у вас дела?» Вопрос понятен, но как его классифицировать? Вроде бы тематика не банковская, но какое‑то намерение же есть?
Так появились следующие варианты ответов:
В запросе содержится одно намерение.
В запросе содержится больше одного намерения.
В запросе не содержится банковского намерения.
Этот вопрос также актуален для диалогов, когда клиент после решения одного своего вопроса меняет тему — это тоже считаем за мультиинтент.
№3. С запросами клиентом разобрались, а что насчёт действий оператора?
Нам нужна разметка, которая позволит свободно масштабировать функционал агента. И если ты хочешь сделать настоящего ассистента оператора, нужно думать, как оператор. Именно это мы и сделали — решили полностью смоделировать процесс работы оператора. В процессе общения с разметчиками и текущими операторами КЦ мы выделили необходимый список действий и интеграций, которыми можно описать любое действие оператора.
Среди них:
Общие фразы (Доброе утро, Чем могу помочь? и т.д.).
Досправшивание/Уточнение.
Обращение в БЗ.
И набор самых разных программ, которыми операторы пользуются во время работы.
Такая разметка позволит не только получить данные для оценки качества ретрива, но и комплексно посмотреть на весь поток. Результаты разметки позволили нам провести масштабное планирование развития агента, где решения о расстановке приоритетов принималось за счёт процентов потока, который мы можем покрыть каждой доработкой.
На словах звучит как мечта, а что на практике? А на практике это недели и недели внесения правок, корректировок и доработок.
Вот то, без чего методология бы не получилась успешной
№1. Примеры. Очень много примеров
Проект разметки растёт, становится сложнее, одни пункты разметки зависят от других. Оценка реплик клиентов и операторов требует взгляда на них с разных сторон. В таком проекте легко запутаться — именно с этим мы и столкнулись. Поэтому вместе с правками методология пополнялась и примерами. Самые сложные и спорные кейсы обсуждались вместе с разметчиками и добавлялись в список примеров.
№2. Нельзя смоделировать работу оператора, ничего о ней не зная
Мы проводили несколько Q&A сессий с действующими операторами КЦ, чтобы узнать всё об их работе. Это позволило не только грамотно составить список необходимых интеграций, но и собрать ценный фидбек, который также был задействован в работе над продуктом
№3. Итеративный процесс и фидбек-луп от контрагентов
Рим не сразу строился, и наш проект разметки тоже. Мы не отдали размечать весь датасет сразу, а начинали с малого — буквально 100 примеров. Потом сразу к фидбеку от разметчиков: что было сложно, что непонятно, спорно. Постепенно, с ростом согласованности росло и число примеров, которые мы могли уверенно отдать на разметку, зная, что качество нас устроит.
№4. Борьба с платформой разметки
В нашем случае это был LabelStudio — open source решение, с высокой степенью кастомизации функционала, но только при условии активной работы над самим собственно open source. Мы не могли ждать реализации дополнительного функционала (в возможности чего мы даже не были уверены), который бы превратил наш проект разметки в мечту, поэтом решили работать с тем, что есть. Новая платформа оказалась для нас terra incognita, поэтому какое-то время ушло просто на то, чтобы привыкнуть, но как только основной каркас проекта был сформирован, работа пошла бодрее.
Спустя почти несколько месяцев работ, мы получили нечто прекрасное:
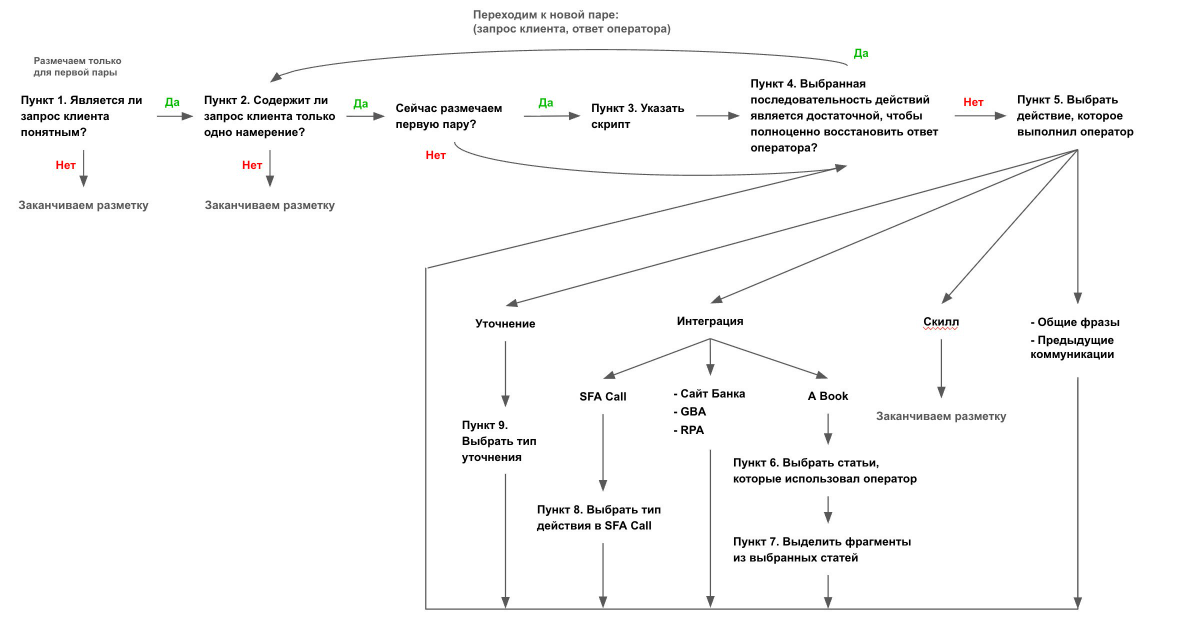
Эта диаграмма — кульминация всей нашей работы. По сути, это небольшая шпаргалка, которая направляет разметчиков в процессе их работы. Столкнувшись с разметкой очередного диалога, достаточно ответить на поставленные в диаграмме вопросы и пройти по направлению стрелочек:
Понятен ли запрос клиента? Да.
Содержит ли запрос клиента только одно намерение? Да.
Первая ли это пара реплик Клиент-Оператор? Да.
и т.д.
Каждый пункт разметки — отдельный вопрос, раскрывающий ту или иную сторону оценки реплики в диалоге. И пока вся методология включает в себя подробное описание пунктов и набор примеров, эта диаграмма позволяет верхнеуровнево посмотреть на основные этапы разметки.
А что размечаем?
Методология это хорошо, но абсолютно бесполезно, если у нас нет данных для разметки. Перед нами стояла ответственная задача — создать датасет, который сможет показать нам качество наших решений на всём потоке. Нам нужно было получить как можно более полное представление о том, какие запросы вообще могут к нам идти. Благо, нахождение подхода не заставило себя ждать — Единый Классификатор. Уже готовое внутреннее решение позволяло проводить иерархическую классификацию продуктов по 4 категориям: Продукт, Тема, Подтема и Подпродукт.
Отобрав уверенные предсказания классов диалогов, дело оставалось за малым — как сформировать выборку для разметки? Датасет должен быть:
Достаточно большим, чтобы полученные на нём оценки были статистически значимыми.
Достаточно разнообразным, чтобы для каждого «класса» диалогов мы могли получить различные варианты запросов.
То есть количество должно сопровождаться вариативностью. Получить 1000 примеров, где клиент просит закрыть кредитную карту, не наш вариант.
Анализ распределения классов показал, что дисбаланс классов довольно сильный. В выборке за 6 месяцев отдельные группы запросов были представлены всего парой-тройкой диалогов. Мы пришли к такой схеме сэмплинга.
Под кластером будем понимать пару Продукт-Тема, под подкластером только Подтему.
Всё множество диалогов делим условно на 3 группы:
Крупные кластеры | Кластеры, составляющие ~90% всей массы диалогов |
Малые кластеры | Всё, что составляет оставшиеся ~10% диалогов |
Слабо-насыщенные кластеры | Кластеры, в которых меньше 25 различных подкластеров |
Тогда, для каждой группы следующая логика сэмплирования:
Крупные кластеры | В каждом подкластере взять по M кейсов (минимум - M*25 примеров) |
Малые кластеры | Взять все диалоги, составляющие кластер |
Слабо-насыщенные кластеры | Взять минимум 30 примеров (по каждому подкластеру по возможности M примеров + случайно насэмплировать из оставшихся кейсов до 30) |
Число M было взято произвольно равное 5. При необходимости увеличить датасет, можно увеличить параметр M. Таким образом мы получаем достаточно разнообразный сэмплинг каждого кластера диалогов, сохраняющий при этом структуру потока.
Итого у нас получилось собрать общий датасет объёмом примерно в 5000 диалогов, который мы и отправили на разметку.
Выводы
Проведение золотой разметки оказалось куда сложнее, чем могло показаться. Но эти несколько месяцев упорной работы научили нас многому и помогли не просто получить данные, необходимые для проведения экспериментов, но и дали лучшее понимания того, с чем на самом деле мы работаем. И вот те маленькие мудрости, которые у нас получилось обрести:
№1. Понимание бизнес-задачи и целевого потока — это всё
Можно сделать хоть самый гениальный RAG, но какой в нём толк, если он покрывает незначительную часть потока. Или можно перепробовать хоть 10 самых современных эмбеддеров, но окажется, что секрет прироста качества в грамотной работе со входящим потоком. Понимание того, что приходит на вход модели — первое, чем нужно озадачиться.
№2. Дьявол кроется в деталях (и точных формулировках)
Хорошая методология — как юридический документ, исключает двусмысленность формулировок. Качественное ТЗ должно отвечать на все вопросы контрагентов ещё до того, как они появились. Но в реальной жизни всё обычно обстоит иначе, сначала появляются вопросы, а потом дорабатывается ТЗ. Что приводит нас к следующему пункту.
№3. Активное взаимодействие с командой разметки
Составление качественной методологии — итеративный процесс, невозможный без фидбек-лупа. Не нужно сразу строить космолёт, начать стоит с МВП и пары десятков примеров для разметки. И уже после дальнейшего анализа и общения с разметчиками станет ясно, что именно стоит доработать. Ну а дальше, как говорится, rinse and repeat, осталось только повторить это ещё пару раз до готовности.
№4. Data в Data Science
Хорошая методология — половина беды. А хорошие данные — вторая половина. Понимание данных, того, с чем мы работаем критически важно для составления хорошего датасета, ведь именно «золотым» датасетом планируется пользоваться практически на постоянной основе.
Читайте также:
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.