Затестил Kimi AI, Qwen, DeepSeek и Grok на работе с текстами. Делюсь результатами
Нейросеть получает статью на редактуру и возвращает гладкий текст, в котором автора уже не узнать. В препринте 2026 года исследователи из Berkeley, Google DeepMind и других организаций показали, что ИИ-модели меняют смысл текста, даже когда их просят исправить только грамматику. Kimi AI, Qwen, DeepSeek и Grok всё чаще пробуют для текстов вместо ChatGPT, и выбирать среди них редактора на глаз рискованно.
По умолчанию нейросеть, которой дали текст на редактуру, переписывает его, хотя просили только править. Ограничить её можно только жёстким промптом и сравнением версий. Модели для редактуры надо сравнивать по тому, какую долю текста они изменили и сохранился ли смысл, а не по впечатлению, что стало лучше.
Рейтинги ставят Kimi AI, Qwen и DeepSeek высоко по работе с русскими текстами, но редактуру они явно не измеряют
Публичные рейтинги сравнивают эти модели на русском по диалогам, длинным текстам и голосам людей. Правку чужой статьи они не проверяют.
Модель | Кто делает и как подключить | Русский в рейтингах |
|---|---|---|
Kimi AI | Moonshot AI, подключение через API, то есть из программы, а не только из окна чата | Kimi K3 в первой двадцатке русского среза Arena на 27 августа 2026 |
Qwen | Alibaba, Qwen3.5-397B-A17B открыта, есть в Alibaba Cloud Model Studio, 201 язык и диалект | Qwen3 235B A22B: 1076 очков в llmarena.ru на 18 апреля 2026 |
DeepSeek | китайская модель со своим API, оплата с пополняемого баланса | DeepSeek V3.2: 4-е место и 1133 очка там же |
Grok | в документации API xAI издатель назван SpaceXSI, grok-4.7 с окном 500 тыс. токенов | Grok 4.7: 13-е место в небольшом народном рейтинге AI-Stat |
Окно контекста — это сколько текста влезает в один запрос. Считают его в токенах, минимальных кусочках текста для модели: слово, число или знак препинания. По токенам же выставляют счёт за API. Места взяты из сводки GEN202 и AI-Stat и между таблицами не переносятся: у таблиц разные участники, задачи и даты. Регистрацию и оплату из России для каждой модели стоит проверить на её сайте до прогона.
Высокое место ничего не говорит о редактуре. DeepSeek на русском в мае 2025 года стояла первой в PingPong Ильи Гусева, но этот тест оценивает ролевые диалоги. Qwen на русском тоже проверяли на другом: Qwen3.5-27B первой стоит в столбце длинных текстов MERA Reason. Ближе всего к редактуре задание из теста bothub: при вычитке Kimi K3 не стала приписывать автору опечатки издания. Только текст там был английский.
Вставляют ли Qwen, DeepSeek и Kimi иероглифы в русский текст
Бывает, но в публичных тестах на этом попались другие модели. В слепом тесте 27 моделей английские слова и иероглифы посреди русских фраз вставляли Tencent Hy4 Preview и NVIDIA Nemotron 3.5 Super VL, а Qwen, DeepSeek и Kimi среди таких не названы. Утечки бывают и точечными: в тесте bothub китайская GLM вписала в русский ответ испанское reconciliación. Одно такое слово на статью глазами легко пропустить, поэтому поиск иероглифов стоит добавить в скрипт подсчёта правки.
Просьба исправить только грамматику не защищает смысл текста
Точного ответа нет, зато измерено, насколько далеко уходит текст. В препринте Abdulhai с соавторами люди правили свои эссе мелко и в разные стороны, а три ИИ-модели на 86 эссе сдвигали текст далеко от оригинала. Эталоном авторы считали точечную правку, которая сохраняет голос автора. В соседнем эксперименте той же работы у тех, кто активно писал с нейросетью, доля нейтральных эссе без позиции по вопросу выросла почти на 70%. Прямой запрет не спасает: модели меняли смысл, даже получив замечания эксперта и просьбу исправить только грамматику. Поэтому промпт для редактуры работает только вместе со сравнением версий.
Промпт для редактуры перечисляет, что править, и запрещает всё остальное
Промпт называет допустимые правки поимённо, запрещает остальные и просит вернуть список изменений:
Ты корректор. Исправь в тексте только орфографию, пунктуацию,
грамматику и явные описки.
Не переписывай предложения, не заменяй слова синонимами,
не меняй порядок абзацев, не добавляй и не убирай мысли.
Интонацию, разговорные слова и короткие фразы автора оставь как есть.
Если сомневаешься, не правь.
Верни полный текст, а после него список правок: было → стало,
по одной на строку.
Фраза про сомнение решает спорные места в пользу автора. Список правок нужен для сверки: если в тексте изменений больше, чем в списке, модель правила молча.
Как посчитать, сколько нейросеть поменяла в тексте
Посчитать правку помогают diff и короткий скрипт. Diff — это сравнение двух версий текста: что убрано и что добавлено. Его выводит команда git diff --no-index --word-diff original.txt edited.txt, а долю изменений считает Python:
import difflib, re

def tokens(t):
    return re.findall(r"\w+|[^\w\s]", t.lower())

def word_share(a, b):
    sm = difflib.SequenceMatcher(None, tokens(a), tokens(b), autojunk=False)
    return 1 - sm.ratio()
word_share показывает долю слов и знаков препинания, которые не совпали в двух версиях. Пороги условные: до 5% — точечная правка, от 15% — переписывание. Надёжнее сначала посчитать word_share на правке живого редактора: у Abdulhai с соавторами эталоном тоже служила человеческая правка.
Почему подсчёт по словам некорректный, когда абзацы переставлены местами
Подсчёт по словам видит в переставленном абзаце удаление и новую вставку, хотя нового текста нет. Devatine и Abraham пишут, что расстояние Левенштейна (минимум замен, вставок и удалений символов), BLEU, ROUGE и TER плохо отражают усилие на правку, когда переставляют блоки текста. Авторы бенчмарка EditEval ещё в 2022 году отметили, что привычные метрики редактирования не всегда согласуются между собой, так что одной цифре верить нельзя.
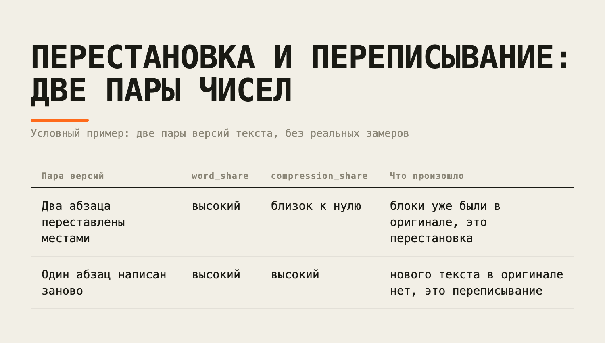
Devatine и Abraham предлагают метрику на сжатии (LZ77): переставленный блок уже есть в оригинале, и архиватор кодирует его короткой ссылкой назад. Приближение на стандартном zlib, который тоже сжимает по LZ77:
import zlib

def compression_share(a, b):
    z = lambda s: len(zlib.compress(s.encode(), 9))
    return (z(a + "\n" + b) - z(a)) / z(b)
Это упрощение, кода авторов здесь нет. Окно zlib — 32 КБ, поэтому длинную статью режьте по разделам. Высокий word_share при низком compression_share, скорее всего, значит перестановку блоков, а высокие оба значения говорят, что модель писала заново.
Как проверить на своей статье, сколько текста модель меняет при редактуре
В рейтингах Grok и DeepSeek стоят в разных таблицах, поэтому сравнить их можно только прогоном одной статьи с одним промптом:
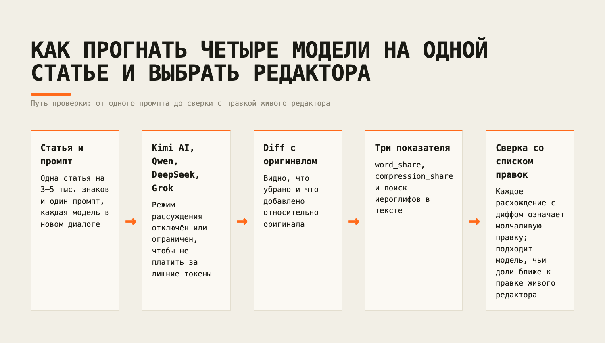
Возьмите статью на 3–5 тыс. знаков, каждую модель запускайте в новом диалоге.
Отключите или ограничьте режим рассуждения, когда модель перед ответом расписывает ход мысли. В краш-тесте 27 моделей китайские модели с ним выдавали по 51 000–68 000 токенов там, где GPT-6 Astra и Gemini 4 Argon укладывались в 6 461–9 841. Это в разы больше, и за разницу платят временем и деньгами.
Посчитайте word_share и compression_share, поищите иероглифы.
Сверьте diff со списком правок от модели: каждое расхождение означает молчаливую правку.
Прочтите изменённые места глазами: подсчёт по словам не видит, что ушёл смысл.
Повторять прогон после каждой доработки промпта удобно так же, как в регрессионном тестировании промптов.
Пороги и код здесь стартовые, итог зависит от текста, а версии моделей быстро меняются: в октябре 2026 года автор краш-теста среди китайских флагманов уже называл Qwen 3.8 Max и DeepSeek V4.1.
Редактуру можно отдавать модели, у которой доли изменений ближе всего к правке живого редактора и нет молчаливых правок. Гладкость результата в этом выборе ничего не решает. А какую долю изменённого текста вы считаете допустимой для редактуры своих статей?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.