Uplift-археология: как откопать эффект в слоях шума
Привет, Хабр. Я Александр Мистергазе, руководитель ML/AI R&D в проекте CVM, и сегодня расскажу о таком подходе в машинном обучении, как uplift‑моделирование.
В uplift‑моделировании выбор алгоритма — лишь часть задачи. Результат во многом зависит от постановки эксперимента, качества исторических данных, схемы валидации, выбора метрик и, наконец, от того, насколько правильно мы интерпретируем полученные результаты.
На примере CVM «Магнита» мы разберёмся, где теряется uplift‑сигнал, почему красивые офлайн‑метрики не гарантируют успеха в эксплуатации и что помогает создать модель, которой действительно можно доверять. Почему «археология»? Потому что искомый эффект редко лежит на поверхности: он погребён под слоями шума — естественной изменчивостью поведения, чужими кампаниями, промо и ценами, — и его нужно раскопать, не повредив.
Эта статья основана на моем докладе на MAGNIT TECH NIGHT. Посмотреть видео выступления можно здесь.
Большой масштаб = большая ответственность
Начнём с масштаба среды, в которой работает CVM «Магнит»: десятки миллионов клиентов, около 1,5 млрд коммуникаций, до 10 млрд персональных предложений в год. При таких объёмах даже небольшая ошибка в выборе аудитории масштабируется на миллионы взаимодействий. Поэтому вопрос уже не в том, можем ли мы персонализировать коммуникации. Вопрос в том, кому конкретное предложение действительно изменит поведение.
Но на пути к этому вопросу мы прошли через несколько этапов. На начальном этапе, в момент появления программы лояльности нужно было рассказать о ней как можно большему числу людей — отсюда массовые коммуникации и максимальный охват. Затем появились бизнес‑правила и сегментация: отправка предложений клиентам, которые соответствуют определённым условиям. Следующий этап — response‑модели, или модели отклика. Они отвечают на вопрос: «Кто с наибольшей вероятностью совершит целевое действие?» Дальше на сцене появились рекомендательные системы, которые подбирают наиболее релевантные предложения для каждого клиента.
Каждый из этих подходов полезен. Но у них есть общий недостаток: они не отвечают на главный вопрос: «Что произойдёт, если мы вообще не отправим клиенту коммуникацию?»
Response‑модель может прекрасно находить людей, которые купят товар, рекомендательная система — предлагать им подходящие товары. Но ни одна из этих задач сама по себе не требует выяснять, изменится ли поведение человека именно благодаря нашему воздействию. Ответить на это позволяет следующий уровень персонализации — uplift‑моделирование.
Четыре типа клиентов
Чтобы понять, что именно мы хотим предсказывать, мысленно разделим клиентов на четыре классические группы.
Естественные покупатели (Sure Things) — совершат целевое действие независимо от предложения: коммуникация релевантна, но эффекта не создаёт.
Безнадёжные (Lost Causes) — не совершат целевое действие ни с предложением, ни без него.
Не беспокоить! (Sleeping Dogs) — без коммуникации совершили бы целевое действие, а после воздействия — нет: предложение может даже ухудшить результат.
Убеждаемые (Persuadables) — совершат целевое действие только благодаря воздействию. Именно эта группа представляет основной интерес для uplift‑моделирования.
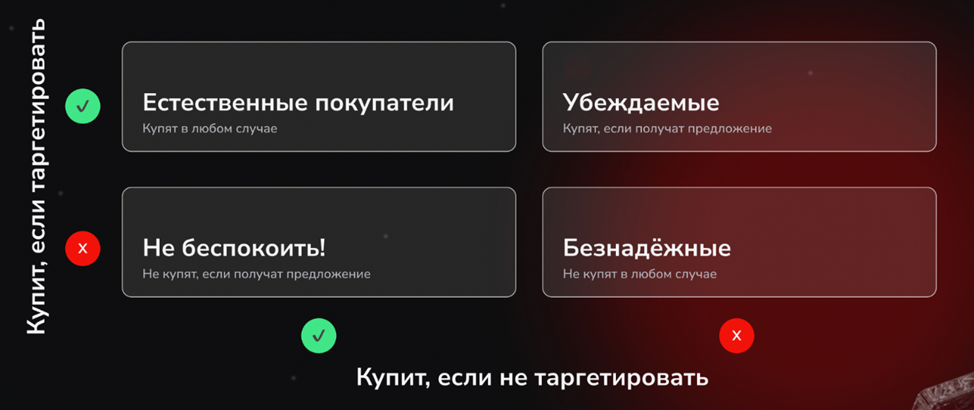
Важно: это концептуальные группы, определяемые потенциальными поступками клиента при наличии и отсутствии воздействия. Их нельзя напрямую разметить по обычным историческим данным.
Благодаря этой схеме становится понятно, почему response‑модель и uplift‑модель решают разные задачи. Представим, что клиент и без нашей коммуникации с высокой вероятностью купит товар. Response‑модель поставит его высоко в рейтинге, и с точки зрения прогнозирования покупки она будет совершенно права. Получается, что она может отлично ранжировать покупателей, но не обязательно создаёт инкрементальный прирост.
В uplift‑задаче объект поиска другой. Мы хотим оценить, насколько изменится вероятность целевого действия или ожидаемая прибыль, если на клиента воздействовать.
Если целевая переменная бинарная, например факт покупки, то разница между потенциальным действием клиента с нашим воздействием на него и без воздействия описывает изменение вероятности покупки. В бизнес‑задачах можно рассматривать и другие таргеты, в том числе денежный результат — это задача сложнее, но зачастую более полезна. С ней нам и чаще всего приходится сталкиваться.
Главная проблема: индивидуальный причинный эффект нельзя увидеть
На первый взгляд всё просто: соберём данные, обучим модель и предскажем uplift каждого клиента. Но тут есть принципиальное ограничение: для каждого клиента мы можем наблюдать только один из двух потенциальных исходов: результат при воздействии или результат без него. Увидеть оба одновременно невозможно. Если клиент получил предложение и купил товар, то мы не узнаем, купил бы он его без предложения, а если не купил — не узнаем, изменилось бы его решение при другом сценарии.
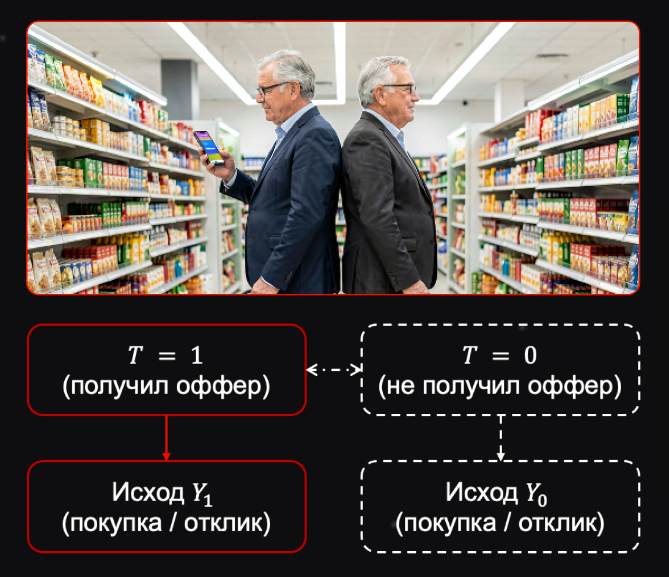
В обычной supervised learning‑задаче у нас есть наблюдаемая целевая переменная: клиент купил или не купил. В uplift‑моделировании целевая переменная тоже есть, но истинная искомая разница между двумя сценариями для конкретного человека остаётся неизвестной.
Поэтому модель не может обучаться на истинных индивидуальных эффектах от взаимодействия (ITE — individual treatment effect). Она оценивает ожидаемый эффект, опираясь на статистические закономерности в группах клиентов с похожими признаками. Отсюда вытекает ключевое требование: исторические данные должны позволять корректно сравнивать целевую и контрольную группы.
Формально мы оцениваем условный средний эффект (CATE): 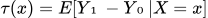 — ожидаемую разность исходов для клиентов с признаками
 .
 не наблюдается ни у одного клиента напрямую — из данных можно оценить только
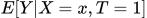 и
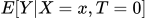 по группам, и их разность сходится к
 лишь при выполнении предположений, о которых поговорим ниже. Uplift — разность двух зашумлённых оценок, и погрешности складываются, а не гасятся для дисперсий независимых оценок. При слабом сигнале именно дисперсия, а не выбор архитектуры, часто становится главным ограничением.
В идеальном случае данные для uplift‑модели собирают в рандомизированном эксперименте: клиентов случайным образом распределяют по целевой и контрольной группе, первая получает воздействие, а вторая нет. При достаточном объёме данных такое сравнение позволяет оценивать причинный эффект, не смешивая его с систематическими различиями между группами. Делить таким образом клиентов пополам — удобный базовый вариант, хотя оптимальное соотношение зависит от стоимости воздействия, доступного объёма данных и целей эксперимента.
Но рандомизация не решает всех проблем. Чтобы оценка эффекта имела причинную интерпретацию, необходимо учитывать несколько предположений.
Однозначность воздействия (consistency,  при
 ). Наблюдаемый исход должен отвечать тому воздействию, которое фактически применено, а само воздействие должно быть хорошо определено.
Позитивность (positivity, 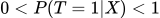 ). Для каждого клиента сегмента должна быть ненулевая вероятность попасть как в целевую, так и в контрольную группу. Иначе сравнение становится невозможным или ненадёжным.
Отсутствие скрытого смещения (unconfoundedness, 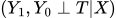 ). Воздействие не должно быть связано с потенциальными исходами через неучтённые факторы. Рандомизация в целом помогает обеспечить это условие.
Отсутствие межклиентских взаимодействий (SUTVA). Результат одного клиента не должен зависеть от воздействий на других. На практике условие может нарушаться — сарафанное радио, слухи об акции, — и это ещё немного шума.
Также доставка push‑уведомления, его показ и открытие — разные события; если клиент попал в целевую группу, но фактически не получил предложение, увы, в ваших данных прибавляется шума.
Если эти условия нарушены, то оценка эффекта может исказиться. Причём модель вполне способна демонстрировать убедительные офлайн‑результаты, которые не воспроизводятся в эксплуатации.
И всё это мы обсуждаем при условии, что само воздействие действительно работает.
Модель усиливает сигнал, а не создаёт его
Представим классическую ситуацию: владелец продукта просит создать uplift‑модель для механики, которая практически не влияет на поведение клиентов. Можно сколько угодно менять архитектуру, подбирать гиперпараметры и усложнять обучение, но если воздействие не создаёт измеримого эффекта, то модели нечего усиливать (кроме шума).
Основные причины слабого сигнала можно разделить на четыре группы:
Нерелевантное предложение. Оно не соответствует потребностям клиента и не меняет его решение.
Слабая награда. Вознаграждение слишком мало, чтобы повлиять на поведение.
Неэффективный креатив. Клиент формально попал в целевую группу, но не придал ему должного внимания (не привлёк ни текст, ни картинка предложения).
Длинный цикл принятия решения. Между коммуникацией и целевым действием проходит значительное время, за которое клиент успевает столкнуться с множеством других факторов.
Последний пункт особенно важен для офлайн‑CVM. Клиент, получив push‑уведомление, должен заметить предложение, заинтересоваться им, принять решение отправиться за покупкой и… не забыть о том, что мы ему предложили, когда и если он доберётся до магазина. Привлечение покупателя в данном случае становится значительно более сложной задачей в сравнении с онлайн‑средой, где время принятия решения измеряется секундами и клиенту требуется меньше усилий и энергии, чтобы обменять свои средства на предлагаемый ему товар.
Но даже хорошая маркетинговая механика не гарантирует, что эффект от неё можно будет легко детектировать. Поскольку наряду со слабым сигналом данные содержат также и внешний шум.
Источники шума:
Другие команды могут запускать свои предложения, создавая конкурирующие воздействия.
На спрос влияют промоакции и изменения цен.
Условия на рынке меняются из‑за действий конкурентов.
Могут происходить другие события, которые мы не контролируем.
Конечно, можно провести лабораторный эксперимент, максимально изолировав клиентов от всех остальных воздействий, но такой результат может и не соответствовать поведению людей нашей реальности, когда взаимодействия пересекаются и конкурируют за внимание клиента.
В итоге модель должна выделить часто небольшой причинный эффект на фоне огромного количества естественных зашумляющих факторов. Именно поэтому в uplift‑задаче так легко переоценить качество своего решения. Эффект в uplift-задачах не лежит на поверхности: он залегает глубоко, и добраться до него можно только послойно снимая шум — аккуратно, чтобы не повредить то, что ищешь.
Валидация: как не получить идеальную модель, которая не работает
Допустим, мы определились с механикой, собрали данные и обучили несколько моделей. Теперь нужно понять, какая из них лучше. Первый соблазн — воспользоваться привычным random split: случайно разделить наблюдения на обучающую и валидационную выборки. Для нашей задачи это может быть слишком оптимистичным подходом. Часть данных из одной маркетинговой кампании может попасть в разные группы, и такое случайное разделение способно привести к утечке информации между выборками. Модель может учиться на наблюдениях, тесно связанных с теми, по которым её затем оценивают, и тогда метрики оказываются лучше, чем при использовании действительно новых данных.
Улучшить ситуацию можно стратифицированным разбиением. Например, можно хотя бы сохранить соотношение целевой и контрольной групп, а также сбалансировать распределение важных признаков. Это полезно для сопоставимости выборок, но не решает проблему переноса на новые кампании.
Поэтому для решения задачи мы выбрали другой подход: разделение обучающей и проверочной выборки целиком по кампаниям. Одни кампании мы используем для обучения моделей, другие — для валидации. Такой подход ближе к реальному сценарию внедрения, он лучше помогает понять, сохранится ли эффект, когда модель начнёт работать с новой кампанией.
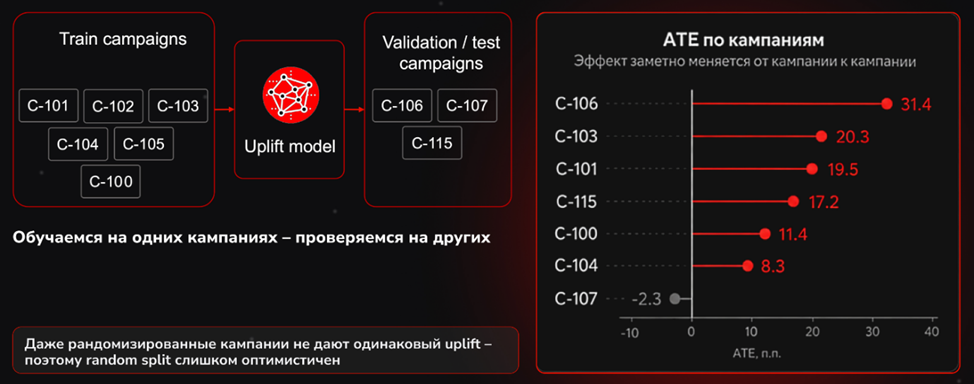
Но у этого решения тоже есть своя цена. Во‑первых, нужно достаточно кампаний, чтобы собрать полноценную валидационную выборку, на это мы выделяем не менее 3 кампаний. Во‑вторых, как следствие, для обучения остаётся меньше данных. В‑третьих, кампании могут существенно различаться по своим характеристикам и величине эффекта, поэтому недостаточно выбирать их просто случайным образом.
Как выбирать кампании для валидации?
Даже одна и та же механика — например, «соверши покупку на Х рублей и получи вознаграждение Y бонусов» — может давать разный эффект в разных кампаниях. Поэтому мы ранжируем кампании по историческим оценкам эффекта, а затем разбиваем их на страты. Из каждой страты выбираем одну или несколько кампаний для проверки. Так мы стараемся не свести проверку к кампаниям с заведомо сильным или слабым эффектом.
Главный вопрос звучит так: «Сохранится ли преимущество модели на кампании, которую она никогда раньше не видела?» Именно этот вопрос определяет ценность модели для эксплуатации.
Метрики: почему красивой uplift‑кривой недостаточно
Предположим, что с проверкой мы разобрались, и теперь нужно измерить качество модели. В uplift‑моделировании есть классические метрики, знакомые многим:
Incremental Gain — кумулятивный прирост целевой переменной;
AUUC (Area Under the Uplift Curve) — площадь под uplift‑кривой;
Qini coefficient — нормированная площадь между кривой модели и линией случайного таргетинга.
Они помогают оценить, насколько хорошо модель ранжирует аудиторию по ожидаемому эффекту и насколько эффективно можно выбирать клиентов для воздействия. Не каждая из них является «удобной» в использовании для случая с непрерывной целевой переменной (дело в «идеальной» uplift‑кривой, которая нужна для нормировки метрик). Тем не менее все они позволяют ответить на вопрос, какая из нескольких моделей показывает себя лучше относительно другой.
Но есть нюанс: модель с лучшей uplift‑метрикой из построенных не обязательно даст нам увеличение прибыли в реальной маркетинговой кампании. Прежде всего необходимо оценить, является ли вообще её внедрение экономически целесообразным. Поэтому одной стандартной метрики недостаточно.
Посмотрим на график кумулятивной прибыли на одной из валидационных кампаний. По горизонтали — доля аудитории, которую мы последовательно включаем в таргетинг по убыванию score модели, по вертикали — накопленный дополнительный финансовый результат (все инвестиции в награды и стоимость коммуникации уже учтены) нормированный на результат полной кампании с рандомизированным таргетингом.
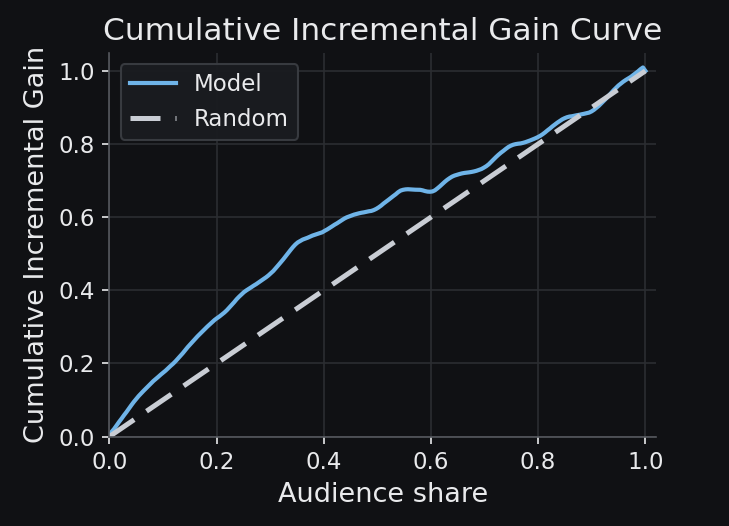
Пунктиром обозначен кумулятивный прирост при рандомизированном таргетинге (то, что было в реальности на этапе exploration). Непрерывная линия показывает результат нашей модели при последовательном добавлении аудитории.
В оптимистичном сценарии кривая модели растёт быстрее baseline, то есть мы получаем больший результат, воздействуя на меньшую долю клиентов.
Так и на графике выше: модель в большинстве точек локально превосходит случайный таргетинг. Метрики показывают неплохие значения. Кажется, что можно представить полученный результат как победу над baseline подходом и начать использовать модель в проде.
Стоп! Внимательный заказчик, скорее всего, задаст вопрос: «Погодите с продом, судя по графику, модель, какой бы порог для score вы ни выбрали, не сможет принести больше прибыли в абсолютном выражении, если мы, как и прежде, будем заниматься случайным таргетингом на всю аудиторию». И он будет прав.
Поэтому мы дополняем стандартные uplift‑метрики бизнес‑ориентированными метриками:
Доля аудитории, на которой модель превосходит случайный baseline при 100%
Средний дополнительный результат относительно baseline при 100% покрытии
Минимальная доля аудитории, при которой достигается пересечение с baseline при 100% покрытии
Последняя метрика особенно полезна для интерпретации кривой. Если модель пересекает baseline только при очень большой доле аудитории, то её практическая ценность может оказаться невелика. Чем значение ниже, тем лучше.
Формально: пусть  — кумулятивный инкрементальный результат (в деньгах, после вычета вознаграждений и стоимости коммуникаций) при таргетинге доли
 аудитории, упорядоченной по убыванию uplift‑скора. Тогда три бизнес‑метрики выше записываются так:
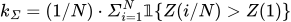 — доля аудитории, на которой модель превосходит случайный baseline при 100% покрытии, то есть «ширина» зоны преимущества.
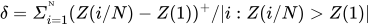 — средний дополнительный результат относительно baseline при 100% покрытии.
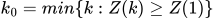 — минимальная доля аудитории, при которой кривая модели достигает уровня случайного таргетинга при 100% покрытии (Total random gain на рис. 5).
Практическое правило: кампания с плановым охватом  имеет смысл, только если
 , а чем заметнее
 , тем больше экономия на коммуникациях без потери результата.
Все три метрики считаются из одной кумулятивной кривой:
import numpy as np
import pandas as pd

def incremental_gain_curve(y, t, score, n_points=None):
    """Кривая накопленного инкрементального результата Z(k).

    Z(k) - по топ-k клиентам, отсортированным
    по убыванию score (Radcliffe 2007).
    Z(k) = Y_T(k) − Y_C(k)·N_T(k)/N_C(k)

    Parameters
    ----------
    y : array-like
        Результат клиента.
    t : array-like
        Флаг воздействия: 1 — ЦА, 0 — КГ.
    score : array-like
        Скор модели (чем больше, тем раньше клиент попадает в таргетинг).
    n_points : int, optional
        Число точек сетки. None — сетка i/N по каждому
        клиенту (эквивалентно n_points=N). n_points > N сводится к N.

    Returns
    -------
    xs : np.ndarray
        Доли покрытия k (правые границы префиксов).
    z : np.ndarray
        Z(k); NaN в префиксах без контрольных клиентов (оценки нет).

    Raises
    ------
    ValueError
        Если данные пусты после удаления NaN, t содержит значения вне {0, 1},
        отсутствует контрольная группа или n_points < 1.
    """
    df = pd.DataFrame({"y": y, "t": t, "s": score}).dropna()
    if df.empty:
        raise ValueError("Пустые данные после удаления NaN.")
    if not df["t"].isin([0, 1]).all():
        raise ValueError("t должен содержать только 0 и 1.")
    n_c_total = int((df["t"] == 0).sum())
    if n_c_total == 0:
        raise ValueError("Нет контрольной группы (t=0): baseline не определён.")
    if n_points is not None and int(n_points) < 1:
        raise ValueError("n_points должен быть >= 1.")

    df = df.sort_values("s", ascending=False, kind="mergesort", ignore_index=True)
    y_arr = df["y"].to_numpy(dtype=float)
    is_t = (df["t"] == 1).to_numpy()
    n = len(df)

    ctr = np.cumsum(np.where(is_t, y_arr, 0.0))
    ccr = np.cumsum(np.where(~is_t, y_arr, 0.0))
    nt = np.cumsum(is_t)
    nc = np.cumsum(~is_t)

    m = n if n_points is None else min(int(n_points), n)
    idx = np.clip(np.arange(1, m + 1) * n // m, 1, n) - 1
    xs = (idx + 1) / n

    nt_k, nc_k = nt[idx], nc[idx]
    with np.errstate(divide="ignore", invalid="ignore"):
        ratio = nt_k / nc_k
        z = ctr[idx] - ratio * ccr[idx]
    z = np.where(nc_k > 0, z, np.nan)
    return xs, z


def uplift_targeting_metrics(y, t, score, n_points=None):
    """Метрики k_0, k_Σ и δ по кривой Z(k) .

    Parameters
    ----------
    y, t, score
        См. :func:`incremental_gain_curve`.
    n_points : int, optional
        Сетка кривой; None — полный сет i/N по каждому клиенту.

    Returns
    -------
    dict
        k0    : минимальная доля охвата, сохраняющая результат полной кампании;
        k_sum : доля безопасного охвата (k_Σ);
        delta : средний выигрыш над baseline в деньгах (δ);
        z1    : Z(1) — инкрементальный результат полной кампании;
        valid : True, если Z(1) > 0 (метрики осмыслены).
    """
    xs, z = incremental_gain_curve(y, t, score, n_points=n_points)
    z1 = z[-1]

    valid = ~np.isnan(z)
    ge = valid & (z >= z1)
    gt = valid & (z > z1)

    return {
        "k0": float(xs[np.argmax(ge)]) if ge.any() else 1.0,
        "k_sum": float(gt.sum() / len(z)),
        "delta": float((z[gt] - z1).mean()) if gt.any() else 0.0,
        "z1": float(z1),
        "valid": bool(z1 > 0),
    }
Все эти показатели помогают ответить на вопрос, который стандартные uplift‑метрики напрямую не закрывают: существует ли достаточно большая зона аудитории, в которой модель обеспечивает устойчивый и экономически осмысленный прирост?
Однако даже этого недостаточно. Иногда модель показывает настолько хороший результат, что его стоит не праздновать, а расследовать.
Когда слишком хороший результат — плохой знак
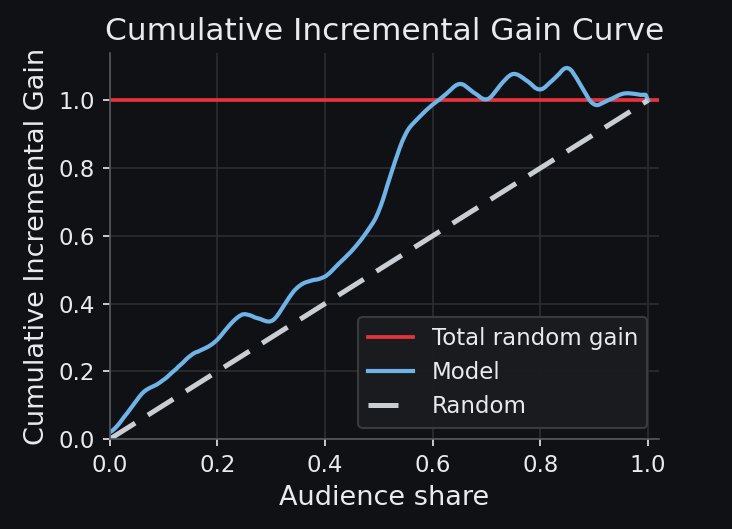
В одном из наших экспериментов нейросеть продемонстрировала подозрительно сильный результат: кривая заметно превзошла ожидаемый baseline:
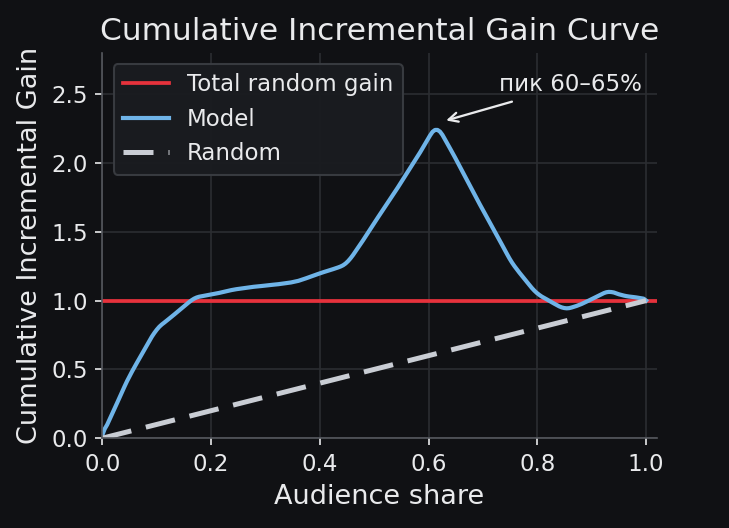
Сам по себе такой результат возможен, но в uplift‑моделировании он требует дополнительной проверки. Однако нас сильно смутила именно форма кривой…
Внезапно появилось желание проверить распределение целевой и контрольной групп по децилям предсказанного uplift. И мы увидели следующую картину:
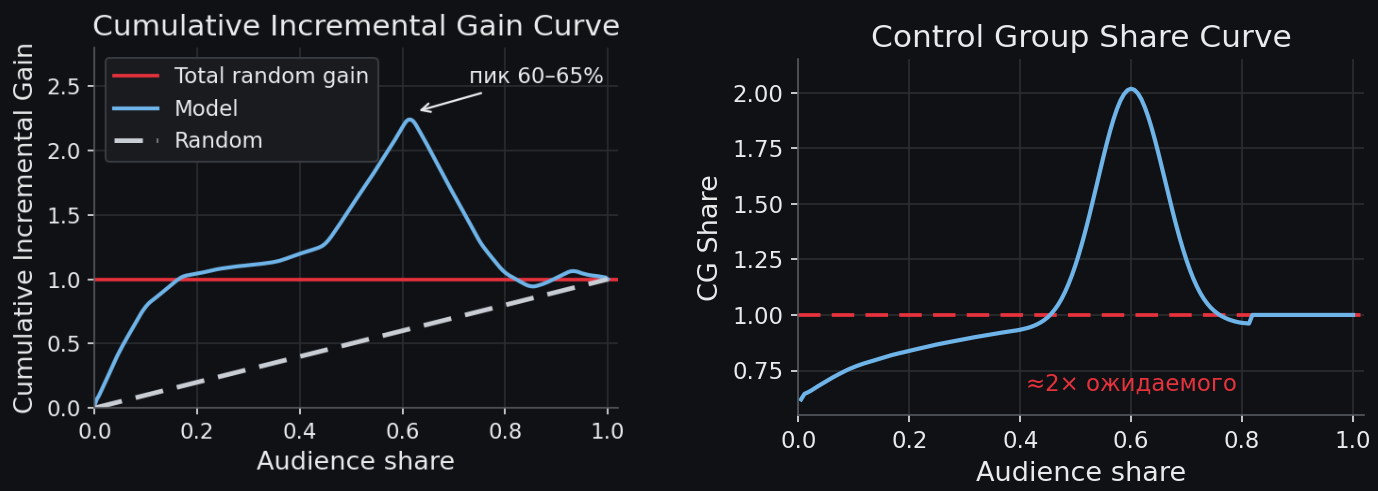
Хорошая новость — получили эстетическое удовольствие, рассматривая график, плохая новость — модель использовать нельзя.
И вот почему: если модель обучалась на корректно рандомизированных данных, то соотношение размеров целевой и контрольной групп в локальных сегментах должно быть в среднем близким к исходному соотношению. А если в верхних децилях группы систематически расходятся, то часть наблюдаемого эффекта можно объяснить не воздействием, а структурой выборки.
Это не означает, что любое отклонение автоматически доказывает ошибку. Важно учитывать статистическую неопределённость, объёмы сегментов и схему эксперимента. Но что мы видели? Довольно сложная нейронная сеть обучилась именно такому виду шума? Говорит ли это о нарушении условия unconfoundedness? Оставьте в комментариях свою версию.
Получается, что можно получить модель, которая выглядит великолепно даже по техническим и нашим новым ориентированным на бизнес метрикам, но плохо переносится в эксплуатацию. Поэтому нас должен ещё интересовать механизм, с помощью которого возник измеренный эффект. Нам важен не только сам факт, что модель оказалась лучше baseline, но и причина. Если преимущество связано с артефактами данных, то при переносе на новые кампании оно может исчезнуть. Словом, если находка слишком хороша для своего слоя — проверяйте контекст залегания: возможно, это не находка, а артефакт данных.
В uplift‑моделировании проблема переобучения особенно актуальна: слабый сигнал легко перепутать с шумом, а модель с высокой ёмкостью способна выучить не только полезные закономерности, но и случайные особенности выборки. В целом в данном классе моделей грань между недообучением и переобучением очень тонка.
Какие алгоритмы сработали у нас
Эксперименты мы вели на данных с клиентскими взаимодействиями согласно механике «покупка на X рублей — вознаграждение Y бонусов». Всего порядка 20 кампаний; контрольная группа составляла канонические 50%; горизонт таргета — 1 неделя. Meta‑learners и метрики AUUC/Qini считали на scikit‑uplift и CausalML, causal forest — на EconML, нейросетевые модели — на catenets. Базовые алгоритмы для meta-learners - CatBoost и LightGBM.
Мы попробовали разные семейства моделей:
meta‑learners, в том числе подходы на основе нескольких базовых моделей;
causal forest;
нейросетевые архитектуры с representation learning.
Коротко о механике каждого семейства — и почему на наших данных они повели себя именно так:
S‑learner обучает одну модель, включая факт воздействия как обычный признак, а эффект оценивает как разность предсказаний при T = 1 и T = 0. При слабом сигнале алгоритм просто не делает расщеплений по этому признаку — эффект «съедается».
T‑learner обучает две независимые модели на целевой и контрольной группах. Разность предсказаний наследует погрешности обеих: дисперсии ошибок двух независимых моделей складываются, дисперсия оценки эффекта растёт примерно вдвое (стандартная ошибка — в √2 раз), что при низком соотношении сигнал/шум становится фатальным.
X‑learner сначала оценивает индивидуальные эффекты в каждой группе, а затем предсказывает их перекрёстно. Он точнее T‑learner при несбалансированных группах, но в нашем эксперименте это не актуально.
Causal forest строит «честные» деревья: разбиение и оценка эффекта считаются на разных подвыборках. Это снижает переобучение и даёт более калиброванные оценки эффекта; цена — чувствительность к настройке (глубина, минимальный размер листа, число признаков в расщеплении).
TARNet и DragonNet строят общее представление признаков и две «головы» для целевой и контрольной групп; DragonNet дополнительно предсказывает propensity с targeted regularization (что опять же для нашего случая с
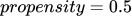 не даёт преимуществ). Ёмкая архитектура легко выучивает шум при слабом сигнале, поэтому требует строгой регуляризации и ранней остановки.
OffsetNet использует «жёсткую репараметризацию»: общая сеть моделирует базовый прогностический отклик, а эффект задаётся как аддитивный сдвиг (offset) к нему. Дисперсия оценки ниже, но жёсткая связность параметров делает обучение чувствительным к качеству общего представления; при слабом сигнале модель у нас оказалась нестабильной и склонной к переобучению.
RANet — нейросетевая реализация RA-learner’а: сначала обучаются прогнозы исходов
 и
 , затем на признаки регрессируется псевдо-исход
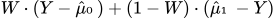 — импутированный индивидуальный эффект. На наших данных RANet был не плох, но при этом легко переобучался и требовал аккуратной регуляризации и ранней остановки.
Получили следующие результаты:
Таблица 1. Сравнение семейств алгоритмов uplift на валидационных кампаниях
Семейство | Модель | В топ-2 | Ниже random | Вердикт |
Meta‑learners | S‑learner | 0 | 4 | - |
T‑learner | 0 | 4 | - | |
X‑learner | 0 | 4 | - | |
Tree‑based | Causal Forest | 4 | 1 | + |
Representation learning | TARNet | 3 | 2 | + |
DragonNet | 3 | 2 | + | |
OffsetNet | 0 | 4 | - | |
RANet | 2 | 2 | + |


Метрики считались по каждой из 5 валидационных кампаний. «Топ-2» — модель входит в две лучшие из восьми сравниваемых в кампании (при равенстве в топ-2 попадали обе). «Ниже random» — модель ранжирует аудиторию хуже случайного таргетинга.
Сразу оговорюсь: это не универсальный рейтинг алгоритмов. Результаты получены на наших данных, выбранной нами механике и схеме проверки по кампаниям.
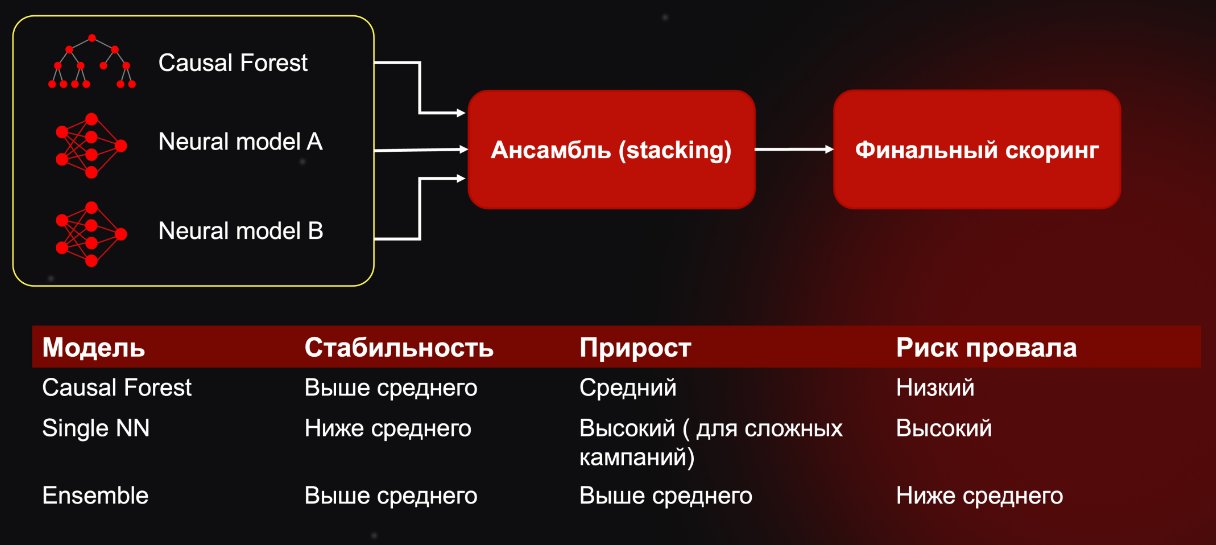
Но мы не стали делать вывод, что лес всегда лучше нейросети. У отдельных нейросетевых моделей на некоторых проверочных кампаниях результаты всё же превосходили наш базовый подход. Поэтому следующим логичным шагом стал ансамбль — взвешенное среднее лучших алгоритмов. В качестве устойчивой основы мы использовали causal forest, а результаты других моделей помогли дополнить его.
Итоги
Разработка хорошей uplift‑модели — это поиск не самой сложной модели, а создание надёжной системы, которой можно доверять.
Раскопки завершены: слой за слоем мы отделили находки от пластов шума. Осталось унести короткий чек‑лист, на который мы опираемся и сегодня:
Сначала убедитесь, что воздействие вообще работает: модель усиливает сигнал, а не создаёт его.
Валидируйте по кампаниям, а не по строкам данных. Главный вопрос: переживёт ли модель кампанию, которую никогда не видела.
Смотрите не только на uplift‑кривую, но и на абсолютную прибыль, и на зону аудитории, где модель реально превосходит случайный таргетинг.
Если результат «слишком красивый» — проверяйте механизм: соотношение целевой и контрольной групп в децилях (и обучите классификатор
 ~
 : при корректной рандомизации его AUC ≈ 0,5), артефакты данных, условие unconfoundedness.
Выбирайте модель не по одной метрике, а по стабильности между кампаниями. У нас устойчивее всего оказался ансамбль с ведущей ролью causal forest.
Часто куда важнее способность сохранять приемлемое качество в разных кампаниях, нежели построить эффектную нейросетевую архитектуру, которая покажет рекордную метрику лишь на одном эксперименте.
А как вы решаете проблему утечки по кампаниям при валидации и какие бизнес‑метрики используете помимо AUUC и Qini? Будем рады примерам из вашей практики в комментариях.
Полезные ссылки
Библиотеки
scikit‑uplift (sklift): github.com/maks‑sh/scikit‑uplift
CausalML (Uber): github.com/uber/causalml
EconML (Microsoft): github.com/py‑why/econml
catenets (A. Curth, M. van der Schaar): github.com/AliciaCurth/catenets — реализация TARNet, OffsetNet, RANet и нейросетевых meta‑learners
Causal forest
Wager S., Athey S. Estimation and Inference of Heterogeneous Treatment Effects using Random Forests. JASA, 2018 — arxiv.org/abs/1510.04342
Athey S., Wager S. Estimating Treatment Effects with Causal Forests: An Application. Observational Studies, 2019 — arxiv.org/abs/1902.07409
Нейросетевые модели (TARNet, DragonNet, RANet, OffsetNet)
Shalit U., Johansson F., Sontag D. Estimating Individual Treatment Effect: Generalization Bounds and Algorithms. ICML, 2017 — arxiv.org/abs/1606.03976
Shi C., Blei D., Veitch V. Adapting Neural Networks for the Estimation of Treatment Effects. NeurIPS, 2019 — arxiv.org/abs/1906.02120
Künzel S., Sekhon J., Bickel P., Yu B. Metalearners for Predicting Heterogeneous Treatment Effects using Randomized Experiments. PNAS, 2019 — arxiv.org/abs/1706.03461
Curth A., van der Schaar M. Nonparametric Estimation of Heterogeneous Treatment Effects: From Theory to Learning Algorithms. AISTATS, 2021 — arxiv.org/abs/2101.10943 (в этой работе предложены RANet и OffsetNet)
Curth A., van der Schaar M. Really Doing Great at Estimating CATE? A Critical Look at ML Benchmarking Practices in Treatment Effect Estimation. NeurIPS Datasets & Benchmarks, 2021 — arxiv.org/abs/2107.13346
Liu, D., Tang, X., Qiao, Y., Liu, M., Sun, Z., He, X., & Ming, Z. Benchmarking for deep uplift modeling in online marketing. arXiv preprin, 2024 — arxiv.org/abs/2406.00335
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.