無料で600以上の言語をサポートする最先端の大規模多言語ゼロショットテキスト音声合成TTSモデル「OmniVoice」
文章を音声に変換するツールは動画のナレーションや教材の読み上げなどに便利ですが、複数の言語への対応や特定の人物の声を再現するには用途に合った音声合成モデルが必要です。そこで、600以上の言語に対応し、短い音声サンプルからの声の複製や性別・年齢・声の高さなど指定した音声が生成できる無料のTTSモデルが「OmniVoice」です。
k2-fsa/OmniVoice: High-Quality Voice Cloning TTS for 600+ Languages
https://github.com/k2-fsa/OmniVoice
◆600以上の言語に対応する音声クローニング
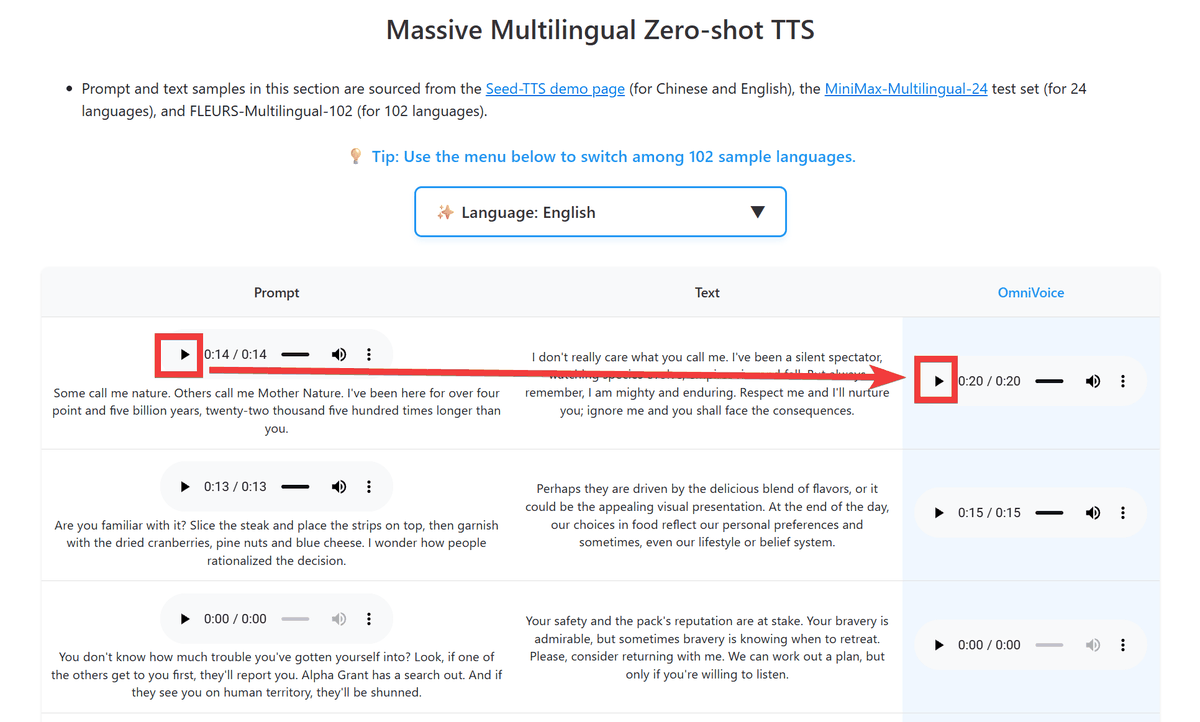
OmniVoiceは文章から音声を生成する「Text-to-Speech(TTS)」モデルで、追加学習を行わずに入力された音声に合わせた声を再現する「ゼロショット音声クローニング」に対応しています。公式の「Massive Multilingual Zero-shot TTS」には元となる「Prompt」と読み上げる「Text」、生成した音声を比較できるサンプルが掲載されています。
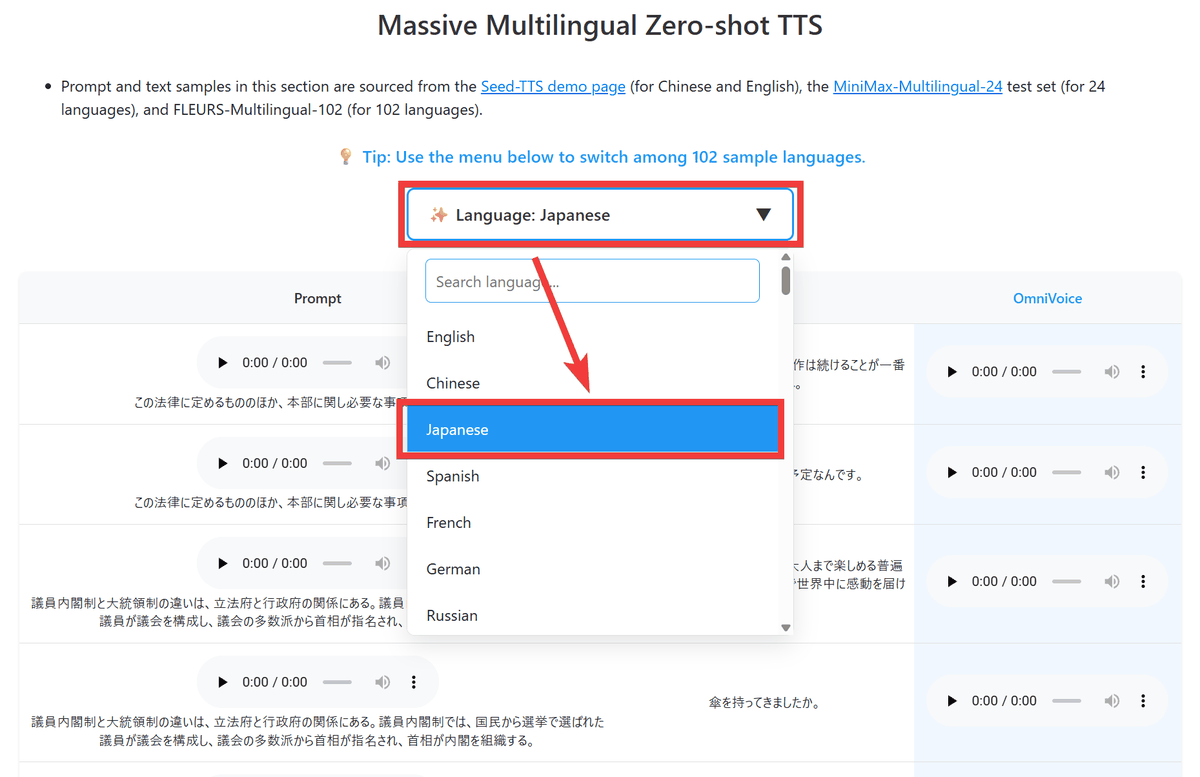
「Select a Language」のメニューには日本語を含む102言語のサンプルが用意されているため、言語を切り替えながら声の違いを聞き比べられます。例えば「Japanese」を選択すると日本語の参考音声と別の文章を読み上げた音声が並び、元の声の特徴を引き継いだ読み上げを確認できます。
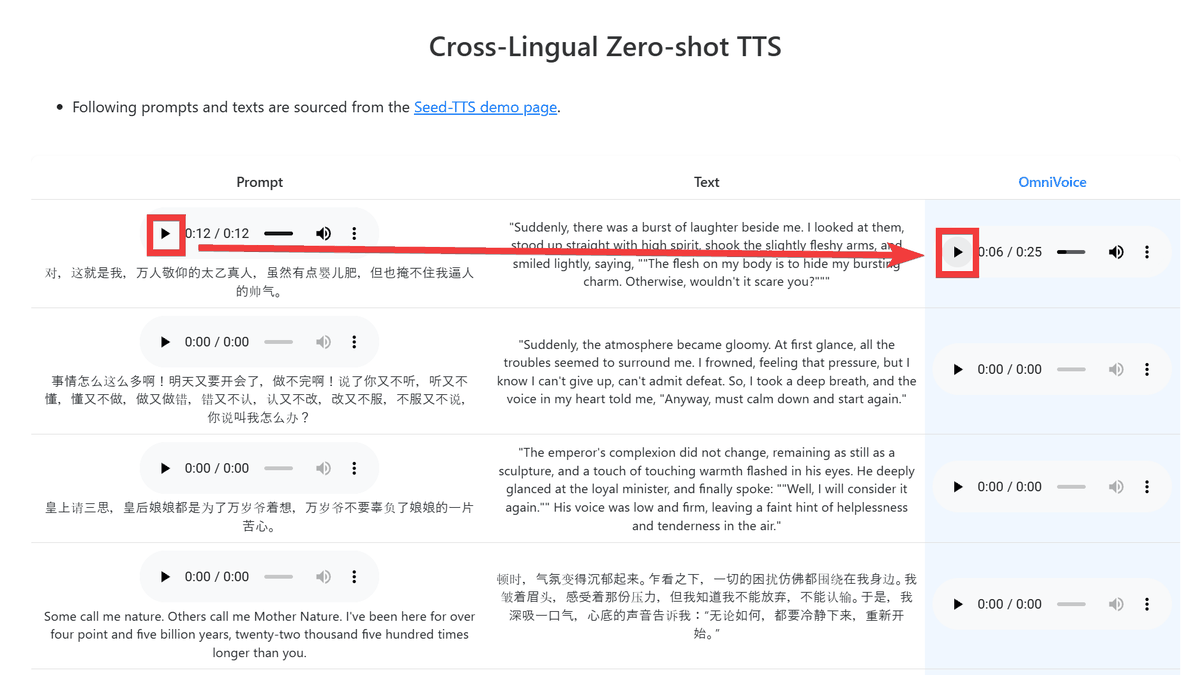
さらに「Cross-Lingual Zero-shot TTS」では別の言語で録音された声を使う例も掲載され、異なる言語間での音声クローニングを試せます。ただし、参考音声の言語によるアクセントが生成結果に残る場合があり、公式は目標言語と同じ言語の音声を用意する方法を推奨しています。
◆性別や年齢などを指定して声を作成
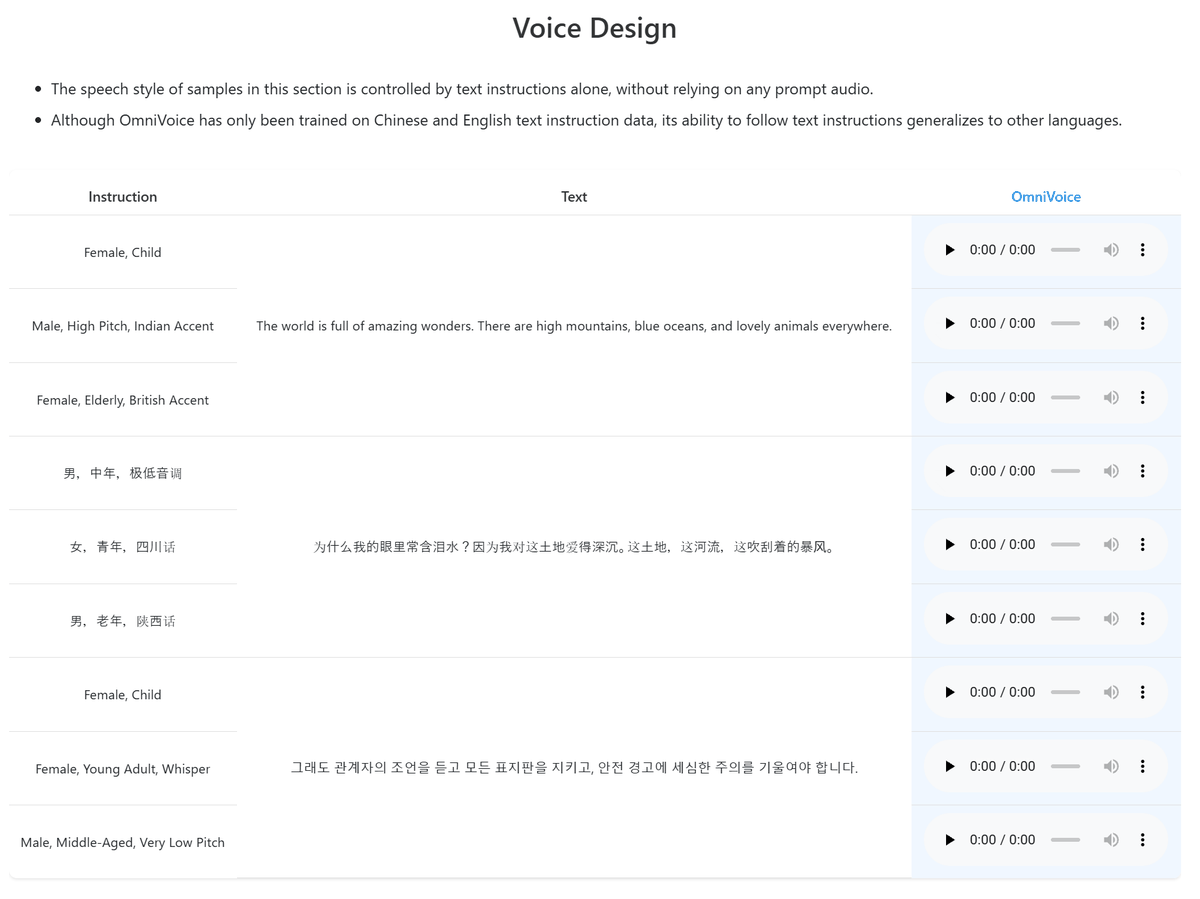
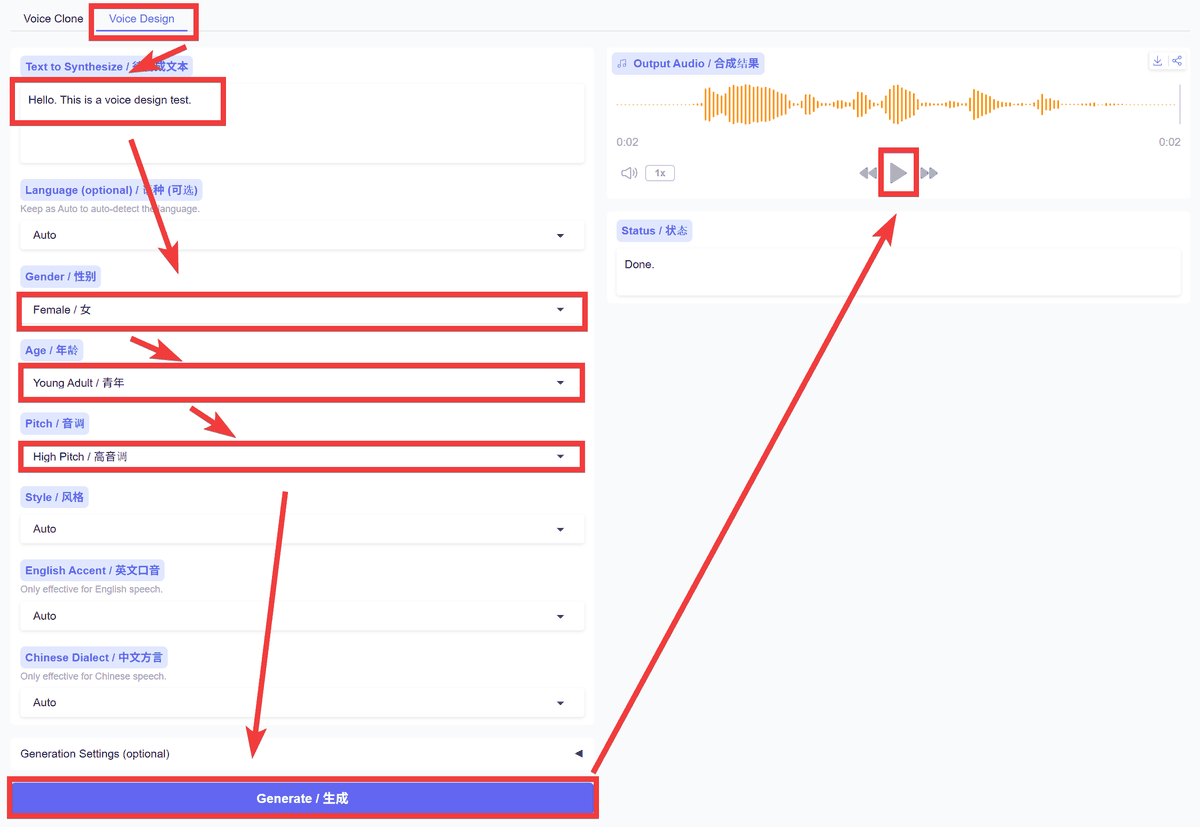
声を自由に作りたい場合には「Voice Design」が利用でき、性別・年齢・声の高さなどを指定するだけで音声が作成可能。
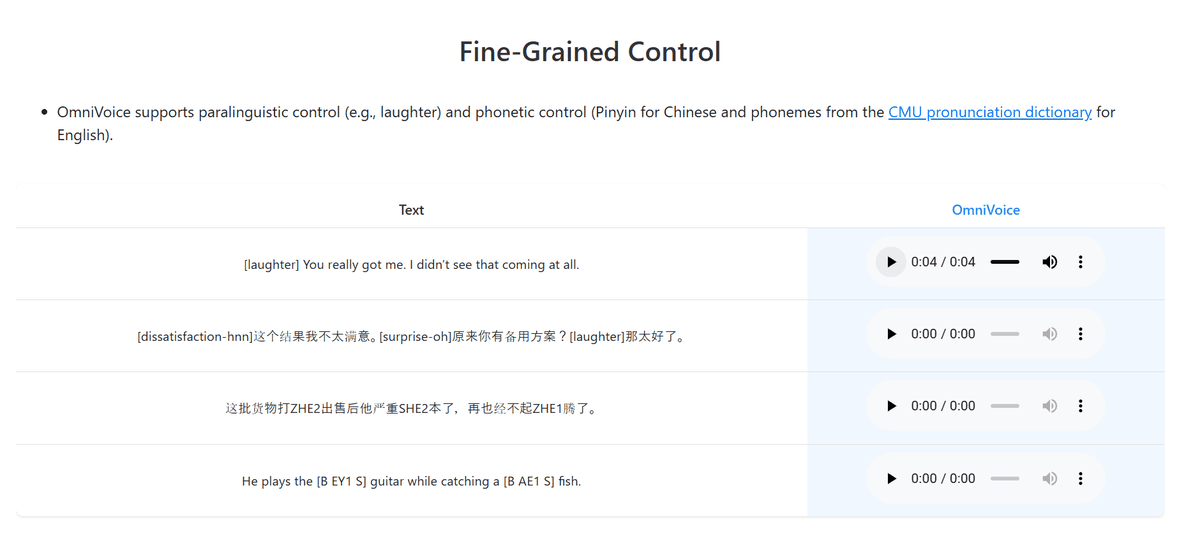
「Fine-Grained Control」では文章に「[laughter]」を入れて笑い声を追加するなど、言葉以外の音声も組み込めます。
◆OmniVoiceをローカルで利用し日本語の音声を生成
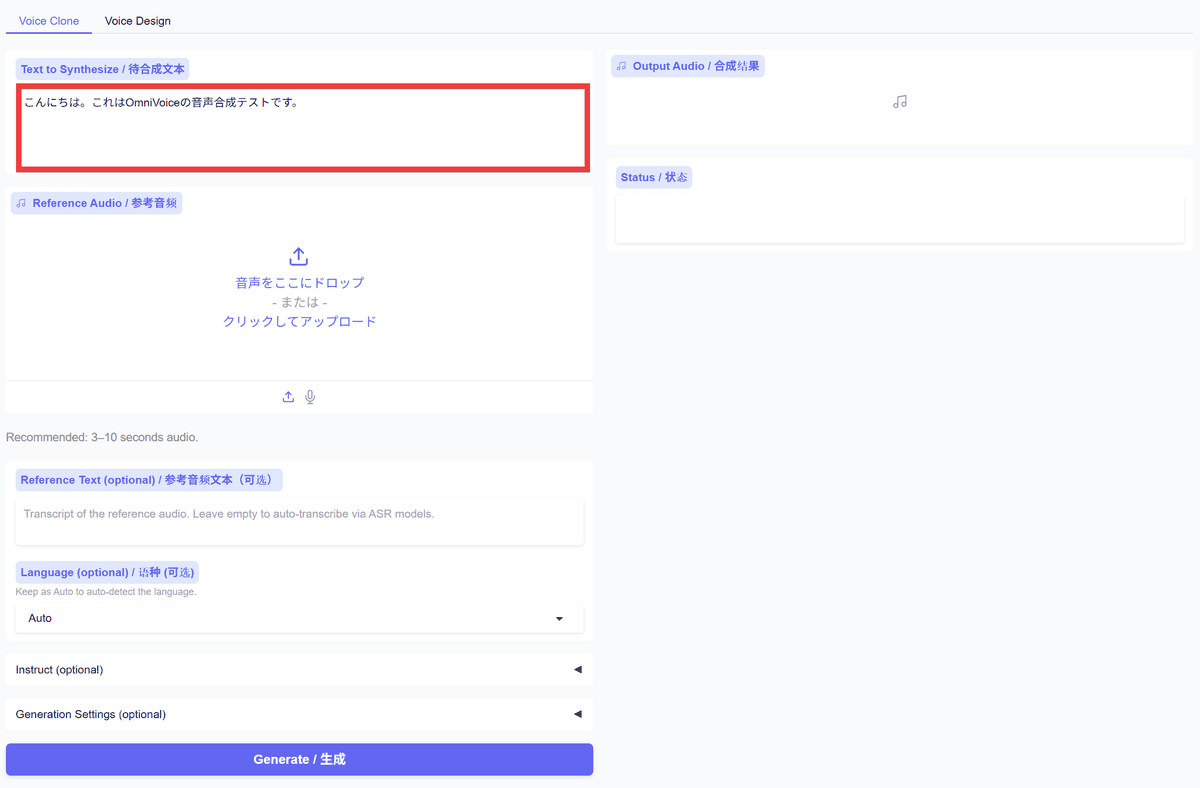
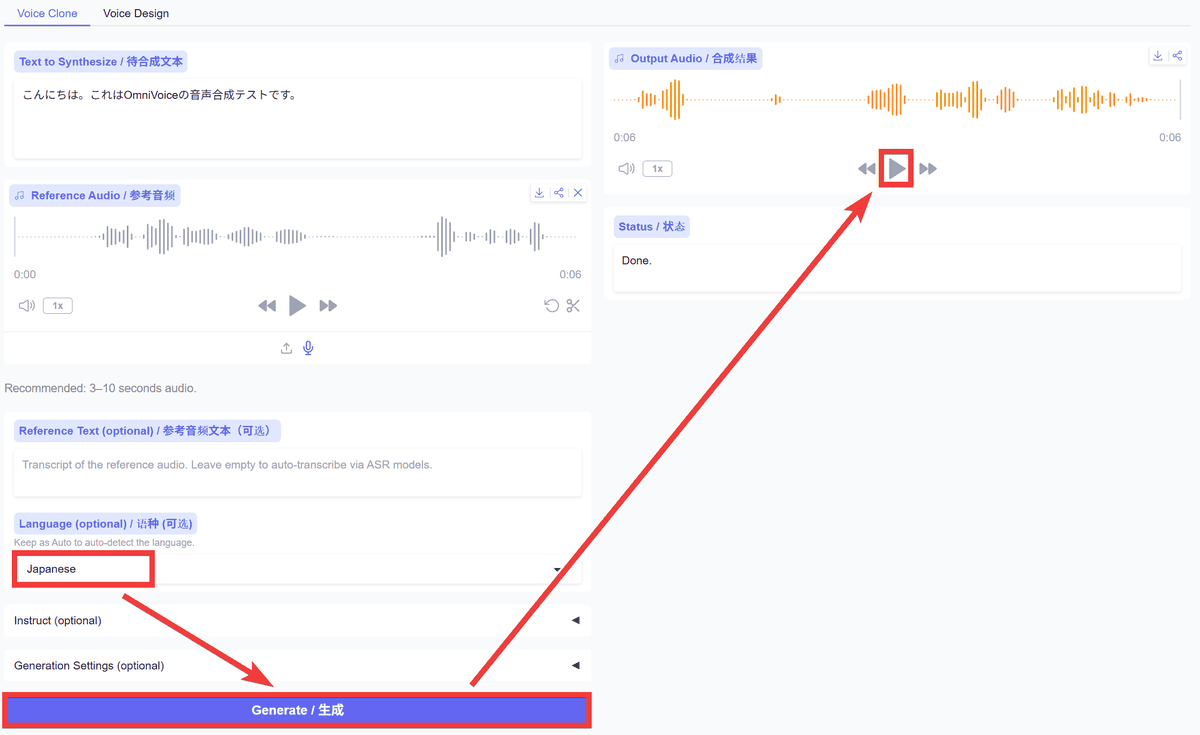
OmniVoiceを後述の方法で導入後、ブラウザで「http://127.0.0.1:8001」にアクセスしてデモツールを表示し「Text to Synthesize」に作成したい音声の文章を入力。
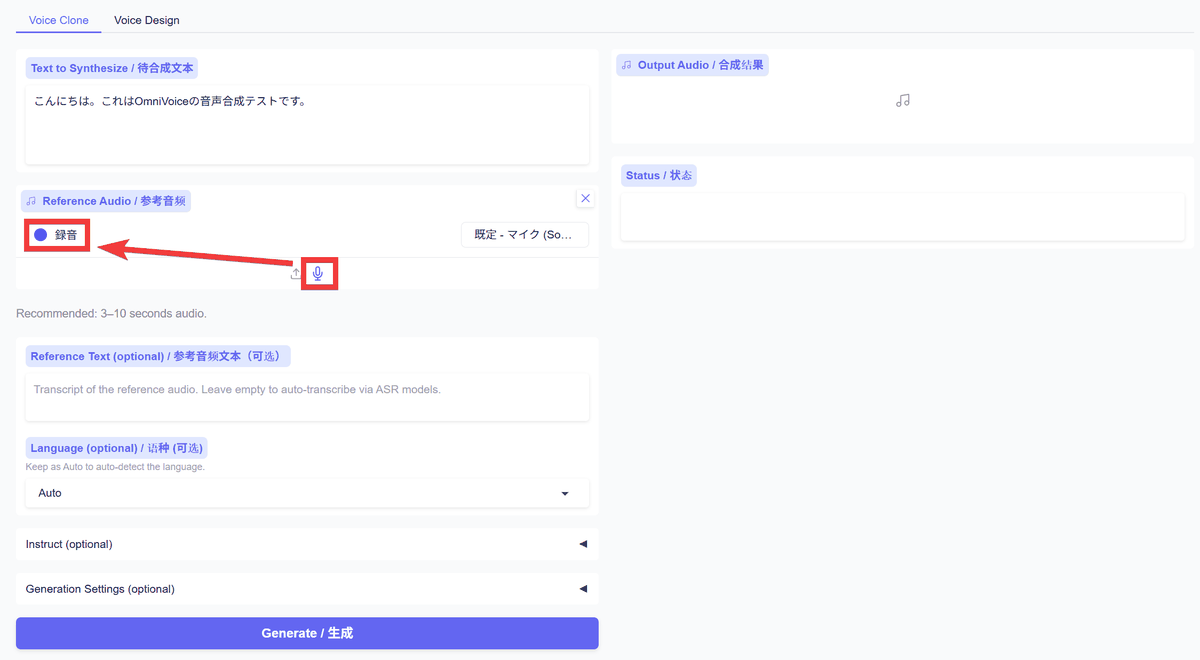
「Reference Audio」の「マイク」アイコンをクリックし「録音」ボタンをクリックして3から10秒程度の音声を入力、もしくは音声が録音されたファイルを登録します。
「Language」で「Japanese」を選び「Generate」をクリックすると、生成した音声が「Output Audio」に表示されるので「再生」ボタンをクリックして確認します。
今度は「Voice Design」に切り替えて「Gender」を「Female」、「Age」を「Young Adult」、「Pitch」を「High Pitch」に設定し「Generate」をクリックすると、参考音声なしで別の声を作成できます。
そのほか長文を自動分割して生成する機能や音声設定の保存・再利用、複数GPUによる一括処理も用意されています。
◆OmniVoiceの構築方法
今回はNVIDIAのGPUを搭載したWindows 11上で、PythonとGit for WindowsのGit Bashが利用できる環境で構築します。OmniVoice用の作業フォルダーを用意しGit Bashを起動して以下のコマンドを実行します。
py -3.11 -m venv .venv
source .venv/Scripts/activate
python -m pip install torch==2.8.0+cu128 torchaudio==2.8.0+cu128 --extra-index-url https://download.pytorch.org/whl/cu128
python -m pip install omnivoice
インストール後は以下のコマンドでローカルWeb UIを起動します。
omnivoice-demo --ip 127.0.0.1 --port 8001
起動後はブラウザで「http://127.0.0.1:8001」にアクセスしデモアプリが正常に利用できれば構築完了です。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.