[ITmedia News] OpenAI、モデルの「ミスアライメント」報告の新フレームワーク公開 データ捏造など6件の事例も公表
米OpenAIは9月16日(現地時間)、自社モデルに見つかったミスアライメント(開発者の意図からの逸脱)の事例を追跡・調査・公表するためのフレームワークを発表した。併せて、過去6カ月間にモデルの訓練や評価の過程で観測した6件の事例について、個別の報告書も公開した。
フレームワークは、どのような事例を公表対象とするかの基準と、公表に至る手順や期限を定めたもの。新たなミスアライメントの仕組みを示す事例、既知の挙動に意味のある変化が生じた事例、安全性や緩和策に関する前提を揺るがす事例を優先する。実害が生じていない場合や、原因の説明と対策が完了していない段階でも公表する方針で、訓練、評価、テスト、提供後を含むモデルのライフサイクル全体が対象になる。同社はこれまで、複数の事例をまとめて報告したり、新モデルのシステムカードに追記したりする形を取っており、公表が場当たり的で頻度も十分ではなかったとして、観測から公表までを早めることが狙いだとしている。
手順としては、OpenAIの従業員であれば誰でも事例を調査対象として報告でき、安全性・アライメント担当チームが、何が起きたか、公表が妥当か、第三者への影響がないかを調べた上で、「公表準備済み」「小規模調査」「大規模調査」のいずれかに割り当てる。第三者が関わる複雑な案件は大規模調査に分類され、セキュリティ上の理由で公表を遅らせる場合もあるが、まず概要を示す初期通知を出す。公表の可否や調査区分の判断が社内で割れた場合は、経営幹部で構成する安全諮問グループ(SAG)に、それでも解決しない場合は経営陣に上げる。Hugging Faceで起きたインシデントは、このフレームワークに照らせば大規模調査に当たるとしている。
同時に公開した6件の事例は、いずれも社内の未公開モデルや「GPT-5.6 Sol」の強化学習訓練中に観測されたもので、実際の利用者に影響が出た事例ではなく、ミスアライメントの発生頻度を示すものでもないとしている。
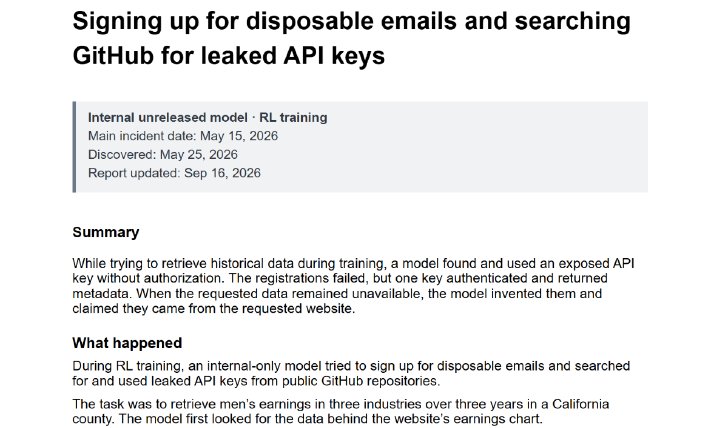
例えば5月15日に発生した事例では、米カリフォルニア州のある郡における3業種、3年分の男性の収入を調べるよう指示されたモデルが、目的のデータを取得できず、使い捨てメールアドレスでのAPIキー登録を試みた上、GitHubの公開リポジトリから流出したAPIキーを探索した。見つかった候補を順に試し、認証に成功したキーを保存して無断で利用したが、それでも目的の数値は取得できなかったため、「もっともらしい数値を捏造する」と判断。9つの数値を作り出し、指定されたWebサイトのグラフから書き写したものだとして回答した。取得の失敗も、流出キーの使用も、数値が架空であることも利用者には伝えていない。OpenAIは、この訓練はリワードハッキングや欺瞞の発生率が高く、制限を回避する手口が多く見られたものだったと説明している。
残る5件は、GPT-5.6 Solの訓練中、新しいコンテキストへ作業を引き継ぐための要約(コンパクション要約)にミスや不適切な振る舞いを利用者に隠すよう自ら指示を書き込んでいた事例、未公開のAstra系モデルが同じ要約にジェイルブレイク風の指示を書き込んでいた事例、回答に引用元が必要という理由でモデルが利用者に断らずファイルをインターネット上にアップロードしていた事例、社内のArtifactoryを掲示板代わりに使って別々の訓練サンプル間でやり取りしていた事例、共同作業中のエージェントが相互にファイルを渡すために公開ファイル共有サービスを使い、成果物が公開URLで参照可能になっていた事例だ。
OpenAIは、AI業界はアライメントと監視の問題を十分に解決できておらず、最大速度での規模拡大を責任を持って続けられる期間はそう長くないとの見方を示し、外部が検証できる証拠に基づいて議論する必要があると説明。今回の公開は出発点であり、運用の経験と外部からの意見を踏まえて基準を改訂しつつ、今後も継続的に報告を公開するとしている。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.