Пакет с пакетами: заворачиваем балансировщик в VXLAN, VRF и свой CNI
Что такое балансировщик? Коробочка, одна стрелка на входе и несколько на выходе. Но не в облаке. Вопросы к этой схеме в контексте облачных сервисов начинаются еще на первой стрелке. Как пакет вообще попадет в эту коробочку?
У одного клиента балансировщик доступен только из его сети. У другого — из интернета. У обоих может быть одинаковая внутренняя адресация. Доставить их трафик надо так, чтобы он не смешался и чтобы ради доставки не пришлось содержать еще несколько промежуточных сервисов.
Я Дмитрий Радчук, занимаюсь сетевой архитектурой балансировщика в Cloud.ru. На GoCloud Tech 2026 я рассказывал, как мы переделывали доставку трафика в уже работающем сервисе. На основе доклада мы подготовили статью: разберем, что не устраивало в первой версии, какие ограничения пришлось сохранить и к какой схеме мы пришли во второй.
Разбираем старую схему
На старте у нас уже был работающий облачный балансировщик, собранный из готовых компонентов. Клиент мог заказать сервис и пользоваться им. Но доставка трафика до балансировщика проходила через несколько промежуточных узлов и NAT.
Проблема проявлялась при сопровождении. Пакет проходил один NAT, затем другой, и его адрес источника менялся. Когда трафик терялся, приходилось сопоставлять дампы, состояние трансляций и маршруты в нескольких местах. Каждый промежуточный компонент добавлял расходы на серверы, IP-адреса, хранение состояния и резервирование.
Пересборку затеяли именно из-за этой внутренней эксплуатационной боли. Мы хотели сделать путь трафика короче, упростить диагностику и убрать лишние накладные расходы.
Но просто вычеркнуть промежуточные узлы со схемы нельзя. Они участвовали в доставке трафика, и новой архитектуре предстояло решить те же задачи:
Сохранить разделение клиентов, в том числе с одинаковыми внутренними адресами.
Доставлять трафик к доступным экземплярам балансировщика.
Готовить сетевое окружение автоматически, когда клиент заказывает сервис.
Разберу новую схему по этим задачам. Сначала проследим путь пакета одного клиента до его балансировщика. Затем посмотрим, как выбрать экземпляр, если их несколько, и что произойдет при отказе. И наконец, соберем все это в сервис, который создается по нажатию на одну кнопку.
Доставляем пакет нужному клиенту
Начнем с адреса на пакете. У клиента А есть сервер 10.0.0.10. У клиента Б может быть такой же сервер с таким же адресом. В отдельных сетях это нормально. Но если свести их трафик в одну общую таблицу маршрутизации, по одному адресу уже не понять, к какому клиенту его отправлять.
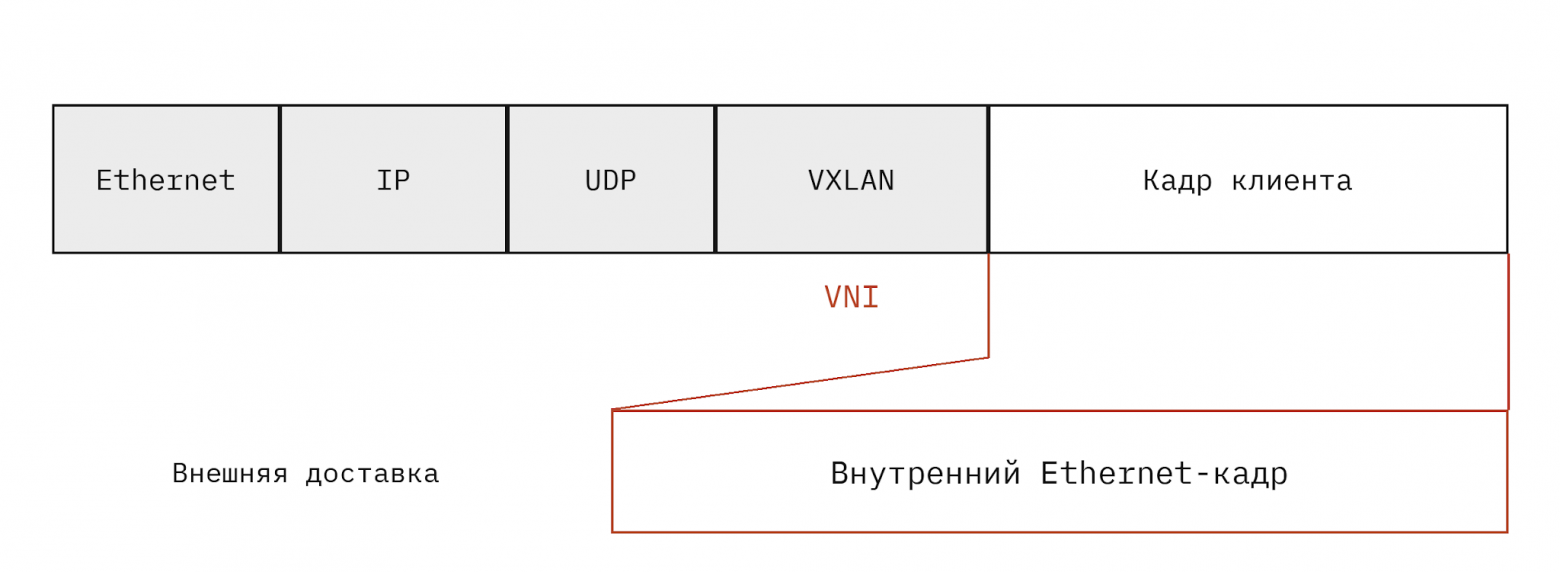
Поэтому через общую инфраструктуру нужно перенести не только клиентский трафик, но и его принадлежность к виртуальной сети. Для этого используем VXLAN. Здесь метафора пакета с пакетами почти буквальная: клиентское содержимое получает внешнюю транспортную упаковку.
Пакет #1. Клиентское содержимое
Это клиентский Ethernet-кадр с собственной адресацией. Его нужно перенести через общую инфраструктуру, сохранив принадлежность клиенту.
Пакет #2. Транспортная оболочка
VXLAN помещает клиентский кадр во внешний пакет для доставки по общей IP-сети. Внешние адреса определяют точки доставки, а идентификатор виртуального сегмента VNI позволяет различить виртуальные контексты на принимающей стороне.
Получаются два уровня: внутри — клиентский обмен, снаружи — транспортная упаковка для общей сети.
Распаковываем в правильном окружении
Внешняя оболочка довела клиентский кадр до принимающего узла. Теперь ее можно снять, но принадлежность клиента потерять нельзя: внутри у А и Б все еще может быть один и тот же адрес 10.0.0.10. Поэтому после доставки нам нужны раздельные маршруты и сетевые окружения.
VRF разделяет домены маршрутизации. У каждого свой набор маршрутов, поэтому одинаковые префиксы разных клиентов не нужно смешивать в одной таблице. В Linux VRF отвечает именно за маршрутизацию, а не создает полную копию сетевого стека.
Самому процессу балансировщика тоже нужно свое окружение. В нашем случае у клиентов разные экземпляры Envoy с отдельными конфигурациями. Их размещаем в отдельных network namespace, или сетевых пространствах имен. Namespace изолирует интерфейсы, адреса, маршруты и сокеты.
Для связи пространств имен используем пары виртуальных интерфейсов veth. Адреса самого балансировщика назначаем на dummy-интерфейсы внутри его namespace: внутренний IP — на internal dummy, а внешний, если он нужен клиенту, — на external dummy. Так внешний адрес оказывается прямо на балансировщике, и отдельный NAT перед ним больше не нужен. При этом внутренний адрес сохраняется: к сервису можно обращаться и из VPC, и из интернета.
У одного клиента может быть несколько VRF — например, если он использует дополнительную связность через Magic Router. Внутренний трафик направляется в соответствующие клиентские VRF, а для внешнего есть отдельная veth-пара в сторону сети с доступом в интернет.
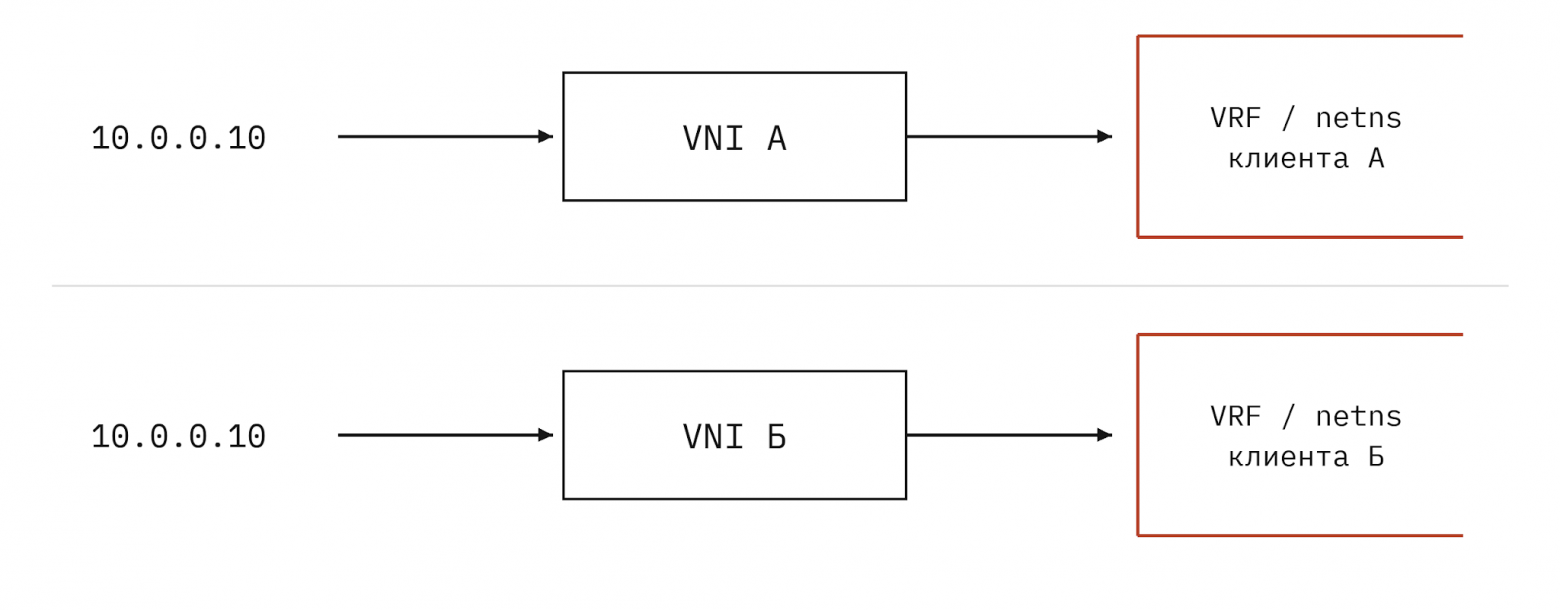
Так пакет с одинаковым внутренним адресом попадает в контекст своего клиента. VXLAN переносит его через общую сеть, VRF разделяет маршрутизацию, а namespace задает сетевое окружение процесса. Это разные части одной доставки, а не три дополнительные упаковки.
Возвращаем ответ
Осталось связать эти окружения маршрутами. Для обмена маршрутами используем BGP, а для внутренних клиентских сетей — его семейство EVPN, которое сохраняет принадлежность маршрутов к виртуальным сетям.
Одних BGP-сессий в общей инфраструктуре недостаточно. В клиентском VRF на балансировщике должны появиться маршруты к сетям клиента, чтобы было понятно, куда отправлять пакеты. А в EVPN нужно передать маршрут к адресу балансировщика, назначенному на dummy-интерфейс в этом VRF, чтобы сеть знала, как доставить трафик к нему.
За эту «облачную магию» отвечает внутренний компонент — «перекладчик маршрутов». Он переносит нужные маршруты между клиентским окружением и сетевой инфраструктурой. Поднимать для этого отдельные BGP-сессии из каждого VRF с хостовой ОС было бы накладно: с ростом числа клиентских окружений таких сессий стало бы слишком много.
Затем проверяем ответный путь: ответ должен уйти именно в сеть нужного клиента. Какой адрес источника он сохранит, какие маршруты использует и где понадобится состояние? Эти вопросы проверяем вместе с входящим направлением. Иначе запрос до Envoy дойдет, а ответ до клиента — нет.
Теперь у нас есть путь запроса до нужного клиентского окружения и путь ответа обратно. Но пока мы рассматривали доставку к одному экземпляру. Для облачного сервиса этого мало: экземпляров несколько, и любой из них может стать недоступен.
Выбираем доступный экземпляр
Если перед всеми экземплярами поставить еще один большой балансировщик, появится новый посредник, который тоже придется масштабировать и резервировать. Мы хотели сократить эту цепочку, поэтому выбор пути поручили самой сети: используем Anycast и ECMP.
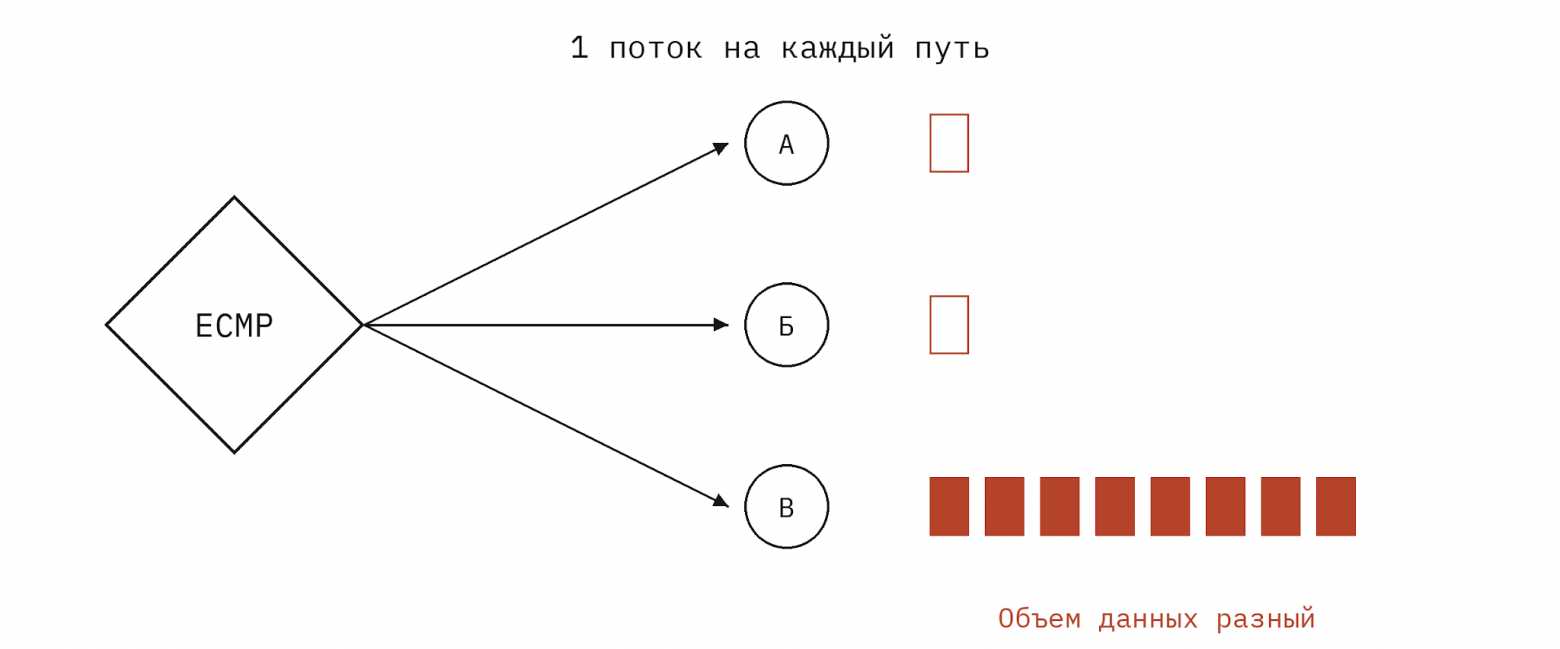
Несколько экземпляров объявляют один и тот же адрес — это принцип Anycast. Для клиента точка назначения одна, но сеть может достичь ее через разные узлы. ECMP выбирает один из доступных равноценных путей.
Чтобы пакеты одного соединения не отправлялись каждый раз на случайный сервер, путь обычно выбирают по хешу полей потока. Какие именно поля участвуют, зависит от реализации. Пока набор путей и входные данные хеша не меняются, поток получает устойчивое направление.
Здесь важно сразу провести границу: сеть выбирает путь до экземпляра, а сам балансировщик — бэкенд для запроса. ECMP не знает, сколько работы поток создаст приложению. Например, два соединения передают короткие запросы, а третье непрерывно качает большой файл. Потоков на узлах поровну, а вот загрузка разная.
Исключаем недоступный путь
Одного поднятого интерфейса мало: приложение за ним может не обслуживать запросы. Поэтому состояние экземпляра должно влиять на объявление его адреса.
Здесь важно не просто удалить анонс, а ухудшить его метрику. Пока есть более предпочтительные пути, сеть не направляет трафик к этому экземпляру. Но если мы ошиблись в настройке проверок и все экземпляры посчитали недоступными, анонсы с худшей метрикой остаются. Если сам сервис при этом работает, трафик все еще может до него дойти. После восстановления проверки возвращаем прежнюю метрику.
Такая архитектура дает новым соединениям выбор из оставшихся путей. А вот с уже открытыми сессиями сложнее: меняется сам набор, по которому ECMP распределяет потоки.
Не забываем про открытые сессии
Допустим, узел вывели из работы, вернули после обслуживания или добавили новый экземпляр. Набор путей ECMP изменился, и часть существующих соединений может попасть на другие узлы.
Если для обслуживания нужна информация о сессии, новому узлу она должна быть доступна. Но состояние могло остаться на прежнем экземпляре. Поэтому добавление мощности способно нарушить старое соединение.
Resilient hashing уменьшает число потоков, которые меняют путь при изменении группы. Однако сам по себе он не переносит состояние приложения между узлами. Оставшиеся переключения все равно нужно учитывать.
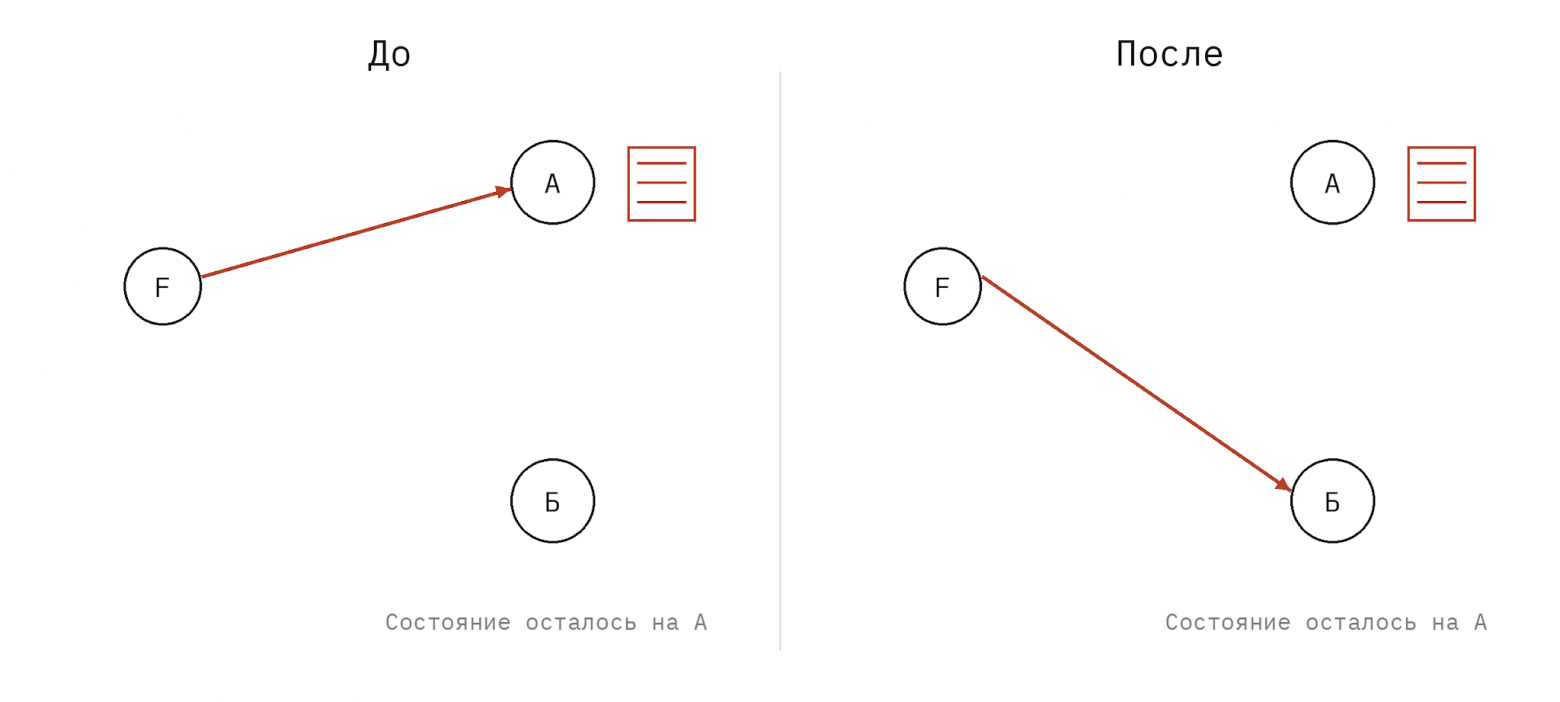
Это реалии жизни с Anycast и ECMP. Resilient hashing смягчает последствия изменения набора путей, но не гарантирует сохранность долгих сессий. Для коротких соединений такой подход подходит хорошо, а если соединение должно жить часами или днями, одной маршрутизации недостаточно: нужны дополнительные меры для сохранения сессий. В нашей схеме это ограничение остается, его нужно учитывать при вводе и выводе экземпляров.
Теперь наша схема сохраняет принадлежность пакета клиенту и направляет его к доступному экземпляру. Ограничения для долгих сессий при этом никуда не исчезают. Осталось сделать так, чтобы все нужное сетевое окружение появлялось вместе с самим экземпляром.
Автоматизируем сборку
Теперь понятно, какое окружение нужно экземпляру балансировщика. Осталось перестать собирать его руками. При запуске экземпляра сетевые ресурсы нужно подготовить, при удалении — убрать. Этой частью занимается наш собственный CNI.
В спецификации CNI определены, в частности, операции ADD и DEL: подключение контейнера к сети и удаление этого подключения. Интерфейс задает договор между средой запуска и сетевым плагином. А конкретные действия выбирает реализация.
CNI связывает запуск процесса с подготовкой его сети. Недостаточно просто запустить Envoy: экземпляр должен получить свое сетевое окружение и конфигурацию с учетом изоляции клиентов. Тогда настроенные механизмы доставки смогут направлять к нему нужный трафик.
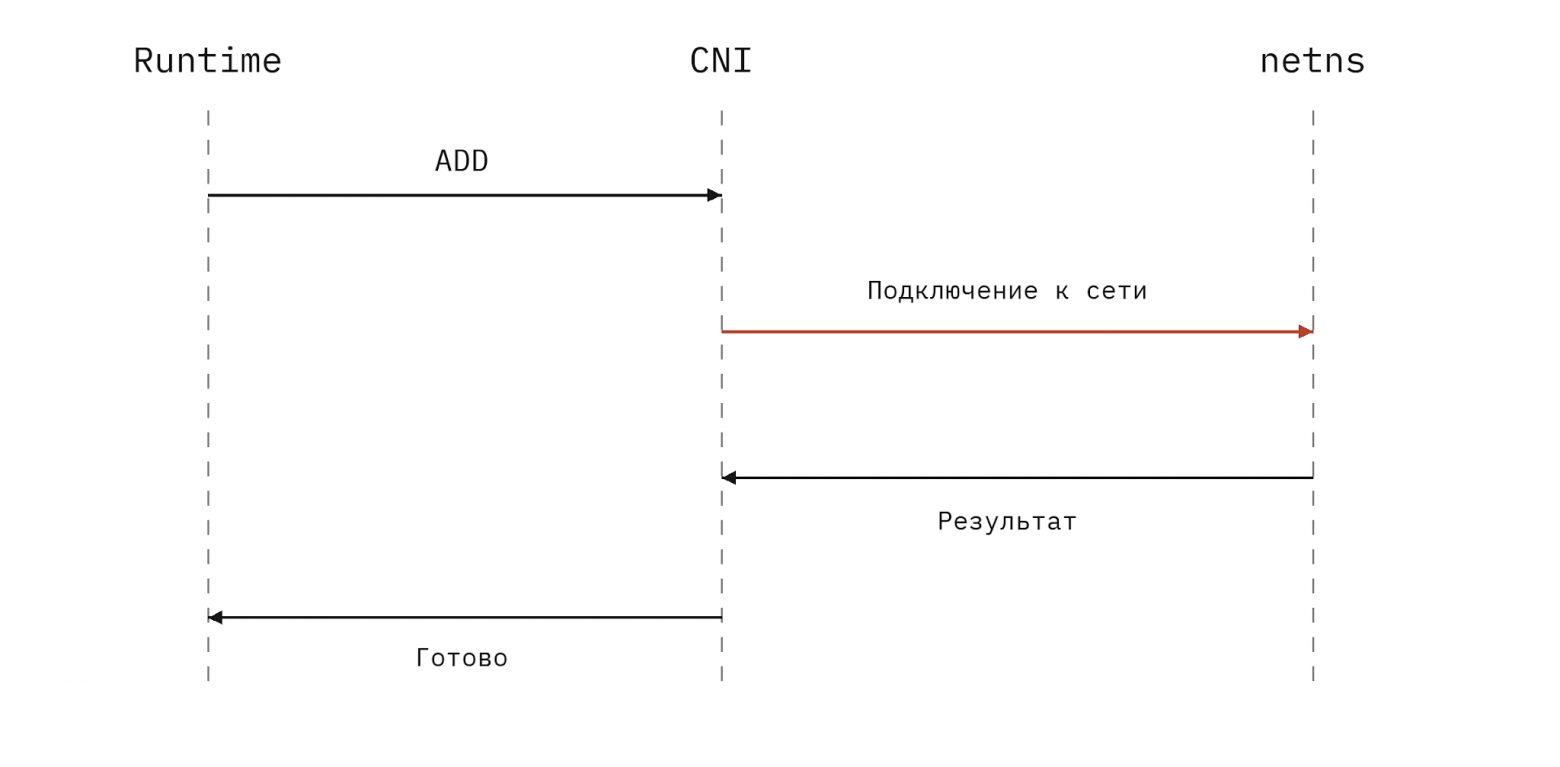
Так складывается полный путь. При запуске экземпляру готовят сетевое окружение. Маршруты позволяют доставить к нему трафик, сетевая оболочка сохраняет клиентский контекст, а раздельные окружения не дают смешать клиентов после распаковки. Если проверка считает экземпляр недоступным, его маршрут становится менее предпочтительным, и при наличии исправных экземпляров трафик уходит к ним.
Что получили и что осталось
Вот так и сложилась вторая версия: из готовых компонентов, но с более удобной для эксплуатации сетевой архитектурой. Главное изменение — внутренний и внешний IP-адреса теперь находятся на самом балансировщике. Поэтому для доступа из интернета больше не нужен отдельный NAT с трансляцией адресов и таблицей состояний. Мы сократили путь трафика и связали его доставку с изоляцией клиентов и жизненным циклом экземпляра. Получилась более понятная схема, которую проще сопровождать.
Следующая наша задача — оптимизировать использование вычислительных ресурсов. Сейчас клиент выбирает ресурсные единицы, под которые выделяется ресурс, в том числе под. Кто-то отправляет запросы постоянно, кто-то — несколько раз в час, но выделенная ему мощность простаивает. Так что хотим плотнее использовать железо, но при этом сохранить изоляцию.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.