Объединяй и властвуй: как перенести ML-эксперимент из лабораторного кластера в промышленный за 60 секунд
Всем привет! Мы команда ML-платформы Ozon. Мы строим инфраструктуру, которой ежедневно пользуются дата-сайентисты и ML-инженеры — от первых экспериментов в Jupyter до обучения моделей на больших GPU-кластерах. Наша задача заключается в предоставлении доступа к современным вычислительным технологиям через привычные инструменты и единый интерфейс платформы.
Со стороны может показаться, что формула счастья наших пользователей предельно проста: «GPU для всех, даром, и пусть никто не уйдёт обиженным». В реальности всё, конечно же, сложнее. Вычислительные ресурсы должны использоваться эффективно. При этом разные этапы рабочего процесса требуют разного оборудования и инструментов. Поэтому выполнять весь процесс на одном, пусть и сверхмощном, кластере не всегда рационально. Если же распределить этапы между несколькими кластерами, нужно обеспечить их взаимодействие, чтобы рабочий процесс выполнялся бесшовно.
Значит, нам необходим механизм, обеспечивающий эту связь. Решение, позволяющее взять пользовательский эксперимент, собрать его код и зависимости в одном кластере и воспроизвести в другом, — чтоб переход между стадиями рабочего процесса происходил в одно действие, быстро и удобно для пользователя. Как мы решили эту задачу и какие выводы сделали — в этой статье.
Мощности по потребностям
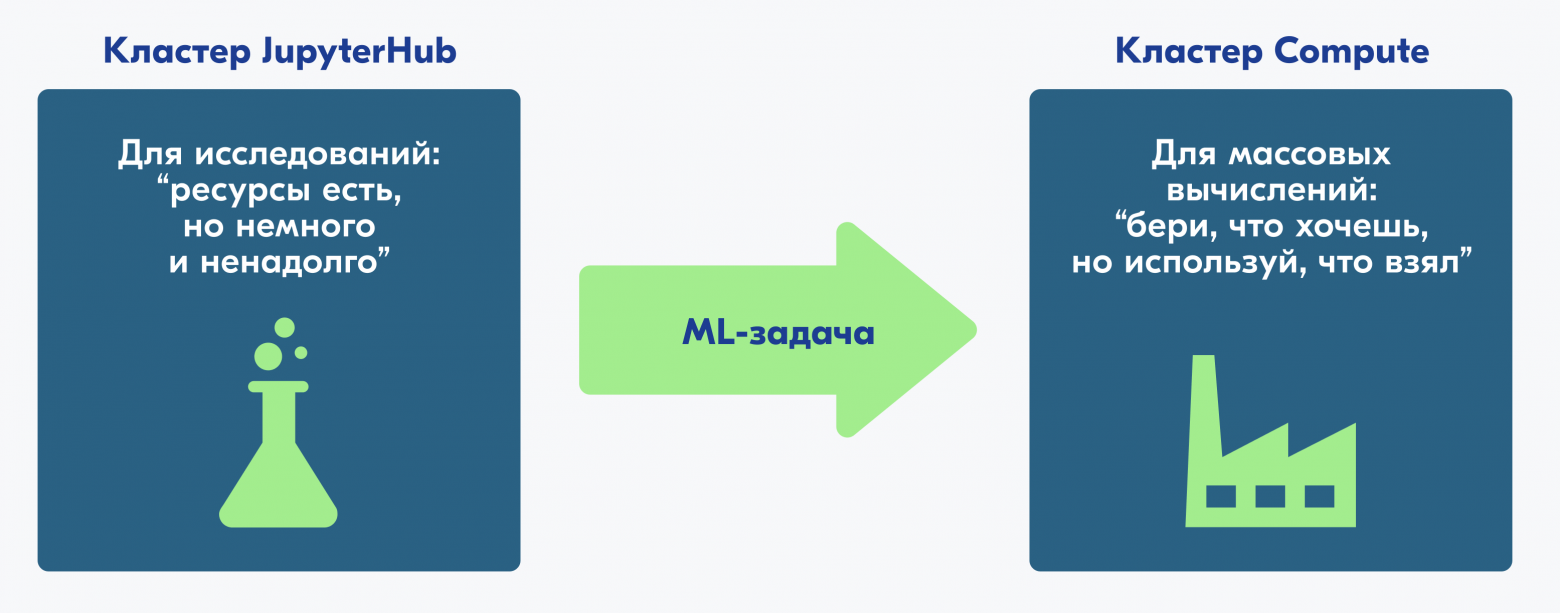
Представим типичный жизненный цикл ML-эксперимента. Сначала дата-сайентист формулирует гипотезу, готовит данные, пишет код и проверяет отдельные этапы вычислений. На этой стадии исследования и прототипирования, как правило, достаточно CPU или GPU с умеренной вычислительной производительностью и подходящей архитектурой. Работа ведётся в интерактивной сессии в кластере JupyterHub, где важны быстрый отклик, многообразие доступных инструментов и простота их применения. Кому-то удобней создавать прототип, подключаясь к JupyterHub через ssh, кому-то — через веб-интерфейс. Одни пользователи предпочитают работать в консоли, другие в jupyter-тетрадках. Ну а необходимые для прототипа библиотеки вообще меняются как перчатки.
После проверки гипотезы нужно обучить модель на полном наборе данных или провести серию масштабных вычислений. Для этого требуются более производительные GPU, иногда несколько узлов, специализированная сеть и планирование с учётом квот и загрузки оборудования. С другой стороны, прототип уже готов, его зависимости определены, и потребность во множестве инструментов для ручных манипуляций отпадает. Зато возникает необходимость автоматизации выполнения эксперимента и выделения под него вычислительных ресурсов. Высокопроизводительному оборудованию необходим качественно иной уровень управления, гибко учитывающий более сложную систему квот, гарантий и требований к утилизации. Поэтому просто добавить в кластер JupyterHub больше GPU — неэффективное решение. При ручном управлении мощности большую часть времени будут простаивать. Это всё равно что играть в шахматы экскаватором.
Для стадии масштабных вычислений мы предоставляем отдельный кластер — Compute. Здесь происходит автоматическое выполнение задач в рамках пользовательского эксперимента. Сотни мощных видеокарт, оркестрируемых ювелирным механизмом планировщика, хватает на любую ресурсоёмкую задачу. При этом утилизация запрошенных мощностей жёстко контролируется: если GPU предоставлены, но не используются, они возвращаются в пул, а задача приостанавливается.
Чтобы этот рациональный подход в управлении ресурсами был удобен для пользователей, остаётся, казалось бы, сущая мелочь: обеспечить межкластерный перенос ML-эксперимента. Но сделать это не так-то просто. Да, пользовательский код в обоих кластерах должен быть один и тот же, но это лишь малая часть того, что нужно переносить. Проблема в многочисленных и разнообразных зависимостях эксперимента, без которых код не заработает. Если срезать деревце и поместить в самую благодатную почву, вероятность, что оно приживётся, крайне мала. Потому что пересаживать нужно вместе с корнями.
Как это переносится
Наивно кажется, что достаточно скопировать .py-файлы. На практике эксперимент состоит как минимум из нескольких слоёв:
Данные и артефакты обучения: датасеты, модели, конфигурации.
Пользовательский код:
train.py,preprocessing.py, файлы jupyter-тетрадок.Пользовательские зависимости:
transformers,xformers, кастомные библиотеки.Системные зависимости: Python, PyTorch, CUDA runtime, libc.
Инфраструктура развёртывания: Kubernetes + базовые docker-образы.
Переносимость определяется тем, насколько точно мы можем воспроизвести нужные слои на целевой машине.
Слой данных и артефактов всё же вынесем за скобки. Для объектов этого слоя существует отдельная логика версионирования и хранения: датасеты и модели логируются в соответствующие сервисы и подгружаются по требованию непосредственно в эксперимент, где бы он ни выполнялся. Главное, чтобы там присутствовали инструменты для отправки и загрузки. Но это уже другие слои эксперимента.
Вообще, задача по переносу кода с окружением отнюдь не нова. Для её решения существуют универсальные инструменты — от пакетных менеджеров до docker-контейнеров.
Соответственно, мы можем перенести:
только код и список зависимостей конкретного эксперимента;
код и все зависимости эксперимента целиком (скрипты и бинарные файлы библиотек, в том числе общесистемные);
включающий всё docker-образ или снимок docker-контейнера.
Вариант со списком зависимостей наиболее прост в реализации: достаточно передать в целевой кластер файлы с кодом и условный requirements.txt. Однако скачивание и установка зависимостей на сервере в целевом кластере затратны по времени и слишком требовательны к совместимости исходной и целевой систем.
Решения на основе docker-образа гораздо более надёжные, но зато слишком тяжёлые и негибкие. Если есть небольшое изменение в коде, то приходится пересобирать образ либо создавать новый снимок контейнера.
Золотой серединой в нашем случае мог бы стать второй вариант. Делать перенос кода вместе с уже установленными пользовательскими зависимостями, но при условии некоторых доработок. Разберём его подробнее.
Почему all-inclusive не подходит
Особой популярностью в ML-среде пользуется менеджер пакетов Conda. У него есть плагин conda-pack, далеко не столь известный, но применяемый у нас в разработке. Он умеет упаковывать рабочий код со всеми зависимостями, в том числе бинарными, в архив, и получается практически полностью самодостаточная сборка. Преимущество тут очевидны: чем меньше мы предполагаем о целевом окружении, тем выше автономность и воспроизводимость. При этом по размеру такой архив всяко будет меньше docker-образа, включающего то же самое плюс ни много ни мало базовый слой операционной системы.
Да, принцип all-inclusive в conda-pack действительно решает проблему переносимости, но есть у него и негативные стороны.
Во-первых, сборка архива с Python, PyTorch, transformers и CUDA — это долго, может занимать час и больше. Во-вторых, архив всё равно получается очень тяжёлым, на десятки гигабайтов. Их и хранить-то проблематично, не говоря уже о физическом перемещении. Учитывая, что при экспериментировании требуется множество вариантов таких сборок, даже такой гибкий способ переноса оборачивается мучительной тратой времени и нервов специалиста. Такова плата за самодостаточность.
Кажется, что оптимального решения не найти. Но мы пока что рассматривали общее пространство решений. Что, если сузить его до частного и ограничиться поиском локального оптимума?
Что даёт единая экосистема
Ещё раз обратим внимание на среду выполнения эксперимента. Прототип алгоритма обучения или обработки данных создаётся в кластере JupyterHub. Это фактически лаборатория, вычислительные ресурсы которой представлены целым зоопарком видеокарт различных типов и характеристик, но весьма ограничены количественно. Запуск на промышленных мощностях осуществляется в нашем же более продвинутом Compute-кластере. Оба кластера используют docker-образы из общего хаба. Всё это составляет единую экосистему. Принцип самодостаточности, на котором основан тот же conda-pack, здесь оказывается избыточным: если целевая среда выполнения нам заранее известна и контролируется платформой, зачем переносить то, что в ней уже есть?
Вместо того чтобы собирать очередной самодостаточный архив, можно переносить только специфические для конкретного эксперимента зависимости, а системные библиотеки, Python, PyTorch и CUDA предоставлять из заранее подготовленного docker-образа. Это позволит избежать многократного копирования одних и тех же тяжёлых компонентов и существенно сократить время подготовки и передачи эксперимента.
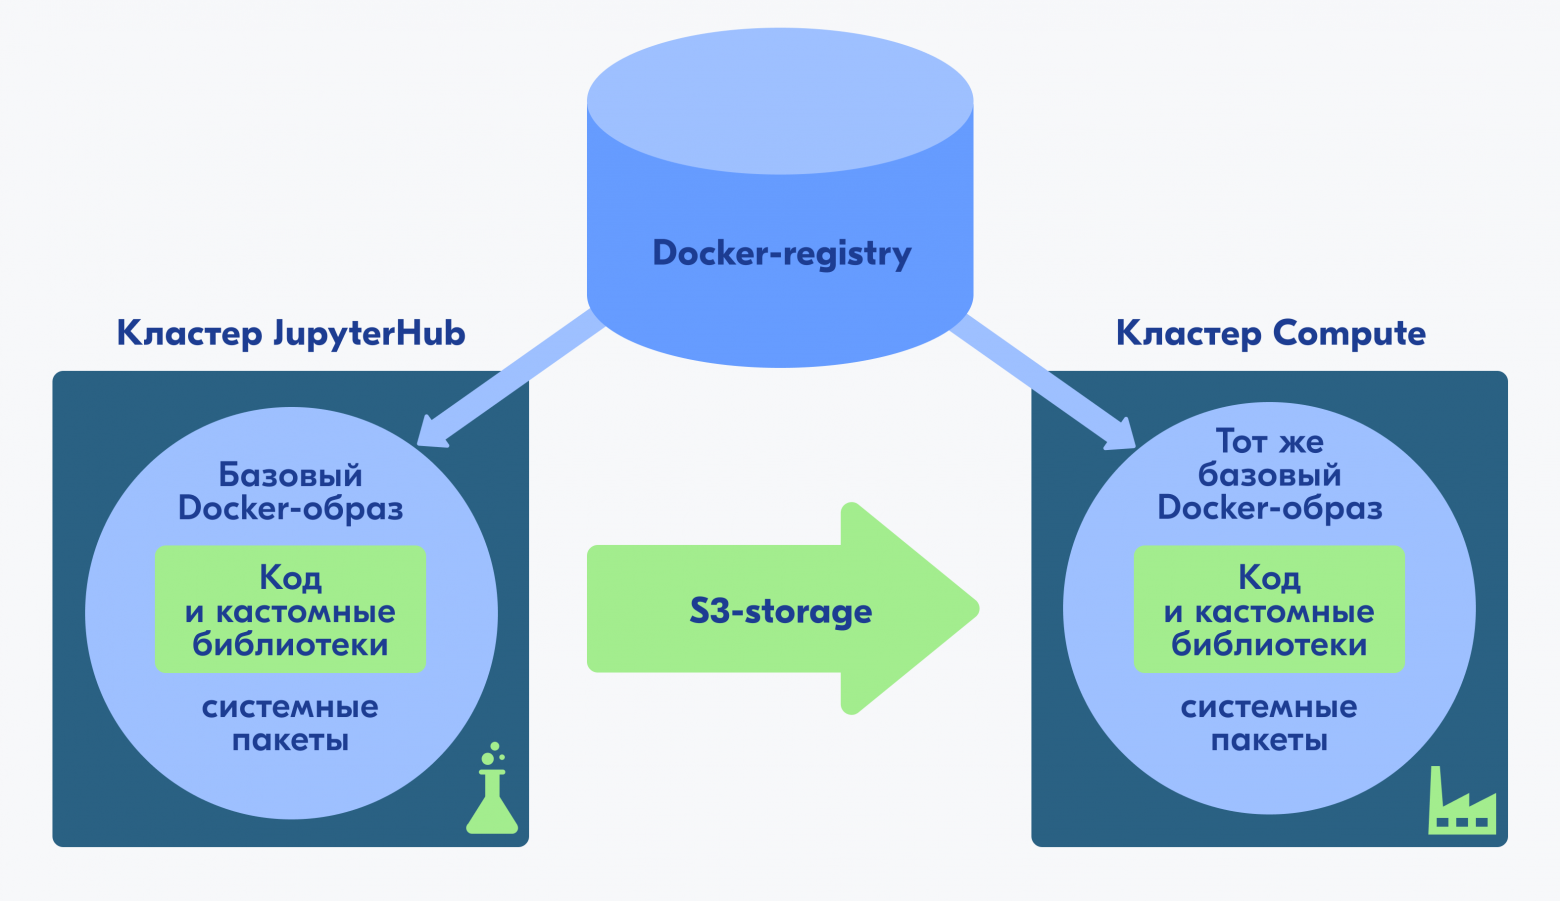
То есть в docker-образ мы включаем следующие зависимости:
Python;
PyTorch;
CUDA runtime;
системные библиотеки;
стандартный набор ML-фреймворков;
платформенные компоненты и инструменты.
Разумеется, для разных комбинаций поддерживаемых версий Python, PyTorch и CUDA понадобятся разные образы. Однако их набор ограничен и контролируется платформой, поэтому такие образы удобно централизованно хранить, поддерживать и своевременно обновлять. Так платформа обеспечивает эксперимент наиболее тяжёлыми системными зависимостями в обоих кластерах.
Но ещё остаются кастомные зависимости. Если пользователь устанавливает библиотеки для разных экспериментов в одно системное окружение, определить, что переносить в целевой кластер для конкретного эксперимента, непросто. К счастью, существует best practice: заводить для каждого эксперимента отдельное виртуальное окружение. Это существенно упрощает работу, в том числе и самому пользователю. Причём копировать в это окружение системные библиотеки не требуется, они и так будут в нём доступны, если окружение создано с опцией system-site-packages. Теперь определить переносимые компоненты не составит труда: это пользовательский код и само виртуальное окружение.
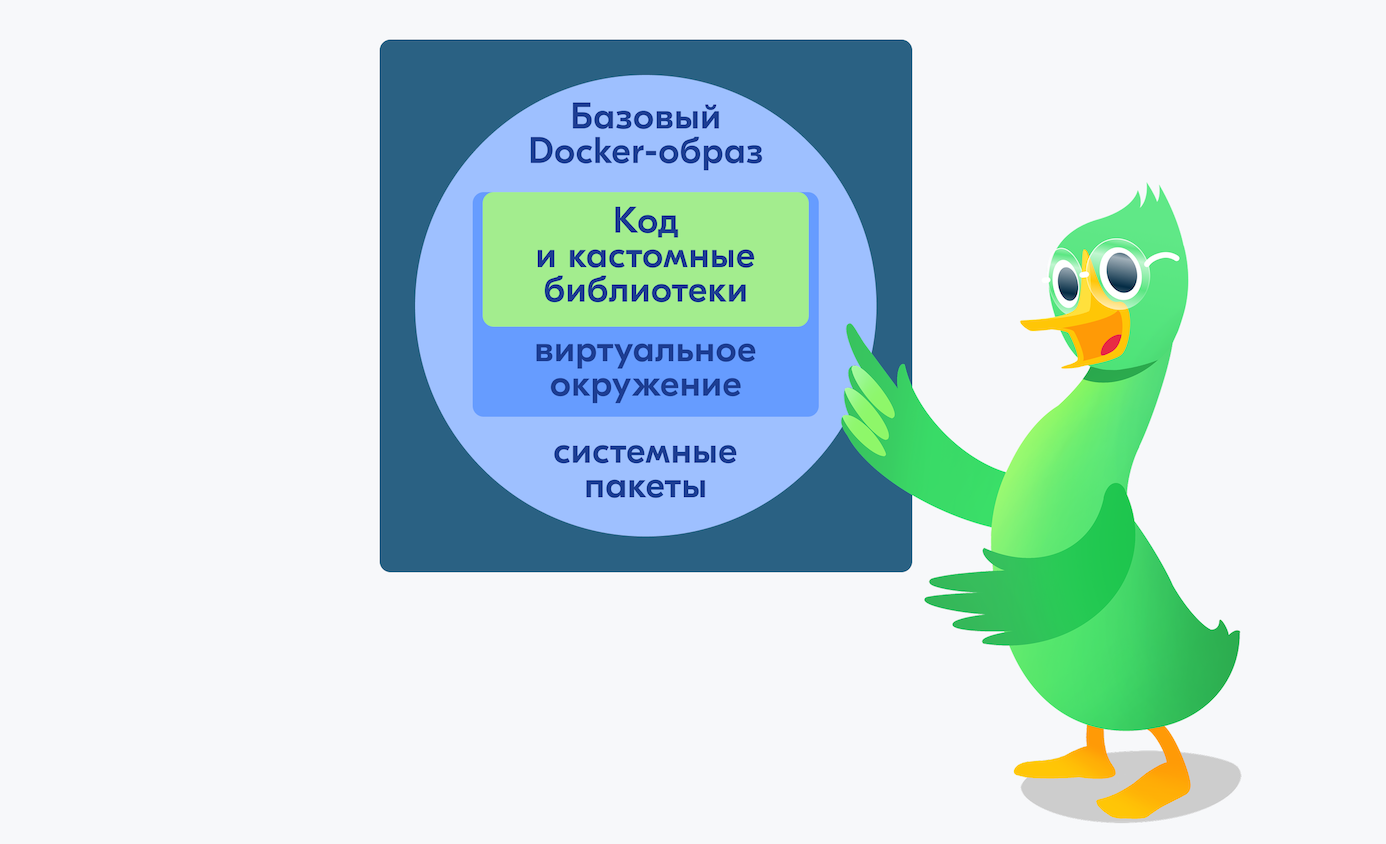
Предположим, структура файлов пользователя выглядит так:
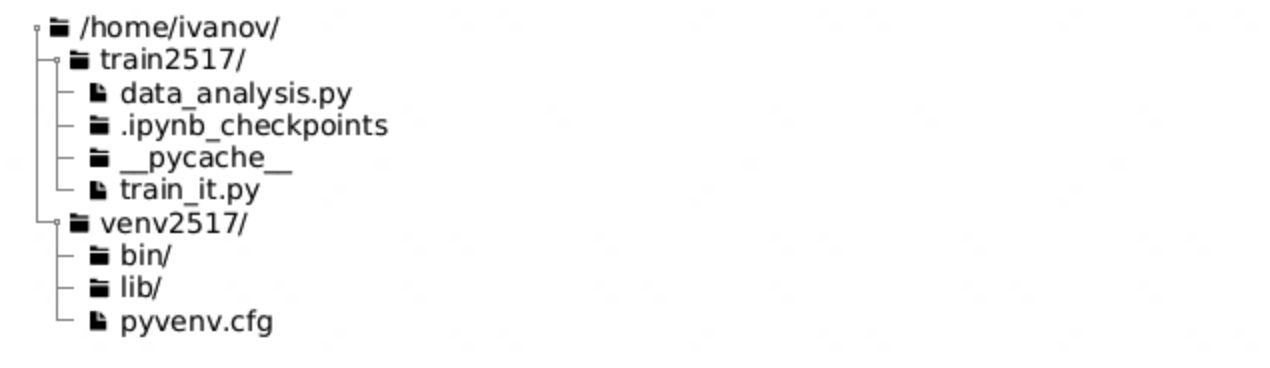
Мы создаём виртуальное окружение с помощью стандартного модуля venv, включив наследование системных пакетов:
python -m venv --system-site-packages /home/ivanov/venv2517Параметр system-site-packages, определяющий доступность системных пакетов в виртуальном окружении, сохраняется в файле pyvenv.cfg. Этот файл находится в корневой директории окружения и, соответственно, тоже подлежит переносу. То есть мы переносим не только пользовательские библиотеки, но и настройку, благодаря которой эксперимент в целевом кластере тоже сможет использовать системные пакеты. При этом сами эти пакеты никуда не переносятся. Они уже будут в целевом кластере в docker-образе, на котором запускается эксперимент.
Вернёмся к инструменту для упаковки эксперимента. Изначально мы рассматривали conda-pack. Подкупала как раз его способность к созданию автономной сборки. Она позволяла не задумываться о закономерностях в окружениях экспериментов: просто берём все их зависимости, в том числе системные, и складываем в переносимый архив. Но осознав негативные стороны данного решения и учтя возможности единой экосистемы по переиспользованию общих библиотек, файлов, образов, мы пришли к альтернативному подходу.
Разработчики conda-pack создали ещё один инструмент — venv-pack, уже не столь категоричный в отношении принципа самодостаточности. Он упаковывает в архив только то, что лежит в директории виртуального окружения. И это была именно та идея, к которой мы шли. Да, при таком подходе переносимый эксперимент не выполнится в целевом кластере, если там не окажется необходимых системных пакетов. Но мы уже решили эту проблему на уровне используемых docker-образов. В общем, бери и используй.
Правда, venv-pack только собирает архив. А нам-то нужно ещё и передать этот архив в другой кластер, там распаковать, запустить... Нужна авторизация, логирование, трекинг использования инструмента. Сама упаковка в этом пайплайне слишком простой и легко реализуемый этап, чтоб тащить в него лишнюю зависимость. Поэтому мы создали собственный инструмент — j2c (jh-to-compute), целиком реализующий пайплайн межкластерного переноса эксперимента. За основу взяли ту же идею: упаковывать только содержимое виртуального окружения, а не весь системный набор зависимостей.
Своё решение
j2c — это python-библиотека с поддержкой CLI на основе Click. Она, как платформенный компонент, входит в набор системных пакетов. Её задача — связать исследовательскую среду JupyterHub с вычислительными мощностями Compute и автоматизировать перенос эксперимента между этими кластерами.
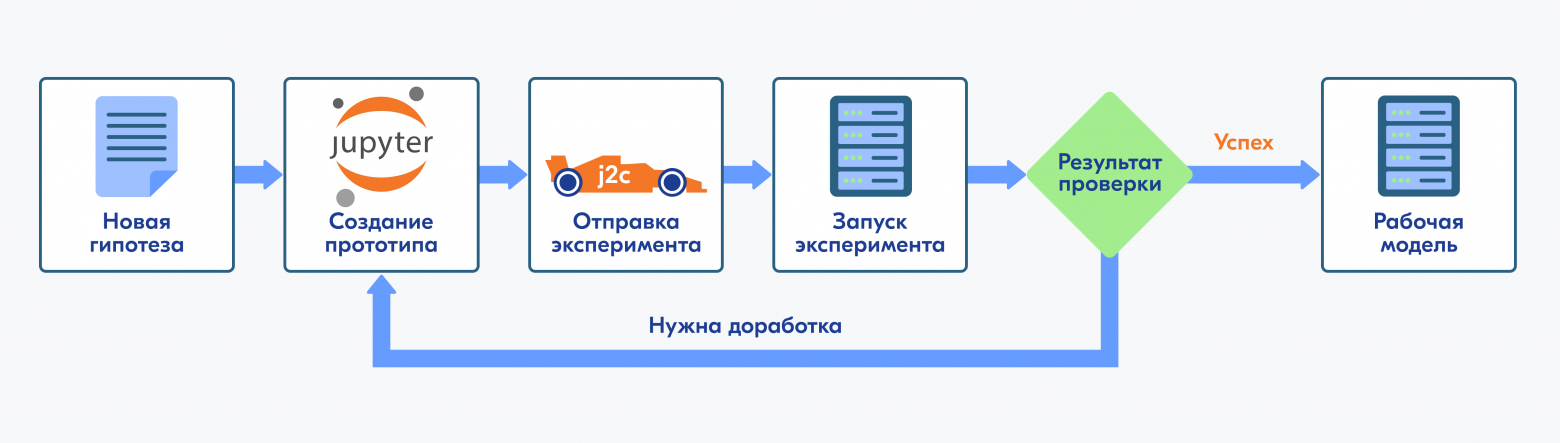
Как только пользователь подготовил рабочий прототип в JupyterHub, он может отправить эксперимент в Compute всего одной командой — j2c pack. Она запускает многоэтапный пайплайн от упаковки кода и виртуального окружения до получения результатов выполнения эксперимента в целевом кластере. Например, для проекта, структура которого приведена выше, пользователю достаточно ввести команду:
j2c pack --code-path /home/ivanov/train2517 \
         --call-path train_it.py \
         --venv-path /home/ivanov/venv2517
Здесь перечислены только основные параметры команды:
--code-path — директория с кодом эксперимента;
--call-path — исполняемый скрипт, точка входа в эксперимент;
--venv-path — путь к виртуальному окружению.
Помимо них, команда позволяет задать параметры для отдельных этапов пайплайна: степень сжатия архива, пути и настройки доступа для закрытого объектного хранилища, конфигурацию ресурсов целевого сервера и т. д. Если параметров много, их можно вынести в YAML-файл.
Сам пайплайн межкластерного переноса эксперимента выглядит так:
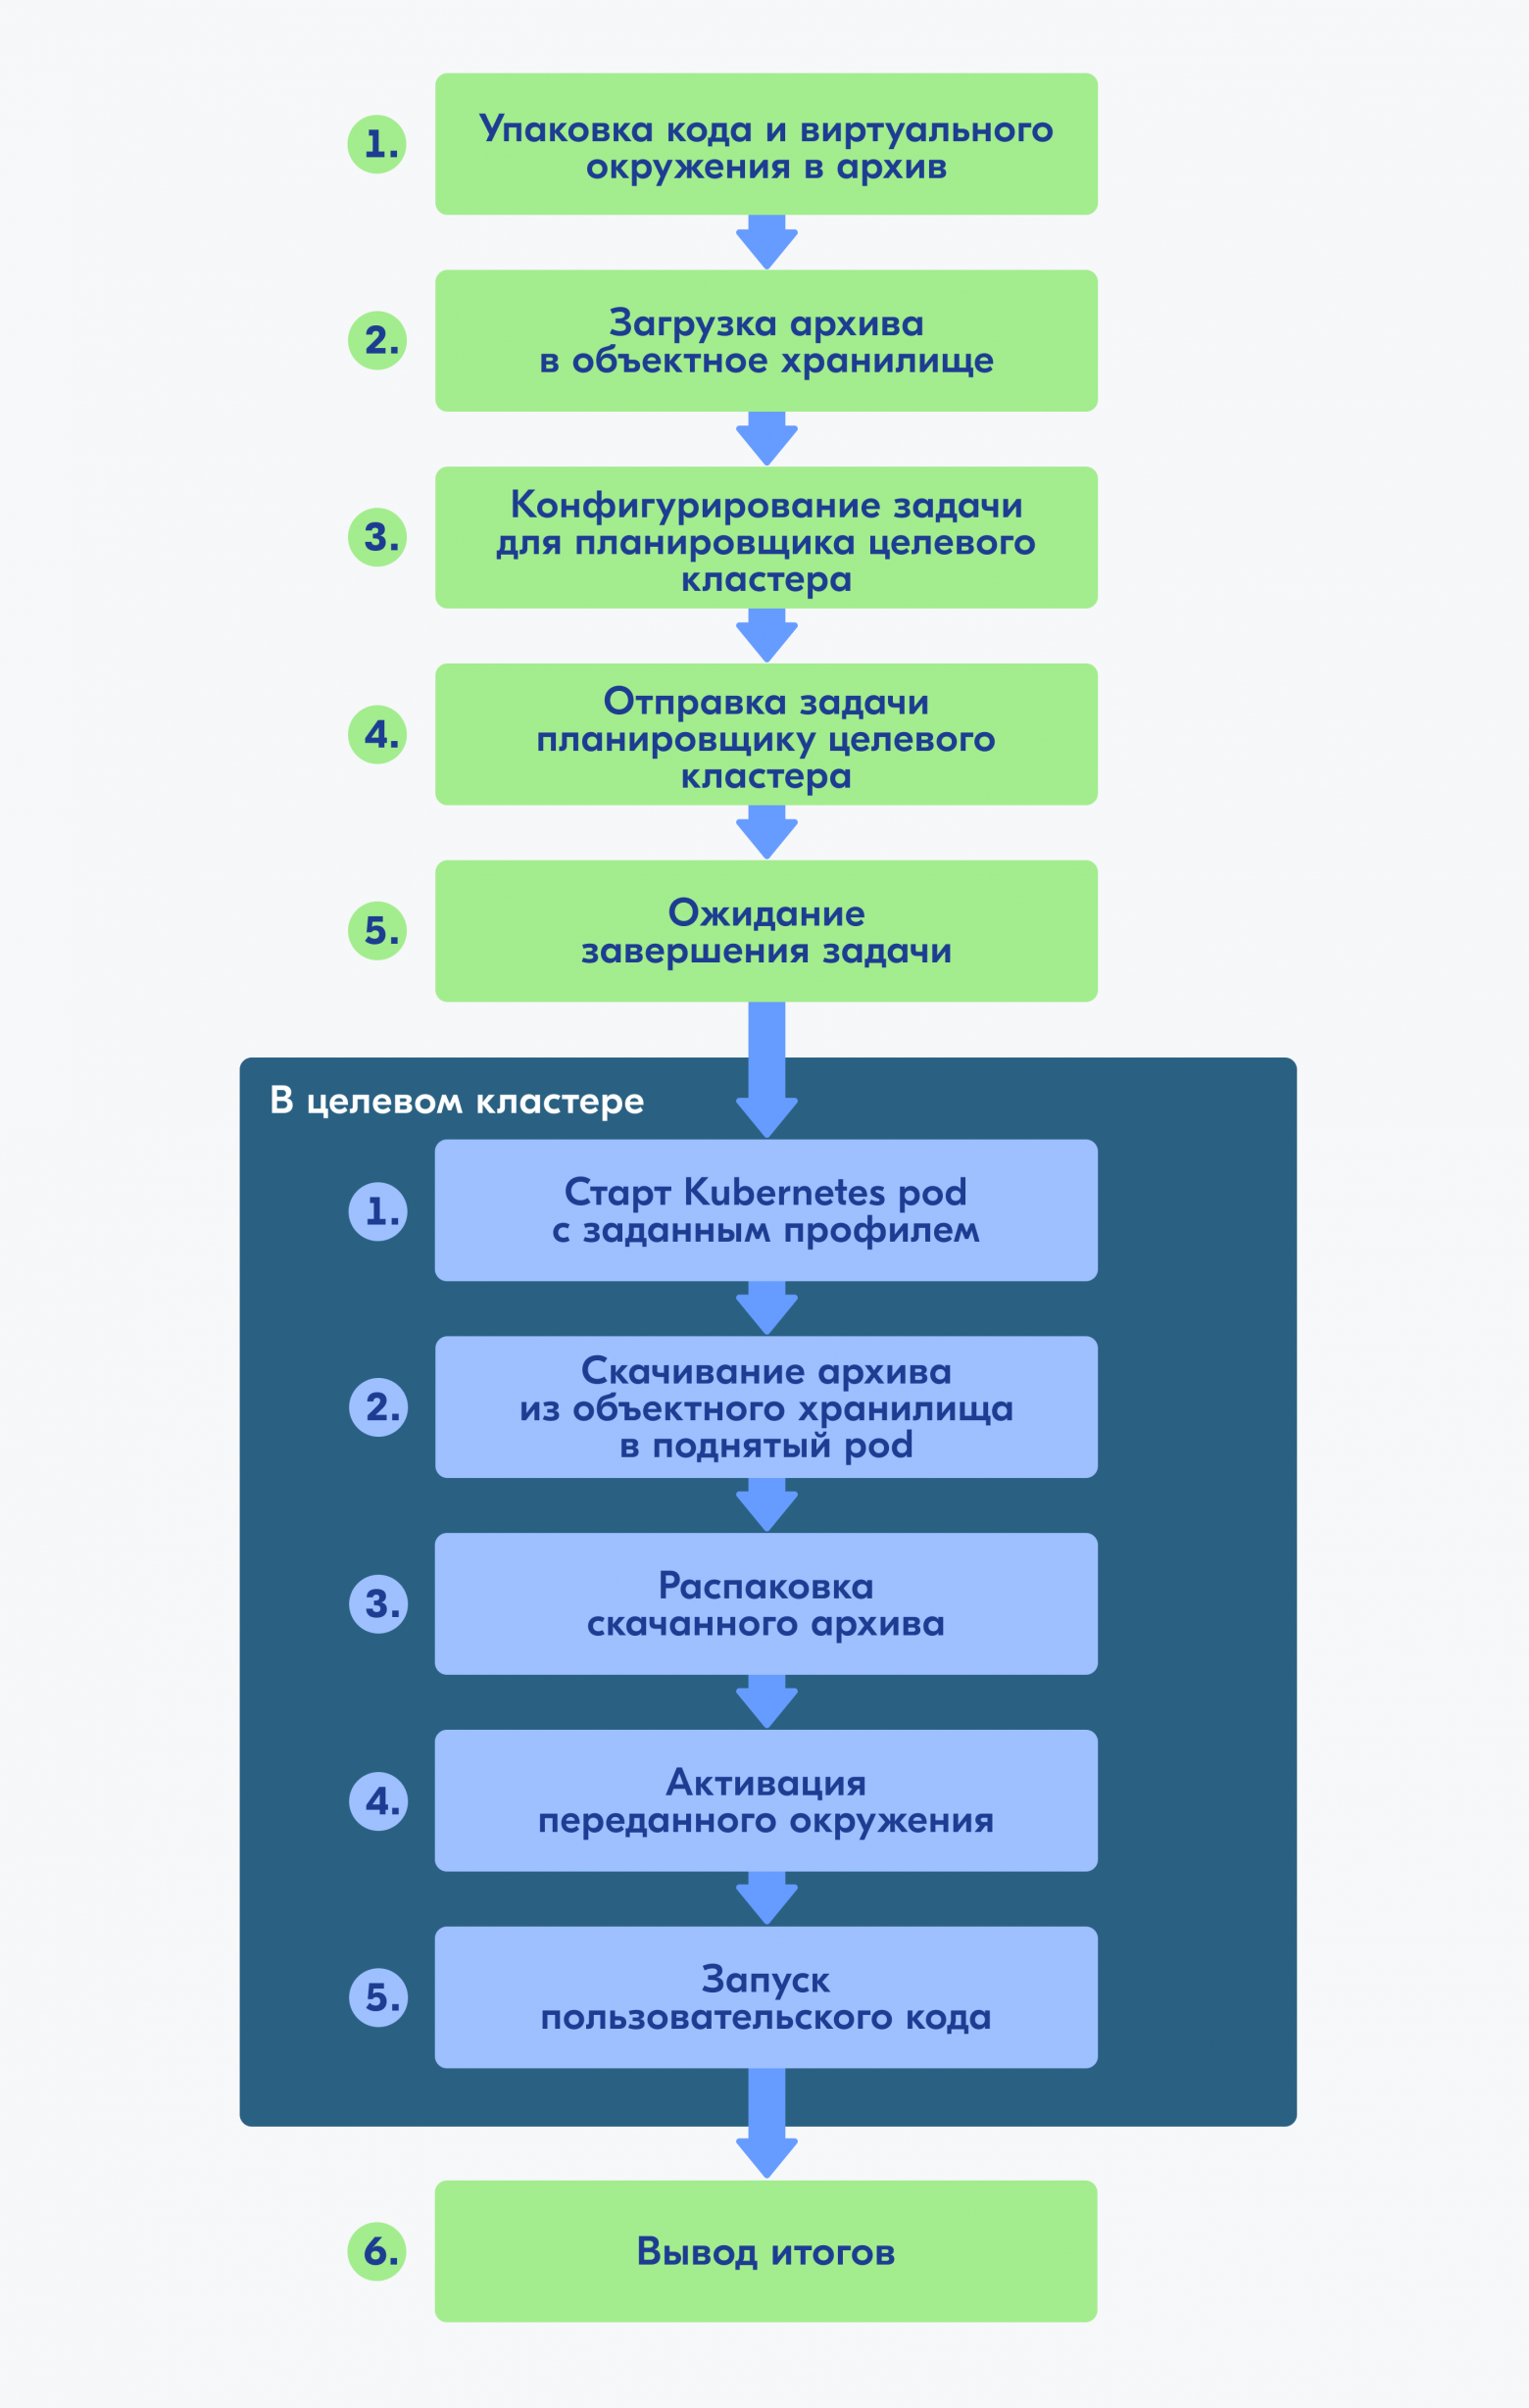
Пройдёмся по отдельным его этапам, отметив для каждого нюансы реализации.
Этап 1. Упаковка кода и виртуального окружения в архив
На первом этапе j2с pack собирает пользовательский слой эксперимента: код и виртуальное окружение.
Архив для проекта из ранее приведённого примера будет выглядеть так:
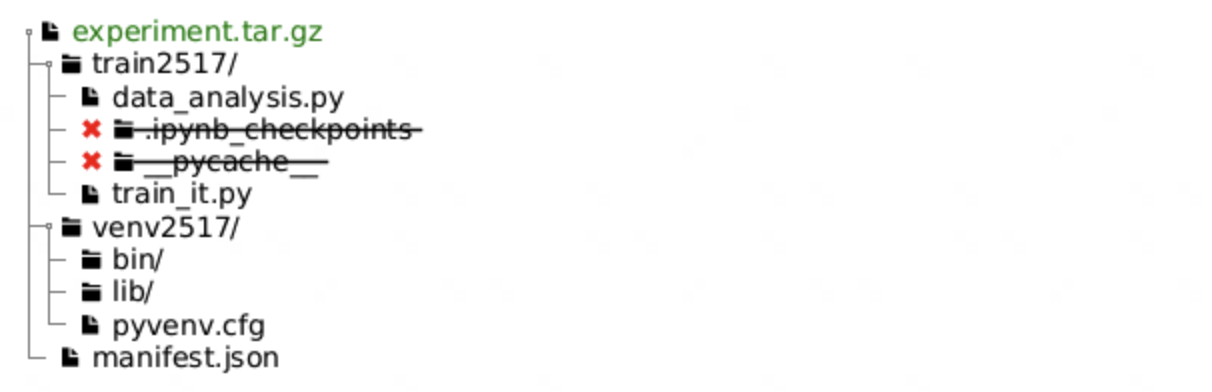
Файл manifest.json содержит информацию о путях внутри архива: к рабочей директории, к виртуальному окружению и к исполняемому скрипту как точке входа в эксперимент.
Этап сборки сам по себе простой, но без учёта ряда нюансов может испортить всё впечатление об инструменте:
Если не исключать лишние директории и файлы (__pycache__, .git, .ipynb_checkpoints и т. д.), архив может неоправданно разрастись, что негативно скажется на последующих этапах.
Необходимо учесть, что директория виртуального окружения зачастую вложена в рабочую директорию, и избежать двойной записи этого наиболее тяжёлого компонента проекта.
Степень сжатия архива должна определяться разумным компромиссом между желаемой скоростью сборки и итоговым размером, но пользователю также следует предоставить возможность настройки этого важного параметра.
Этап 2. Загрузка архива в объектное хранилище
После сборки архив отправляется в объектное хранилище. Оно общее на всю экосистему и доступно как в исходном, так и в целевом кластере. Поэтому задача j2c pack здесь сводится лишь к применению настроек доступа и вызову этого клиента. А основную работу на данном этапе выполняет s3-клиент. Отметим здесь важность объектного хранилища именно как промежуточной точки передачи архива: последний становится независимым от исходного кластера и может быть использован многократно без необходимости повторной сборки и загрузки.
Этап 3. Конфигурирование задачи для планировщика целевого кластера
За запуск задач в целевом Compute-кластере отвечает сервис планировщика. На вход ему должна быть передана конфигурация в JSON-формате, в которой необходимо указать docker-образ, запрашиваемые ресурсы и исполняемую команду с аргументами. Соответственно, на третьем этапе j2c pack эта конфигурация и готовится.
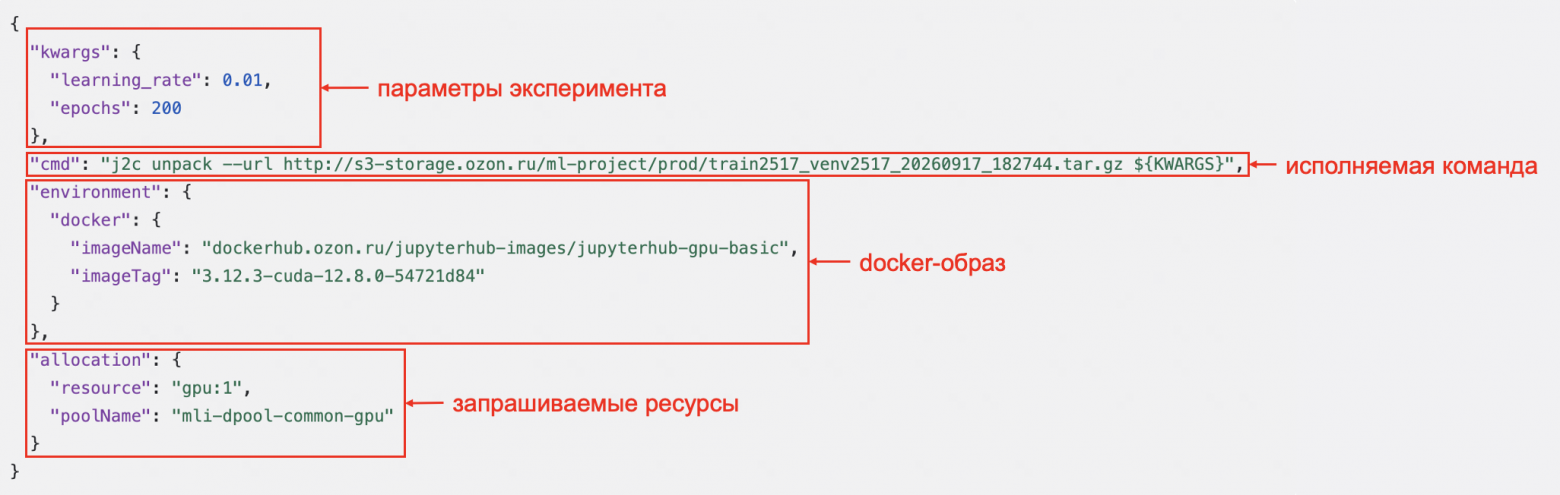
Исполняемая команда всегда j2c unpack, обратная команде j2c pack. Её мы рассмотрим на следующем этапе. На вход ей передаётся путь к архиву в объектном хранилище и аргументы для исполняемого скрипта. Эти аргументы, а также запрашиваемые ресурсы задаются самим пользователем через дополнительные параметры j2c pack. Docker-образ по умолчанию берётся такой же, как и в исходном кластере JupyterHub. Но пользователь при желании может указать любой из списка доступных.
Этап 4. Отправка задачи планировщику целевого кластера
На данном этапе j2c pack вызывает API-метод планировщика для отправки задачи, передавая ему подготовленную ранее конфигурацию. Планировщик поднимает в Kubernetes pod с заданным docker-образом на запрошенных ресурсах. В целевом контейнере выполняется команда j2c unpack. Что она делает:
скачивает из объектного хранилища переданный в качестве параметра архив;
распаковывает этот архив;
активирует виртуальное окружение, если оно передано, иначе используется системное;
вызывает исполняемый скрипт, передавая ему пользовательские параметры.
Да, j2c unpack тоже часть библиотеки j2c и потому гарантированно доступна для вызова в целевом контейнере.
Впрочем, j2c pack пока не знает, что происходит с отправленной ей задачей, так как ответ планировщика ограничивается идентификатором задачи (job_id).
Этап 5. Ожидание завершения задачи
Чтобы отслеживать состояние задачи и логи эксперимента, j2c pack опрашивает сервис планировщика по job_id через соответствующие API-методы в режиме поллинга. Пользователь видит ход выполнения эксперимента в реальном времени. Здесь важны две возможности:
Пользователь может запустить j2c pack и без ожидания: команда завершится сразу после 4-го этапа, но будет выведена ссылка на задачу в планировщике. По указанной ссылке пользователь сможет проверить состояние задачи, когда посчитает нужным.
Пользователь может сам завершить j2c pack после 4-го этапа, и это не повлияет на выполнение задачи. Для принудительной остановки задачи пользователю доступна отдельная команда.
Этап 6. Вывод итогов
Когда статус задачи меняется на терминальный (успешный или неуспешный), j2c pack получает через API планировщика ссылки на итоговые артефакты эксперимента: модели, датасеты, метрики. Вся эта информация выводится в лог команды. На этом команда j2c pack завершает свою работу.
Это надо отметить
Инструмент, неустойчивый к сбоям? — это плохой инструмент. Поэтому важнейшая деталь, предусмотренная в j2c pack, — наличие идемпотентности и кеширования каждого этапа. Если выполнение операции прервётся по непредвиденным причинам, достаточно перезапустить команду, и операция продолжится с последнего незавершённого этапа. Архив не придётся заново собирать и загружать в S3-хранилище. Можно запустить задачу и переключиться на работу над другим экспериментом в том же окне, при необходимости проверяя состояние задачи повторными вызовами j2c pack. Однако если пользователь поменял параметры команды для какого-либо из этапов, то этот и все последующие этапы будут выполняться заново.
Для удобства пользователя и отладки вся информация о работе команды и ходе выполнения эксперимента выводится в реальном времени:
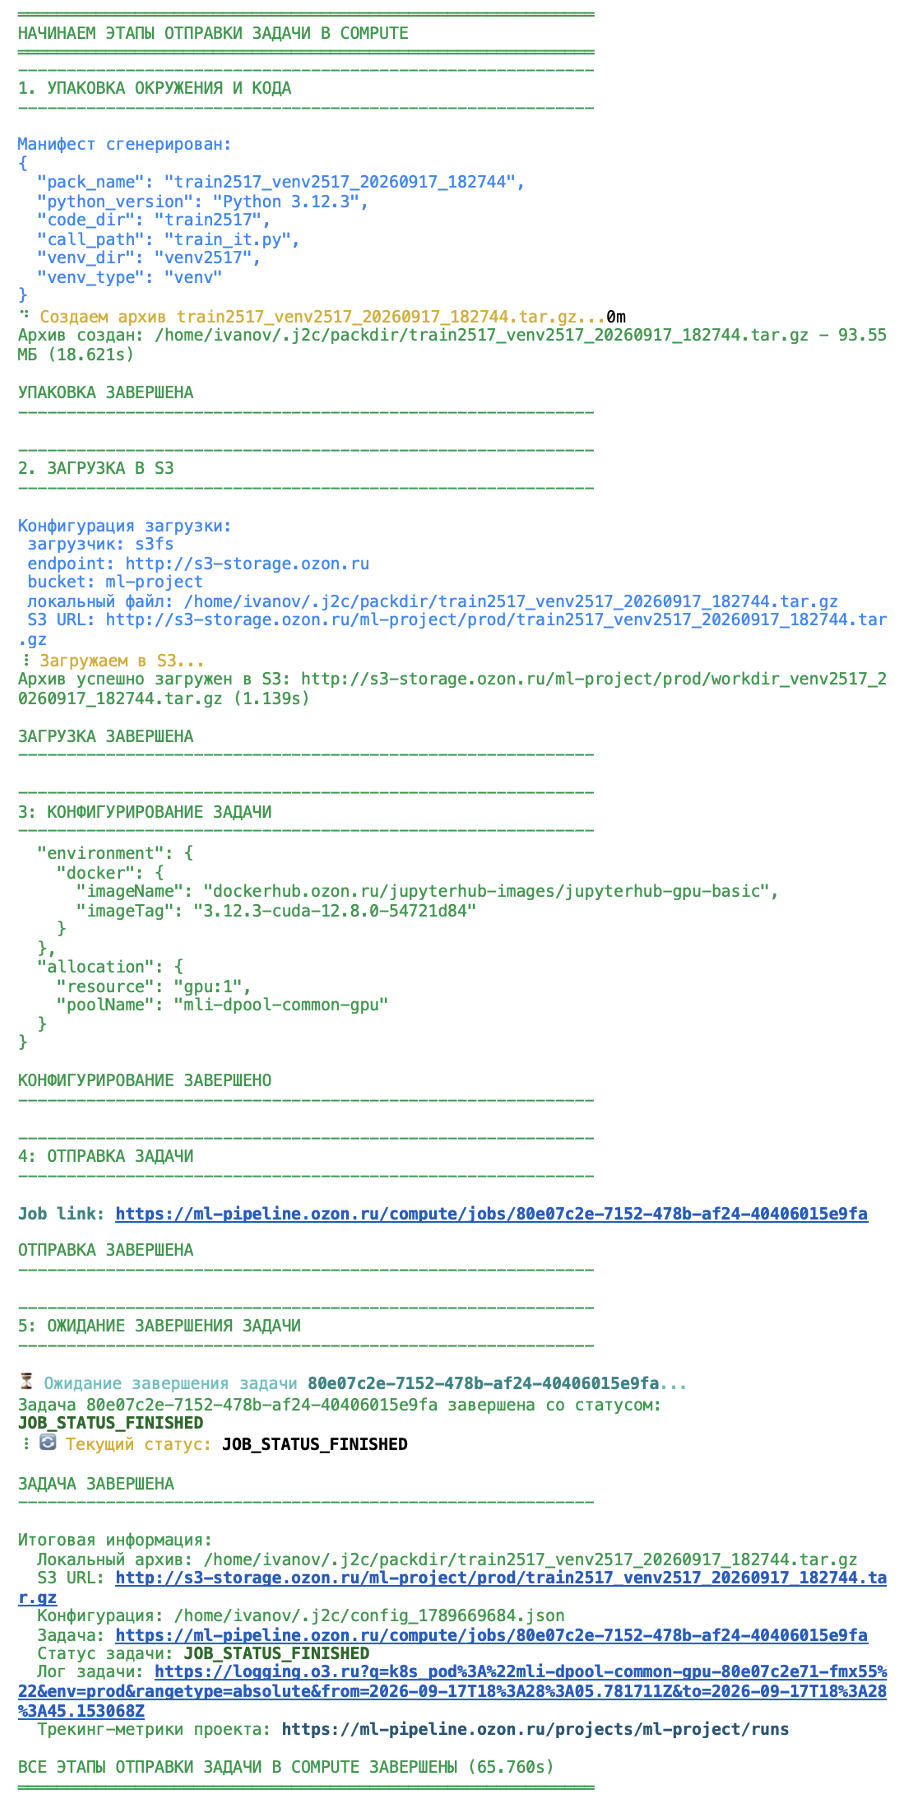
Управляя переносом эксперимента, j2c реализует и большой пласт инфраструктурной логики: валидацию аргументов, аутентификацию, ретраи, тайм-ауты, сериализацию манифеста, обработку ошибок Kubernetes, взаимодействие с объектным хранилищем, сервисами планировщика и конфигураций. Фактически j2c связывает множество платформенных компонентов друг с другом, дополняя ту концепцию единой экосистемы, продуктом которой она сама и явилась.
Было... стало...
Как и раньше пользователь может проверять гипотезы и создавать эксперименты в привычной ему среде JupyterHub.
У пользователя всё так же есть возможность запускать эксперименты на любых вычислительных ресурсах в кластере Compute.
А вот чтоб перейти от создания эксперимента к его запуску на необходимых мощностях, пользователю нужно было тратить часы и дни на перенос этого эксперимента между кластерами. Либо ожидать, пока кто-нибудь не освободит GPU в исследовательском кластере.
Но теперь появился инструмент, который позволяет переносить эксперименты из JupyterHub в Compute одной командой, легко и безболезненно. За минуты, а не дни.
На это время сокращается Time-To-Market для разрабатываемых на нашей платформе ML-продуктов. И это без каких-либо затрат на новые GPU. Учитывая стирание границ между кластерами, можно порассуждать и о более эффективной суммарной утилизации имеющихся GPU. По сути, она теперь определяется возможностями производительного кластера Compute, где достигает 80%. Тогда как в JupyterHub утилизация практически не контролируется, но и ресурсов у него слишком мало, чтоб повлиять на общую для кластеров статистику.
Вот такие преимущества даёт одна маленькая библиотека, объединяющая большие сервисы.
Объединяй и властвуй
Предоставление мощностей по потребностям вовсе не означает, что GPU должны возникать там, где их запрашивает ML-эксперимент. Проще обеспечить переносимость эксперимента к ресурсам, которые ему необходимы. И это вопрос не выбора конкретного инструмента упаковки, а архитектуры всей экосистемы, в которой этот эксперимент живёт.
У нас уже была реализована функциональность для запуска задач в Compute на произвольных docker-образах. Мы видели, какие программные пакеты применяют наши пользователи в своих экспериментах и с какими проблемами они сталкиваются, используя самописные решения или тот же conda-pack. Оставалось собрать всю информацию воедино и сделать выводы.
Ключевая идея, к которой мы пришли, в общем-то, лежала на поверхности. Преимущества единой экосистемы нужно осознанно использовать, а не игнорировать, иначе это будет не экосистема, а набор разрозненных сервисов. Там, где окружение общее, даже хороший универсальный инструмент может проигрывать специализированному: он просто не рассчитан на выгоду от переиспользования библиотек и приложений конкретной платформы.
И нельзя сказать, что ML-эксперимент теперь стал как-то больше зависеть от экосистемы. Он изначально создавался внутри неё и использовал её библиотеки. Зато эксперимент стал меньше зависеть от кластера. Он легко переносится туда, где экосистема может предоставить ему дорогие ресурсы и где использование GPU уже контролируется. Так что цель «GPU для всех» оказалась вполне достижимой. По крайней мере, для всех пользователей нашей экосистемы.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.