Бэкап SQLite прошёл integrity_check, но потерял 90% данных: проверяю пять способов копирования
Для небольшого проекта мне понадобилось настроить резервное копирование SQLite. База используется постоянно, останавливать приложение ради каждого бэкапа не хотелось. При этом копия должна сохранять все подтвержденные транзакции. Я рассматривала несколько вариантов: обычное копирование файлов, SQLite Backup API и VACUUM INTO. Прежде чем настраивать запуск по расписанию, решила проверить их на тестовой базе — не только в простое, но и когда приложение продолжает писать данные или держит открытые соединения.
Для первого теста я использовала таблицу orders с полями: ID заказа, имя покупателя, сумма и описание. Так проще сверить, какие строки попали в копию. Данные синтетические, не из рабочего проекта. Позже для проверки параллельной записи я завела отдельную таблицу tasks.
Я начала с самого простого способа — скопировать только app.db. В скрипте для этого использовалась функция shutil.copy2(), то есть обычное файловое копирование. Копия создалась без ошибок, а проверка PRAGMA integrity_check вернула ok. Однако из ста подтвержденных заказов в копии оказалось только десять.
Проверка | Исходная БД | Копия |
| 100 | 10 |
| 100 | 10 |
|
|
|
При этом последние 90 записей читались через открытое соединение с исходной базой — их транзакции завершились до копирования. Ни параллельной записи, ни аварийного завершения процессов, ни ошибок диска не было.
Почему копия одного файла оказалась неполной
Это состояние я создала специально. Сначала вставила десять заказов и закрыла соединение — они остались в основном файле app.db. Затем снова открыла базу, перевела её в режим WAL и добавила ещё три порции по 30 заказов. Соединение не закрывала и до конца копирования данные больше не меняла. Вот фрагмент скрипта, который отвечает за запись:
with closing(sqlite3.connect(src)) as live:
    live.execute('PRAGMA journal_mode=WAL')
    for first in (11, 41, 71):
        insert_rows(live, first, first + 30)

    # Здесь выполняются варианты резервного копирования.
    # live остаётся открытым.
Функция insert_rows() вызывает commit() после каждого блока, а src указывает на заранее созданную базу с первыми десятью заказами.
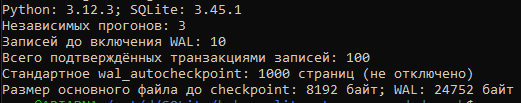
На момент копирования основной файл app.db занимал 8192 байта, а журнал app.db-wal — 24 752 байта. В режиме WAL SQLite сначала записывает изменения в журнал, а затем переносит их в основной файл во время checkpoint. По умолчанию автоматический checkpoint запускается, когда журнал достигает 1000 страниц (около 4 Мб при размере страницы 4096 байт). В нашем случае журнал был намного меньше, поэтому checkpoint не срабатывал и новые записи оставались только в WAL.
В режиме WAL подтверждённая транзакция ещё не означает, что соответствующие страницы app.db сразу перезаписаны. При чтении SQLite объединяет данные основного файла и зафиксированные изменения из WAL. А shutil.copy2() знает только путь к одному файлу, и подтверждённые транзакции в соседнем WAL её не касаются. Десять старых записей составляли полностью корректную базу со своими таблицами и индексами. integrity_check не сравнивает её с историей операций приложения и не знает, каким должен быть последний номер заказа.
Я трижды запускала скрипт на новых базах. Результат воспроизводился: сто записей в источнике, десять в копии, в обеих базах integrity_check = ok. Кроме COUNT(), скрипт сверял ID, суммы и хеш SHA-256 упорядоченных строк. В источнике заказов было на 75 650 ₽, в неполной копии — на 1 715 ₽. Сверять содержимое здесь полезнее, чем хеш самого файла: физически разные файлы вполне могут содержать один и тот же набор строк.
Отдельно я проверила, как SQLite реагирует на повреждение самого файла. Взяла одну из полных резервных копий, продублировала файл, а у дубликата испортила первые четыре байта заголовка. На этот раз запрос завершился ошибкой DatabaseError: file is not a database — до integrity_check дело даже не дошло. Повреждение я внесла вручную, это не модель реального дискового сбоя. Меня интересовала только разница между физически повреждённым файлом и целым файлом, в котором не хватает части данных.
В отдельном контрольном опыте я корректно закрыла последнее соединение, и SQLite выполнила завершающий checkpoint. Новая файловая копия уже содержала все сто заказов. В режиме журнала DELETE без параллельной записи копия тоже получилась полной. Но в обоих случаях условия другие: в первом тесте соединение оставалось открытым, а изменения лежали в WAL.
Затем я добавила в бэкап файл app.db-wal. Во время копирования не было ни новых записей, ни checkpoint, поэтому оба файла отражали одно состояние базы.
Все сто заказов восстановились. Файл -shm переносить не пришлось: при открытии SQLite заново создала вспомогательный WAL-индекс. Дальше я проверила, насколько результат зависит от момента копирования каждого файла.
В следующем запуске основной файл копировался до wal_checkpoint(TRUNCATE), а журнал — после него. Между этими операциями я дописала десять заказов, чтобы изменения были заметны. По сути, собрала резервную копию из двух разных состояний базы. Такое расхождение возможно при последовательном копировании файлов работающего приложения, если между операциями произошёл checkpoint.
Сначала тест показался безрезультатным: 110 записей в источнике и все 110 в собранной паре файлов. Потом я увеличила длину текстовых значений, не меняя число строк и порядок операций. Теперь восстановленная копия содержала лишь десять заказов.
Данные | Исходная база | Полученная копия | integrity_check копии |
Короткие значения | 110 | 110 | ok |
Длинные значения | 110 | 10 | ok |
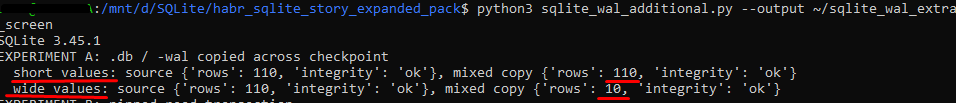
Я специально привожу оба результата: неудачное копирование нескольких файлов иногда выглядит успешным. Расположение страниц зависит в том числе от размера данных, а результат неатомарной операции — от того, что успело произойти между её частями. Если просто добавить -wal в архив, согласованного снимка не получится.
Я также попробовала выполнить wal_checkpoint(TRUNCATE) непосредственно перед shutil.copy2(). Если запись гарантированно остановлена, checkpoint завершается и основной файл содержит все данные. На живом сервисе такую гарантию нужно обеспечивать отдельно: новые транзакции могут попасть в WAL сразу после checkpoint, а сам checkpoint может задержаться или вовсе не завершиться из-за читающих транзакций.
Читатель, который не даёт журналу освободиться
Отдельно я проверила, как checkpoint ведёт себя при долгом чтении. Для опыта хватило таблицы с одной строкой и соединения, которое держит открытую читающую транзакцию.
Первое соединение открывало читающую транзакцию и получало значение before. Я оставляла его открытым. Второе соединение 1400 раз обновляло ту же строку, каждый раз фиксируя изменение. В конце записывающая сторона видела 1399, а старый читатель по-прежнему — before. Оба результата верны: WAL позволяет читателю оставаться на собственном снимке данных.
reader.execute('BEGIN')
reader.execute('SELECT value FROM t WHERE id=1').fetchone()
for i in range(1400):
    writer.execute('UPDATE t SET value=? WHERE id=1', (str(i),))
    writer.commit()
После этих обновлений файл WAL вырос до 5 780 392 байт. Автоматический checkpoint был включён, но очистить журнал не мог. Ручной запуск показал:
читатель: before
записывающее соединение: 1399
WAL: 5 780 392 байт
wal_checkpoint(PASSIVE)    (0, 1403, 3)
wal_checkpoint(TRUNCATE)   (1, 1403, 3)
Для TRUNCATE первый элемент ответа — единица: операция не завершилась, потому что снимок занят читателем. Из 1403 страниц журнала checkpoint перенёс в основной файл только три. После закрытия читателя тот же TRUNCATE вернул (0, 0, 0), и WAL обнулился.
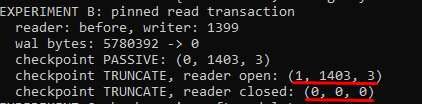
Пока читающая транзакция удерживала старый снимок, WAL продолжал расти даже при включенном автоматическом checkpoint. В скрипте, который рассчитывает на предварительный wal_checkpoint(TRUNCATE), придётся проверять его результат: сам вызов ещё не означает, что журнал удалось освободить.
Два кандидата, которым я готова доверить работающую базу
В итоге я оставила два встроенных механизма SQLite — Backup API и VACUUM INTO. Оба получают согласованное состояние с учётом WAL, но делают это по-разному. Backup API переносит содержимое страниц базы в файл назначения, в том числе её свободные страницы. В моих тестах запись была умеренной, поэтому конфликтов блокировок не возникало. На более нагруженной базе копирование может получить SQLITE_BUSY, если нужная блокировка занята дольше допустимого времени. Поэтому для рабочего сценария стоит настроить busy_timeout и предусмотреть повторные попытки. VACUUM INTO собирает новый файл и уплотняет содержимое. В этих тестах соединение с источником оставалось открытым, а сто подтвержденных заказов были доступны для чтения.
Сначала я проверила Backup API:
with closing(sqlite3.connect('backup.db')) as target:
live.backup(target)
Затем проверила VACUUM INTO:
live.execute('VACUUM INTO ?', ('vacuum.db',))
В обоих случаях в новом файле появились все сто заказов с правильными ID и значениями. Теперь, когда известны условия каждого копирования, все пять вариантов можно свести в одну таблицу. Сравнение я повторила на трёх независимо созданных наборах данных:
Способ копирования | Записей | Данные совпадают | Проверка целостности |
Только | 10 | Нет |
|
| 100 | Да |
|
SQLite Backup API | 100 | Да |
|
| 100 | Да |
|
Checkpoint + | 100 | Да |
|
¹ Между копированием файлов не было ни записи, ни checkpoint.
² Checkpoint завершился успешно, новых записей до окончания копирования не было.
Все три повтора дали одинаковый результат. Оставалось проверить оба штатных механизма при продолжающейся записи.
Проверка при продолжающейся записи
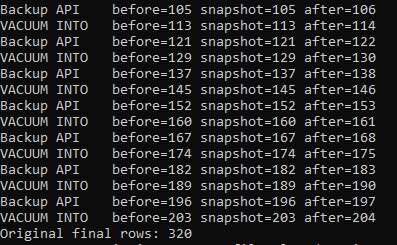
Для следующей проверки я завела таблицу tasks со ста строками и запустила отдельный поток, который добавлял задачи с ID от 101 до 320. Каждая вставка завершалась собственным commit(), между вставками была пауза 7 мс. Основное соединение тем временем создавало снимки по очереди: семь через Backup API, семь через VACUUM INTO. Никаких барьеров синхронизации между записью и запуском очередной копии я не ставила. В каждом полученном файле я проверяла диапазон ID и integrity_check, а число строк сравнивала с количеством строк в источнике непосредственно до и после копирования. Источник успевал измениться, иногда даже в процессе операции. Например, для одного вызова VACUUM INTO получилось 113 записей до запуска, 113 в готовой копии и 114 после него. Все четырнадцать снимков оказались структурно исправными, и в каждом ID шли подряд от 1 до последнего номера, без пропусков.
Backup API: 105, 121, 137, 152, 167…
VACUUM INTO: 113, 129, 145, 160, 174…
В исходной базе после завершения потока: 320
Нельзя приписывать всем снимкам состояние ровно на момент начала вызова. Здесь я проверяла согласованность данных в каждом готовом файле и отсутствие пропусков в последовательности ID, а не точный момент получения снимка. Оба механизма прошли эти проверки. Поведение при длительных блокировках и интенсивной записи таким небольшим тестом не измерить. Файловое копирование в эту серию я не включала: его неатомарность я уже проверила отдельно.
После массового удаления
Ещё одно различие проявляется после массового удаления строк: файл SQLite не уменьшается вслед за таблицей. Я создала другую базу, положила в неё четыре тысячи бинарных объектов размером по 1024 байта, затем удалила три тысячи. В режиме auto_vacuum=NONE освободившиеся страницы остались внутри файла. Оба метода сохранили одну и ту же тысячу объектов — я проверила это по хешу содержимого, а не только по количеству. А вот размеры заметно разошлись:
Backup API 5 484 544 байта
VACUUM INTO 1 376 256 байт
В этой искусственно заполненной и затем очищенной базе VACUUM INTO дала файл почти вчетверо меньше. Команда перестраивает базу и отбрасывает свободные страницы, а Backup API сохраняет её структуру как есть. Для приложения, которое регулярно удаляет старые данные, это может быть важно. Правда, перестройка требует времени и места на диске, а если операцию прервать, появившийся файл нельзя считать готовым бэкапом. Более того, на гигабайтных базах данных (что, конечно, редко бывает в SQLite) такая перестройка приводит к колоссальной нагрузке на дисковую подсистему (I/O spike) и монопольной блокировке. Использовать VACUUM INTO в автоматическом расписании бэкапов на продакшене нужно с осторожностью.

Негативные сценарии
Напоследок я проверила три негативных сценария. Задача по расписанию может запуститься повторно, в каталоге может остаться предыдущая копия, а приложение может держать открытую транзакцию.
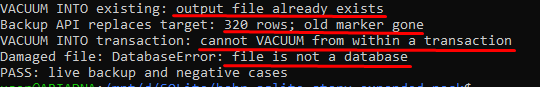
В тестовом каталоге я заранее создала непустую SQLite-базу с таблицей marker и передала её путь в VACUUM INTO. Перезаписывать файл команда не стала и выбросила исключение OperationalError: output file already exists. Таблица marker после ошибки осталась нетронутой.
В той же ситуации Backup API повёл себя иначе: он заменил содержимое существующего файла новым снимком, и прежняя таблица исчезла. В итоге в файле назначения оказались все 320 записей из tasks.
Третий сценарий — VACUUM INTO внутри открытой транзакции. На соединении с исходной базой я выполнила BEGIN, а затем попробовала создать копию. SQLite вернула ошибку cannot VACUUM from within a transaction, и файл назначения не появился. После отката транзакции команду можно запустить снова.
Сценарий | Результат |
|
|
Backup API, существующий файл | прежние таблицы заменены, 320 записей tasks |
|
|
Отсюда разные требования к коду, который запускает копирование.
Для VACUUM INTO нужен несуществующий или пустой файл назначения, а на соединении не должно быть открытой транзакции (BEGIN я проверяла только с VACUUM INTO).
У Backup API другая опасность: он заменяет содержимое существующей базы назначения, поэтому ошибочно выбранный путь может уничтожить предыдущую исправную копию.
Поэтому при запуске по расписанию я бы писала копию во временный файл с уникальным именем, проверяла её и только потом переносила в архив, не трогая последнюю рабочую версию.
Что я выбрала для автоматизации
Для автоматизации я выбрала Backup API. Его можно вызвать прямо из сервиса, из отдельного процесса или штатной командой консольного клиента SQLite:
sqlite3 /srv/app/app.db ".backup '/srv/backups/app-copy.db'"
Для небольшой базы SQLite это стандартный способ получить согласованную копию. Снимки я открывала отдельно и проверяла их содержимое, а вот перенос приложения и полное восстановление сервиса на другом сервере не проверяла.
VACUUM INTO может быть удобнее, если после массового удаления записей требуется компактная копия. Но для полноценного резервного копирования этого мало: нужно хранить несколько версий, отправлять их за пределы исходного сервера и регулярно проверять восстановление. И помнить, что оба метода не сохраняют файлы приложения, на которые ссылаются записи в базе, например загруженные пользователями изображения.
Для проверки бэкапа в приложении понадобятся контрольные значения на момент снимка: сравнивать копию с текущим COUNT() бессмысленно, если в базу продолжают писать. Проверка integrity_check при этом дополняет сверку содержимого, но не заменяет её.
Вместе с ним я настроила регулярное пробное восстановление в отдельный каталог.
Практические выводы:
В режиме WAL для бэкапа работающей базы лучше использовать штатные механизмы SQLite, создающие согласованную копию с учётом журнала.
integrity_checkпроверяет целостность структуры базы. О полноте данных по его результатам судить нельзя.Повторные попытки при
SQLITE_BUSYи настроенныйbusy_timeoutстоит предусмотреть заранее. Это касается Backup API, особенно когда во время копирования с базой продолжают работать другие соединения.Новый или пустой файл назначения, отсутствие открытой транзакции на соединении. У
VACUUM INTOименно такие требования.А проверку бэкапа лучше закончить восстановлением в отдельном каталоге. После этого сверить данные, не ограничиваясь проверкой структуры.
Снапшоты файловой системы или дискового тома в этой статье я не проверяла. Их можно использовать для SQLite при условии, что снимок согласованно фиксирует состояние базы вместе с WAL. Но здесь многое зависит от конкретного хранилища и способа создания снапшота.
Все тесты выполнены на синтетических базах: Python 3.12.3 со встроенной SQLite 3.45.1.
О механике WAL, checkpoint и ограничениях способов копирования подробно написано в документации:Online Backup API, VACUUM INTO, wal_checkpoint.
НЛО прилетело и оставило здесь промокод для читателей нашего блога:
-15% на заказ нового VDS — HABRFIRSTVDS.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.