Когда Hadoop начал тормозить бизнес: как мы перестроили платформу данных в Lenta Tech
Привет, Хабр! На связи Владимир Бибичев, инженер больших данных, и Илья Кисляков, старший инженер больших данных Lenta Tech (ИТ-бренд «Группы Лента»). Мы занимаемся развитием и сопровождением корпоративной платформы больших данных.
На старой платформе Hadoop ETL-процессы могли часами ждать свободных ресурсов, аналитики не успевали выполнять запросы, а бизнес — вовремя получать данные. С ростом нагрузки ситуация становилась всё сложнее, и в какой-то момент мы поняли: простым расширением кластера проблему не решить.
Пришлось серьезно пересмотреть подход к работе с платформой данных. Что именно мы изменили, с какими трудностями столкнулись и к каким результатам пришли — рассказываем в статье.
Оглавление:
Обновили вычислительные движки: Spark, Trino, StarRocks и Kyuubi
Перешли на Apache Iceberg, чтобы упростить работу с таблицами
Airflow 2.11: перестали тратить ресурсы на ожидание зависимостей
Один DAG — один объект: зачем мы изменили структуру загрузок
Переписали ETL-фреймворк и отказались от старых Scala-операторов
С чего всё начиналось: Hadoop, общий YARN и одна ETL-учетка
Для начала немного контекста.
Корпоративная платформа данных нужна, чтобы собирать информацию из разных источников, обрабатывать её и предоставлять бизнесу для аналитики, расчетов и прогнозирования. При этом важна не только возможность выполнить запрос. Нужно понимать, кто отвечает за конкретные данные, насколько они актуальны, сколько ресурсов потребляет обработка и когда результат будет доступен.
В старой платформе с этим возникали сложности.
Мы использовали собственную серверную инфраструктуру. В её основе находился кластер Hadoop: данные хранились в HDFS, а распределением вычислительных ресурсов занимался YARN.
ETL-процессы выполнялись на Spark 2.4, оркестрация была построена на Airflow 2.0.6. Для работы с данными пользователи использовали в том числе Hive, Hue и Zeppelin.
Источники были разными: SAP-системы, реляционные базы данных, файловые системы, Apache Kafka и API. Результаты обработки поступали в Power BI, РСУБД, файловые системы и другие инструменты потребления данных.
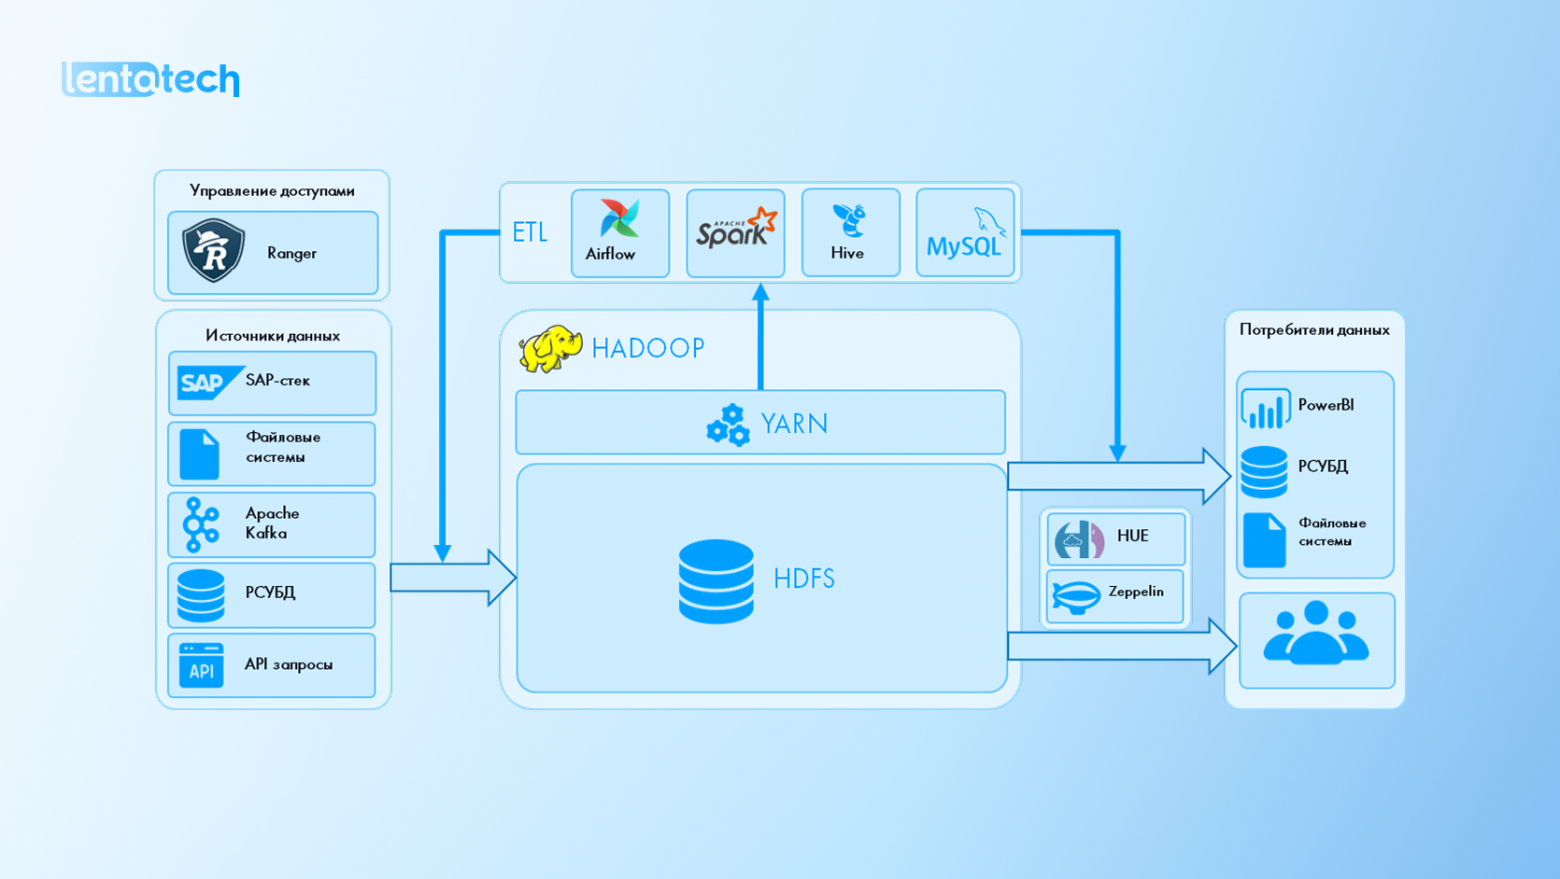
На первый взгляд, обычная архитектура платформы больших данных. Но у неё было несколько особенностей, которые со временем стали серьёзно мешать работе.
Проблема № 1. ETL и пользователи конкурировали за ресурсы
Вычисления ETL-процессов и пользовательские запросы работали в общем пуле YARN.
В первой половине дня, когда нагрузка достигала пика, очередь заданий заметно увеличивалась. Отдельные процессы загрузки данных могли ждать свободных ресурсов по часу-два.
Для аналитиков ситуация была не лучше. Пока очередь не сокращалась, выполнить ad-hoc-запрос или оперативно проанализировать данные было затруднительно.
В результате страдали и ETL, и пользовательская аналитика. А главное, мы не могли обеспечить предсказуемое время выполнения процессов и выполнение SLA.
Казалось бы, можно просто добавить серверов. Но это решило бы проблему лишь на время: объём данных продолжал расти, а вместе с ним увеличивалась потребность в вычислительных ресурсах.
Проблема № 2. Ответственность за данные была сосредоточена в одной команде
Все ETL-процессы выполнялись под единой технической учетной записью.
Создание новых потоков, изменение существующих интеграций и разбор инцидентов проходили через одну команду. Она фактически отвечала за данные разных бизнес-направлений.
Такой подход создавал сразу несколько сложностей:
Любая доработка зависела от доступности общей команды.
Было трудно определить, кому принадлежит конкретный набор данных и сколько стоит его обработка.
Старые потоки данных продолжали работать, даже если их актуальность уже была под вопросом. Без понятного владельца и прозрачной стоимости вычислений заниматься их регулярной очисткой было непросто.
Проблема № 3. ETL-фреймворк оброс легаси
Наш фреймворк развивался несколько лет. Разные поколения инженеров добавляли в него новые возможности, расширяли существующие операторы и адаптировали их под очередные задачи.
В основе оставались Scala-операторы, а зависимости между процессами становились всё сложнее.
Постепенно фреймворк превратился в систему, которую было трудно поддерживать и развивать. Даже относительно небольшое изменение могло потребовать доработки нескольких связанных компонентов.
Добавим сюда устаревающие вычислительные движки и ограниченные возможности масштабирования физической инфраструктуры.
Стало понятно, что точечными изменениями накопившиеся проблемы уже не решить. Поэтому мы решили перестроить платформу целиком: перейти на облачные ресурсы, использовать Kubernetes, обновить вычислительные движки и ETL-фреймворк, а ответственность за данные распределить между доменами.
Начали с инфраструктуры, поскольку именно ограничения вычислительных мощностей сильнее всего сказывались на работе платформы.
Почему мы выбрали облако и начали с инфраструктуры
Первым делом предстояло решить вопрос вычислительных мощностей.
С собственной инфраструктурой всё было довольно предсказуемо, но медленно. Чтобы расширить кластер, нужно было рассчитать ожидаемую пиковую нагрузку, согласовать закупку оборудования, дождаться поставки и ввода серверов в эксплуатацию. На это могли уходить недели и даже месяцы.
При этом железо закупалось с запасом под пиковые нагрузки. В периоды меньшей активности часть мощностей простаивала, но затраты на инфраструктуру никуда не исчезали.
Мы рассматривали несколько вариантов развития инфраструктуры, включая расширение физического кластера и использование облачных провайдеров.
В итоге выбрали Yandex Cloud. Одним из ключевых аргументов стала возможность использовать прерываемые виртуальные машины.
Прерываемые виртуальные машины: экономия с оговорками
Прерываемые ВМ обходятся примерно в три раза дешевле обычных. Но есть нюанс: облачный провайдер может остановить такую машину.
Поэтому использовать их для всех задач подряд нельзя. Зато они подходят для вычислений, которые допускают перезапуск: например, отдельных ad-hoc-запросов, ноутбуков и части ETL-процессов.
Мы начали применять такие ресурсы ещё на этапе работы со старым Hadoop-кластером. Расширили его на 13 виртуальных машин и выделили отдельным доменам собственные вычислительные ресурсы. Это позволило распределить нагрузку, сократить очереди и уменьшить время ожидания свободных мощностей.
Конечно, у гибридного подхода были свои особенности. Для завершения задач использовали graceful timeout продолжительностью четыре часа, после чего ноды автоматически перезапускались.
Но главное преимущество облака проявилось в другом: мы получили возможность гибко управлять вычислительными мощностями.
Если нагрузка растет, можно добавить виртуальные машины. Если снижается — убрать ненужные ресурсы.
По нашим расчетам, аренда облачных ресурсов под пиковую нагрузку оказалась на 58% дешевле закупки физического оборудования в пятилетнем горизонте.
Kubernetes и домены: как устроили новую платформу
Переход в облако не решил бы проблемы общей ответственности и конкуренции за ресурсы. Поэтому основу новой платформы мы построили на Kubernetes.
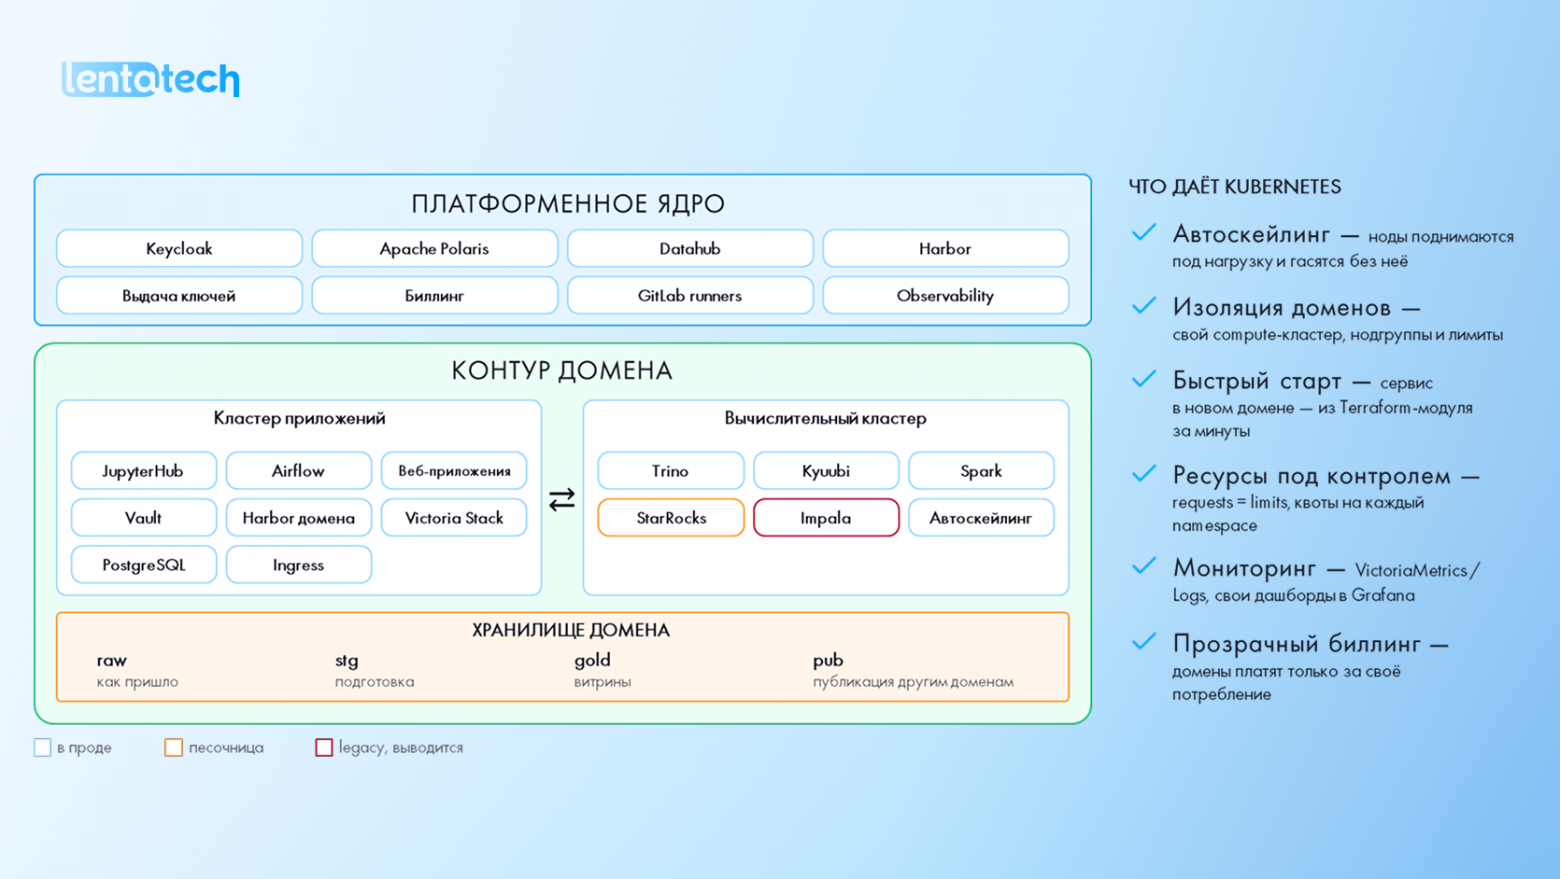
Главная идея заключалась в разделении инфраструктуры на платформенное ядро и независимые контуры доменов.
Платформенное ядро содержит общие сервисы, которые нужны разным командам:
Keycloak — для управления доступом и разграничения прав;
Harbor — для хранения образов приложений;
VictoriaMetrics и VictoriaLogs — для сбора метрик и логов;
GitLab runners — для выполнения задач CI/CD;
Apache Polaris и DataHub — для работы с каталогами и метаданными;
сервисы выдачи ключей, биллинга и наблюдаемости.
А вот основные вычисления и приложения располагаются в отдельных доменных контурах.
Каждый такой контур состоит из трёх частей:
Кластер приложений. Здесь работают Airflow, JupyterHub, веб-приложения и другие сервисы, через которые пользователи взаимодействуют с платформой.
Вычислительный кластер. В нём выполняются запросы и расчёты с использованием Spark, Trino и других движков.
Хранилище домена. Здесь размещаются данные, которые проходят несколько уровней обработки:
raw — исходные данные;
stg — подготовленные данные;
gold — витрины;
pub — данные, опубликованные для других доменов.
Что изменилось благодаря разделению доменов
Раньше нагрузка одного направления могла влиять на остальных пользователей общей платформы. Теперь у доменов собственные вычислительные контуры, нодгруппы, лимиты и квоты. Благодаря этому мы можем управлять потреблением ресурсов каждой команды отдельно.
Для Kubernetes настроили ограничения requests = limits, а для пространств имён — квоты.
Появилась и более прозрачная модель ответственности. Каждый домен отвечает за свои данные, их качество и SLA. Выдачу доступов и изменения согласовывает владелец соответствующего домена.
Отдельно стоит сказать о мониторинге. С помощью VictoriaMetrics, VictoriaLogs и дашбордов Grafana стало удобнее отслеживать работу приложений и искать узкие места.
Ещё одно важное изменение — шаблонизация инфраструктуры. Теперь основные сервисы можно разворачивать с помощью Terraform-модулей, а вычислительные мощности добавлять изменением параметров конфигурации.
Если раньше расширение кластера могло занимать месяцы, то теперь речь идёт о нескольких часах. А запуск сервисов в новом домене занимает минуты.
Обновили вычислительные движки: Spark, Trino, StarRocks и Kyuubi
После инфраструктуры занялись вычислениями. Основным инструментом ETL у нас остался Apache Spark. Но вместо версии 2.4 мы перешли на Spark 3.5, работающий в Kubernetes.
Новая версия дала возможности для более эффективного выполнения запросов, включая адаптивную оптимизацию планов и dynamic partition pruning.
Однако одним Spark мы решили не ограничиваться. На платформе появились несколько SQL-движков, каждый со своей областью применения.
Trino для запросов к разным источникам
Trino используем для федеративных SQL-запросов и ad-hoc-аналитики. Его важная особенность — возможность обращаться к разным источникам данных в рамках одного запроса без необходимости предварительно переносить все данные в одно место. Для распределенной платформы с несколькими доменами это очень удобно.
По нашим оценкам, Trino обеспечивает примерно десятикратное ускорение выполнения запросов по сравнению со связкой Spark, Hive и Tez, которую мы использовали на старой платформе.
StarRocks для быстрых аналитических запросов
StarRocks — MPP-OLAP-движок, который используем для быстрых дашбордов и агрегатов. В наших сравнениях он показывал производительность примерно в 6–8 раз выше Trino.
При этом у StarRocks пока есть ограничения в работе с внешними метасторами: движок поддерживает не все необходимые нам операции. Поэтому сейчас мы используем его для ускорения отдельных аналитических запросов, а по мере развития инструмента планируем расширять сценарии его применения.
Kyuubi и Spark SQL
Kyuubi позволяет предоставлять Spark SQL как сервис для BI через JDBC, выполняя запросы от имени конкретного пользователя. Это ещё один инструмент для организации пользовательского доступа к вычислениям.
Что делаем с Impala
На этапе перехода мы также сохранили Impala. Причина довольно практичная: перенос пользователей на новую платформу должен проходить постепенно. Резко отказаться от привычных инструментов было бы сложно.
В дальнейшем планируем вывести Impala из эксплуатации и сосредоточиться на Trino и StarRocks.
Таким образом, у нас появилось несколько движков с разными задачами, а Spark остался основным инструментом трансформации данных.
Перешли на Apache Iceberg, чтобы упростить работу с таблицами
Ещё одним изменением стал переход на Apache Iceberg.
Раньше мы использовали форматы Parquet и ORC. Они подходят для хранения данных, но сами по себе не предоставляют всех возможностей управления таблицами, которые требовались новой платформе. Iceberg добавляет уровень табличных метаданных и позволяет работать с данными в озере гораздо удобнее.
Что мы получили?
ACID-транзакции. Можно организовать согласованную работу с таблицами при параллельных операциях.
Time travel. Появилась возможность обращаться к предыдущим состояниям таблицы через снимки данных.
Schema evolution. Изменять структуру таблиц, в том числе добавлять и переименовывать столбцы, стало проще.
Скрытое партиционирование. Iceberg берёт на себя часть работы с организацией разделов таблицы.
Кроме того, один табличный формат можно использовать с разными инструментами, включая Spark, Trino, Flink и PyIceberg.
Для ETL это означает более удобную инкрементальную загрузку, упрощение отладки и меньший риск проблем при изменении схемы.
По сути, мы получили дополнительный уровень управления данными, которого не хватало в старой архитектуре.
Airflow 2.11: перестали тратить ресурсы на ожидание зависимостей
Отдельная большая история — оркестрация. В старой платформе использовали Airflow 2.0.6. Для организации зависимостей между загрузками приходилось активно применять сенсоры.
Проблема заключалась в том, что сенсоры занимали слоты выполнения. А количество слотов определяет, сколько задач Airflow может обрабатывать параллельно. Получалась неприятная ситуация: часть ресурсов уходила на процессы, которые просто ожидали выполнения других задач.
При большом количестве загрузок это заметно влияло на производительность.
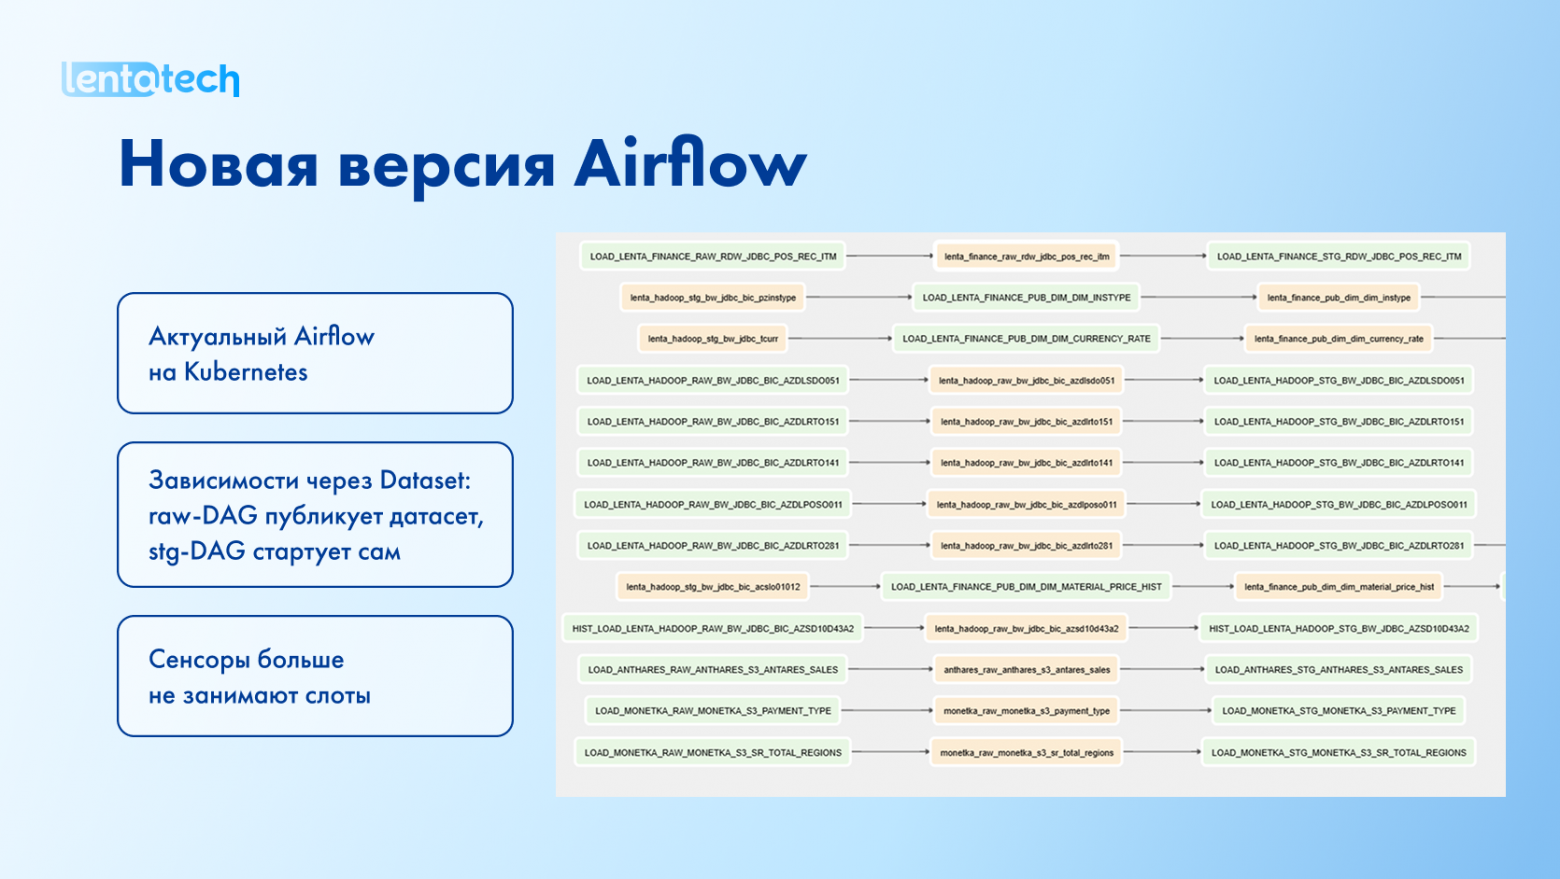
Мы перешли на Airflow 2.11 и начали использовать механизм Datasets. Теперь один DAG может публиковать событие обновления датасета, а другой — запускаться при его появлении.
Например:
DAG загружает данные в слой raw.
После успешной загрузки публикует Dataset.
Зависимый DAG получает событие и запускает обработку данных для слоя stg.
Так мы организуем зависимости без прежней необходимости удерживать слоты ожидающими сенсорами.
Ещё одно преимущество — наглядность. В интерфейсе Airflow можно увидеть связи между DAG и Dataset. Раньше для восстановления цепочки загрузок требовалось участие опытного инженера, который понимал внутреннее устройство фреймворка и его метаданные. Теперь разобраться, откуда приходят данные и какой процесс зависит от другого, стало значительно проще.
Один DAG — один объект: зачем мы изменили структуру загрузок
Обновлением Airflow дело не ограничилось. Мы пересмотрели сам подход к организации ETL-процессов.
Раньше DAG могли объединять целые цепочки загрузок. Для относительно статичных процессов это работало. Но по мере появления новых источников, витрин и зависимостей сопровождать такие цепочки становилось всё сложнее.
Изменение одного объекта могло затронуть несколько связанных DAG.
Поэтому мы перешли к принципу «один DAG — один объект». Теперь каждый DAG отвечает за загрузку конкретной таблицы, а его имя отражает назначение процесса.
Например:
LOAD_<catalog>_<schema>_<table>
По такому названию инженер или аналитик может сразу определить, какой объект загружает DAG.
Что это дало:
зависимости стали понятнее и проще для сопровождения;
отдельные процессы можно перезапускать и отлаживать точечно;
сбой одного DAG не блокирует остальные загрузки;
добавлять новые объекты стало удобнее.
Для платформы, где постоянно появляются новые требования и меняются источники данных, такая структура оказалась практичнее.
Переписали ETL-фреймворк и отказались от старых Scala-операторов
В старом фреймворке операторы постепенно обрастали дополнительной логикой.
Разные задачи решались расширением уже существующих компонентов, из-за чего поддерживать их становилось всё труднее.
Мы решили отказаться от этого подхода и переработали фреймворк.
Во-первых, перешли от легаси-операторов на Scala к PySpark.
Во-вторых, декомпозировали логику: теперь каждый оператор выполняет конкретную функцию, имеет собственные метаданные и предоставляет через них интерфейс взаимодействия.
Такие компоненты проще повторно использовать, тестировать, сопровождать и передавать другим инженерам.
Оптимизировали проверку готовности источников
Раньше готовность отдельных таблиц отслеживалась отдельными сенсорами. При большом количестве объектов это создавало дополнительную нагрузку на Airflow и занимало ресурсы, которые могли использоваться непосредственно для загрузки данных.
Теперь для каждого источника работает отдельный изолированный процесс. Он проверяет готовность всех необходимых объектов этого источника и запускает соответствующие DAG.
В результате нагрузка на оркестратор стала более управляемой и предсказуемой. Вместе с новой структурой DAG и обновленным фреймворком это упростило развитие ETL-процессов.
Что получилось в итоге
Изменения затронули практически все уровни платформы: от инфраструктуры и вычислений до организации ETL-процессов и управления данными. И результаты не заставили себя ждать.
1. Разработка новых ETL-интеграций ускорилась примерно в пять раз, а время запуска подов сократилось с двух минут до 20 секунд.
2. Расширять вычислительные мощности тоже стало проще: если раньше на это уходили недели и даже месяцы, то теперь достаточно нескольких часов.
3. Изменилась и экономика платформы. Благодаря облачной инфраструктуре мы можем гибко управлять вычислительными мощностями: добавлять ресурсы при росте нагрузки и сокращать их, когда потребность снижается. Это позволяет не оплачивать простаивающие мощности.
4. Есть результаты и со стороны обработки данных: время их прохождения от источника до потребителя составляет 45 минут, а количество ложных срабатываний бизнес-алертов сократилось вдвое.
5. Разделение платформы на доменные контуры позволило избавиться от конкуренции за общий пул ресурсов. Теперь команды могут управлять собственной нагрузкой, а изменения в одном контуре не затрагивают остальные.
6. Благодаря шаблонизации стало проще развивать инфраструктуру: многие операции, которые раньше требовали длительных согласований и закупок, теперь выполняются через конфигурацию.
7. Обновление ETL-фреймворка и переход на Datasets в Airflow сделали цепочки загрузок понятнее. Чтобы разобраться в зависимостях между процессами, больше не нужно восстанавливать их по метаданным вручную — достаточно открыть интерфейс Airflow.
В итоге мы получили платформу, которую проще масштабировать и сопровождать, а ответственность за данные и их качество теперь закреплена за конкретными доменами.
Какие выводы сделали
За время трансформации у нас сформировалось несколько принципов, которые стоит учитывать при развитии платформ данных.
1. Архитектурные проблемы не всегда решаются точечными оптимизациями. Если процессы конкурируют за ресурсы, ответственность размыта, а фреймворк сложно поддерживать, очередная закупка серверов лишь отсрочит решение основных проблем.
2. Облачная инфраструктура даёт больше гибкости в управлении нагрузкой. Возможность быстро добавлять и отключать ресурсы особенно важна, когда нагрузка меняется в течение дня.
3. У данных и процессов должны быть владельцы. Без понятной ответственности сложно контролировать качество, SLA, стоимость обработки и актуальность существующих потоков.
4. Шаблонизация упрощает развитие платформы. Когда развертывание сервисов и организация загрузок строятся по единым принципам, инженерам приходится тратить меньше времени на повторяющиеся операции.
5. ETL-фреймворк должен оставаться понятным и поддерживаемым. Сложная логика, накопленная за годы, может стать серьезным ограничением для развития. Декомпозиция операторов, прозрачные зависимости и единые правила именования помогают избежать этой ситуации.
Мы начинали трансформацию с решения проблем производительности, но довольно быстро поняли, что изменения нужны не только на уровне инфраструктуры. Пришлось пересмотреть и техническую архитектуру, и принципы работы с данными.
Теперь у нас есть платформа, которую проще масштабировать, сопровождать и развивать вместе с потребностями бизнеса.
На этом у нас всё. Если вы тоже работали с миграцией Hadoop, развивали ETL-фреймворки или выстраивали доменную архитектуру платформы данных, расскажите о своем опыте в комментариях. Интересно узнать, какие решения сработали у вас и с какими сложностями пришлось столкнуться.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.