Зачем голосовому боту на LLM снова нужен классификатор вроде Jev
Голосовой бот на LLM разговаривает приятно, но на реальных звонках регулярно спотыкается. Он может найти свободное окно и так и не записать клиента или перебить человека, который просто задумался посреди фразы.
Часть таких решений можно снять с LLM и отдать быстрой модели-классификатору. Самая обсуждаемая из них сейчас Jev от TypeSafe, и у нее уже появились открытые аналоги. Ниже разбираю, как Jev-подобные модели применяют в голосовых ботах другие команды, и сравниваю их кейсы с нашим опытом в Voximplant.
Почему одной LLM мало
В 2022–2024 годах, когда больших языковых моделей ещё не было в широком доступе, а бот в телефонном разговоре уже должен был понимать намерение, мы собрали свой классификатор, Voximplant Avatar. Он быстро и дёшево выделял intent из фразы по настраиваемому каталогу и отмечал, вошли ли в эту фразу entities, то есть структурированные данные, системные или кастомные. Работал он неплохо, да и работает в некоторых проектах до сих пор.
Потом появились большие языковые модели, и на минуту показалось, что классификатор больше не нужен: модель сама и смысл поймёт, и ответ сочинит. На практике эйфория, как обычно, закончилась довольно быстро. На живых проектах средние модели лопались от величины начального промпта или после нескольких смен темы и начинали галлюцинировать. Большие и дорогие справлялись с нагрузкой, но либо ломали unit-экономику решения, либо отвечали так медленно, что в телефонном разговоре это было неприемлемо. А часть моделей и вовсе была недоступна в отдельных регионах.
Когда вы делаете голосового бота профессионально, для прода крупного заказчика, вам важно оптимизировать всё: качество ответов, попадание в метрики, бюджет. Конструкторы ботов стали обходить эти ограничения инженерией. Они делали многостадийных ботов, ставили несколько агентов на один номер с моделью-маршрутизатором, а там, где диалог точно идёт по сценарию, оставляли скриптованные куски. Мы делаем несколько сотен больших коммерческих проектов в год и накопили достаточно опыта, чтобы сказать: одна-единственная модель пропускает момент вызова инструмента, вылезает за контекстное окно и сжигает недопустимое количество токенов. В реальных кейсах полагаться на одну модель нельзя, весь разговор она почти точно не вытянет.
Avatar к этому моменту уже устарел, архитектурно в первую очередь. Мы начали менять его на похожую схему с небольшой языковой моделью, дешёвой и быстрой, и тут вышел Jev. Всё новое в очередной раз оказалось хорошо забытым старым.
Что это вообще такое
Jev — модель System One от TypeSafe, то есть модель для принятия решений (decision model), выложенная в ранний доступ в сентябре 2026 года. На вход она принимает состояние (кусок транскрипта, последнюю реплику бота, шаг сценария) и ряд вопросов. Назад приходит типизированный ответ: выбор из заданных вариантов, оценка по короткой шкале или вероятность ответа «да/нет» на один прямой вопрос.
Текст Jev не пишет, выходных токенов как таковых не имеет, просто отдаёт типизированную структуру. Что с этой структурой делать дальше, решает конструктор бота. Официальное описание и типы вопросов есть на сайте TypeSafe.
Jev довольно быстр. Замеры задержки расходятся, но в целом укладываются в «до 500 мс»: у кого-то пачка из тридцати пяти вопросов уложилась примерно в 170 мс на прогретом соединении, у кого-то вышло 332–892 мс. У TypeSafe в материалах фигурирует диапазон 70–500 мс.
Для полноты картины добавлю, что тема моделей-классификаторов совсем недавно получила второе дыхание, и не Jev единым. Вот что вышло за последнее время (обзоры есть в Latent Space и в обсуждении на Reddit):
Laya от исследователя из Convai Innovations, главный и самый популярный бесплатный аналог с открытым исходным кодом (лицензия Apache 2.0).
Clef от Cloudflare, открытая модель для сверхбыстрого принятия решений внутри программных систем.
CMF от Cortiq, лёгкая открытая модель весом всего 304,5 МБ. Она работает за миллисекунды без генерации токенов и показывает высокую точность в задачах классификации.
Bespoke Nimble от Bespoke Labs, рецепт «открытого Jev» на базе LoRA-файнтьюна модели Qwen3.5-9B с использованием ограниченного декодирования.
Kev от @jaredpalmer. Начинался как ультракомпактная Jev-подобная модель Kev-0.5B на базе Qwen2.5-0.5B, созданная для эффективного локального запуска на потребительских устройствах вроде MacBook Pro, а сейчас это уже семейство моделей.
CLM-8B, совместная разработка Стэнфорда и Nvidia. Модель кэширует многоразовые действия агентов и в тестах авторов показывает скорость выше, чем у Jev.
В общем, Jev-подобных моделей уже много. Я хочу рассмотреть тему в целом: как модель-классификатор может улучшить голосового бота.
Классификатор на входе, специализированный агент на каждую тему
Типичная ситуация в голосовом меню: номер один, а тем внутри него несколько. Запись, статус заказа, претензия, «соедините с человеком». Если всё это живёт в одном промпте, средняя модель пухнет и после второй-третьей смены темы начинает нести пургу.
Решение такое: на входе ставим быстрый классификатор. Он выбирает небольшого агента, заточенного под одну тему, и подключает его к разговору. Смена тематики тоже его решение, отдельным тактом, до того как управление передали большой модели и она начала сочинять ответ.
Piotr Zaczek показал это на голосовом контуре коротким роликом. Ролик как раз про время, за которое система решает сменить направление диалога: 0,5 с против почти 5 с, плюс экономия на токенах большой модели. Piotr отобрал у неё разрешение делать выводы и рассуждать за рамками своей темы, теперь это делает классификатор.
Зачем так: у специализированного агента короткий промпт и один каталог инструментов. Классификатор дешёвый и быстрый, его не жалко спрашивать на каждой смене темы.
В том же посте Zaczek отдельно, уже без ролика, называет три применения, которые ему нравятся помимо маршрутизации:
разбор после звонка;
всегда включённые фоновые ограничения, мимо речевого ответа;
решение, когда отдать трубку другому агенту или человеку.
Запомним эти применения классификатора.
Модель предлагает, Jev оценивает
Дороже всего бот ошибается в действиях, когда что-то меняет: записывает клиента на старое имя или не кладёт трубку после «до свидания».
Giorgi Lomidze разбирает в посте JEV in Production от 24 сентября 2026 года, как они за две недели вынесли такие решения из речевой модели в классификатор на Jev. Продукт называется Pocos, это телефонный ассистент для салонов и студий.
Как это устроено. Звонок приходит в Voximplant по SIP. Сценарий VoxEngine через RealtimeAPIClient соединяется с LLM (у них в проде Gemini Live) и поддерживает голосовой диалог: приветствие, контроль перебиваний, таймеры, отбой. Речевая модель слышит абонента и предлагает вызвать инструмент. Все выводы модели, прежде чем они смогут что-то изменить в системе или в диалоге, модерируются классификатором: собирается короткий пакет фактов, Jev получает несколько вопросов «да/нет», на выходе получаем вероятности.
Вопросы буквальные. «Абонент подтвердил это действие?» «Последняя реплика меняет, подтверждает или отменяет то, что мы только что сказали?» «Абонент попрощался?» Дальнейшие действия зависят от вероятности «да/нет», которую вернул Jev. Конкретные пороги нужно подгонять под ситуацию. У Giorgi сильное согласие начинается от 0,9, слабое опускается до 0,1, а прощание считается сильным от 0,75 и только если абонент не принёс новую тему.
Суть подхода можно изложить так: LLM только предлагает, Jev оценивает, решение принимает бизнес.
Как понять по смыслу, что абонент договорил
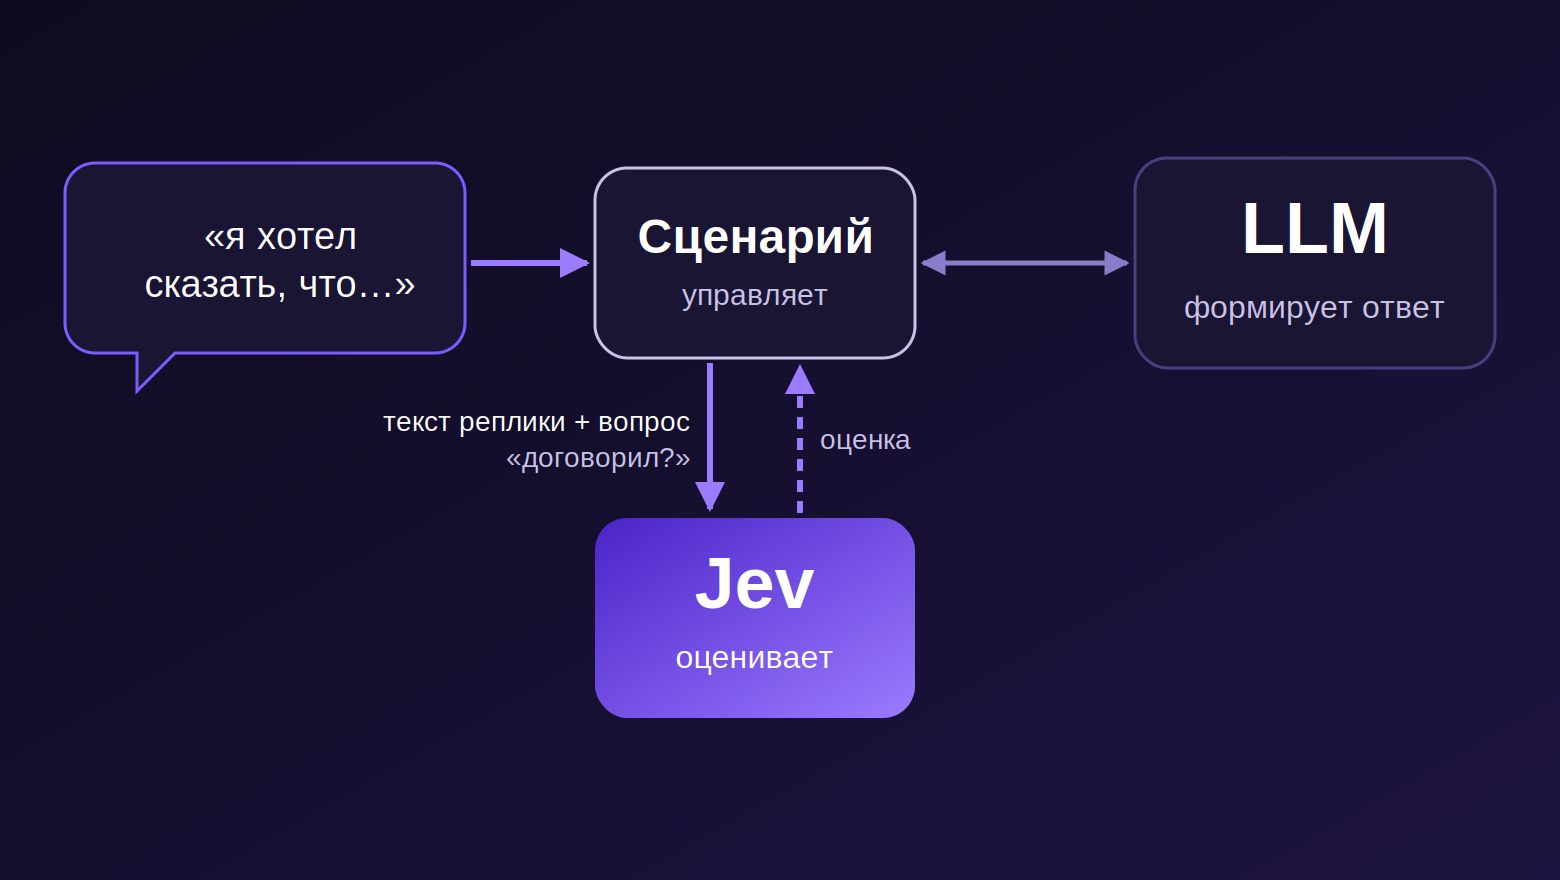
Абонент вдруг замолкает на полуслове. Таймер тишины уже готов отдать ход боту. «Да» после вопроса «перенести на вторник?» считается законченной репликой. «Я хотел сказать, что…» уже нет, хотя длина паузы та же.
У нас есть свои инструменты для определения завершения очереди в диалоге, Agentic VoiceDSP. В одном модуле VoxEngine сидят Silero VAD, детектор завершения хода Pipecat Smart Turn и опциональный шумодав Hush. У разработчика есть контроль над событиями хода (TurnStarted, TurnInferenceTriggered, TurnStopped), и на каждое можно как-то отреагировать. Smart Turn как раз решает по паузе, закончился ход или нет, и если нет, выдерживает тишину stopSecs. То есть это контроль на уровне звука, по акустической модели хода.
Поверх него мы хотим определять конец реплики ещё и по смыслу сказанного: мысль закончена или человек ищет следующее слово. Технически это должно сработать. Типичная задержка ASR около 50 мс, классификация Jev около 200 мс, вместе около 250 мс. Не мгновенно, но для большинства индустрий применительно к полнокаскадной архитектуре ботов на телефоне этого должно хватить.
С чем мы хотим поэкспериментировать:
Сначала ход отслеживают VoiceDSP и VAD.
На частичном или финальном тексте задаём Jev один вопрос: «говорящий закончил то, что хотел сказать?» В состояние кладём последнюю реплику бота, потому что «да» бывает полным ответом только тогда, когда перед ним был вопрос.
Допустим, turn detection сказал «конец», а Jev на тексте видит незаконченную мысль. Выводы расходятся, и в этом случае считаем, что абонент хочет продолжить мысль, и ход боту не передаём. Если оба решения сказали «конец», можно отдавать реплику и стартовать ответ.
Ту же механику Supreet Tare из Taritas реализовал на боевом проекте голосового коучинга и расписал её в статье Semantic turn detection with Jev. У него аудио ловит тишину, и после 350 мс тишины Jev получает один вопрос. Ответ приходит примерно за 0,4 с. Дальше код выбирает, сколько ещё ждать: 1,7 с, если мысль закончена (вероятность от 0,75), 2,8 с, если ответ неуверенный, и 4,5 с, если фраза обрывается на «and», «but» или запятой. Кажется, что это очень медленно, но в тренажёре Supreet важнее не упустить ничего важного, чем быстро ответить.
Перебивание, «щас погодь», backchannel и реплика в сторону
Jay Albo разобрал интересный кейс на Agora Conversational AI в посте Jev VAD, код лежит в репозитории AgoraIO-Community/convoai-jev-vad. Контроль аудио и начала речи по энергии сигнала здесь пропустим. Абонент начал говорить, в Jev пошёл текст. Один вызов возвращает четыре вероятности:
turn_complete: абонент закончил мысль, можно передавать очередь. Это мы уже проходили.holding_floor: абонент прямо просит паузу. «Подожди, щас посмотрю…» Уже интереснее.addressed_to_agent: это точно сказано боту? «Эй, там! Давайте потише, я по телефону разговариваю». Вот это самая любопытная деталь, и встретилась она нам впервые.taking_floor: пока бот говорит, это настоящее перебивание или backchannel вроде «мм» и «угу»? Некоторые модели сами умеют определять подобные недофразы, но в массе такое поведение неконсистентно, и смена или обновление модели может сломать бота в этом месте.
В его сессиях вызов Jev возвращался примерно за 300 мс.
Как Jev разбирает данные для анкеты
Запись на приём, перенос записи, отмена визита, вопрос про счёт. Домен маленький, вариативность ограничена, фразы живые, и абонент в одной реплике сразу приносит свои данные, специалиста для записи и дату с временем визита. Большая языковая модель, которая ещё и говорит, здесь избыточна. Нужен тот самый Avatar: классификатор выбирает значимые данные из того, что сказал человек, и отдаёт их в код бота.
Jason Stiles собрал это как телефонную линию вымышленной клиники и описал в разборе Jev IVR, обновлённом 24 сентября 2026 года. Стек: Node, Twilio ConversationRelay, Deepgram на распознавании, ElevenLabs на голосе, Jev на понимании.
Код бота держит состояние формы, и на каждый ход в Jev уходит один запрос примерно с 30–35 вопросами.
Интент определяется выбором по описанию. «Перенеси», «давайте другой день» и «I need to change my appointment» попадают в reschedule, потому что в критериях описано, чего хочет человек.
Со структурированными данными сложнее, чем с выделением entity. Код сам находит кандидатов на данные в транскрипте: все похожие на число куски для года рождения, все куски из одного–четырёх слов для имени. Jev выбирает, какой кусок год, а какой чьё-то имя. Главный плюс классификатора здесь в том, что галлюцинаций нет как явления. Выдумать дату Jev не может, ошибка в данных всегда идёт из слов абонента. Подтверждение всегда идёт отдельным запросом: абонент согласился, отказался или назвал поле анкеты, которое надо поменять. Звучит, конечно, старомодно, зато работает быстро и чётко.
Дорогой ответ или дешёвый
Маршрутизатор тем из первого раздела выбирает, о чём говорить. Есть и другой выбор: какой ценой отвечать на этот ход. На «да», почтовый индекс или короткий статус можно ответить дёшево. Путаница, инструкция, пространное объяснение или отказ дёшево, скорее всего, не получатся.
Deepesh Jayal из Evalgent разобрал этот выбор в статье Jev for Model Routing in Voice Agents. В его случае модели разделены на три класса:
Заготовка с ответами. Здесь модель не вызывается, ответ даётся простым синтезом или скриптом.
Быстрая модель на короткий фактический ответ.
Тяжёлая и дорогая модель на неоднозначность и высокую цену ошибки.
На каждом ходе Jev выбирает, чем ответить, и фактически отвечает на вопрос «нужен дорогой ответ?». Deepesh опирается на ModelRouterMiddleware из пакета langchain-typesafe: критерии выбора модели пишутся обычным языком, вероятности остаются в состоянии агента. Так разбор после звонка показывает, почему ход ушёл на дорогую модель.
Я бы зафиксировал три правила, которые из этой статьи стоит перенять:
Низкая уверенность поднимает выбор на класс выше, а не оставляет на дешёвом.
Вопрос с высокой ценой ошибки на дешёвый класс не попадает, даже если классификатор уверен, что «вопрос простой».
Посреди звонка поднятый класс не понижают. Дорогую модель уже разбудили. Переход обратно на дешёвую на следующем «да» экономит немного, но может попортить контекст дорогой модели.
Идеальный каскад с классификатором
Подведём итоги. Ниже порядок, в котором имеет смысл собирать голосового бота с быстрым и дешёвым Jev-подобным классификатором, чтобы получить от него максимум пользы. Порог уверенности на каждом шаге свой, добытый из опыта, и его точно нужно подбирать индивидуально под кейс.
Конец реплики и перебивание. На тексте это добавляет около 250 мс задержки (ASR около 50 мс и классификация около 200 мс). Вопросы: «мысль закончена?», «это backchannel?», «человек просит подождать?», «реплика точно нам?». По образцу решения Jay Albo.
Тематика. Если в голосовом меню больше одной темы, применяйте классификатор, как у Piotr Zaczek, и подключайте оптимизированного агента для каждой темы. Смену темы посреди звонка определяет тот же классификатор, а не догадка агента.
Форма, заполнение полей. Запись, перенос, отмена, статус, счёт. Код нарезает кандидатов в сущности, Jev выбирает кусок транскрипта, фразы берутся из заготовок, в тестах используется кассета ответов. С этим подходом я бы лично поспорил, потому что есть более эффективные способы выделения структурированных данных, чем бинарное деление классификатором. Но как любопытный эксперимент он имеет право на жизнь, а с точки зрения навигации по меню и нужным полям анкеты действительно заслуживает внимания.
Изменение данных, внесение записей. Создать, перенести, отменить, списать, положить трубку. Решение Giorgi Lomidze: LLM только предлагает, Jev оценивает, верно ли и уместно ли предложение. Если да, вносим изменение. Если есть расхождения, не вносим и думаем, что делать дальше.
Цена ответа. Заготовка, быстрая модель или тяжёлая модель. Тяжёлую будим, когда классификатор сказал, что ход тяжёлый, или когда цена ошибки и так высокая. Класс модели посреди звонка не опускаем.
Если вы уже пробовали Jev или его аналоги в голосовых ботах, расскажите в комментариях, какие пороги у вас прижились и что ломалось по дороге.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.