Когда Docker Compose уже мало, а Kubernetes еще слишком много: знакомство с Uncloud. Часть 1
Disclaimer: статья проверена по документации и репозиторию Uncloud для стабильной версии v0.20.0. Проект активно развивается, поэтому отдельные CLI-команды и Compose-возможности могут меняться между релизами.
Как всегда, всё начинается со специфического запроса от Заказчика: «Мы хотим забыть Kubernetes как страшный сон и вернуться к Docker Compose!».
На этом месте, наверное, многие DevOps-инженеры с пониманием улыбнутся.
Но после ещё было: «Только, пожалуйста, сделайте так, чтобы было возможно масштабирование. И ещё бесшовное обновление приложений! Но чтобы остался Docker Compose».
В этот момент становится понятно, что задача перестает быть тривиальной.
Docker Compose прекрасно работает, пока приложение живёт на одной машине. Он отлично знаком и понятен разработчикам, у него низкий порог входа, практически нет дополнительной инфраструктуры и огромное количество готовых примеров.
Но как только появляется второй сервер, возникают привычные вопросы:
• где запускать контейнер?
• как масштабировать сервис между несколькими машинами?
• как организовать service discovery?
• как контейнеры будут взаимодействовать между разными хостами?
• куда направлять входящий трафик?
• как делать rolling update?
• что произойдет, если одна из машин станет недоступна?
И именно здесь обычно на сцену выходит Kubernetes, а вместе с ним появляются ещё с десяток новых сущностей: Deployment, StatefulSet, Ingress, Service, ConfigMap, Secret, PersistentVolume, PersistentVolumeClaim, CNI, CSI. Так задача запустить несколько контейнеров на нескольких серверах превращается в отдельный инфраструктурный проект. И проблема в том, что иногда самого Kubernetes становится слишком много и порой необоснованно трудозатратно.
Если условно требуется обслуживать сотни сервисов, десятки команд, сложные политики размещения, обеспечивать инфраструктуру хранения данных, операторы, GitOps и всё остальное, Kubernetes полностью оправдывает себя.
Но когда необходимо хостить веб-приложение из нескольких десятков контейнеров, возникает ощущение, что ты нанял диспетчерскую аэропорта для управления парковкой на десять машин. Можно. Но зачем?
А если оставить Docker Compose, но добавить к нему часть возможностей, ради которых в подобных сценариях начинают рассматривать Kubernetes? Оказывается, можно. Есть целый класс промежуточных решений: Docker Swarm, Nomad, Kamal, различные PaaS-инструменты, собственные deployment-скрипты. И еще — Uncloud.
Что такое Uncloud
Uncloud — это способ превратить несколько Docker-хостов в единую среду, сохранив Docker Compose в качестве основного интерфейса управления.
Идея простая: не заставлять пользователя учить новый способ описания приложения и превращать каждый сервис в отдельный Kubernetes Deployment, упаковывать в helm-чарты или писать манифесты для Flux. Вместо этого Uncloud пытается взять привычный мир Docker и добавить к нему слой «кластеризации».
В документации проекта эта идея сформулирована примерно так: это легкий инструмент оркестрации контейнеров поверх Docker-хостов, который находится между привычным Docker Compose и более тяжёлыми системами вроде Swarm или Kubernetes.
Получается следующая схема:
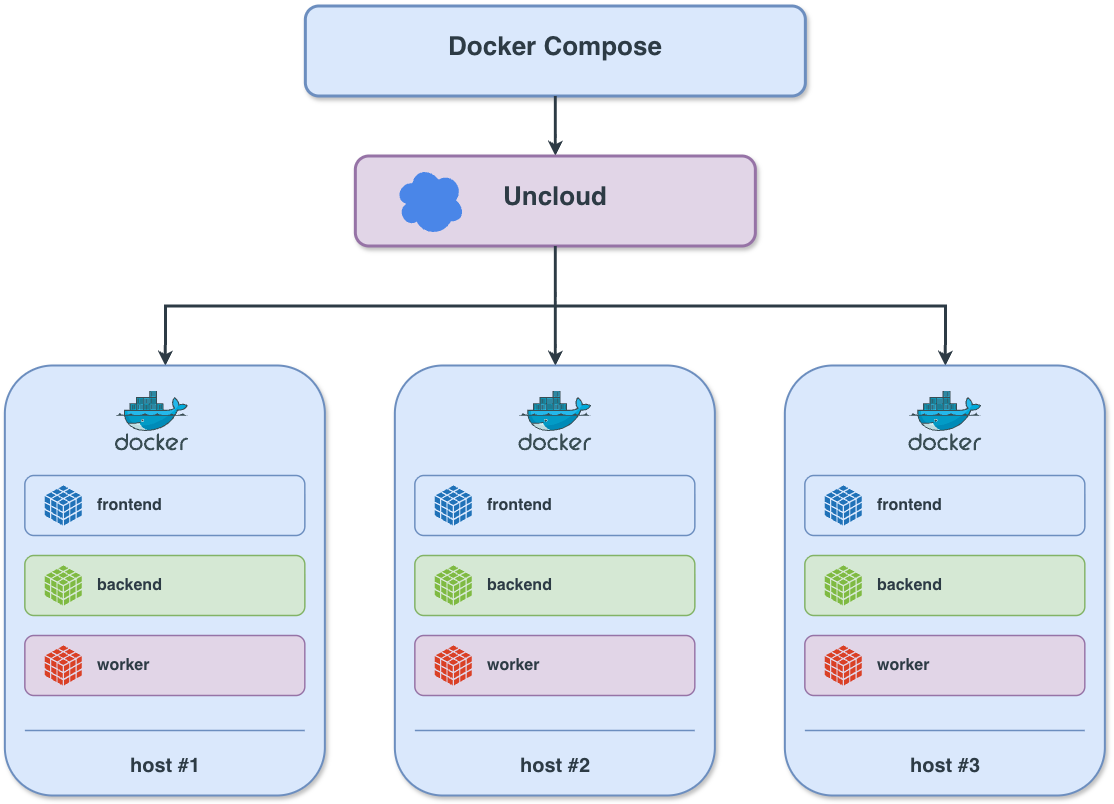
Uncloud не заменяет Docker новым runtime, он добавляет над несколькими Docker-хостами общий слой состояния, сети и управления.
И самое интересное здесь не CLI, HTTPS или DNS, а то, как Uncloud вообще организует кластер.
Состояние кластера: Corrosion
Когда мы слышим «кластер», обычно представляем control plane - центральный компонент, который хранит состояние, принимает команды, планирует размещение контейнеров и следит за состоянием узлов.
Uncloud построен иначе. Центрального control plane у него нет: состояние кластера распределено между машинами, и каждый узел хранит свою локальную реплику этого состояния.
Основой этой модели является Corrosion - распределенное хранилище состояния на базе SQLite, использующее CRDT-модель для репликации и слияния изменений. Узлы обмениваются изменениями через peer-to-peer механизм, поэтому для работы кластера не требуется один центральный сервер, который постоянно должен быть доступен всем остальным.
CRDT - Conflict-free Replicated Data Type. Это подход к работе с реплицируемыми данными, при котором несколько узлов могут независимо изменять свои локальные копии, а затем обмениваться изменениями и объединять их по формальным правилам.
Представим, что между двумя машинами временно пропала сеть и одна из них изменила состояние сервиса, а другая зарегистрировала новый хост.
В централизованной архитектуре такие изменения обычно проходят через общий источник истины - например, control plane или лидер кластера. В распределенной модели Uncloud узлы могут продолжать работать со своей локальной репликой. После восстановления связи изменения синхронизируются и объединяются.
Здесь появляется понятие “eventual consistency” - согласованность в конечном итоге. Реплики не обязаны иметь одинаковое состояние в каждый конкретный момент. Если новые изменения перестают поступать и связь между узлами восстанавливается, система должна прийти к согласованному состоянию.
Это соответствует архитектурному выбору Uncloud в пользу Availability и Partition tolerance (AP) в рамках CAP теоремы.
При этом eventual consistency не означает, что система всегда автоматически выбирает «правильный» с точки зрения пользователя вариант. CRDT гарантирует, что после восстановления связи реплики смогут прийти к единому состоянию. Но какое именно состояние получится при конфликтующих изменениях, определяется правилами слияния.
В результате Corrosion здесь играет роль фундаментального слоя: он не запускает контейнеры и не управляет сетью непосредственно, а предоставляет распределенное состояние, на котором уже работают остальные механизмы Uncloud.
В текущем Uncloud v0.20.0 Corrosion запускается как управляемый сервис под контролем компонента uncloudd. При этом сам проект предупреждает о том, что начиная с v0.20 изменились версия и формат cluster store. Поэтому при обновлении кластера важно согласованно обновлять CLI и daemon на его машинах.
Добавление машины в кластер
После того, как появилась распределенная основа, обычный Docker-хост можно превратить в полноценный узел Uncloud-кластера.
Предположим, есть первый сервер:
server-01 - 10.0.0.10Мы хотим превратить его в первый узел Uncloud-кластера:
```bash
uc machine init root@server-01
```
Эта команда выполняет гораздо больше, чем просто добавление записи о сервере. Uncloud подключается к машине по SSH, при необходимости устанавливает Docker, разворачивает сервис uncloudd, настраивает сетевую часть и необходимую инфраструктуру кластера, включая механизм хранения и синхронизации состояния.
После этого добавим еще две машины:
```bash
uc machine add --name server-02 root@server-02
uc machine add --name server-03 root@server-03
```
В результате мы по-прежнему имеем обычные Docker-хосты, но теперь каждый из них является частью общей распределенной инфраструктуры Uncloud.
Сеть: WireGuard
После того, как у нас появился кластер, контейнеры на разных Docker-хостах должны иметь возможность общаться друг с другом.
Обычный Docker bridge работает внутри одного хоста: контейнер на server-01 не может просто обратиться к контейнеру на server-02 по его внутреннему Docker IP. Между этими двумя подсетями нужен как минимум еще один связующий слой.
В Uncloud эту задачу решает WireGuard - современный VPN-протокол и сетевой интерфейс уровня L3. Но в Uncloud он используется не как VPN для подключения пользователей к серверу, а как основа приватной сети между узлами.
Во время инициализации для каждой машины генерируется собственная пара ключей WireGuard. Публичный ключ используется для идентификации узла в WireGuard mesh, а приватный остается на самом хосте. Также выделяется отдельная подсеть внутри общей кластерной сети.
В текущей реализации используется следующая схема адресации:
10.210.0.0/16 вся сеть кластера
10.210.X.0/24 подсеть машины X
10.210.X.1 адрес самой машины
10.210.X.2–254 адреса контейнеров этой машины
Uncloud связывает сеть WireGuard с сетевым стеком Docker.
На каждом хосте создается Docker bridge, которому назначается соответствующая /24-подсеть. Сам WireGuard-интерфейс при этом использует сетевой адрес хоста.
В результате получается конструкция:
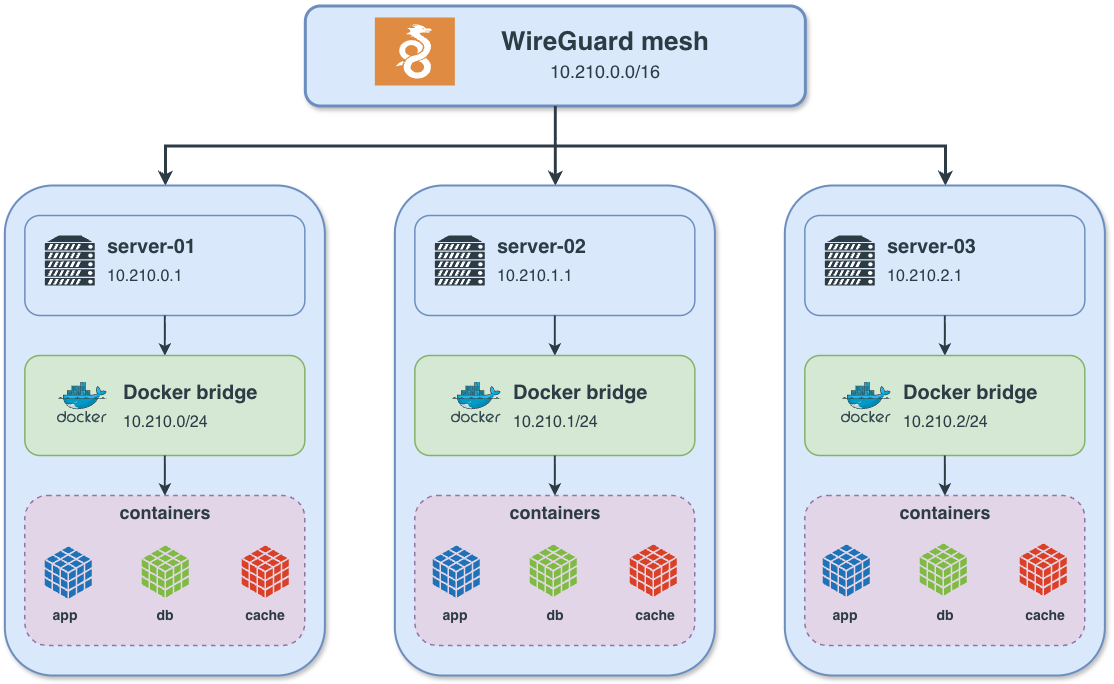
Благодаря этому контейнер получает уникальный адрес во всей кластерной сети.
Для самого контейнера не имеет значения, на каком физическом сервере находится другой: если до его IP-адреса есть маршрут внутри общей WireGuard-сети, трафик может идти напрямую между узлами. Uncloud не строит для этого отдельную традиционную Docker overlay network поверх VXLAN или аналогичного механизма. Вместо этого Docker bridge каждого хоста подключается к своей подсети внутри общей WireGuard mesh-сети, и контейнеры разных хостов получают адреса, доступные из единого приватного пространства.
Таким образом, WireGuard в Uncloud - это не просто защищенный канал между серверами, а сетевой фундамент кластера. Он связывает подсети отдельных машин в единую L3-сеть и делает контейнеры доступными независимо от того, на каком хосте они запущены.
Для просмотра текущего состояния WireGuard можно использовать команду uc wg show. Она позволяет увидеть состояние WireGuard-интерфейсов и peer'ов кластера.
Но одной IP-связности недостаточно. Поверх сетевого уровня необходим механизм service discovery, который должен позволять обращаться к сервису по имени.
Service discovery и DNS
В Uncloud обнаружение сервисов реализовано через внутренний DNS. На каждой машине сервис Uncloud запускает DNS-сервер, который слушает на внутреннем IP-адресе хоста в WireGuard-сети (10.210.X.1) и обслуживает доменную зону .internal. Uncloud отслеживает состояние контейнеров через общее состояние кластера и динамически обновляет DNS-записи.
Для контейнеров точкой входа остаётся родной DNS Docker (127.0.0.11). Uncloud не заменяет его, а настраивает как upstream. При создании контейнера через Docker API Uncloud заполняет поля HostConfig.Dns, и контейнер получает в качестве upstream-сервера адрес Uncloud DNS (10.210.X.1), опцию ndots:1 и домен internal.
Внутри контейнера /etc/resolv.conf будет выглядеть привычно:
```text
nameserver 127.0.0.11
search internal.
options ndots:1
```
Но проверка опции HostConfig
```bash
docker inspect --format='{{.HostConfig.Dns}}' <container_name>
```
вернет массив с указанием адресов WireGuard-сети
```text
# [10.210.1.1]
```
Запросы, не относящиеся к зоне .internal, перенаправляются на вышестоящие DNS-серверы из /etc/resolv.conf хоста или на публичные 1.1.1.1 и 8.8.8.8.
Внутренний DNS поддерживает четыре типа имен:
• <machine-name>.machine.internal — mesh IP-адрес хоста;
• <container-name>.<machine-name>.machine.internal — mesh IP контейнера на определенном узле;
• <service-name>.internal — mesh IP всех контейнеров сервиса - используется непосредственно для service discovery;
• lb.<service-name>.internal — Virtual IP - IP балансировщика, распределяющего трафик на контейнеры сервиса. (Разработчики планируют реализовать этот VIP позже с помощью IPVS, ip/nftables или eBPF).
Текущая архитектура DNS не является окончательной, в планах — внедрить пространства имен по проектам или окружениям для исключения конфликтов.
Для внешнего контура используется Managed DNS от Uncloud (бесплатная облачная служба). Она позволяет автоматически зарезервировать для кластера уникальное имя вида *.xxxxxx.uncld.dev с помощью команды uc dns reserve. В этом режиме встроенный прокси-сервис Caddy автоматически обновляет публичные DNS-записи для маршрутизации входящего трафика к приложениям.
Управлять службой можно также командами uc dns show (посмотреть имя) и uc dns release (освободить домен).
При инициализации машины можно полностью отказаться от Managed DNS, используя флаг --no-dns при запуске uc machine init.
В качестве альтернативы предусмотрена экспериментальная команда uc dns set для привязки стороннего домена, однако его DNS-записи Uncloud автоматически не обновляет.
Что происходит при разрыве сетевой связности
Если часть машин временно теряет связь с остальным кластером, узлы могут видеть различающиеся версии состояния. Поэтому и DNS на разных машинах потенциально может иметь разный набор доступных endpoints.
В документации предусматривается такое поведение: DNS должен корректировать свои записи в соответствии с тем, какие контейнеры доступны в конкретной части сети. Это позволяет reverse proxy на этой стороне сети работать только с доступными контейнерами.
Caddy: ingress, TLS и балансировка
Для внешнего HTTP/HTTPS-трафика Uncloud использует Caddy как reverse proxy. По умолчанию при инициализации кластера Caddy разворачивается как global service - по одному экземпляру на каждой машине. Он принимает входящие соединения на host-портах 80/tcp, 443/tcp и 443/udp. Последний используется для HTTP/3, работающего поверх протокола QUIC.
Для простого случая достаточно описать публикацию сервиса через расширение Uncloud x-ports:
```yaml
services:
  web:
    image: myapp:latest
    x-ports:
      - app.example.com:8000/https
```
Здесь 8000 - порт внутри контейнера, а app.example.com - hostname, по которому сервис будет доступен снаружи.
После uc deploy Uncloud автоматически настраивает Caddy: он начинает принимать запросы для указанного hostname, получает и обновляет TLS-сертификат Let's Encrypt и направляет трафик на здоровые экземпляры сервиса. Если реплик несколько, запросы распределяются между ними.
При этом Caddy не хранит список контейнеров вручную. Uncloud генерирует его конфигурацию на основании текущего состояния сервисов. Поэтому при изменении состава реплик конфигурация ingress также меняется. В частности, в generated Caddyfile появляются актуальные IP-адреса контейнеров в качестве upstreams. Сам Uncloud обновляет эту конфигурацию при изменениях сервиса и его health status.
Это означает, что ingress тесно связан с service discovery и состоянием контейнеров: Caddy получает не абстрактный “backend”, а актуальный набор endpoints, на которые можно отправлять запросы. При этом сам трафик до контейнеров проходит через кластерную сеть.
x-ports предназначен для стандартного сценария: взять HTTP/HTTPS-порт контейнера и опубликовать его через автоматически сгенерированный reverse proxy.
Но иногда требуется более сложная логика — разные маршруты и redirects, несколько имен хостов, аутентификация, кастомные хедеры, кэширование, собственная политика балансировки и дополнительные TLS-настройки. Для таких случаев Uncloud предоставляет расширение x-caddy. В отличие от x-ports, оно позволяет передать собственную конфигурацию Caddy в формате Caddyfile.
Например:
```yaml
services:
  web:
    image: myapp:latest
    x-caddy: |
      example.com {
        reverse_proxy {{upstreams 8000}}
      }
```
Здесь происходит важная вещь: {{upstreams 8000}} — шаблон Uncloud, который подставляет актуальные адреса экземпляров данного сервиса для порта 8000. Поэтому нам не нужно вручную перечислять IP контейнеров. Получается собственная конфигурация Caddy, но список upstreams по-прежнему управляется Uncloud.
Можно использовать более сложную конфигурацию:
```yaml
services:
  web:
    image: myapp:latest
    x-caddy: |
      example.com {
        redir /old/* /new{uri} permanent

        @admin path /admin/*
        basic_auth @admin {
          admin $2a$14$...
        }

        reverse_proxy {{upstreams 8000}} {
          lb_policy first
        }

        header /static/* Cache-Control "public, max-age=604800"
        log
      }
```
В этом примере Caddy одновременно управляет редиректами, аутентификацией, собственными HTTP хедерами и балансировкой между экземплярами сервиса.
x-caddy можно задавать непосредственно в Compose-файле либо передать путь к Caddyfile. Конфигурация обрабатывается как Go template, поэтому Uncloud может подставлять динамические значения (например, список upstreams).
Важно: нельзя использовать x-caddy одновременно с x-ports для одного и того же сервиса.
Для ingress важен еще один момент: в качестве upstreams используются доступные и здоровые экземпляры сервиса. Поэтому изменение состояния контейнеров приводит не только к изменению состояния кластера, но и к изменению маршрутизации и настройкам Caddy.
В особых случаях Caddy можно отключить при инициализации с помощью --no-caddy. При этом прием внешнего трафика, терминация TLS, маршрутизация по доменам и балансировка нагрузки выносятся за периметр Uncloud и реализуются внешними инфраструктурными компонентами или через публикацию портов в host mode.
CLI
Uncloud старается не заставлять оператора подключаться отдельно к каждой машине. CLI может сам подключиться к любому доступному хосту, а тот, в свою очередь, предоставляет доступ к API.
При первоначальной инициализации uc machine init по SSH устанавливает Docker и Uncloud daemon (uncloudd). В актуальной версии демон uncloudd работает как systemd service, а Corrosion запускается как управляемый контейнер. Таким образом, после добавления хоста он становится еще одной точкой входа в кластер.
Практическое следствие: если один узел недоступен, это не означает автоматически, что весь кластер перестал быть управляемым. CLI может использовать другой доступный хост. Это одна из самых сильных идей Uncloud: равноправный узел одновременно является и вычислительным ресурсом, и единицей управления системой.
Функционал остаётся Docker-подобным и основан на команде uc.
Например:
uc machine ls - посмотреть машины.
uc ps - посмотреть запущенные контейнеры.
uc logs backend - посмотреть логи.
uc exec backend sh - зайти в контейнер.
uc scale backend 3 - масштабировать сервис.
uc deploy - выполнить deployment.
Uncloud предоставляет команды для управления масштабированием сервисов.
Например:
```bash
uc scale backend 3
```
Для просмотра и проверки текущей конфигурации Caddy:
```bash
uc caddy config
```
Обновление сервисов
Uncloud поддерживает бесшовное обновление: при обновлении реплицируемого сервиса контейнеры заменяются последовательно, а не останавливаются все одновременно.
Пусть в compose.yaml образ backend изменился с версии 1.0 на 1.1:
Запускаем: uc deploy
Для обычного stateless-сервиса по умолчанию используется порядок start-first: новая реплика запускается до остановки старой.
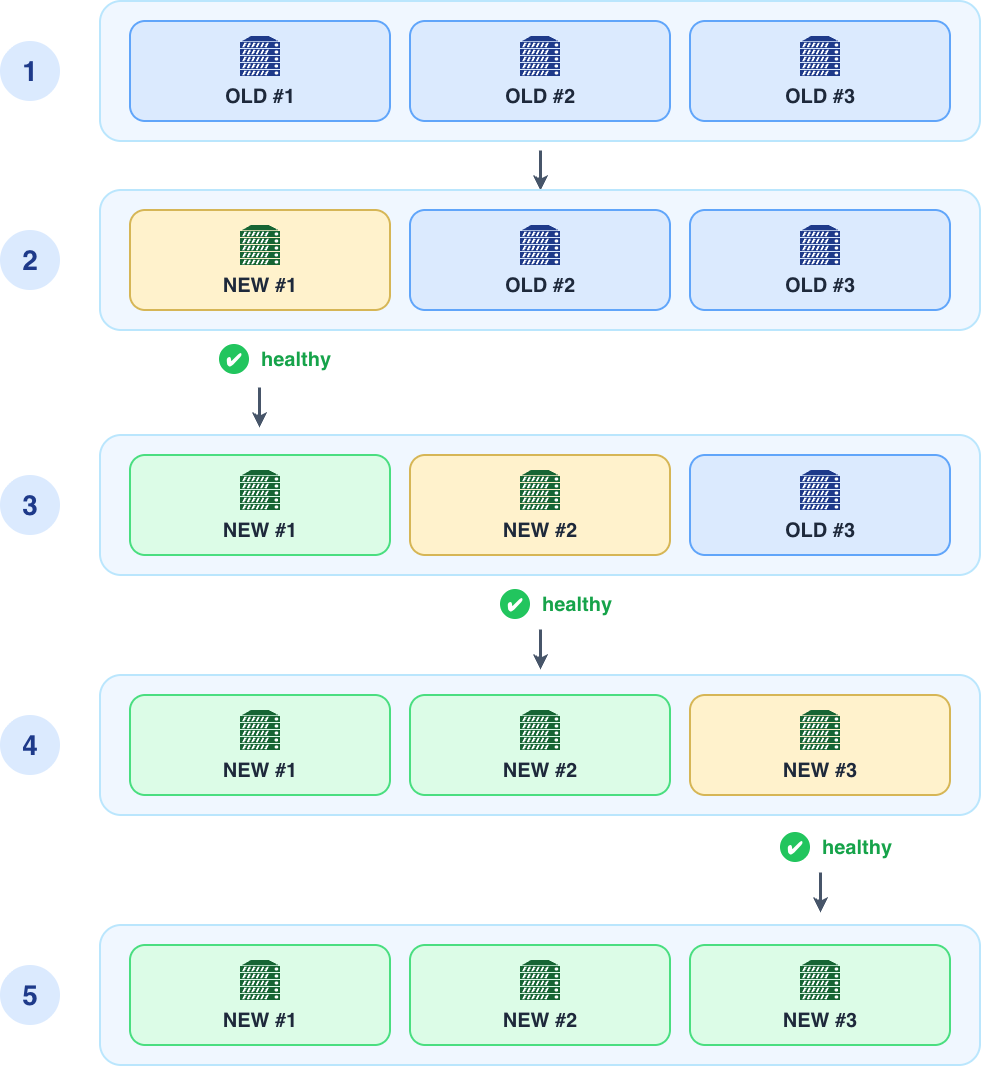
Новый контейнер сначала должен успешно пройти проверки работоспособности, после чего старая реплика удаляется и Uncloud переходит к следующей. К механизму health monitoring и роли Docker healthcheck мы еще вернемся в следующем разделе.
Такой порядок позволяет для stateless HTTP/API-сервисов с несколькими репликами не прерывать обслуживание всего сервиса во время обновления. При этом говорить о безусловном zero downtime всё же не стоит: результат зависит от количества реплик, порядка обновления, конфигурации портов и особенностей конкретного приложения.
start-first и stop-first
start-first - не единственный вариант. Uncloud поддерживает и stop-first, при котором сначала удаляется старая реплика и только затем запускается новая.
Этот порядок можно задать:
```yaml
services:
  api:
    image: myapp:v2.0
    deploy:
      update_config:
        order: stop-first
```
stop-first необходим в ситуациях, когда старая и новая реплика не могут одновременно существовать на одном хосте. Uncloud автоматически использует этот порядок, например, при конфликте host port, когда новый контейнер не может занять порт до освобождения старым.
Он также используется для single-replica service с подключённым volume: одновременный запуск двух экземпляров в таком случае мог бы привести к конкурентному доступу к одному хранилищу. При этом само наличие volume не означает автоматический переход на stop-first для сервиса. Если несколько экземпляров сервиса могут одновременно работать с общим хранилищем, это считается допустимым сценарием и должно быть безопасно с точки зрения самого приложения.
Поэтому выбор порядка обновления связан с моделью приложения.
Важно также не переносить на Uncloud всю модель update_config из Docker Swarm. В текущей реализации поддерживаются только order и monitor, а такие параметры, как parallelism, delay, failure_action и rollback_config не поддерживаются.
Таким образом, rolling update в Uncloud — это относительно простой механизм последовательной замены реплик сервиса.
pre-deploy
Стоит отметить еще одну полезную функцию. Перед обновлением приложения иногда нужно выполнить действие, которое должно завершиться успешно до старта самого сервиса — например, миграцию базы данных.
Для этого в Uncloud есть расширение x-pre_deploy:
```
services:
  api:
    image: myapp:v2
    x-pre_deploy:
      command: ./manage.py migrate
```
Если команда завершается с ошибкой, deployment не продолжается.
Подведем итог
К этому моменту мы собрали основную архитектуру Uncloud.
Несколько обычных Docker-хостов объединяются в кластер с распределенным состоянием на базе Corrosion. Поверх него строится приватная сеть WireGuard, контейнеры получают адреса в общем сетевом пространстве, а service discovery позволяет обращаться к ним по именам, не зная физического расположения реплик. Caddy добавляет внешний ingress, TLS и маршрутизацию трафика, а CLI uc объединяет эти механизмы в единый workflow.
На уровне идеи всё выглядит просто: берём привычный Docker и добавляем ему недостающие возможности для работы с несколькими машинами. Но как только мы начинаем использовать такую систему в реальной инфраструктуре, появляются другие вопросы. Как обновлять сервисы без простоя? Что происходит при падении контейнера или целой машины? Как доставлять образы? Как размещать stateful-сервисы и работать с volumes? Как передавать чувствительные данные? Это и многое другое разберем во второй части статьи.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.