RAG под защитой: как не превратить корпоративную базу знаний в канал утечки
Российские компании уже дали ИИ доступ к внутренним документам и базам знаний. Корпоративную базу знаний подключают к ИИ-ассистенту быстро: выгрузили SharePoint и базу знаний компании, построили индекс, получили чат, который отвечает по регламентам. Вместе с регламентами в индекс попадает всё остальное: черновики с персональными данными, документы с ограниченным доступом, страницы, которые может править любой сотрудник. Векторное хранилище не знает, кому что показывать: оно возвращает то, что ближе по смыслу. А модель не отличает цитату из политики от инструкции, спрятанной в тексте.
Что такое RAG и что нужно защищать?
RAG (Retrieval-Augmented Generation, «генерация с дополненным поиском») – это способ заставить языковую модель отвечать по документам организации, а не только по тому, что она запомнила при обучении. Перед обращением к модели система находит в базе знаний RAG фрагменты, подходящие под вопрос, и добавляет их в запрос как контекст. Модель строит ответ на основе этих фрагментов.
Как это устроено:
Подготовка. Документы режутся на фрагменты, каждый превращается в вектор (Embedding) – это набор чисел, который описывает смысл текста. Векторы хранятся в специальном векторном хранилище.
Поиск. Вопрос сотрудника тоже превращается в вектор, и система находит фрагменты с наиболее близким смыслом.
Ответ. Найденные фрагменты добавляются в запрос к модели, и она формулирует ответ, обычно со ссылками на источники.
RAG используют там, где ответ должен опираться на внутренние знания компании: ассистенты по регламентам и политикам, сервисы поддержки сотрудников и клиентов, поиск по SharePoint и файловым ресурсам, справочные системы по договорам и технической документации. Главные причины его популярности: ответы остаются актуальными без дообучения модели (обновили документ – обновился ответ), их можно проверить по ссылкам на источники, а сами данные не покидают инфраструктуру организации.
Для безопасности из этого следует важное: каждый документ в индексе становится частью запроса к модели, а значит, защищать нужно не только модель, но и всё, что в неё «подкладывается».
RAG добавляет четыре риска, которых нет у обычного обращения к модели: отравление базы, обход прав, выкачивание и выдумывание. Фильтр промптов на входе и выходе эти риски не закрывает: проблема живёт в данных и в хранилище, а не в тексте вопроса.
Защита строится вокруг трёх точек: что попадает в индекс, что достаётся из индекса и на чём построен ответ.
В этой статье разбираем, почему RAG стал отдельной поверхностью атаки и как выглядит контур защиты на примере INFERA AI.Firewall.
Четыре риска, которые добавляет RAG
1. Отравление базы
Инструкция, спрятанная в документе («игнорируй прежние указания»), срабатывает у каждого, чей вопрос приведёт к этому фрагменту. Доступ к чату для этого не нужен: достаточно права записи в любой источник, будь то wiki, общая папка или внешняя выгрузка. Это не теория. В исследовании PoisonedRAG (USENIX Security) показано, что для заранее выбранного вопроса достаточно подмешать пять специально составленных текстов в базу из миллионов, чтобы в 90% случаев модель выдала ответ, нужный атакующему.
2. Обход прав
Хранилище само не знает, кому какой документ можно показывать. Поиск по сходству возвращает ближайшее по смыслу, а не разрешённое. В OWASP Top 10 LLM это отдельная уязвимость LLM08 «Vector and Embedding Weaknesses»: запросы к векторному хранилищу без проверки прав дают выдачу по одной лишь близости эмбеддингов. Простая иллюстрация: в индекс попали общий регламент и приказ о премировании руководителей. Вопрос «как считается премия» вернёт оба документа любому, кто спросит.
3. Выкачивание
Векторы хранят больше, чем кажется. Эмбеддинг (embedding) – это набор чисел, в который система превращает фрагмент текста для поиска. Принято считать, что по такому набору исходный текст не восстановить, но исследования показывают обратное. Краткие тексты утекают с высокой точностью, а длинные фрагменты точно восстановить почти не получается, но общий смысл всё равно утекает, и этого достаточно, чтобы раскрыть содержание документа. Поэтому векторы нужно защищать как исходные документы: не выгружать «для аналитики», хранить в зашифрованном виде, а массовое извлечение выдачи через легитимный интерфейс нужно ограничивать и отслеживать.
4. Выдумывание
Когда в базе знаний нет ответа, модель всё равно может ответить уверенно и без ссылок. Для CISO это риск целостности: на основе такого ответа принимают решения, а в государственных системах контроль достоверности уже стал нормативным требованием. В OWASP этот класс уязвимости описан как LLM09 «Misinformation».
Принцип: контур в разрыве между приложением и хранилищем
Расскажем, как реализован контроль на примере INFERA AI.Firewall.
Архитектура решения: контур защиты встаёт в разрыв между приложением и векторным хранилищем и говорит с приложением на языке хранилища.
Чат-киоск или любое другое приложение обращается к базе знаний обычным способом, ничего не меняя у себя, но попадает в контур, а не напрямую в хранилище. Обращения к модели, к базе знаний и к инструментам ИИ-агента идут через один контур с общей политикой и общим журналом.
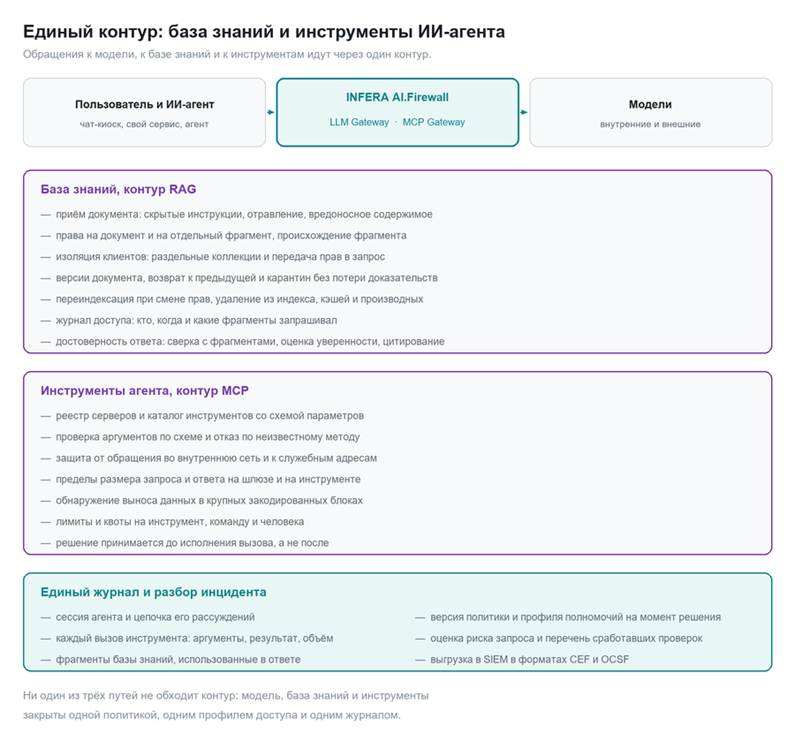
Практические следствия такой схемы:
документы принимает панель INFERA, а не приложение: во внешней базе знаний приложение работает только на чтение;
запрос к модели с найденным контекстом идёт через тот же конвейер, что и обычные обращения, поэтому проверка ответа не требует отдельной интеграции;
обращение к источнику в состоянии «Не разрешён» отклоняется с понятной причиной и попадает в журнал обращений.
Соответствие рисков и механизмов:
Риск | Что происходит | Чем закрывается |
Отравление базы | Инструкция или ложный факт в документе срабатывает у всех, чей вопрос найдёт этот фрагмент | Реестр источников, проверка при приёмке, карантин, версии и откат |
Обход прав | Хранилище возвращает похожее по смыслу, а не разрешённое | Права на документ и фрагмент, вырезание до модели, журнал «найдено и отсеяно» |
Выкачивание | Накопленные векторы позволяют восстановить исходный текст | Пределы частоты и объёма, детект перебора коллекций, шифрование векторов и индексов |
Выдумывание | Уверенный ответ без опоры на документы | Сверка с фрагментами, оценка уверенности, ссылки на источники, контрольные наборы |
RAG: слои контроля и защиты
Слой 1. Реестр источников
Первое, чего не хватает большинству RAG-проектов, это перечня того, что вообще попадает в индекс.
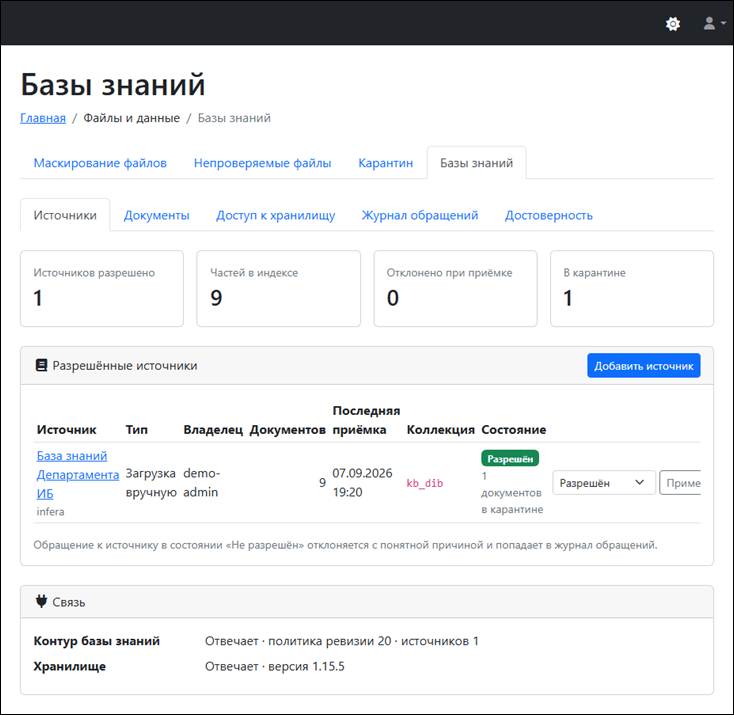
В реестре INFERA AI.Firewall каждый источник имеет состояние «Разрешён», «В карантине» или «Не разрешён» и привязан к коллекции хранилища, организации и владельцу. Поддерживаются типы: загрузка вручную, SharePoint, Confluence, файловый ресурс, веб-выгрузка. Разделение клиентов или подразделений делается разными коллекциями.
У каждого источника есть владелец, который отвечает за содержимое: при инциденте понятно, к кому идти. Состояние переключается прямо в строке реестра, поэтому реакция на подозрительный источник занимает секунды: перевести в карантин или запретить, не трогая приложение.
Также видны счётчики: сколько источников разрешено, сколько частей в индексе, сколько документов отклонено при приёмке и сколько находится в карантине.
Слой 2. Проверка документа до попадания в поиск
Проверка стоит на входе: документ анализируется на скрытые инструкции для модели, признаки отравления и противоречия до того, как попадёт в поиск. Настраиваются порог риска приёмки и действие при находке: поместить в карантин, отклонить или принять с извещением. Принимаются файлы .txt, .md и .docx.
У документа пять состояний: «В индексе», «Переиндексируется» (например, после смены прав), «В карантине», «Отклонён при приёмке» и «Удалён из индекса». У документа в карантине прямо в списке названа находка, например, «игнорировать все формы». Такой документ в поиск не попадает, но сохранён для разбора.
Принципиальный момент – поведение при сбое. Если служба проверки недоступна, приёмка отклоняется: непроверенный документ в индекс не допускается (fail-closed). Для CISO это компромисс между доступностью и безопасностью, и принимать его нужно осознанно: при остановке сервиса проверки новые документы в базе знаний не появятся, зато и непроверенное не пройдёт.
Слой 3. Версии, откат и необратимое удаление
Каждый документ ведётся версиями. В истории видны: версия, дата загрузки, кто загрузил, что изменилось, число частей и состояние. Из карточки документа выполняется возврат к предыдущей версии: если отравление обнаружили позже, откат занимает минуты, а не ручную переиндексацию.
Удаление при этом намеренно необратимо: векторы вычищаются из хранилища, версии удаляются, документ можно только принять заново. Запись об удалении остаётся: контур продолжает отказывать по этому идентификатору, и видно, кто и когда удалил.
Слой 4. Права на уровне документа и фрагмента
Права задаются на документ и на его отдельные части.
В INFERA AI.Firewall в карточке документа есть блок «Кто может найти этот документ»: кому, какие части и откуда взялось право. Если права не заданы, документ доступен всем, кто вправе обращаться к его коллекции, и панель пишет об этом прямо, поэтому молча открытых документов не остаётся.
Ключевая техническая деталь – где именно применяются права. Приложения нередко не сообщают хранилищу «кто спрашивает» и тогда фильтр на стороне хранилища бессилен. Поэтому рубежей контроля два. Контур отсеивает фрагменты без прав и фрагменты документов в карантине до того, как выдача уйдёт приложению. Затем конвейер защиты, где сотрудник известен всегда, повторно вырезает недоступное из контекста до обращения к модели. Сотрудник об этом не узнаёт: недоступных фрагментов в контексте просто нет, и модель не сможет ни пересказать, ни процитировать их.
Слой 5. Пределы обращений и детект разведки
Этот слой отвечает на угрозу выкачивания. Панель объясняет смысл прямо на экране: по накопленным векторам можно восстановить исходный текст, если получить их достаточно много, поэтому ограничиваются частота и объём выдачи, а перебор коллекций распознаётся отдельно. Мониторинг паттернов доступа к хранилищу для выявления массового сбора данных рекомендует и OWASP.
Параметр | Зачем нужен |
Запросов в минуту на человека и на приложение | Ограничивает частоту обращений сотрудника и программы |
Частей за сутки на человека | Задаёт «бюджет» фрагментов, которые можно получить за день |
Повторы одного запроса за час | Ловит механический перебор одного и того же вопроса |
Коллекций за пять минут | Признак разведки: обращение ко многим коллекциям подряд |
Шифровать векторы и индексы | Хранение содержимого индекса в зашифрованном виде |
Отклонять при превышении | Если выключено, обращение выполняется, но помечается |
Практический совет по внедрению: сначала включить пределы в режиме пометки, собрать картину обычной нагрузки (аналитики и интеграции ходят в базу заметно чаще остальных), и только потом включать отклонение, чтобы не сломать легитимные сценарии.
Слой 6. Журнал обращений
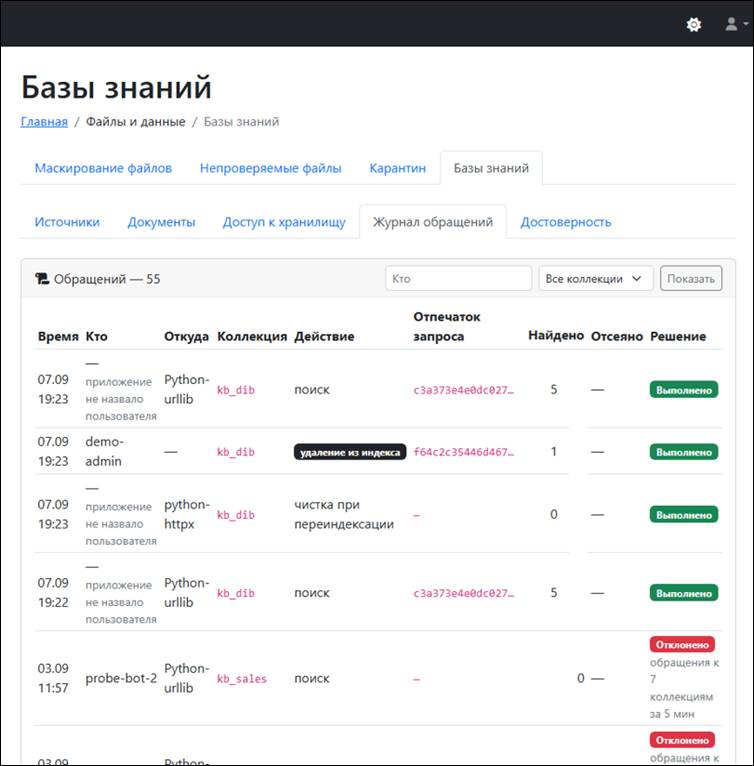
Журнал INFERA AI.Firewall фиксирует каждое обращение к базе знаний: время, кто, откуда, коллекцию, действие (поиск, индексация, удаление из индекса, чистка при переиндексации), отпечаток запроса, число найденных и отсеянных фрагментов и принятое решение. Колонка «Отсеяно» отвечает на вопрос «что человек не увидел»: сколько найденных фрагментов убрано по правам или карантину до выдачи приложению. Для аудита это доказательство того, что разграничение прав работает в цифрах, а не только в настройках.
Текст вопросов по умолчанию не сохраняется, хранится только отпечаток, иначе журнал вопросов к корпоративной базе стал бы самым большим хранилищем чужих дел.
Слой 7. Достоверность ответа
Последний слой отвечает на риск выдумывания. Ответ, построенный по базе знаний, сверяется с фрагментами, на которых он основан. Проверка реализована шагом конвейера «Достоверность ответа (база знаний)», то есть тем же способом, что и остальные проверки, и работает на направлении «Ответ модели».
Основные настройки:
Порог уверенности ответа: ниже него ответ помечается как не подтверждённый источниками. В требованиях заказчиков встречается порог 70 из 100, ниже которого фиксируется как событие. Слишком высокий порог объявит неподтверждённым любой пересказ текста своими словами.
Требование ссылок на источник: ответ без ссылок считается нарушением и обрабатывается выбранным действием.
Блокировка ответа, если проверка не состоялась: при недоступной службе ответ по базе знаний не выдаётся.
Действие при низкой уверенности может выбираться. Например, пометить ответ или отправить на решение оператора по выбранным темам. Для чувствительных тем (юридические, финансовые, кадровые) ручная проверка до выдачи оправдана, для остальных хватает пометки.
Отдельно настраиваются контрольные наборы: списки вопросов с известными правильными ответами. По ним контур регулярно проверяет, отвечает ли модель по базе знаний или домысливает, и сравнивает фактическую долю неподтверждённых ответов с целевой. Пока набора нет, долю посчитать не на чем, хотя оценка отдельных ответов на живом потоке работает и без него. Для CISO это удобная метрика качества: целевая доля неподтверждённых ответов превращается в измеримый показатель сервиса.
Что видит сотрудник
Со стороны пользователя ничего не ломается: коллекция знаний подключается к переписке в чате, вопрос задаётся как обычно. Отличия видны в ответе. Появляются ссылки на источники, ответ с низкой уверенностью получает приписку, по выбранным темам ответ ждёт решения оператора, а фрагменты, к которым у сотрудника нет прав, в ответе не участвуют, и он об этом не узнаёт.
Как внедрять: дорожная карта для CISO
Ставить все слои в боевой режим одновременно не нужно. Рабочая последовательность выглядит так:
Инвентаризация. Составьте перечень источников базы знаний, назначьте владельца каждому и отметьте, где лежат персональные данные и коммерческая тайна. Источник без владельца в реестр не попадает.
Режим наблюдения. Включите приёмку с действием «принять и известить» и пределы обращений с пометкой вместо блокировки. Цель этого этапа: увидеть реальную картину, сколько находок, какая нагрузка, какие приложения не передают имя пользователя.
Режим принуждения. Переведите подозрительные находки в карантин, задайте права на документы с ограниченным доступом, включите отклонение при превышении пределов и вырезание недоступных фрагментов из контекста.
Достоверность. Соберите контрольный набор вопросов с известными ответами, задайте целевую долю неподтверждённых ответов и порог уверенности. Для чувствительных тем включите передачу на решение оператора.
Регулярный контроль. Включите метрики в отчётность и пересматривайте пороги по результатам.
Корпоративная база знаний работает как продолжение промпта каждого сотрудника, поэтому защищать её нужно как продукционную систему: с реестром источников, контролем входа, правами на уровне фрагмента, лимитами на выдачу и проверкой готового ответа. Рынок пока внедряет ИИ быстрее, чем защищает. Регуляторы при этом уже сместились к конкретным требованиям: достоверность ответов, защита данных, внимание к ИИ-агентам.
Практическая рекомендация одна: начните с инвентаризации источников и режима наблюдения. Это даёт реальные цифры для бюджета и показывает, где в вашей базе знаний уже лежит то, чего там быть не должно.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.