«Донащупывая» Data Lineage
Добрый день, Хабр! В рамках основной деятельности — проектирования витрин данных в корпоративных хранилищах, — неизбежно сталкиваюсь с вопросом происхождения данных. Проще говоря, необходимо понять, кто и когда, как, из чего и в чьих интересах собрал попавшийся под руку датасет. Обновляется ли срез данных и есть ли у него пользователи? Для такого процесса в мире DWH давно укоренилось название «построить Data Lineage». Предлагаю вместе со мной еще раз пройтись по определению и попробовать его уточнить, так сказать, донащупать.
Определение как концепция
А зачем вообще заниматься донащупыванием? Разве нет точного определения? Есть. Однако хадэшная литература и интернет-ресурсы раскрывают понятие Data Lineage не более чем на концептуальном уровне. Суть определения составляет требование к метаинформации — быть источником сведений о родословной рассматриваемого объекта. Практическое наполнение концепции, будь то редкая монография, частная корпоративная разработка или вендорский инструмент, носит авторский характер. Системность остается за кадром. Этот факт значительно усложняет унификацию работы с Data Lineage, особенно, когда кто-то из заказчиков приходит с формулировкой: «А давайте мы все-таки его построим».
Пример определения из книги «Свод знаний по управлению данными» (DAMA Book).
Data Lineage – это путь, по которому данные движутся от места своего возникновения до места своего использования, иногда называемый цепочкой данных (data chain). Одним из способов документального оформления происхождения данных являются потоки данных, которые фиксируют маршруты прохождения данных через бизнес-процессы и системы. Описанный от начала до конца поток данных показывает, где данные возникают, где хранятся и используются, а также все преобразования данных в процессе их движения как внутри, так и между различными процессами и системами. Потоки могут документироваться с разной степенью детализации — до уровня предметной области, сущности или даже атрибута.
Так в определении описывается информация о движении данных от источников до точки сборки и требования к промежуточным точкам такого движения.
Для более детального понимания, почему Data Lineage скорее является картиной в стиле импрессионизма, чем фотографией, приведу сравнение. Возьмем понятие «информационная модель». При разработке информационной системы создание модели обязательно. Шаблон обрабатываемой информации должен быть — это концептуальное требование. Каким именно он будет — вопрос практической реализации. Важно то, что всевозможные практики уже известны. Нет смысла заново придумывать нотацию «Воронья лапка» — все уже есть, как говорится cел и поехал. Причем, реализации будут выглядеть плюс-минус одинаково в разных инструментах. А при переносе информационной модели, разработанной в инструменте «А», в инструмент «Б», возникающие проблемы должны носить сугубо технический характер. В отличие от реализации информационной модели, имплементация Data Lineage выглядит творческой задачей.
К сути
Во всех определениях помимо прочего есть требование возможности отслеживания происхождения данных: какая информация из какой собиралась и как именно. Поэтому в основе реализации логично использовать ориентированный граф (directed graph). Уточним вид этого графа, есть ли у него еще какие-то свойства, и что стоит в узлах? Так как данные переливаются из одной структуры в другую, первое и очевидное желание взять в качестве узлов сами эти структуры — таблицы, вьюхи, матвьюхи, файлы, дашборды и т. п. В общем, все то, что можно покрутить, повертеть и посмотреть. Такой подход вполне себе рабочий, до того момента, пока одна и та же таблица не встретится два раза подряд. Возможна ситуация, при которой данные извлекаются из одной таблицы, преобразуются, обогащаются дополнительными сведениями и укладываются в туже самую таблицу вместо извлеченных строк, фактически происходит UPDATE. В Data Lineage в качестве источника и приемника используется одна и та же структура - мы получили цикл. Если таких апдейтов несколько подряд, то картинка будет выглядеть еще запутаннее: две петли без возможности понять очередность исполнения.
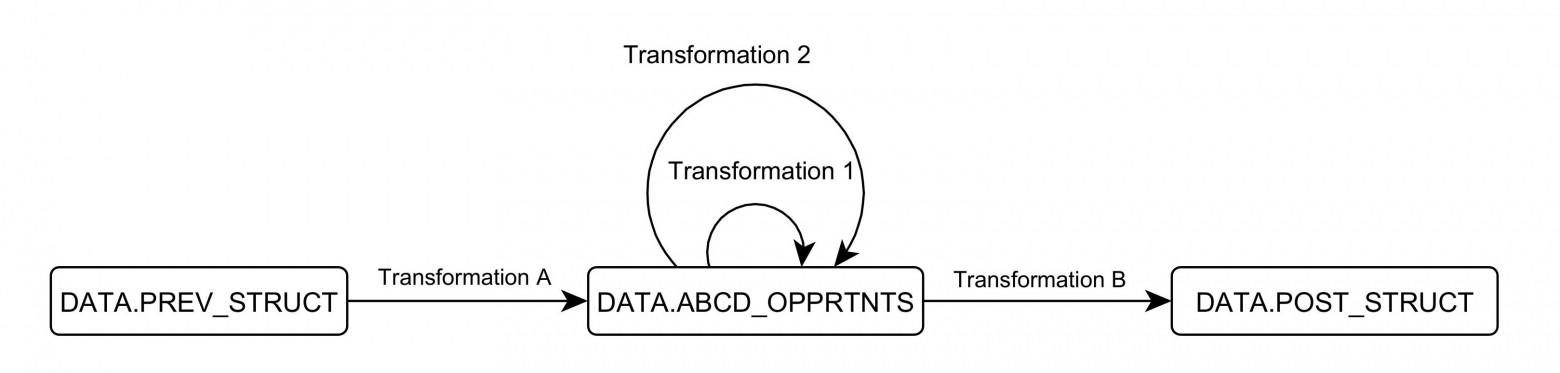
Нельзя назвать это грубой ошибкой, но отследить последовательность трансформаций и выполнить требования определения Data Lineage уже не так просто.
Другая картина получается, если вместо структуры данных (data structure) в качестве узла графа взять состояние данных (data state), после той или иной трансформации. Имена структур, ассоциированных с состоянием данных, в свою очередь становятся частью дополнительной информации о вершине графа (на рисунке выделены в отдельные ноды, обозначенные пунктиром).
Циклы исчезают, а ориентированный граф дополнительно становится ацикличным (directed acyclic graph).
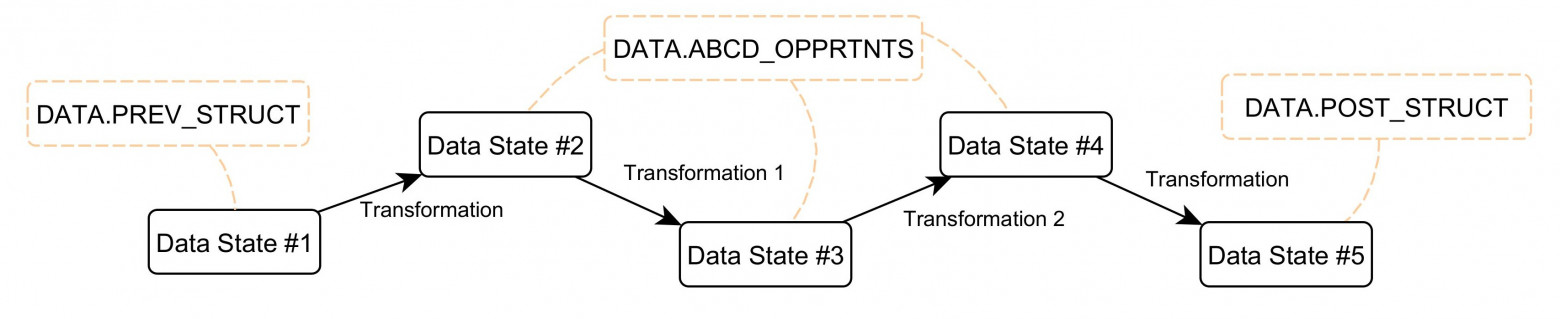
Исходя из изложенного можно заключить, что основой любой реализации Data Linege должен быть ориентированный ациклический граф состояний данных (DAG of data states). Под изменением состояния данных в первую очередь понимается применение к какой-либо трансформации к исходному состоянию. Также можно рассматривать изменение платформы обработки информации или структуры.
Справедливости ради надо сказать, что аббревиатура DAG в последнее время все чаще встречается когда речь заходит о происхождении данных в том или ином инструменте. Так, концептуальной основой, спрятанной под капот Apache Airflow и DBT, является ациклический орграф.
Вместо заключения
Сделанный в предыдущем абзаце вывод позволяет более осознанно подходить к вопросу создания Data Lineage и работе с уже имеющимся инструментарием. Дополнительно можно говорить о появлении двух свойств.
Гибкость построения. В такой формулировке сквозной Data Lineage может быть построен от точки зарождения данных до точки использования в любом техническом окружении, а уровень детализации диктуется не только инструментарием, но и решением пользователя. Так, ненужные технические алгоритмы можно скрыть за одним-двумя блоками. Наоборот — одиночная трансформация может быть «раскрыта» в виде последовательности нескольких понятных действий.
Связующее звено между реализацией и бизнес-постановкой. Заметим, что бизнес-требования заказчика только в BRD выглядят как художественный текст, иногда разбавленный формулами и картинками. Всегда алгоритм сборки витрины можно представить как последовательное преобразование объектов корпоративной модели данных — тот же ориентированный граф состояний данных. И теперь сравнение замысла и реализации можно свести к сравнению объектов одной и той же природы.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.