Первые 5 минут инцидента: чек-лист дежурного
В первые минуты инцидента важнее всего не скорость, а порядок. Когда сыплются алерты, руки сами тянутся перезапустить сервис или что-нибудь удалить. А причину быстрее находит тот, кто проходит одни и те же шаги в одном и том же порядке.
Ниже мой чек-лист для Linux-сервера: пять шагов, по нескольку команд на каждый. Я собрал его, пока делал 13 кейсов для тренажёра дежурств (о нём была первая статья). Поэтому у каждого шага есть пример из кейса, где именно он находит причину.
За пять минут чинить не обязательно. Задача этих минут — понять, в каком слое проблема, и ничего не сделать хуже.
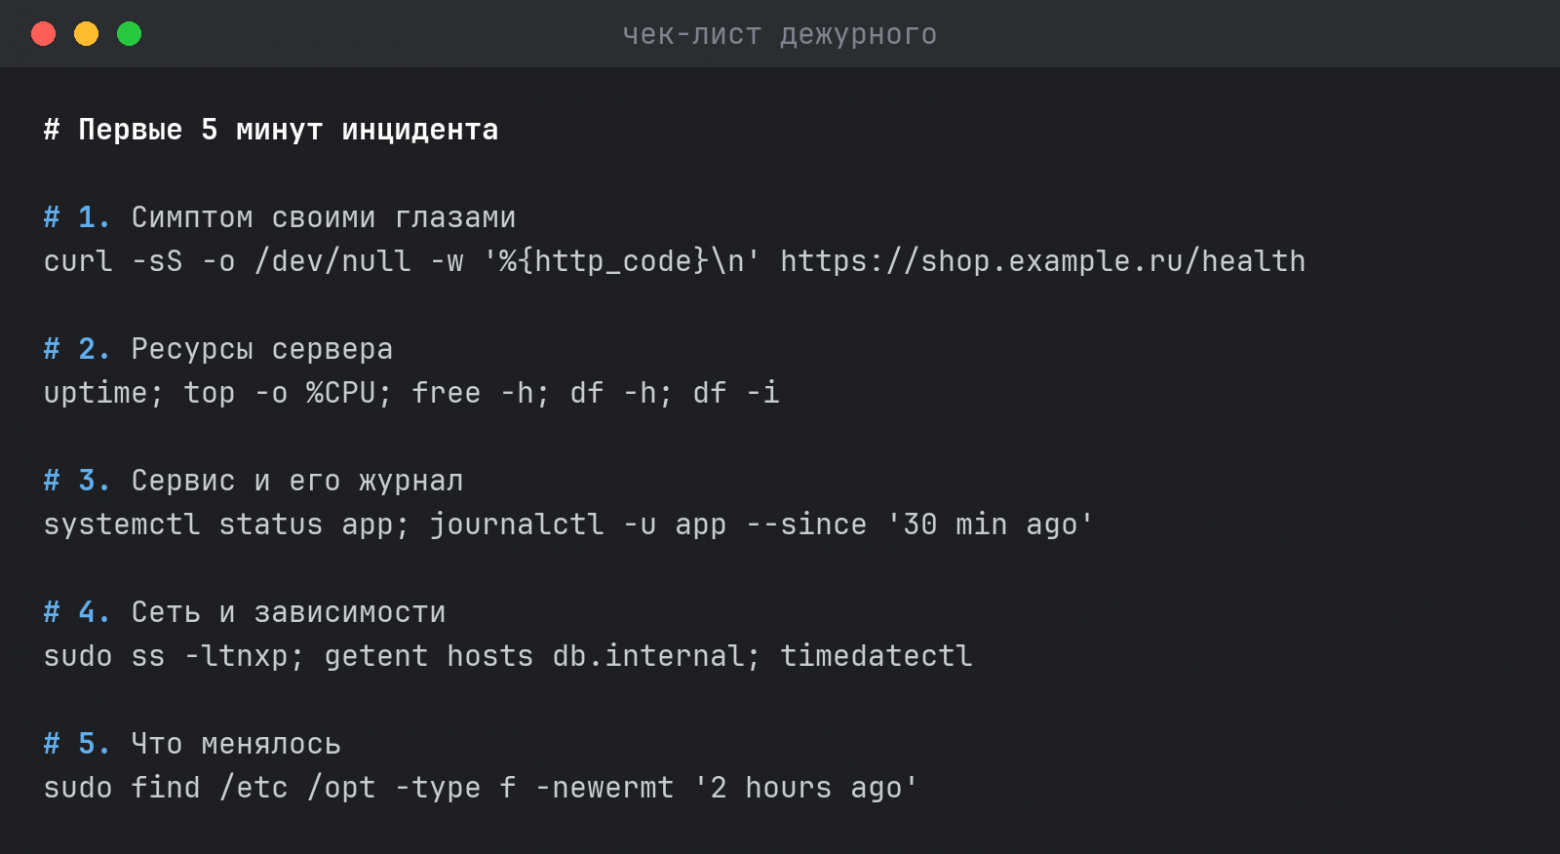
Алерт говорит «сайт не работает», но «не работает» бывает разным. Первым делом сделайте тот же запрос, что и пользователь, а потом тот же запрос напрямую к приложению, мимо nginx:
curl -sS -o /dev/null -w '%{http_code} %{time_total}s\n' https://shop.example.ru/health
curl -sS -v http://127.0.0.1:8080/health
Код ответа уже называет слой, в котором стоит искать:
502 или 504 — nginx жив, а приложение за ним не отвечает или слушает не тот адрес;
500 — приложение работает, но падает на запросе: часто виновата база, диск или что-то ещё снаружи;
таймаут — сервер перегружен или запрос не доходит по сети;
ошибка TLS — сертификат или, что неочевидно, часы сервера.
В кейсе про 502 nginx запущен и принимает соединения, и тот, кто начинает с «перезапущу nginx», теряет время. Запрос напрямую на адрес приложения сразу показывает, что проблема между nginx и приложением, а не в самом nginx.
Шаг 2. Ресурсы сервера
Процессор, память и диск проверяются за минуту, и в пяти из 13 моих кейсов след виден уже здесь. Поэтому смотрю их до логов приложения:
uptime                               # load average против числа ядер (nproc)
top -o %CPU                          # кто ест процессор; в top клавиша M — по памяти
free -h                              # смотрите на available, а не на free
sudo dmesg -T | grep -i 'out of memory'   # убивал ли кого-то OOM Killer
df -h                                # место
df -i                                # inode — про них забывают чаще всего
Два случая, где этот шаг легко пройти мимо:
«No space left on device», а
df -hпоказывает 70% свободного места. Кончились не байты, а inode: кто-то наплодил миллионы мелких файлов. Их найдётsudo du --inodes -s /srv/app/* | sort -n.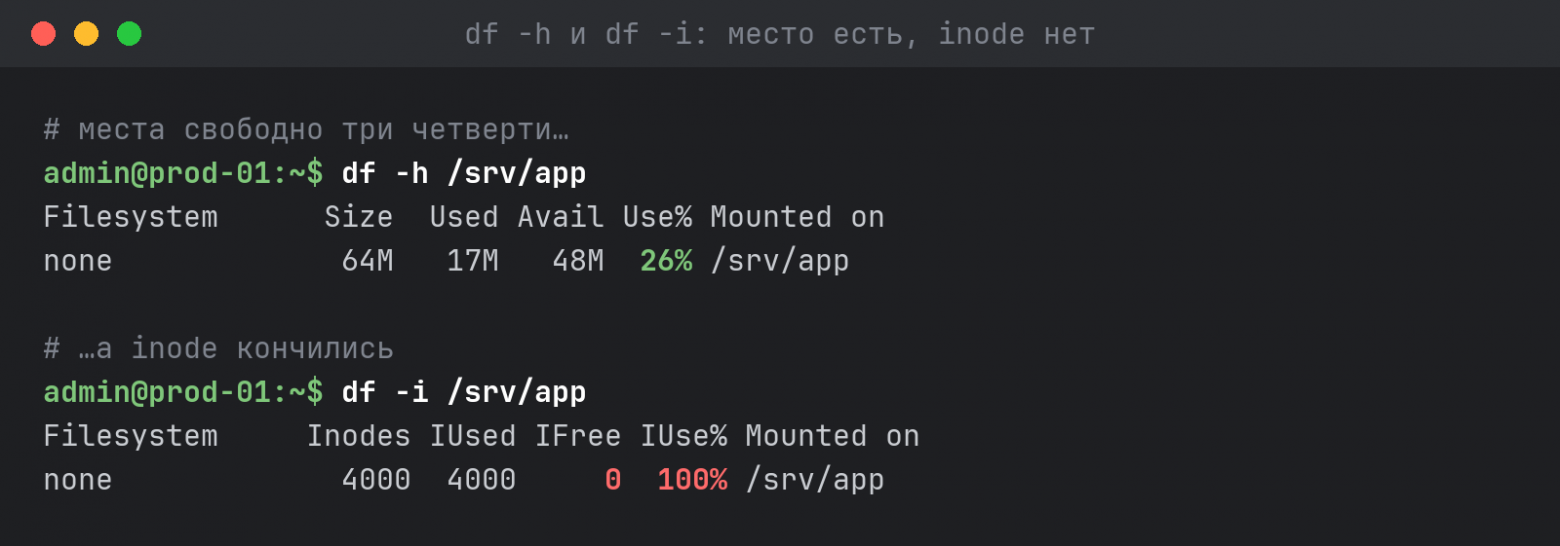
Сервис падает сам по себе, в его логах пусто. Его убило ядро из-за нехватки памяти, и след остался только в
dmesg. Убитый процесс при этом часто не тот, кто съел память: виновника покажетps aux --sort=-%mem | head.Шаг 3. Сервис и его журнал
Если ресурсы в порядке, спрашиваем сам сервис, что с ним:
systemctl status shop-app                          # запущен ли, код выхода, счётчик рестартов
journalctl -u shop-app --since "30 min ago" --no-pager
systemctl cat shop-app                             # юнит вместе со всеми drop-in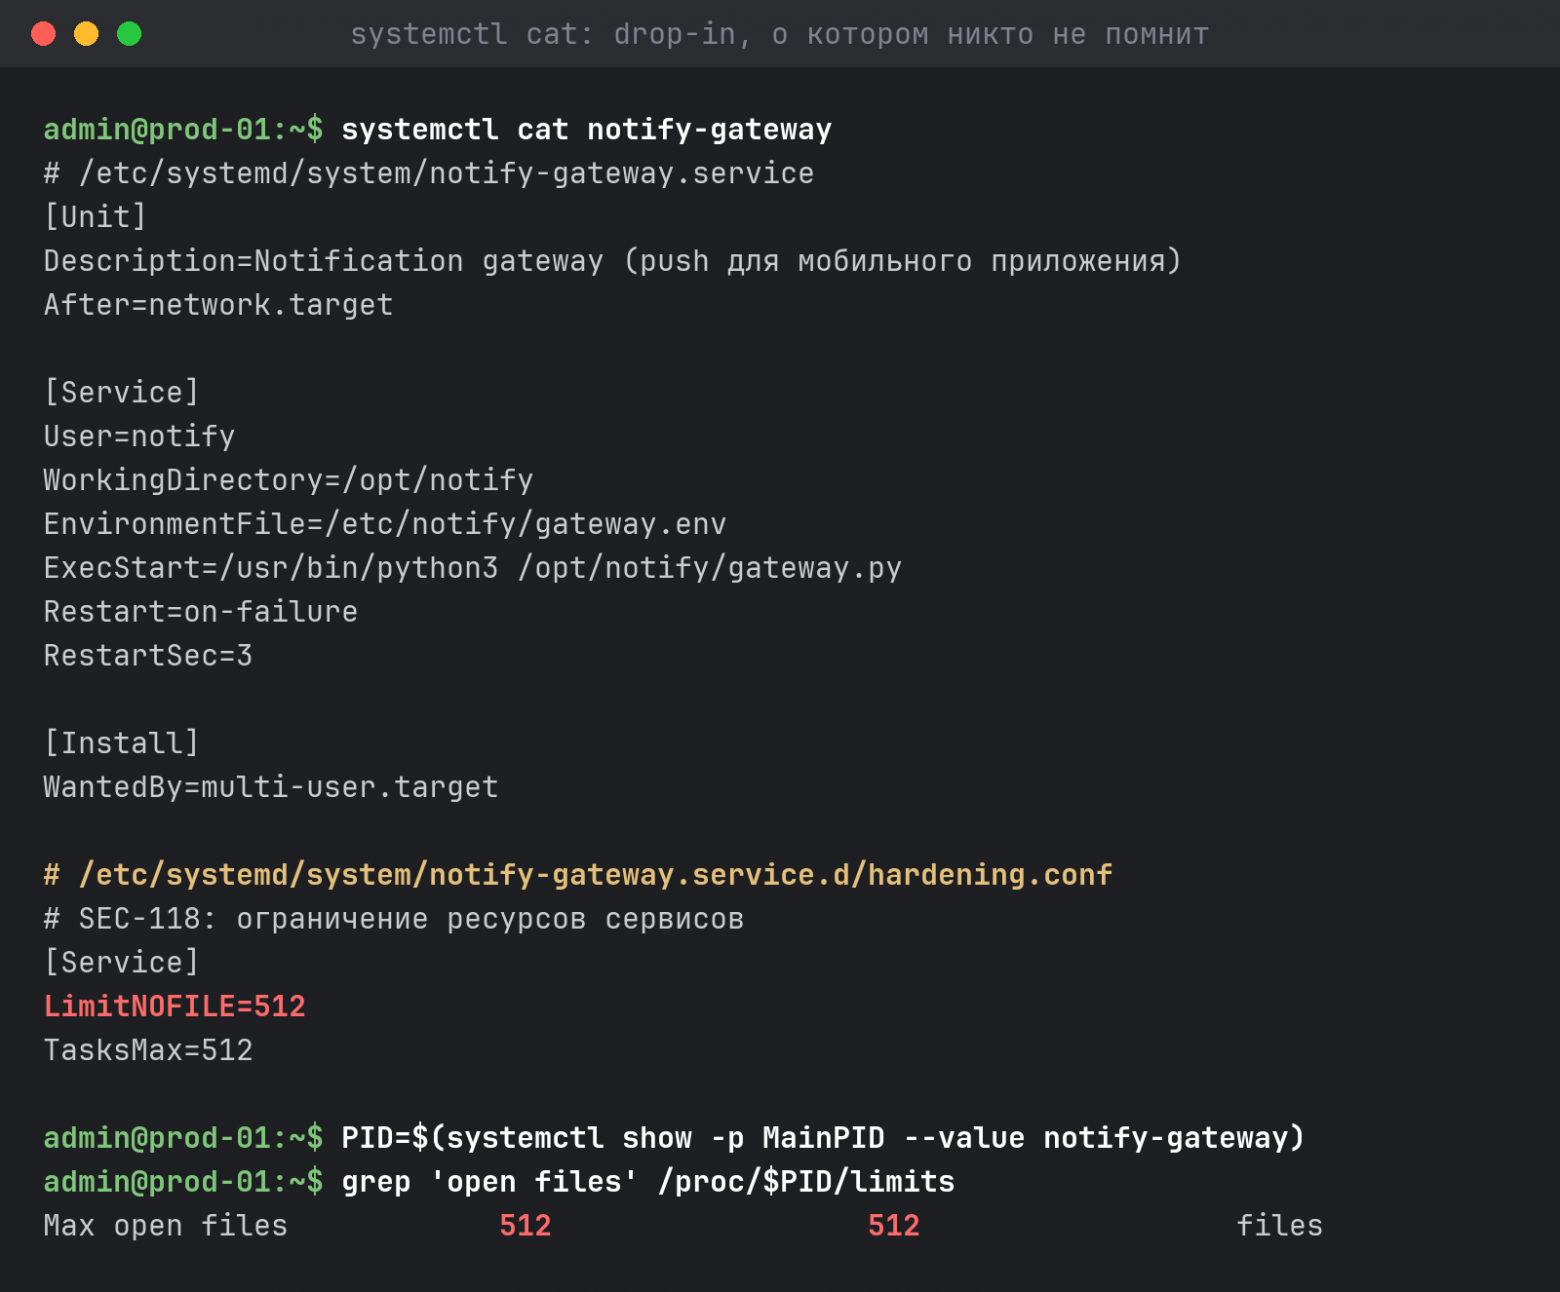
В журнале ищите первую ошибку, а не последнюю. Сервис сRestart=alwaysпадает по кругу, и конец журнала забит одинаковыми последствиями. Причина обычно в строке перед первым падением.systemctl catнедооценен. Он показывает не только юнит, но и все drop-in из*.service.d/, которые мог подложить деплой или скрипт «усиления безопасности». В кейсе про «Too many open files» один из вариантов именно такой: лимит дескрипторов снизил drop-in, о котором никто не помнит. Реальный лимит работающего процесса покажет/proc/<PID>/limits.У некоторых сервисов свой лог помимо журнала: PostgreSQL пишет в
/var/log/postgresql/, nginx — в/var/log/nginx/error.log. В кейсе с упавшим PostgreSQL ошибка в его логе сразу называет параметр и файл, который добавил деплой.Шаг 4. Сеть и зависимости
Сервис запущен и в журнале жалуется на подключение? Значит, проблема между ним и тем, к чему он ходит:
sudo ss -ltnxp                      # кто что слушает: TCP-порты и unix-сокеты
getent hosts gateway.pay.internal   # имя так, как его ищет приложение
dig gateway.pay.internal            # что отвечает DNS
pg_isready -h 127.0.0.1             # жива ли база
timedatectl                         # синхронизированы ли часы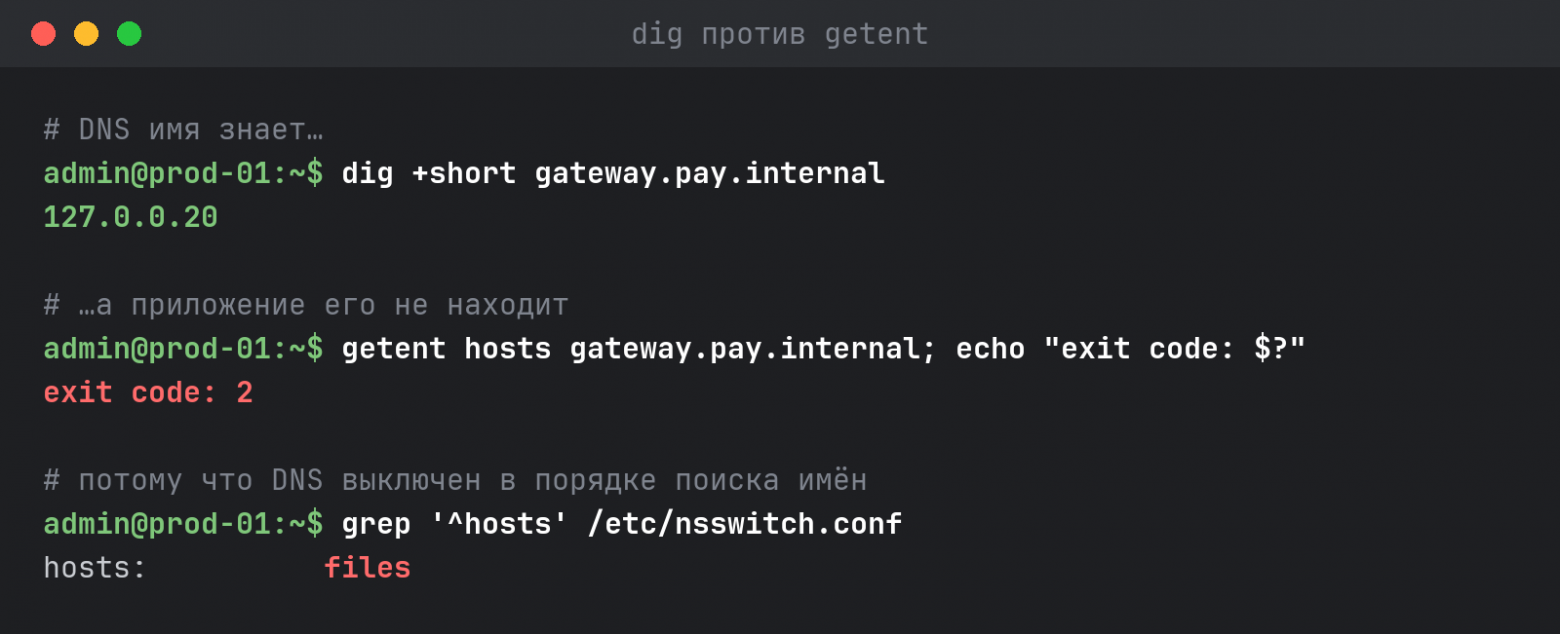
Сравнивайте не «работает / не работает», а то, куда ходит приложение, с тем, где сервис на самом деле:В кейсе про 502 nginx идёт на один порт, а приложение после релиза слушает другой. Адрес из строки
upstreamвerror.logи выводssне совпадают — причина найдена.В кейсе с платёжным шлюзом
digотвечает правильно, аgetent— нет: после скрипта харденинга в/etc/nsswitch.confосталосьhosts: files.digспрашивает DNS напрямую, а приложение ищет имя через libc, какgetent.Ошибки TLS к чужому API и «token used before issued» в одном журнале указывают не на сертификаты и не на авторизацию, а на часы сервера. Хватает одного
timedatectl.Шаг 5. Что менялось
Самый полезный вопрос на инциденте — «что поменялось перед тем, как сломалось?». Релиз, правка конфига, обновление пакетов, чей-то скрипт. В большинстве моих кейсов причина именно такая, как и на настоящих серверах.
sudo find /etc /opt -type f -newermt '2 hours ago'   # что правили за последние 2 часа
tail -n 30 /var/log/apt/history.log                  # что ставили и обновляли
last -n 10                                           # кто заходил на сервер
kubectl rollout history deployment/api               # если дело в Kubernetes
Если изменение нашлось и по времени совпадает с алертом, откат почти всегда быстрее и безопаснее, чем подбор исправления посреди ночи. Разбираться, что именно в релизе не так, можно утром.
Но откат помогает, только если изменение прошло через деплой. В кейсе про CrashLoopBackOff есть вариант, где ConfigMap поправили руками:
kubectl rollout undoвернёт предыдущую версию деплоймента, но поды продолжат падать с тем же сломанным конфигом.Чего не делать
Первые минуты чаще всего портят не незнанием команд, а тремя рефлексами.
Перезапускать всё подряд. Рестарт стирает улики: процесс, который тек, его открытые файлы и соединения. А сервис со сломанным конфигом после рестарта просто не поднимется, и к старой проблеме добавится новая. Сначала
statusи журнал, потом осознанный рестарт.Удалять логи вслепую.
rmлога, который держит открытым работающий процесс, места не освободит: файл исчезнет изls, но останется на диске (такие файлы покажетsudo lsof +L1). Обнуляйте его черезtruncate -s 0. И смотрите, что чистите: в кейсе с забитым/var/logрядом с распухшим логом лежитauth.log, а аудит удалять нельзя.Убивать виновника и считать дело сделанным. Если процесс держит systemd или сторожевой скрипт, через секунду он вернётся с теми же параметрами. В кейсе про OOM Killer
killпомогает на несколько секунд: сторож поднимает процесс заново, и память снова уходит.
И ещё один простой приём: записывайте, что делаете и во сколько. Даже если вы один, через час не вспомните, после какой команды метрики пошли вниз, а для постмортема это главное.
Это мой порядок, и наверняка не единственный. Какие команды вы набираете первыми, когда заходите на упавший сервер? Самые полезные добавлю в чек-лист.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.