Почему нельзя построить ролевую модель доступа, просто выгрузив Active Directory
Об инфраструктурной археологии, реальных путях доступа и попытке превратить накопившиеся разрешения в управляемую модель. Практический опыт разработки AMR (Access Model Reconstruction).
Я в ИТ более 20 лет и большую часть этого времени работал руководителем. Это не мешает мне браться за задачи своими руками, тем более когда это полезно и для работы, и для моего развития.
С LLM я знаком с момента их появления, хотя раньше использовал их в основном для поиска информации, работы с документацией и изображениями. Хайп вокруг AI‑агентов постепенно создал иллюзию, будто достаточно желания и хорошей идеи, а дальше можно сделать практически что угодно.
В своё время руководил небольшой командой инженеров и разработкой внутренней автоматизации, поэтому навыки архитектуры и системного подхода у меня уже были. Последние десять лет занимаюсь ИБ, отсюда и тема проекта. Потому и решил попробовать самостоятельно построить инструмент для реконструкции доступов, используя AI‑агента как разработчика.
По ходу работы собирался описать всё в одной статье, включая ошибки, неудачные попытки и получавшиеся костыли. Но материала оказалось слишком много. Про работу с AI‑агентом расскажу отдельно. Пока расскажу, зачем понадобился AMR, какие решения пришлось принять и что получилось.
Мне захотелось собрать инструмент для аудита прав доступа в AD, на серверах и сервисах, причем так, чтобы каждый раз не начинать обследование с нуля. Новые данные должны обновлять картину доступов, а результаты уже проведённых проверок и уточнений — сохраняться и использоваться в дальнейшем.
Обычно такие обследования делаются довольно привычными средствами. PowerShell‑скриптами собираются сведения о пользователях, группах и разрешениях, выгрузки сводятся в Excel. Потом начинаются разговоры с владельцами информационных систем и ИТ‑поддержкой, поиски документации и попытки разобраться, почему в одной выгрузке написано одно, а на сервере обнаруживается совсем другое. На выяснение всех этих несоответствий уходит немало времени. А когда инфраструктура меняется, многое приходится проверять заново.
Для начала нужно было разобраться с пользователями, группами, серверами и ресурсами — кто за что отвечает, для чего всё это используется и к каким информационным системам относится. А главное — видеть всю цепочку доступа, то есть через какие доменные и локальные группы пользователь получил права на конкретную папку, базу данных или сервис.
Но одним обследованием дело не ограничивается. Хотелось прямо в модели попробовать добавить группу, убрать лишние права и посмотреть, как это повлияет на доступы пользователей. Если что‑то пошло не так — отменить решение, не затрагивая рабочую инфраструктуру. По непонятным случаям подготовить вопросы для ИТ или владельцев систем, по согласованным изменениям — задачи инженерам. А после выполнения снова собрать данные и проверить, получилось ли то, что планировали.
Когда доступы растут вместе с компанией
Возьмём крупную компанию с многолетней историей. За это время менялись подразделения, администраторы, подрядчики и информационные системы. Приложения заменяли друг друга, базы данных переезжали, а доступы при этом нередко оставались как были.
Одному сотруднику понадобились дополнительные права, и его добавили в существующую AD‑группу. Другому дали доступ как у коллеги, а потом ту же группу определили на ещё один ресурс, потому что нужные люди уже состояли в ней. В тот момент каждое решение могло казаться разумным. Администратор, который придёт через несколько лет, вряд ли сможет уверенно сказать, какие ресурсы открывает эта группа и всем ли её участникам они нужны.
Внешне процессы могут быть вполне организованы. Заявки согласовываются, ServiceDesk работает, учётные записи создаются и блокируются. Однако выдавать доступ и управлять тем, какие права у человека на самом деле — разные задачи. Для IAM/IGA нужно знать состав групп, реальные разрешения на ресурсах, задачи этих ресурсов в инфраструктуре и человека, способного подтвердить необходимость доступа.
Это и хотелось автоматизировать. На коленке поднял проектик AMR, начав с анализа групп Active Directory. И довольно быстро понял, что, прежде чем рисовать ролевую матрицу, придётся заняться инфраструктурной археологией.
Почему роли пришлось отложить
Первая идея была простой. Взять пользователей, должности, подразделения, группы и найти повторяющиеся сочетания прав. На небольшой выборке я рассчитывал увидеть компактный набор ролей, но обнаружил почти индивидуальные комбинации разрешений. К тому же часть аккаунтов не имела понятной связи с сотрудником или бизнес‑функцией: технические учётки, подрядчики, дубли и другие исключения.
В Role Engineering существуют подходы bottom‑up, когда кандидатов в роли ищут по выданным правам, и top‑down, когда исходят из бизнес‑функций. Их ограничения, в частности, описывает публикация NIST. Если просто преобразовать исторические группы в роли, вместе с нужными полномочиями можно закрепить давно забытые исключения. Но и проектировать роли только по оргструктуре не получится, когда должность мало говорит о фактических обязанностях, а владельцы систем не всегда знают, где размещены их ресурсы и кто имеет к ним доступ.
В CIS Controls v8.1, safeguard 6.8 рекомендуется определить права ролей, задокументировать их и регулярно пересматривать. Логично, только сначала нужно узнать, какие ресурсы существуют, какие разрешения уже выданы и кому они реально нужны. Сами рекомендации, как и установка IAM‑платформы, эту работу за нас не выполнят.
Поэтому пришлось отложить идею строить бизнес‑роли напрямую. Сначала решил восстановить фактическую картину (As‑Is), разобраться с доступами к ресурсам и их владельцами, оценить наиболее рискованные случаи. Проектирование Target / To‑Be должно опираться на эти сведения, а не повторять накопившееся в AD.
Что для меня стало «доступом»
Первоначальной схемы «учётная запись — AD‑группа — сервер» оказалось мало. Одна ИС (информационная система) может занимать несколько серверов, а на одном сервере могут работать компоненты разных систем. Даже когда известно, к какой ИС относится сервер — какие действия разрешены конкретному пользователю на данном сервере, приходится выяснять отдельно.
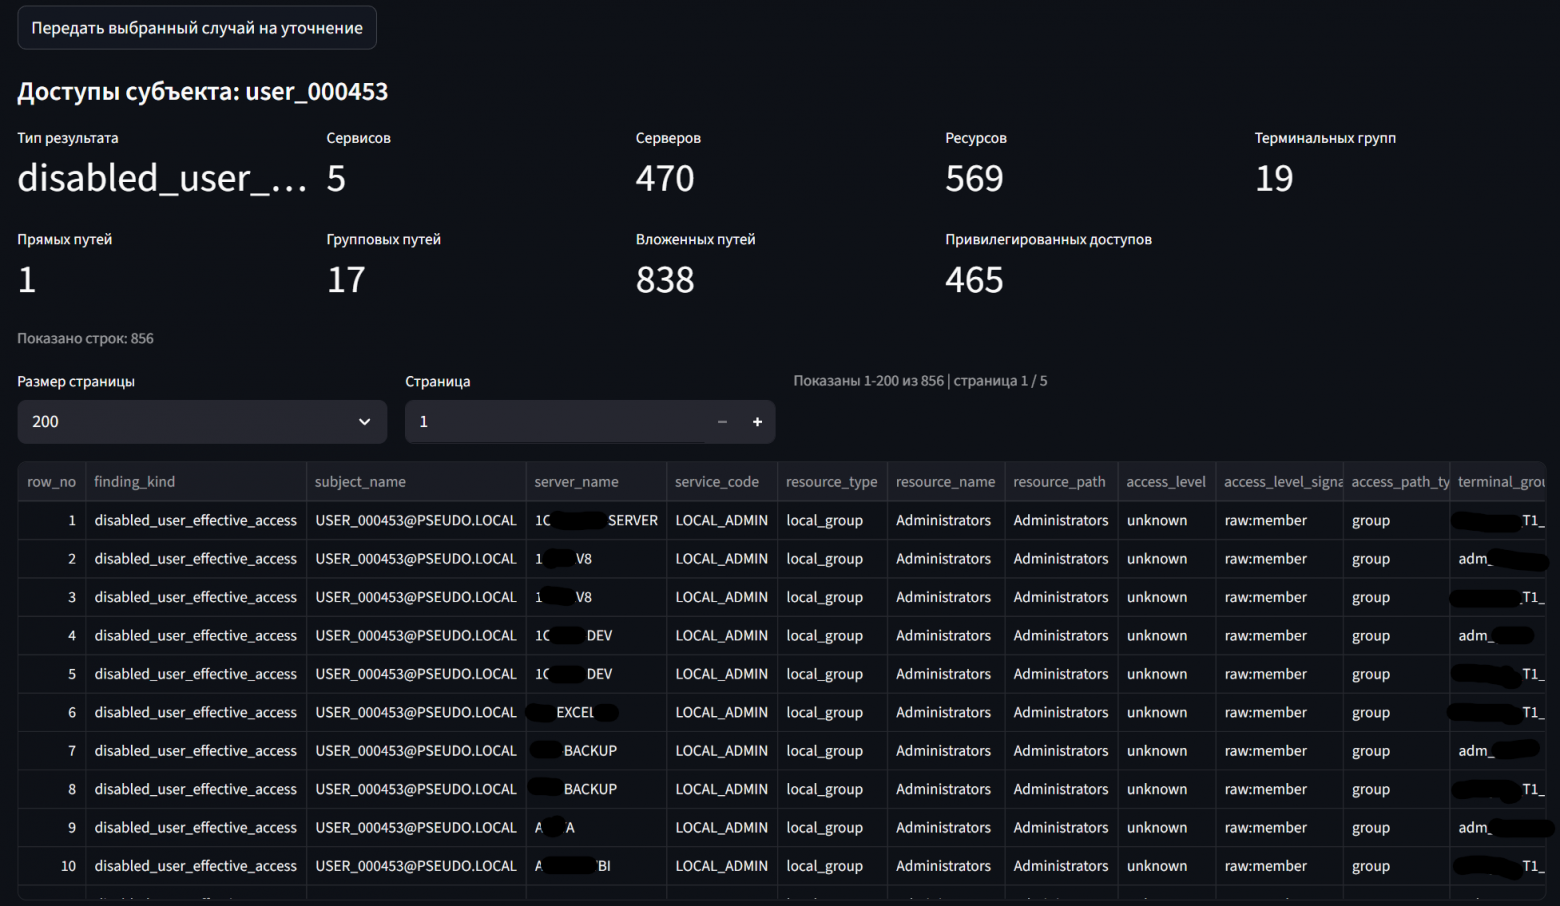
Возьмём сервер fs01, на котором лежат файлы ИС «Отчётность». Через несколько вложенных AD‑групп у пользователя u.petrov обнаружилось разрешение Modify на одну из папок. Но это вовсе не значит, что он может зайти на сервер по RDP, имеет права локального администратора или доступ к SQL Server. Это совершенно разные разрешения. Поэтому в AMR пришлось разбираться не просто с тем, кто имеет доступ к серверу, а с тем, через какие группы, к каким именно ресурсам есть доступы и какие права получил пользователь.
После объединения источников оказалось, что осторожности требует и само слово «доступ». В SMB играют роль и разрешения общего ресурса, и NTFS ACL. Быть членом локальных Administrators, подключаться по RDP и иметь роль db_owner в MSSQL — это разные полномочия. SQL‑native logins не всегда можно сопоставить с доменными учётками, а удалённые из AD пользователи могут оставлять SID в списках разрешений. Кроме того, в разрешениях могут встречаться локальные учётки, пользователи доверенных доменов и встроенные субъекты Windows. То есть — если записи нет в AD, это ещё не значит, что она ошибочная.
И ещё одну особенность AD легко упустить. Группы пользователя обычно смотрят по атрибуту memberOf. Но есть ещё «основные группы», для них у пользователя есть отдельный атрибут primaryGroupID. Например, у большинства доменных пользователей для группы «Domain Users» он равен 513. Если собирать данные только по memberOf, часть связей между пользователями и группами потеряется.
Разрешения в разных системах устроены по‑разному, поэтому для анализа пришлось привести их к общим категориям: read, write, execute, full, admin, deny и unknown. При этом исходные значения и источники записей я сохранил.
Это не универсальный способ расчёта прав. Например, DENY в Windows ACL нельзя просто приравнять к ограничениям в SQL. Если из полученных данных не удаётся точно понять, какие полномочия предоставлены, в модели остаётся unknown.
Ещё сложнее было восстановить бизнес‑контекст. ACL показывает, кому что разрешено, но не отвечает на вопросы о чувствительности данных, владельце ресурса и последствиях недоступности ресурса. В таких случаях сначала разбиралось то, что можно проверить технически, а именно административные полномочия, широкие группы, возможность изменения и удаления данных. Дальше мне приходилось выяснять, что произойдёт, если доступ убрать, какие процессы от него зависят и кто может это подтвердить. За этим приходится идти в ИТ и владельцам бизнес‑функций. Ответы было важно не потерять в переписке, а сохранить в модели для следующих проверок.
В итоге для AMR доступ — это не просто членство в AD группе и не абстрактное «пользователь имеет доступ к серверу». Мне нужно знать, кто именно, к какому ресурсу и какие права получил, а главное — через какие группы эти права появились. И всё это должно подтверждаться собранными данными.
Что пришлось решить в архитектуре
Стало понятно, что складывать всё в одну «правильную таблицу доступов» нельзя. Особенно когда исходные данные приходят повторными снимками, а оператор уже потратил время на выяснение информации об этих группах и ресурсах.
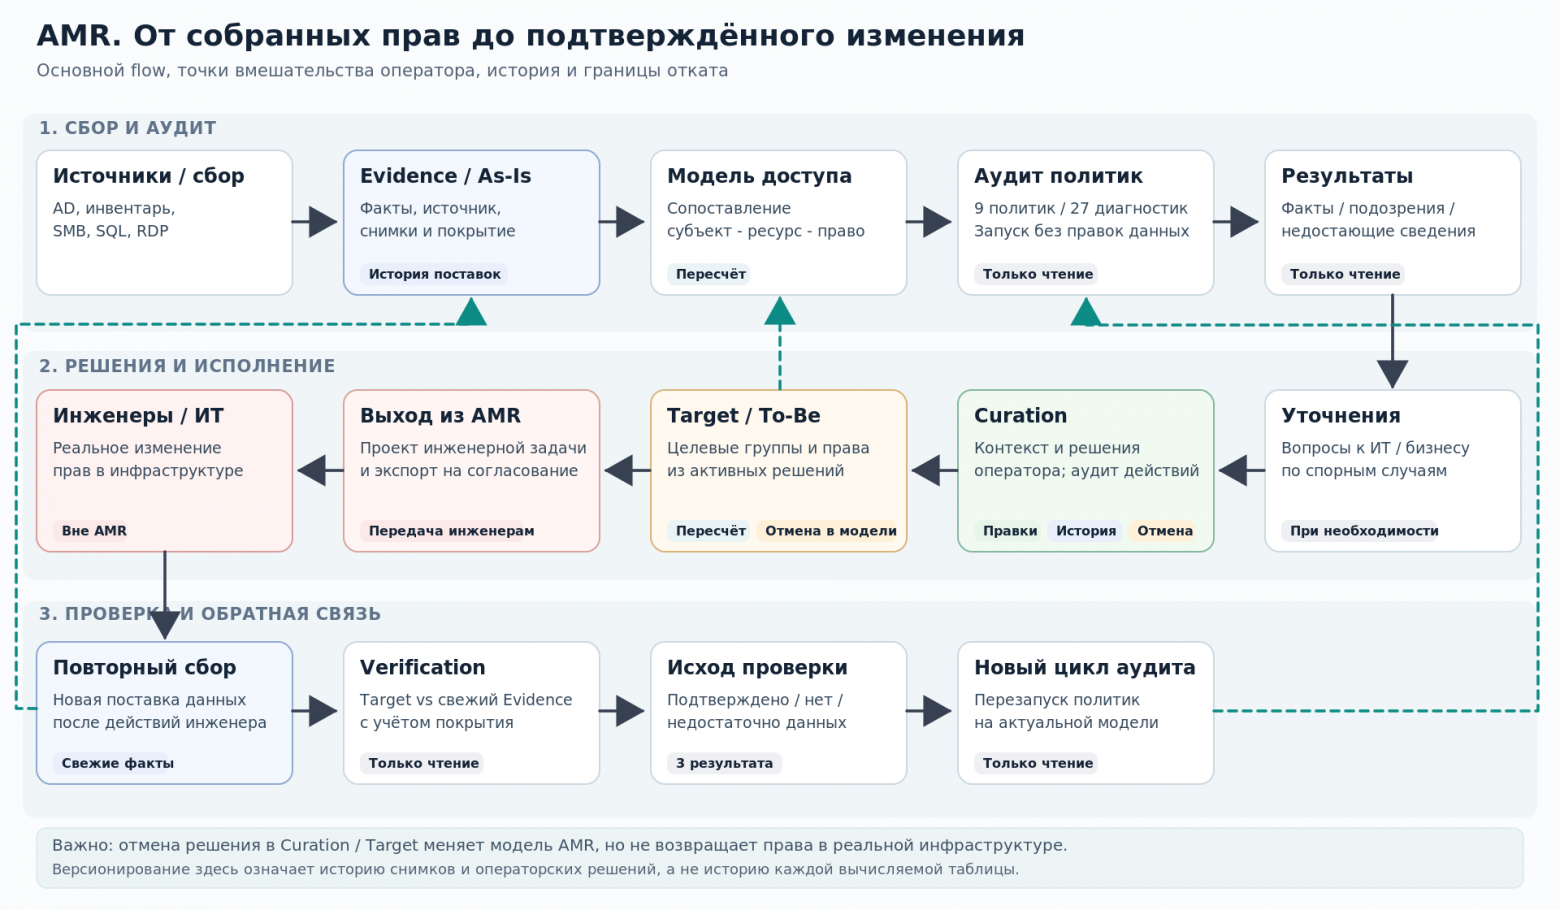
Чтобы не смешивать собранные данные с ручными уточнениями и будущими изменениями, в AMR появились отдельные слои.
В Evidence / As‑Is лежит то, что удалось собрать из AD, с серверов и сервисов. Про каждую запись известно, из какого источника и в какой загрузке она пришла. Сами исходные данные мы не исправляем.
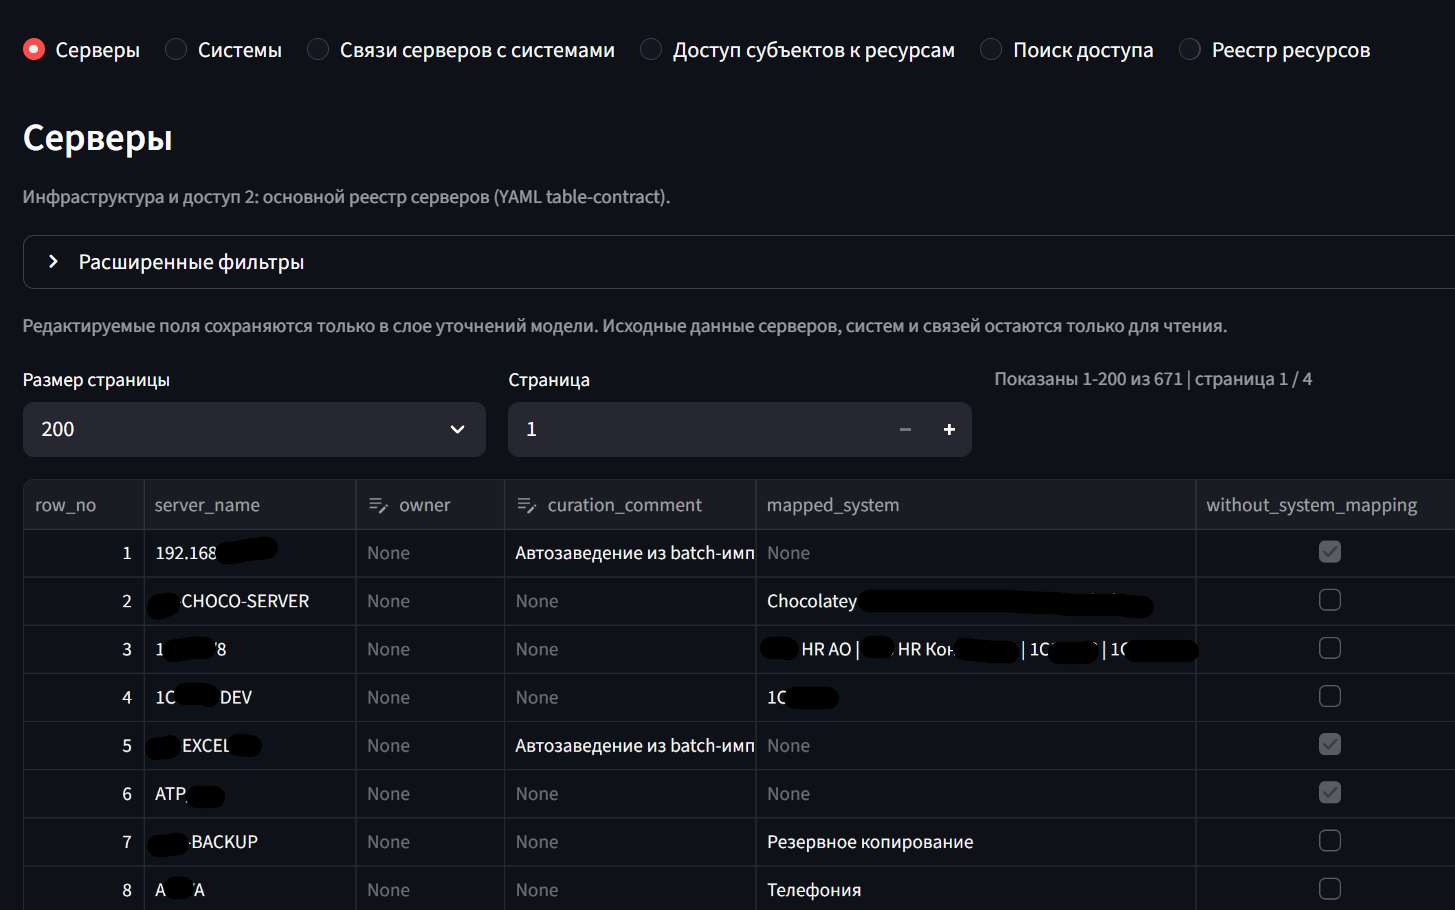
В Curation оператор разбирается с найденным. Он определяет типы учётных записей, уточняет, для чего нужны группы и ресурсы, связывает ресурсы с информационными системами и сохраняет принятые решения. (Вносятся для объектов описания, связи, комментарии, уточнения).
Target / To‑Be описывает, как всё должно выглядеть после согласованных изменений. Пока это только модель, к которой мы хотим прийти, а не реальные права на серверах. (То что получается на выходе. Вся система держит новое смоделированное состояние, на выходе — заявки в ИТ для уточнения либо выполнения уже конкретных действий).
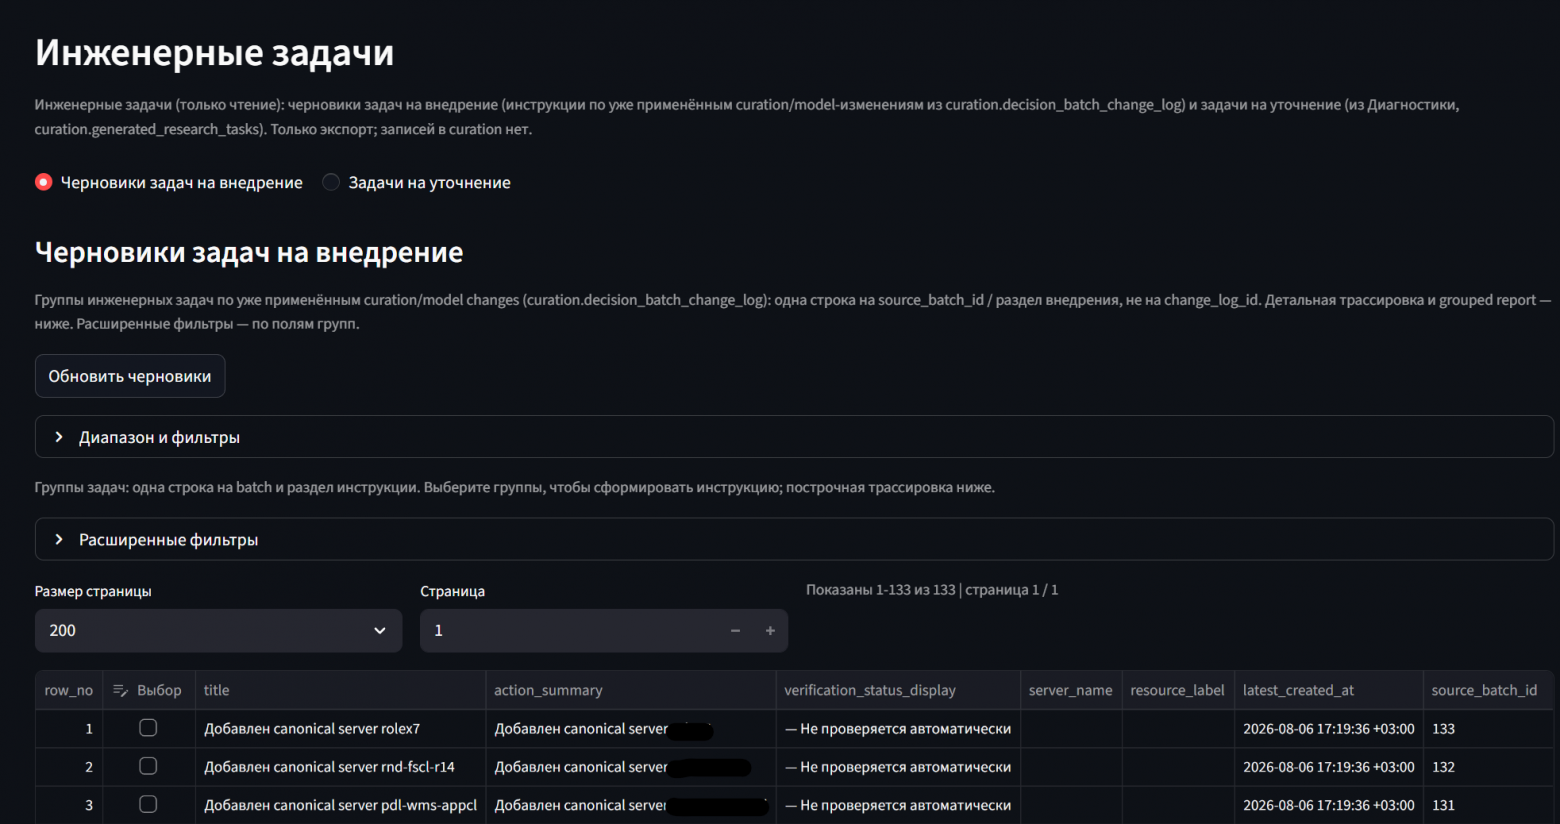
Сначала я недооценивал, насколько важно отделить решение оператора от самих данных. Поэтому решения стал сохранять отдельно, с историей. Пакет можно отключить, пересчитать модель, при необходимости вернуть его действие после проверки конфликтов. Но это откат только внутри AMR. Если инженер уже изменил группы или разрешения на реальном сервере, отмена пакета ничего там не восстановит.
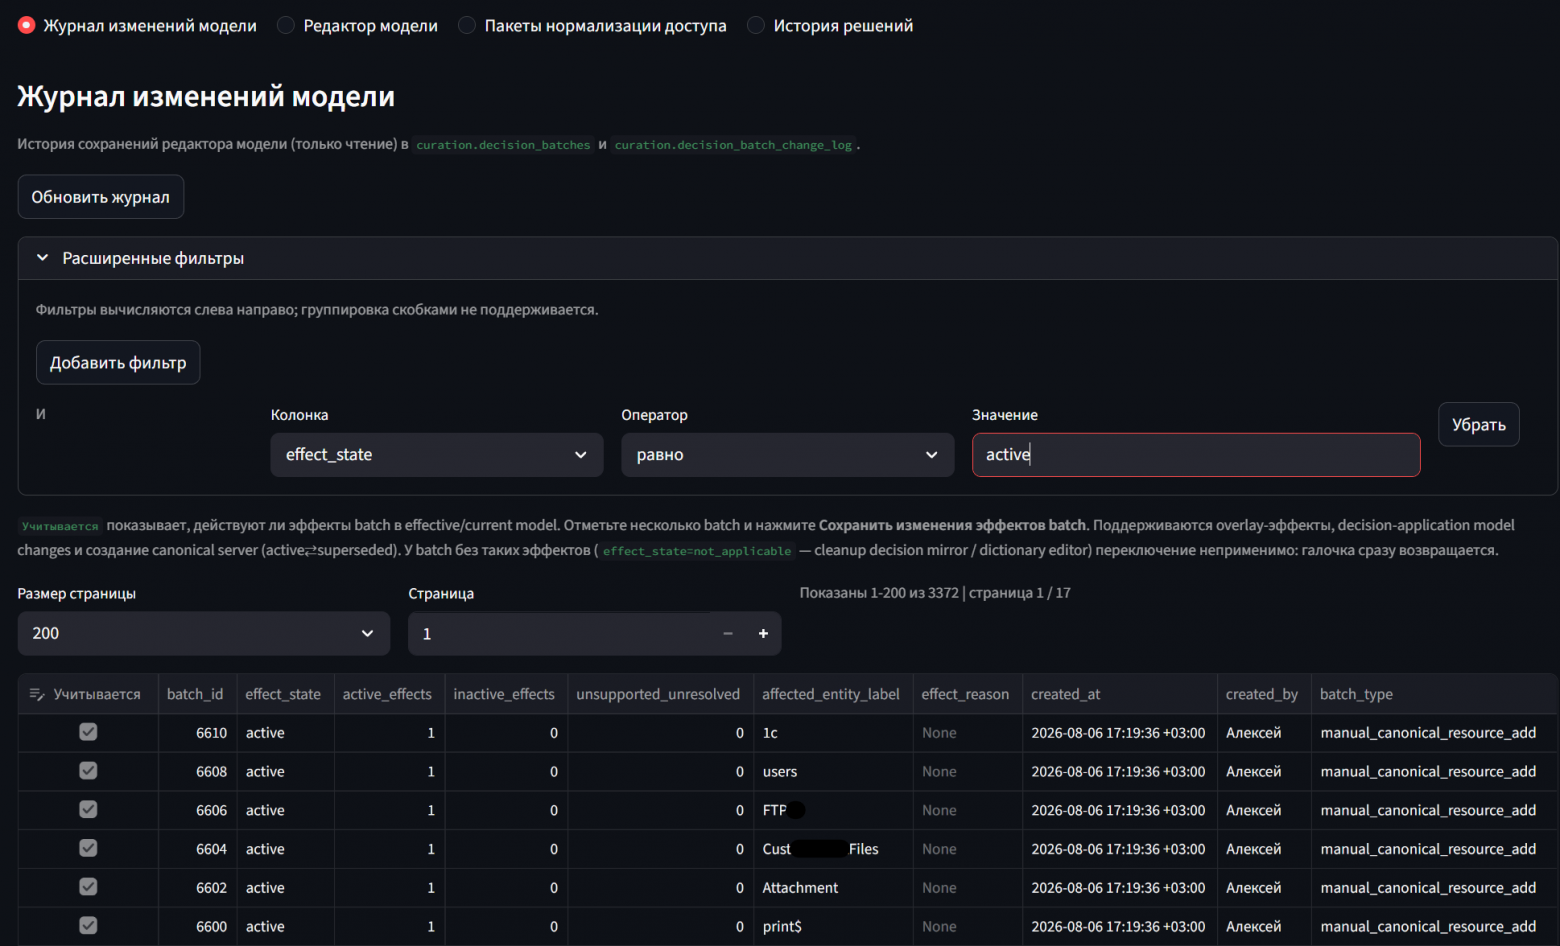
Отдельно пришлось разбираться с повторной загрузкой. Если при очередном сборе исчезла строка, право могло остаться на месте. Возможно, данные пришли с другого набора серверов или сбор был частичным. Мне пришлось учитывать покрытие и свежесть поставок, чтобы не принимать отсутствие записи за доказательство изменения доступа.
Ниже показан основной процесс AMR. На схеме видно, где сохраняются первичные сведения, что оператор может менять с сохранением истории, откуда формируются инженерные задачи и как новый сбор возвращается в цикл проверки.
Почему перешёл от диагностик к политикам
Первые проверки выдавали тысячи строк. Технически находки были полезны, но оператору непросто начинать работу с выбора диагностик по их кодам. Ему гораздо понятнее сформулировать, какое правило он хочет проверить. Например, отключённые учётки не должны сохранять доступ, а обычные и привилегированные права лучше разделять.
Так появились девять политик целевой модели и 27 диагностик. Оператор выбирает политики, AMR выполняет соответствующие проверки и показывает результаты. При этом достаточно быстро пришлось отказаться от мысли, что каждую находку можно сразу объявлять нарушением.
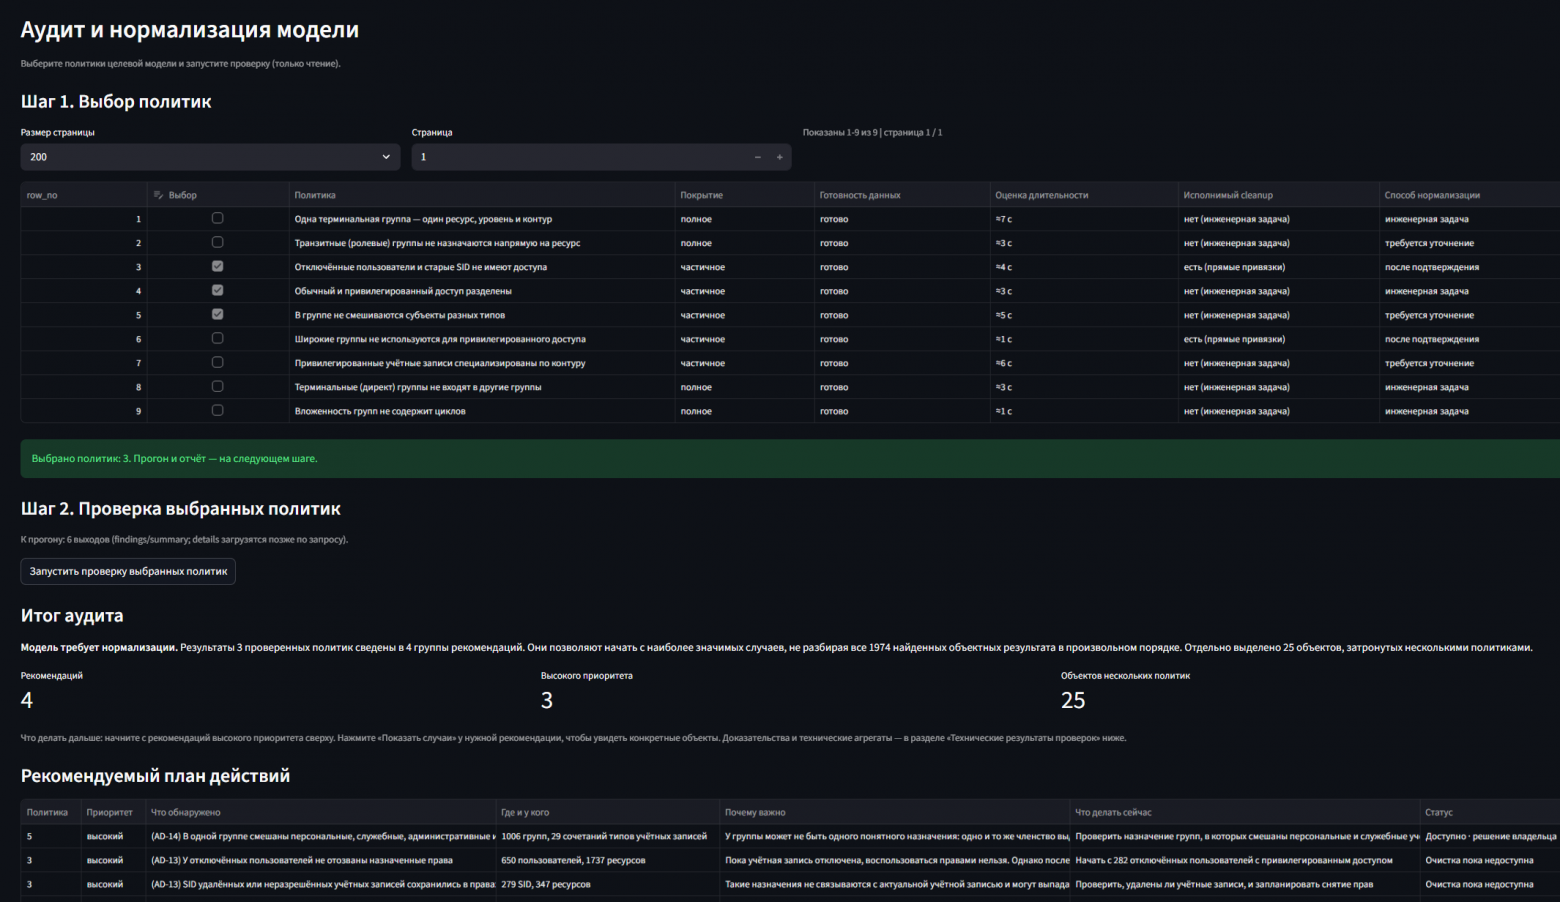
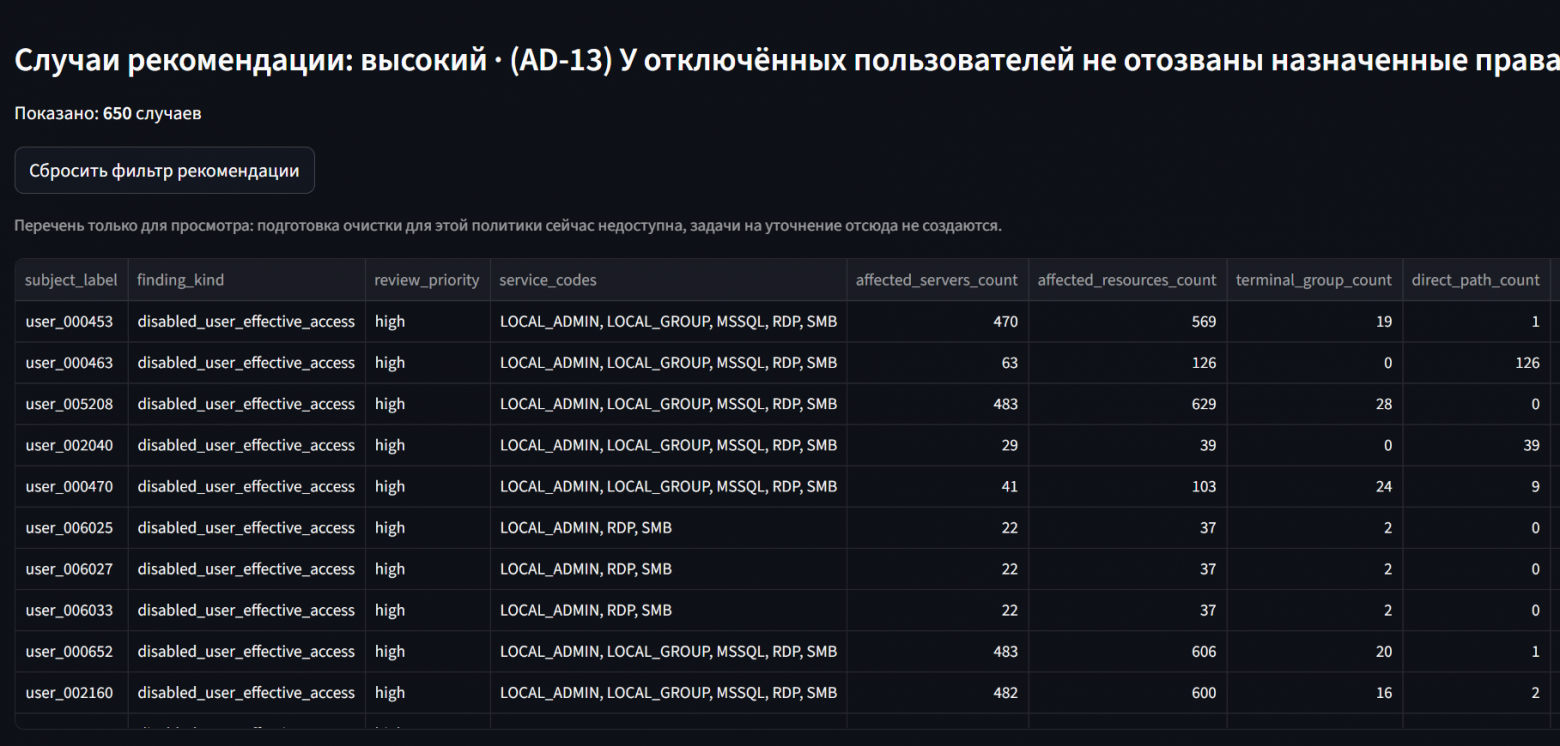
Большая группа сама по себе ещё не проблема. Возможность подключиться по RDP и права локального администратора — разные полномочия. При поиске пересечений административных прав Windows и MSSQL обнаружилось, что одинаковые имена логинов могут принадлежать разным учётным записям. Некоторые проверки пришлось переделывать уже на реальных данных.
Поэтому диагностика должна различать установленный факт, подозрение, требующее проверки, и ситуацию, когда сведений недостаточно. Дальше у оператора появляется выбор: уточнить доступ, принять решение по нормализации или сформировать задачу инженеру. Сам факт запуска диагностики ещё ничего не меняет.
Что делать с найденным доступом
Допустим, на сервере обнаружены три пользователя в локальных Administrators. Кажется, их можно заменить одной контролируемой группой. Но сначала надо выяснить, кто обслуживает сервер, какие права должны сохраниться и не сломает ли замена работающие сервисы.
Одно дело — выбрать новую группу, другое — подтвердить, что она обеспечит нужный путь доступа. Поэтому в модели я сначала описываю замену и проверяю ожидаемый результат, затем согласовываю его и только после этого готовлю инженерную задачу.
AMR сам не исполняет PowerShell, SQL или другие команды изменения прав в инфраструктуре. Инженер получает описание того, что и где нужно изменить, почему это нужно и как проверить результат. Для меня такое разделение принципиально, потому что аналитический инструмент должен только анализировать, а доступы в производстве меняет инженер.
Результат подтверждает только новый сбор после выполнения задачи, причём из источника, который охватывает затронутый ресурс. Проверяя целевую модель, я учитываю, что свежие данные могут подтвердить ожидаемое состояние, противоречить ему или не позволить сделать вывод из‑за недостаточной свежести или покрытия. Поэтому на схеме после выгрузки файла для инженера процесс возвращается к сбору и повторному аудиту.
Что получилось и чего пока нет
Получился рабочий аналитический MVP. Достаточно удобный и многофункциональный. AMR позволяет повторно загружать сведения из AD и источников серверных разрешений, сопоставлять объекты, восстанавливать пути доступа. Есть целевая модель и подготовка инженерных задач. Для отдельных видов доступа, включая локальных администраторов, RDP, SMB и SQL, я сделал сценарии нормализации.
Фишка для меня в том, что после очередного сбора не приходится начинать обследование заново. Ранее принятые решения и уточнённый контекст остаются в модели, а аналитические результаты можно пересчитывать по обновлённым данным.
Реализованные механизмы не выдаю за подтверждённый результат эксплуатации. Массовое приведение реальных прав к целевой модели не проводилось. Полный цикл «задача инженеру — изменение — подтверждение новым производственным сбором» в масштабе программы ещё предстоит пройти. Сокращение месяцев ручных обследований до недель пока остаётся только потенциалом подхода. Кроме того, предстоит развивать работу со структурой вложенных AD групп и вариантами NTFS разрешений.
Практические выводы
1. Бизнес‑роли из существующих групп строить бы не стал. Сначала нужно выяснить, какие разрешения для них существуют. Старые права могут оказаться ошибочными.
2. Доступа к серверу или ИС мало — я бы проверял конкретный ресурс и конкретное полномочие. Право изменять файлы не даёт автоматически административных полномочий на сервере или в базе данных.
3. Начинать стоит с самого понятного и рискованного — административных прав, широких групп и возможности менять чувствительную информацию на критичных ресурсах.
4. Нужно знать, откуда взялась информация о правах доступа и можно ли ей доверять. Если каких‑то данных не хватает или непонятно, для чего нужен ресурс, это тоже нужно показывать. Иначе можно принять неправильное решение и изменить то, что трогать не следовало.
5. То, что обнаружено в инфраструктуре, и то, как хотелось бы сделать — это разные вещи. Даже если новая модель доступа уже согласована, это ещё не значит, что права на серверах действительно изменились.
6. Прежде чем давать инженеру задачу на изменение прав, нужно понять, как потом проверить результат. Закрытая заявка не является доказательством, что лишний доступ исчез, а нужные права сохранились.
В итоге я убедился, что построить IAM в старой инфраструктуре трудно чаще всего не из‑за выбора платформы. Сначала надо выяснять, что именно мы защищаем и какие разрешения уже есть. А потом ещё искать, кто вообще может подтвердить, что они нужны. AMR стал моей попыткой восстановить этот недостающий слой. Он не заменяет IAM, он нужен до него и рядом с ним.
Вместо заключения
AI‑агент помог мне реализовать проект. Сколько бы это заняло с командой автоматизации, одному Богу известно. Всё делалось на коленке и местами буквально «навалом мыслей». Сегодня мне казалась правильной одна идея, а завтра реальные данные заставляли менять направление. Но понимания предметной области агент не заменяет. Ему приходилось объяснять контекст, задавать архитектурные ограничения и проверять результаты, а мне самому — постоянно учиться.
Отдельно скажу про безопасность. С агентом я работаю по принципам Zero Trust. У него нет привилегий по умолчанию, и рабочую инфраструктуру он сам не меняет. Доступ к реальным данным компании ему закрыт, и такие данные я агенту не передаю, даже если они анонимизированы или псевдонимизированы. Скрипты и обработки, которые работают с живыми данными, проверяю и запускаю сам, в контролируемой среде.
Рабочий MVP мне ещё предстоит развивать и обкатывать в эксплуатации. Пока что считаю, что эксперимент удался.
Если тема заинтересует читателей, сделаю цикл статей. Есть что рассказать про реальные пути доступа, особенности AD и SQL, а также про устройство AMR с его политиками, операторскими решениями и проверкой изменений. Ещё расскажу про разработку с AI‑агентом, про ошибки, которые пришлось исправлять, и о том, почему к агенту, на мой взгляд, обязательно применять Zero Trust.
Напишите в комментариях, что из этого интересно. Так мне будет понятнее, с чего начать.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.