Вычисления, хранение, масштабируемость: погружение в архитектуру гиперконвергентной дата-платформы
Привет, Хабр. Меня зовут Павел Кутаков. Я главный архитектор VK Data Platform, VK Tech.
Более 10 лет подход с разделением compute- и storage-слоев де-факто считается стандартом, следование которому позволяет максимально эффективно использовать доступные ресурсы. Но на практике подобный подход применим не всегда — например, по нашему мнению, он не всегда оптимален для построения платформ данных. Именно поэтому при разработке VK Data Platform мы реализовали единую гиперконвергентную архитектуру.
В статье расскажу, почему мы выбрали такой подход, как обеспечиваем гибкость решения и с помощью каких практик гарантируем безопасность и отказоустойчивость.
Начнем с базы: compute/storage separation и гиперконвергентная архитектура
Compute/Storage Separation — это архитектурный подход, при котором слой вычислений (CPU, память, контейнеры, виртуальные машины) и слой хранения (диски, тома, объектные хранилища) существуют как независимые компоненты. Можно разворачивать их на разных физических узлах, масштабировать отдельно и управлять ими с помощью разных инструментов.
У такого паттерна есть четкие эксплуатационные выгоды:
Независимое масштабирование. Compute и storage наращивают строго по потребности: если растет объем данных — расширяют хранилище; если растет нагрузка на обработку — добавляют вычислительные мощности. Это снижает избыточность ресурсов.
Эффективная утилизация. В сценариях с выраженным дисбалансом (например, холодный архив или высоконагруженная аналитика) можно точно подбирать конфигурацию под тип нагрузки и не переплачивать за неиспользуемые мощности.
Унифицированный доступ к данным. Единый storage‑слой позволяет разным compute‑кластерам работать с одними и теми же данными. Это удобно для мультикластерных сред, репликации, аналитики и сценариев, где несколько сервисов читают один набор данных.
Гибкость размещения. Storage можно вынести в отдельный кластер, ЦОД или объектное хранилище (S3‑совместимое), а compute — развернуть там, где это оптимально по задержкам, стоимости или политикам безопасности.
Вместе с тем у подхода есть принципиальное ограничение: все операции чтения и записи проходят через сетевой контур, поэтому задержки и пропускная способность сети становятся критичными параметрами. В ряде случаев именно сеть становится узким местом производительности — и тогда выигрыш от независимого масштабирования нивелируется ростом latency.
Именно поэтому у подхода с разделением есть альтернатива в виде гиперконвергентной архитектуры. Она предлагает иной принцип организации инфраструктуры: compute и storage объединяются в рамках единых узлов и управляются как единый контур.
У такого подхода тоже есть преимущества:
Локальность данных для высокой производительности. Операции чтения и записи выполняются преимущественно на локальных дисках или в пределах кластера с минимальной сетевой задержкой — это критично для СУБД (например, PostgreSQL или ClickHouse), чьи движки оптимизированы под прямой доступ к локальным устройствам.
Автоматизированное управление и отказоустойчивость. Оркестратор (чаще всего на базе Kubernetes) координирует размещение компонентов, балансировку и распределение данных — в том числе реализует anti‑affinity‑правила и автоматическое переключение трафика.
Сниженная зависимость от сети. Сеть задействуется в основном для репликации и синхронизации, а не для каждого запроса к данным — это уменьшает влияние сетевых задержек на производительность.
Таким образом, гиперконвергентная модель не отрицает ценности разделения ресурсов, а смещает фокус: вместо максимальной гранулярности масштабирования она делает ставку на локальность данных, согласованное управление ресурсами и предсказуемую производительность для рабочих нагрузок, чувствительных к задержкам. При этом никто не мешает применять оба подхода одновременно: разделение compute и storage — для аналитики больших данных, где такое разделение стало стандартом просто в силу объема обрабатываемых данных, и локальность данных — для критических нагрузок.
Именно такую архитектуру с объединением слоев вычислений (control plane и data plane), хранения и сетей «в одном флаконе», мы реализовали в VK Data Platform. И в качестве оркестратора в основе платформы мы выбрали Kubernetes.
Предпосылки выбора Kubernetes
Есть несколько свойств и факторов, которые полностью аргументируют выбор в пользу Kubernetes в качестве среды оркестрации.
Операторы. В K8s доступны операторы — специализированные контроллеры, которые через Kubernetes API наблюдают за кастомными ресурсами (Custom Resources) и автоматически приводят состояние кластера к целевому. Благодаря этому эксплуатационные практики (бэкапы, масштабирование, обновления, обработка отказов) фиксируются в воспроизводимом коде и выполняются без ручного вмешательства. В итоге оператор берет на себя управление жизненным циклом СУБД — поддерживает консистентность, кворум и реагирует на события, фактически выступая «автопилотом» для базы данных и заметно повышая надежность и предсказуемость ее работы.
Отказоустойчивость с учетом anti‑affinity и мульти‑ЦОД‑сценариев. Kubernetes позволяет гибко задавать правила размещения (в том числе anti‑affinity), чтобы реплики СУБД не оказывались на одних и тех же узлах или даже в одном ЦОД — это снижает риск одновременного отказа всех копий данных.
Сетевые политики. С помощью Network Policies можно строго контролировать сетевой доступ к базам данных, ограничивая взаимодействие только нужными сервисами и снижая поверхность атаки.
Микроинстансы и тонкое управление ресурсами. Kubernetes дает возможность запускать компактные экземпляры (например, тестовые PostgreSQL‑ноды на доли CPU и сотни мегабайт памяти) и точно лимитировать их потребление, что удобно для сред разработки, staging‑окружений и легких служебных баз.
Гибкое управление хранилищем. Kubernetes унифицирует работу с разными типами хранилищ — от локальных дисков до сетевых и объектных систем — через единый механизм PersistentVolumes и StorageClasses. Это дает предсказуемое управление томами независимо от инфраструктуры, автоматизирует provisioning и политики доступа, а также позволяет выбирать оптимальный тип хранилища под конкретную СУБД.
Важно понимать, что миф о том, что Kubernetes плохо подходит для stateful‑нагрузок вроде СУБД из‑за сложностей с хранением и управлением состоянием в распределенной среде сегодня уже не актуален. Так, современные операторы не используют примитив StatefulSet, а реализуют собственную, более гибкую логику управления томами, отказоустойчивостью и синхронизацией, а локальные диски управляются точно так же, как сетевые: через механизм PersistentVolumeClaims. Таким образом, Kubernetes уже способен полностью закрывать потребности СУБД и является надежным решением для эксплуатации баз данных в облаке.
От подхода к архитектуре
Теперь перейдем от обоснования подхода к разбору, как реализовано решение «под капотом» на практике.
Базовая архитектура при развертывании
Базовая архитектура при развертывании имеет следующий вид:
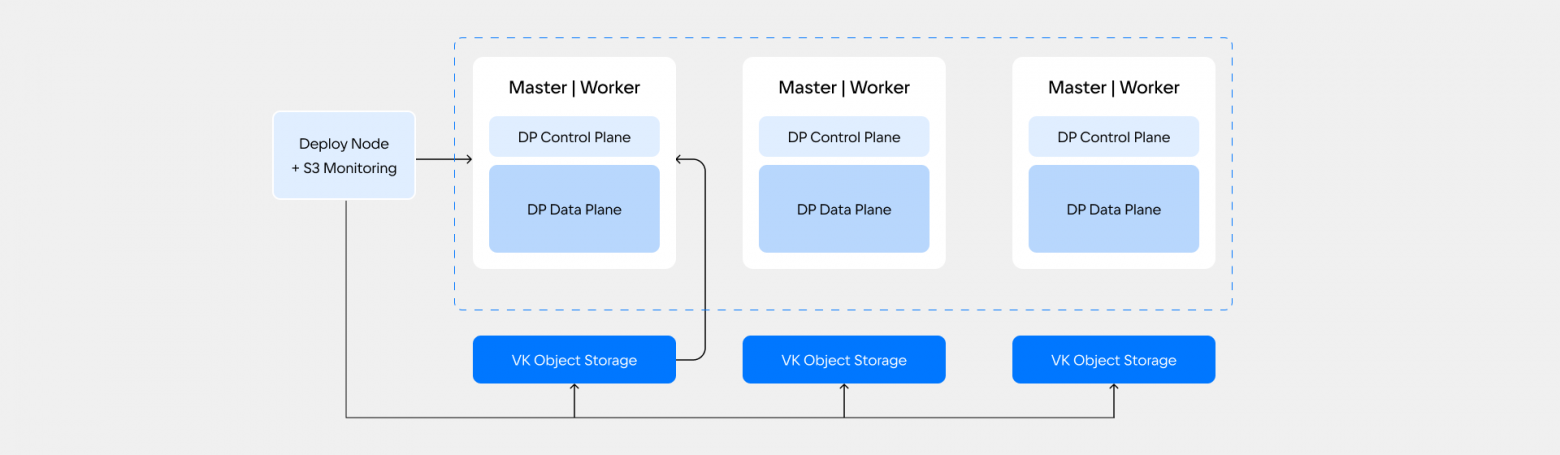
Здесь:
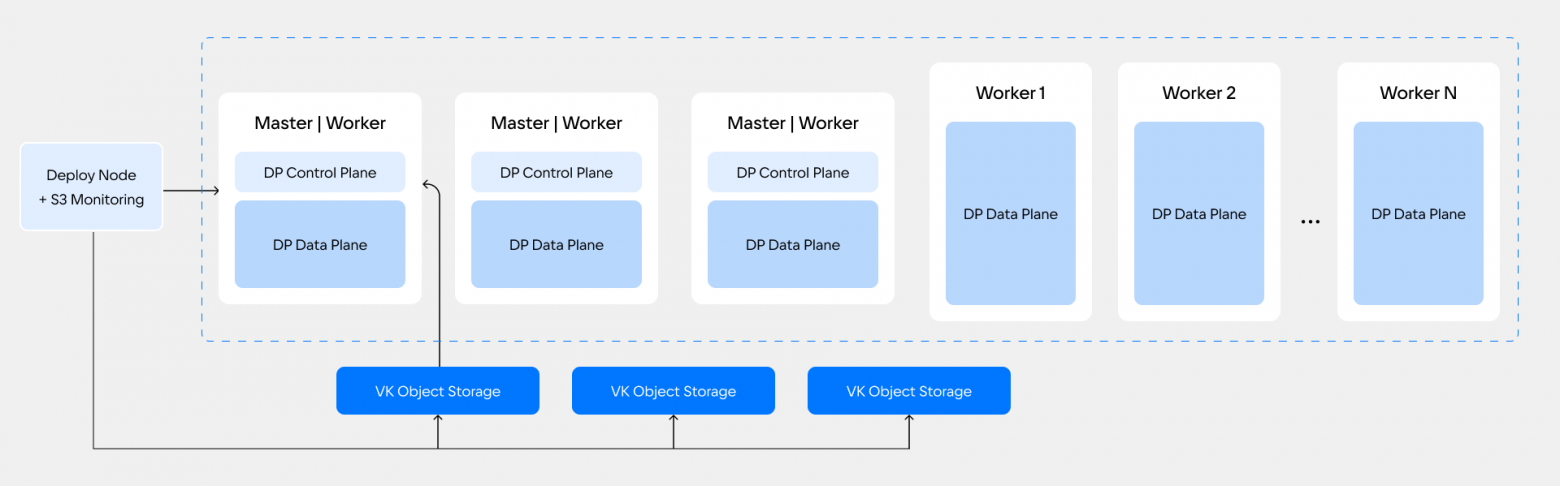
Три ноды кластера Kubernetes, на каждой из которых выделены два ключевых слоя: Control Plane (управляющий контур) и Data Plane (контур обработки данных). Здесь же размещаются системные сервисы — в том числе система аутентификации и авторизации.
Deploy‑нода — отдельный узел для запуска процесса развертывания. Фактически это точка входа для установки и начальной конфигурации всей платформы.
S3-совместимое хранилище (в нашем случае — VK Object Storage), которое используется для хранения бэкапов, синхронизации с внешними системами и доставки нестандартных артефактов (например, библиотек).
Примечание: Показательно, что даже при такой архитектуре принцип Compute/Storage Separation остается применимым: если объем данных выходит за пределы локальных дисков, схему можно адаптировать под раздельное размещение вычислений и хранения — решение полностью масштабируемо.
При этом схема не нарушается даже при увеличении числа узлов. Более того, поскольку базовые механизмы оркестрации (включая affinity/anti‑affinity) уже реализованы в платформе, все дополнительные узлы практически полностью становятся доступны для пользовательских сервисов (Control Plane не резервирует их мощности).
Архитектура оркестратора
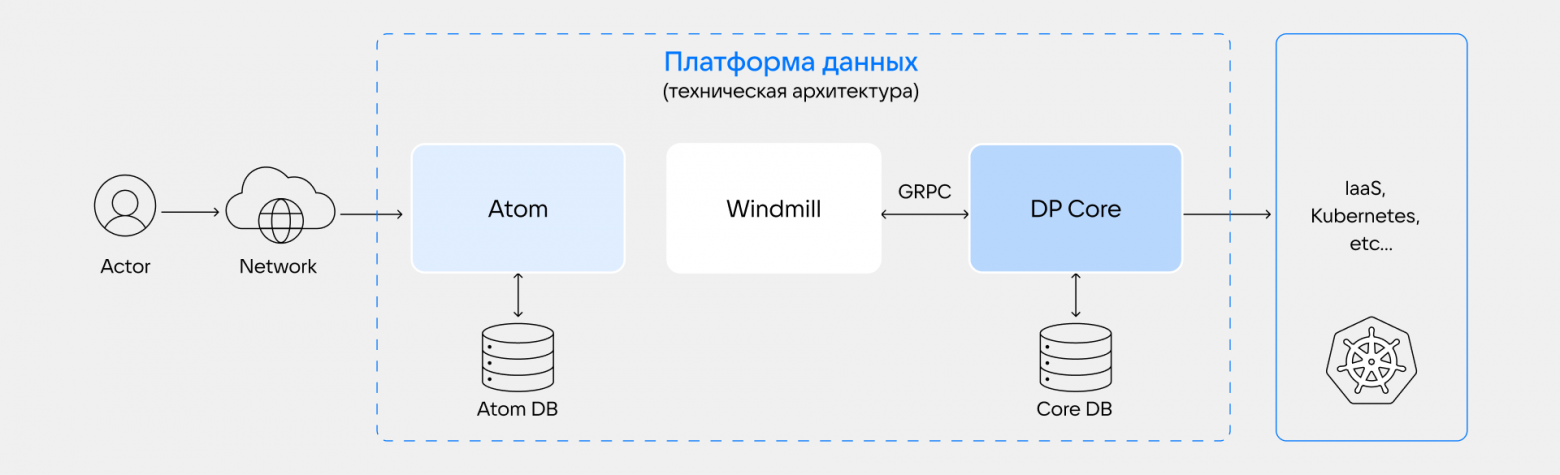
Если сам Kubernetes является оркестратором «физического» уровня, то для управления жизненным циклом работы СУБД нужен более высокоуровневый оркестратор. Он-то и составляет основу контура управления системой (Control Plane). Структурно этот оркестратор устроен крайне просто и содержит три базовых компонента:
Atom — входной API‑слой для взаимодействия с пользователем. Через него проходят все запросы из пользовательского интерфейса. Здесь же реализуется авторизация и проверка прав на выполнение действий.
Windmill — асинхронный workflow‑движок, который пошагово обрабатывает задачи развертывания. Поскольку запуск сервисов (например, ClickHouse) не мгновенный процесс, Windmill управляет многошаговыми операциями и отслеживает их статус.
DP Core — ядро системы, обеспечивающее архитектурную развязку. В нем сконцентрирована вся логика взаимодействия с инфраструктурой: выделение IP‑адресов, операции с Kubernetes, запуск развертываний и прочее. Остальные компоненты не содержат этой логики — они делегируют такие задачи ядру, которое «знает», как с ними работать.
Архитектура в деталях
Теперь подробно остановимся на архитектуре каждой отдельной ноды Kubernetes.
Так, в рамках платформы каждый узел Kubernetes выступает как самодостаточный гиперконвергентный домен: на нем одновременно исполняются управляющие процессы платформы, прикладные рабочие нагрузки и системные сетевые компоненты.
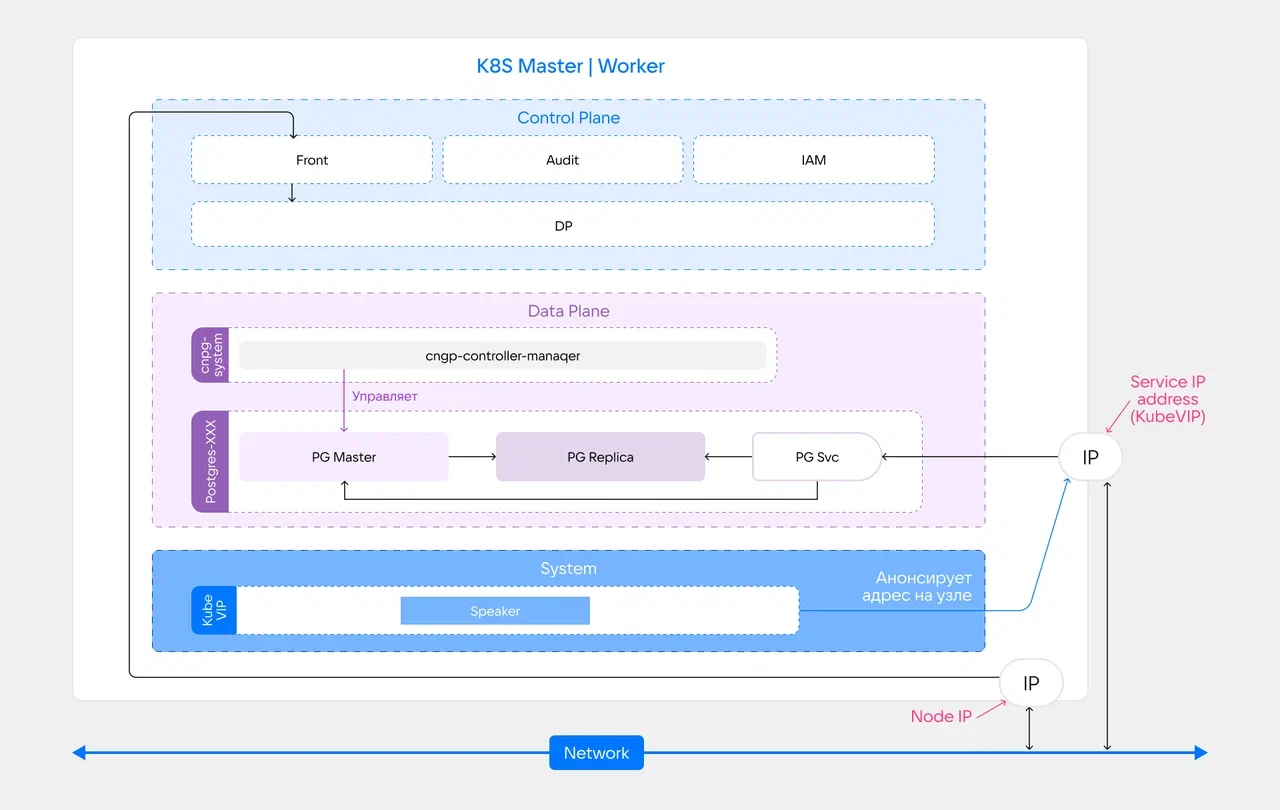
Такой подход позволяет консолидировать вычислительные, сетевые и инфраструктурные ресурсы в едином узле — без необходимости выделять отдельные слои под оркестрацию, хранение или балансировку.
И важным аспектом нашей реализации является использование двух типов IP: Node IP как базового адреса ноды и Service IP (эти адреса выделяются специальным системным сервисом KubeVIP) как виртуальной точки входа для трафика.
Lakehouse-платформа для аналитики и ML
Объединяйте данные из разных систем и снижайте расходы на хранение в 7–10 раз
Связка Kube VIP, который выполняет функции распределения нагрузки вместо аппаратных балансировщиков, и Speaker обеспечивает выдачу и анонсирование этих адресов, поддерживая отказоустойчивость и доступность сервисов в кластере.
Исходя из этого, формируется плоская сетевая модель кластера, где:
серые блоки на схеме (Node IP) — это адреса самих нод;
цветные (Service 1–6 IP) — виртуальные адреса сервисов, анонсируемые с этих нод.
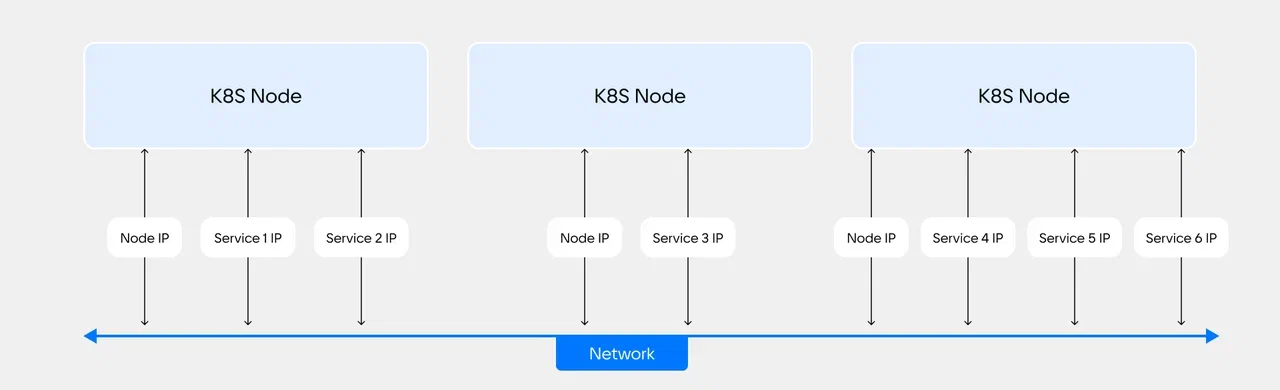
При отказе любой ноды анонсирование ее сервисных IP автоматически переносится на другие узлы — так обеспечивается отказоустойчивость и непрерывная доступность сервисов.
Меры обеспечения безопасности гиперконвергентной дата-платформы
При проектировании нашей платформы безопасность является приоритетом. В основе защиты лежит подход Zero Trust: разрешены только строго необходимые сетевые взаимодействия с детерминированными направлениями трафика — любое сканирование внутренней сети исключено.
Дополнительно реализуется сегментирование на сетевые зоны. При этом, следуя классическому cloud‑native‑подходу (схемы для которого вы можете найти в экзаменах у всех мировых облачных провайдеров), принято выделять три зоны.
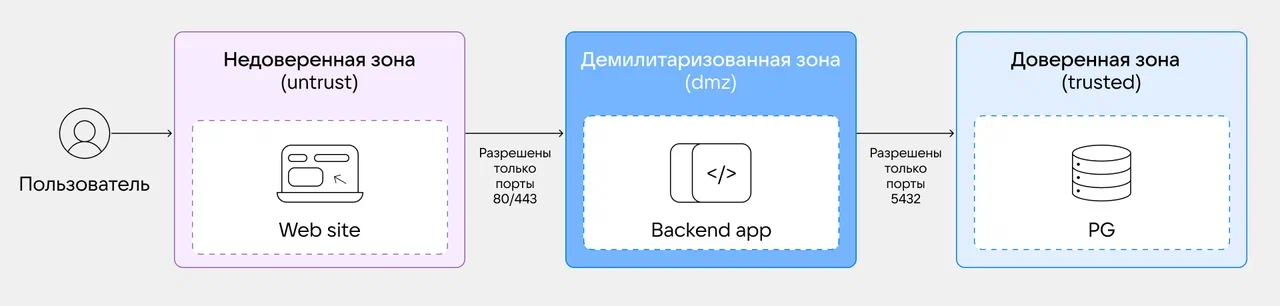
Мы же в своей реализации сформировали пять зон безопасности. Это обусловлено повышенной сложностью системы. При этом в выделенных зонах раздельно размещаются управляющие компоненты, сервисные приложения и базы данных, что позволяет четко разграничить доступ между контурами.
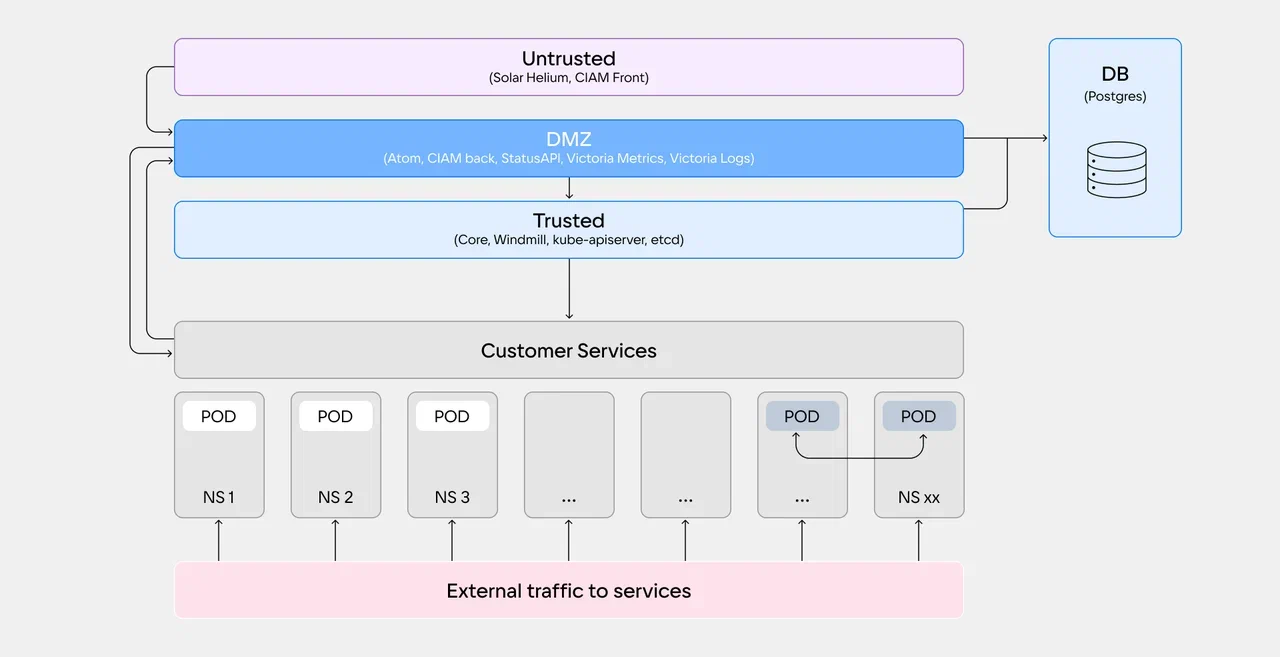
Контроль сетевого взаимодействия реализуется через политики сети: по умолчанию сервисы замкнуты в пределах своего namespace, а внешний трафик для них строго регламентирован. Межсервисное взаимодействие (например, подключение стримингового сервиса к ClickHouse для аналитики) явно декларируется и разрешается через сетевые политики. Это обеспечивает прозрачность и предсказуемость коммуникаций между компонентами.
При этом в систему уже встроены все необходимые инструменты для мониторинга и аудита:
Аудит настроек и действий. Фиксируются не только факт, время и пользователь, инициировавший изменение, но и значения параметров «до» и «после». Это помогает быстро выявлять причины сбоев — например, определять, какая настройка могла повлиять на производительность.
Сбор и анализ логов. Доступны фильтрация и поиск по журналам событий — это ускоряет диагностику инцидентов.
Мониторинг состояния Kubernetes. Отслеживаются статусы подов, узлов и других ресурсов кластера.
Контроль дисковых подсистем и хранилищ. Можно контролировать состояние дисков и метрики подсистем хранения.
Наблюдение за системными и прикладными сервисами. Обеспечивается сквозной контроль работы ключевых компонентов платформы.
И работа над инструментами мониторинга продолжается.
Как мы обеспечиваем отказоустойчивость
Теперь остановимся на отказоустойчивости. В нашей реализации она также обеспечивается комплексно.
Три и более узла в кластере Kubernetes. Это базовая страховка: если один узел «упадет», кластер все равно останется рабочим за счет кворума — система продолжит управлять сервисами.
Распределение реплик по разным узлам. Мы используем правила anti‑affinity: Kubernetes специально разносит копии сервисов по разным физическим серверам. Если на одном узле случится сбой, остальные реплики спокойно продолжат обслуживать нагрузку.
Автоматическое переключение сетевого трафика. Чтобы трафик не терялся при сбоях, используем протоколы VRRP или BGP — они держат маршруты устойчивыми и быстро переводят трафик на резервные узлы. И все это без ручного вмешательства.
Репликация данных и автоматический failover. Данные и их состояние — в зоне ответственности платформы. Например, PostgreSQL (через CNPG) сразу идет с репликами, а операторы в Kubernetes сами запускают переключение на резервную копию, если основная недоступна. Все происходит автоматически и довольно быстро.
Благодаря этим мерам простои сводятся к минимуму, и сервисы остаются доступными даже в нештатных ситуациях.
Возможности кастомизации
Платформа спроектирована так, чтобы не ограничивать пользователя типовыми сценариями: она дает возможность гибко адаптировать инфраструктуру под нестандартные задачи — от запуска собственных сервисов до тонкой настройки штатных продуктов и работы с особым окружением.
Так, для подключения нестандартных продуктов, которых изначально нет в нашей платформе, пользователи могут использовать разные варианты интеграций.
XaaS (Anything as a Service). Подход, который позволяет превратить любой внешний сервис или инструмент в полноценный продукт платформы. Для этого решение оформляют в виде Helm‑чарта (манифеста) — после этого оно получает весь стандартный набор возможностей: управление, масштабирование, настройки, визуализацию визоров и прочие функции, доступные для штатных сервисов. Такой подход удобен, например, для развертывания внутреннего инструментария или специфического сервиса в нескольких экземплярах: однократно описанный как продукт, он далее управляется по тем же правилам, что и остальные сервисы платформы.
Выделенные узлы Kubernetes. Вариант подразумевает выведение из кластера и зоны действия оркестратора отдельных нод, на которых можно самостоятельно устанавливать и настраивать любое ПО под особые требования — например, для работы со специализированным железом, однократных экспериментов или полностью нестандартных задач.
В итоге VK Data Platform дает максимальную гибкость: можно добавить свой сервис, тонко подстроить штатный продукт или развернуть что‑то в полностью изолированной зоне — и при этом все остается под контролем, а состояние развертываний легко отслеживать.
Что в итоге
Безусловно, гиперконвергентная модель не является универсальной заменой разделению compute и storage — в отдельных сценариях изолированный storage‑слой остается оптимальным решением (например, при работе с экстремально большими объемами данных, выходящими за пределы емкости локальных дисков).
Однако у гиперконвергентной архитектуры есть существенные достоинства: снижаются задержки за счет локального доступа к данным, упрощается координация ресурсов, обеспечивается стабильная работа сервисов даже при сбоях отдельных узлов. И все эти преимущества реализованы в VK Data Platform — каждый желающий уже может опробовать их в своих проектах. Причем сделать это можно выгодно — в рамках специальных предложений на тест VK Data Platform в облаке VK Cloud можно получить до 150 000 бонусных рублей или скидку до 40% при оплате на срок от трех месяцев.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.