Как я пишу агента для оценки и выбора модели под свои задачи/агентов
В прошлый раз я писал про "Как я пишу почти автономного агента для разработки своих пет-проектов", а сейчас я хочу сместить фокус на выбор модели под конкретные задачи. В сети полно контента на тему "Вышел новый GPT Astra (Claude Fable) near-AGI edition", но нас это мало чем интересует: дорого, долго и слишком самостоятельны.
На этот раз я решил обойтись без нейрослопа (почти), поэтому сразу прошу прощения за возможные ошибки, пунктуацию и пассивную агрессию (если такая имеет место быть с моей стороны)
Зачем самостоятельно оценивать модели?
Если присмотреться, то можно заметить, что все AI-вакансии имеют общее ядро — оценка качества моделей (выполняемой ими работы), а с замерами всегда есть и будут проблемы, но если не пытаться, то нет понимания "что хорошо и что плохо", получится "Я подправляю вручную инструкции (промпты) и смотрю, что получилось, после чего запускаю eval-тесты, пройдет — хорошо, не пройдет — буду дальше ковырять промпт". Но статья не о процессе разработки, а об оценке моделей.
Почему не опираюсь на общие бенчмарки в сети
Не секрет, что работа LLM сильно завязана на работу харнеса (harness, простыми словами — обвязка над LLM) — отсюда вывод, что публичные официальные бенчмарки показывают работу LLM в вакууме, и даже если вы найдете бенчмарки под харнес, он не будет учитывать ваши надстройки.
Про бенчмарки типа "Спроектируй визуализацию гелиоцентрической солнечной системы" промолчу, по мне, выглядит красиво, но к реальным решаемым задачам имеет малое отношение.
Какие типы задач имею на данный момент и на что я пишу бенчмарки
На данный момент мои основные задачи можно разделить на:
генерация кода и создание диаграмм
выжимка и переводы текста
оценка/сравнение других моделей
объяснение сложных вещей простыми словами
Задач много, а бенчмарков не так много — везде, где необходимо какое-то детерминированное действие стараюсь использовать бенчмарки (собирать метрики насколько хорошо или плохо отрабатывает модель), но грань тонкая и выявить ее не так просто (мб для этого стоит написать еще агента?). Я руководствуюсь правилами "Нормально делай — нормально будет.." "Если я представляю конкретный валидный результат — необходимо собирать метрики. Если правильных вариантов несколько — опиши несколько вариантов".
Какие типы бенчмарков
Скор везде — число от 0 до 1, чем ближе к единице, тем лучше. Бенчмарки делятся на три группы: генеративные (текст на входе — текст на выходе), embedding-ные (работают с векторами текстов) и decision-ные (строгий выбор или оценка по шкале).
Таблица типов бенчмарков
Бенчмарк | Что делает простыми словами | Скор — что измеряет |
|---|---|---|
| модель переводит текст; есть эталон (если вариантов несколько — считаем по лучшему) | F1 — совпадение слов ответа и эталона с учётом повторов. Попросту: та же лексика, что в хорошем переводе; отсебятина и вода снижают балл |
| модель сжимает длинный текст в краткий пересказ | тот же F1 против эталонной выжимки (эталонных вариантов может быть несколько) |
| модель пишет функцию/класс, код реально компилируется и запускается на кейсах «вход → ожидаемый выход» (python, C++, Java, JavaScript) | pass_rate — доля кейсов, где код отработал и вернул ровно ожидаемое. Не «похоже на правду», а «работает — не работает» |
| формальные требования к тексту: «не больше 30 слов», «в верхнем регистре», «без цифр», «валидный JSON», «маркированный список» и т.п. | доля пройденных пунктов чек-листа |
| задачи с числовым ответом (маркер «Ответ: <число>») | 1/0 — совпало ли число с эталоном (с допуском). В среднем по задачам получается доля реально решённых — ход решения не проверяется, только итог |
| пары текстов, у каждой человеческая оценка «насколько близки по смыслу» | Spearman — совпадает ли ранжирование пар по смыслу у модели (косинус эмбеддингов) с человеческим. Ближе к 1 — модель «чувствует» близость как человек |
| по запросу найти релевантные документы в корпусе (эмбеддинги + косинус) | nDCG@10 — насколько высоко в топ-10 выдачи стоят релевантные документы: первое место — максимум, десятая — почти мимо |
| то же самое, но на реальном корпусе новостей (новости в моем отдельном пет-проекте, не тема статьи) | nDCG@10 |
| текст относят к классу ближайшего образца («прототипа»), всё внутри на эмбеддингах | accuracy — доля верно угаданных классов |
| строгий выбор через Decision API (или чат со structured output для текстовых моделей): выбрать вариант (choice), сказать уверенность (noul), оценить по шкале (score) | «насколько угадал»: выбор — совпадение 1/0; уверенность — штраф за самоуверенный промах (Brier); шкала — средний промах от эталона (MAE) |
| статья оценивается по трём критериям 1–10 (важность / релевантность / достоверность), итоговый балл = 6·imp + 4·rel + 4·trust | насколько совпал итоговый балл с эталоном: 1.0 — поставил тот же балл, что и эталон; каждый балл промаха отрезает от единицы свою долю (максимум ошибки на шкале — 126, поэтому промах в 10 баллов съедает ~0.08) |
| мелкие подручные проверки («посчитай», «повтори N раз»); сюда падают разовые задачи | F1 против эталона, как у перевода |
Таблица метрик
Headline (вторая колонка таблицы) — это главный скор бенчмарка, он идёт в сводку и сравнение прогонов. Но при прогоне по каждому бенчмарку собирается полный набор метрик:
Метрика | Что измеряет простыми словами | Где считается |
|---|---|---|
headline-скор, описан выше | главный скор бенчмарка | все бенчмарки |
latency | средняя длительность одного ответа модели (с) | все бенчмарки |
tokens (prompt / completion / total) | расход токенов прогона, сумма по всем запросам | все, кроме embedding |
pass@k | доля тестов, решённых хотя бы одним из k сэмплов (порог почти точного попадания, 0.999): «смог ли хоть раз за k попыток» | все, осмыслен при мультисэмплинге |
score_std | типичный разброс скора между сэмплами одного теста — насколько ответы модели стабильны | все, при |
F1 | пересечение слов ответа и эталона с учётом кратности (повторы учтены); по нескольким эталонам берётся лучший | все генеративные |
BLEU | доля n-грамм (1–4) ответа, совпавших с эталоном; штраф за болтовню вокруг правильного текста | все генеративные |
ROUGE-1 / ROUGE-2 / ROUGE-L | совпадение одиночных слов / пар слов / самой длинной общей подпоследовательности | все генеративные |
norm. Levenshtein | похожесть строк: 1.0 — совпали посимвольно; промах = сколько минимальных правок отличает ответ от эталона (нормировано на длину большего текста) | все генеративные |
code similarity | сходство исходника с эталоном после нормализации (комментарии и пробелы срезаны); читается, когда ответ — код | все генеративные |
cosine (средний) | косинусная близость эмбеддингов пары текстов — сырая «векторная дистанция» |
|
Spearman | совпадает ли порядок пар по близости у модели (косинусы) и у человека — главный скор |
|
Pearson | линейная связь векторов близости модели и человека |
|
MSE | средняя квадратичная ошибка прогноза близости против человеческих оценок |
|
nDCG@k | качество ранжирования: релевантные документы чем выше, тем лучше (идеал — все релевантные вверху); главный скор |
|
Recall@K | доля релевантных документов, попавших в выдачу |
|
MRR | средний «1/ранг» первого релевантного документа: нашлось ли релевантное на первых местах |
|
accuracy | доля верно угаданных классов; главный скор |
|
macro F1 | средний F1 по классам — редкие классы не тонут |
|
micro F1 | F1 по всем попаданиям сразу — частые классы весят больше |
|
accuracy (choice) | доля точных попаданий в выбранный вариант |
|
Brier (choice/noul) | штраф за самоуверенный промах: чем увереннее модель ошиблась, тем больнее метрике |
|
log loss (choice/noul) | логарифмическая ошибка вероятностей; беспощадна к полной уверенности с промахом |
|
threshold acc (noul) | доля верных решений «уверен / не уверен» относительно порога |
|
ECE (noul) | калибровка уверенности: расхождение между заявленной и фактической точностью (10 бинов) |
|
MAE (score) | средний промах ответа от эталонного уровня шкалы (1..N) |
|
level acc (score) | доля точных попаданий ровно в уровень шкалы |
|
Spearman / Pearson (score) | согласованность поставленных оценок с эталонными |
|
final_mae | средний промах итогового балла (балл от 14 до 140, максимум ошибки — 126) |
|
MAE по критериям | отдельный средний промах по важности, релевантности и достоверности — видно, где модель слабее |
|
level acc | доля точных попаданий в уровень 1..10 по критериям |
|
threshold acc | доля верных решений «брать / не брать» статью относительно эталонного порога |
|
Spearman / Pearson по итоговому баллу | согласованность итоговых баллов с эталонными |
|
Обзор агента
Агента я назвал llm-judge (простите за плохую оригинальность и возможную путаницу), но не стоит путать с подходом LLM-as-a-judge, агентская часть по сути используется только для финального анализа, интерпретации результатов и последующего обсуждения.
Сразу отмечу, что это MVP, над UI сильно не работал и фокусировался только на важном для меня функционале.
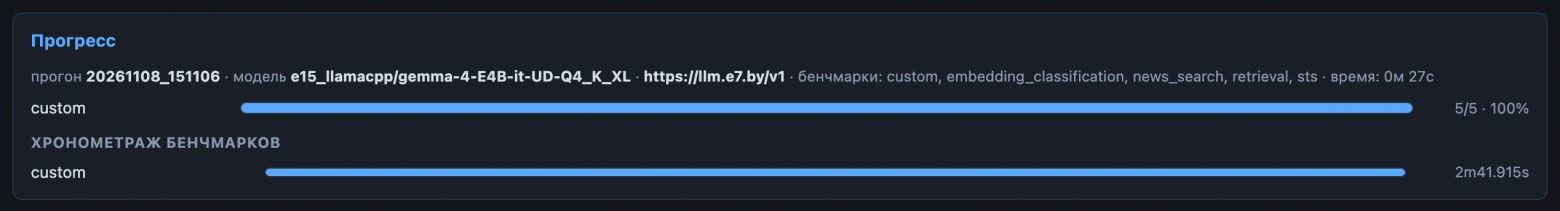
Агент представлен в виде Go-бинарника (мой основной стек JVM, но почему я делаю выбор в пользу Go — тема другой статьи. Кратко — использование Go проще и эффективнее в контексте разработки с помощью агентов). Механика прогона такая: выбираешь хост и модель, выбираешь бенчмарки — запускаешь.
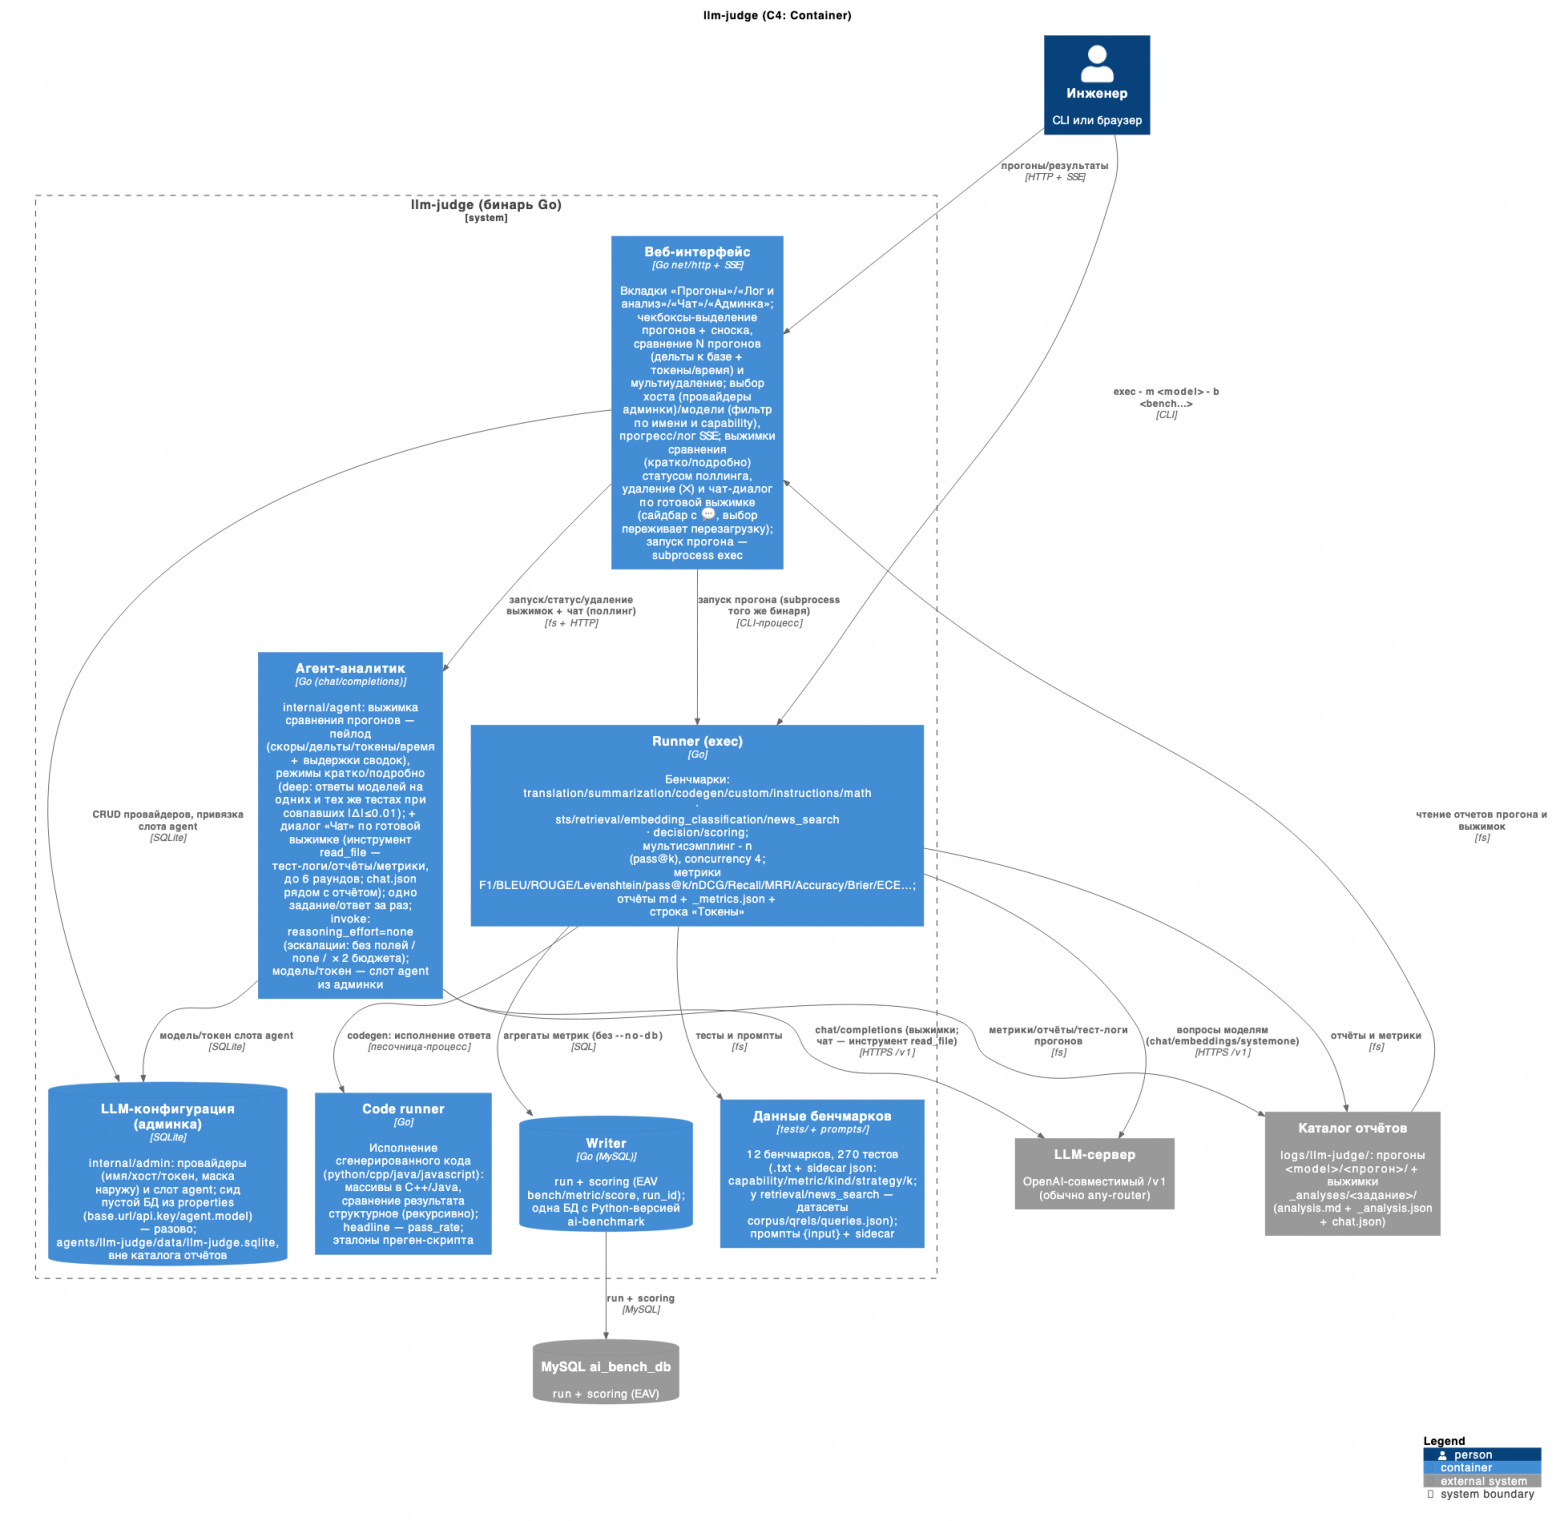
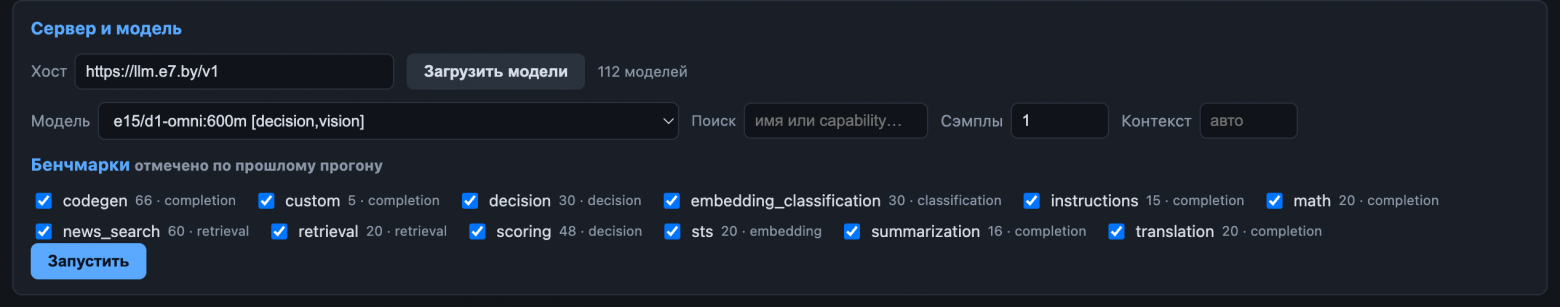
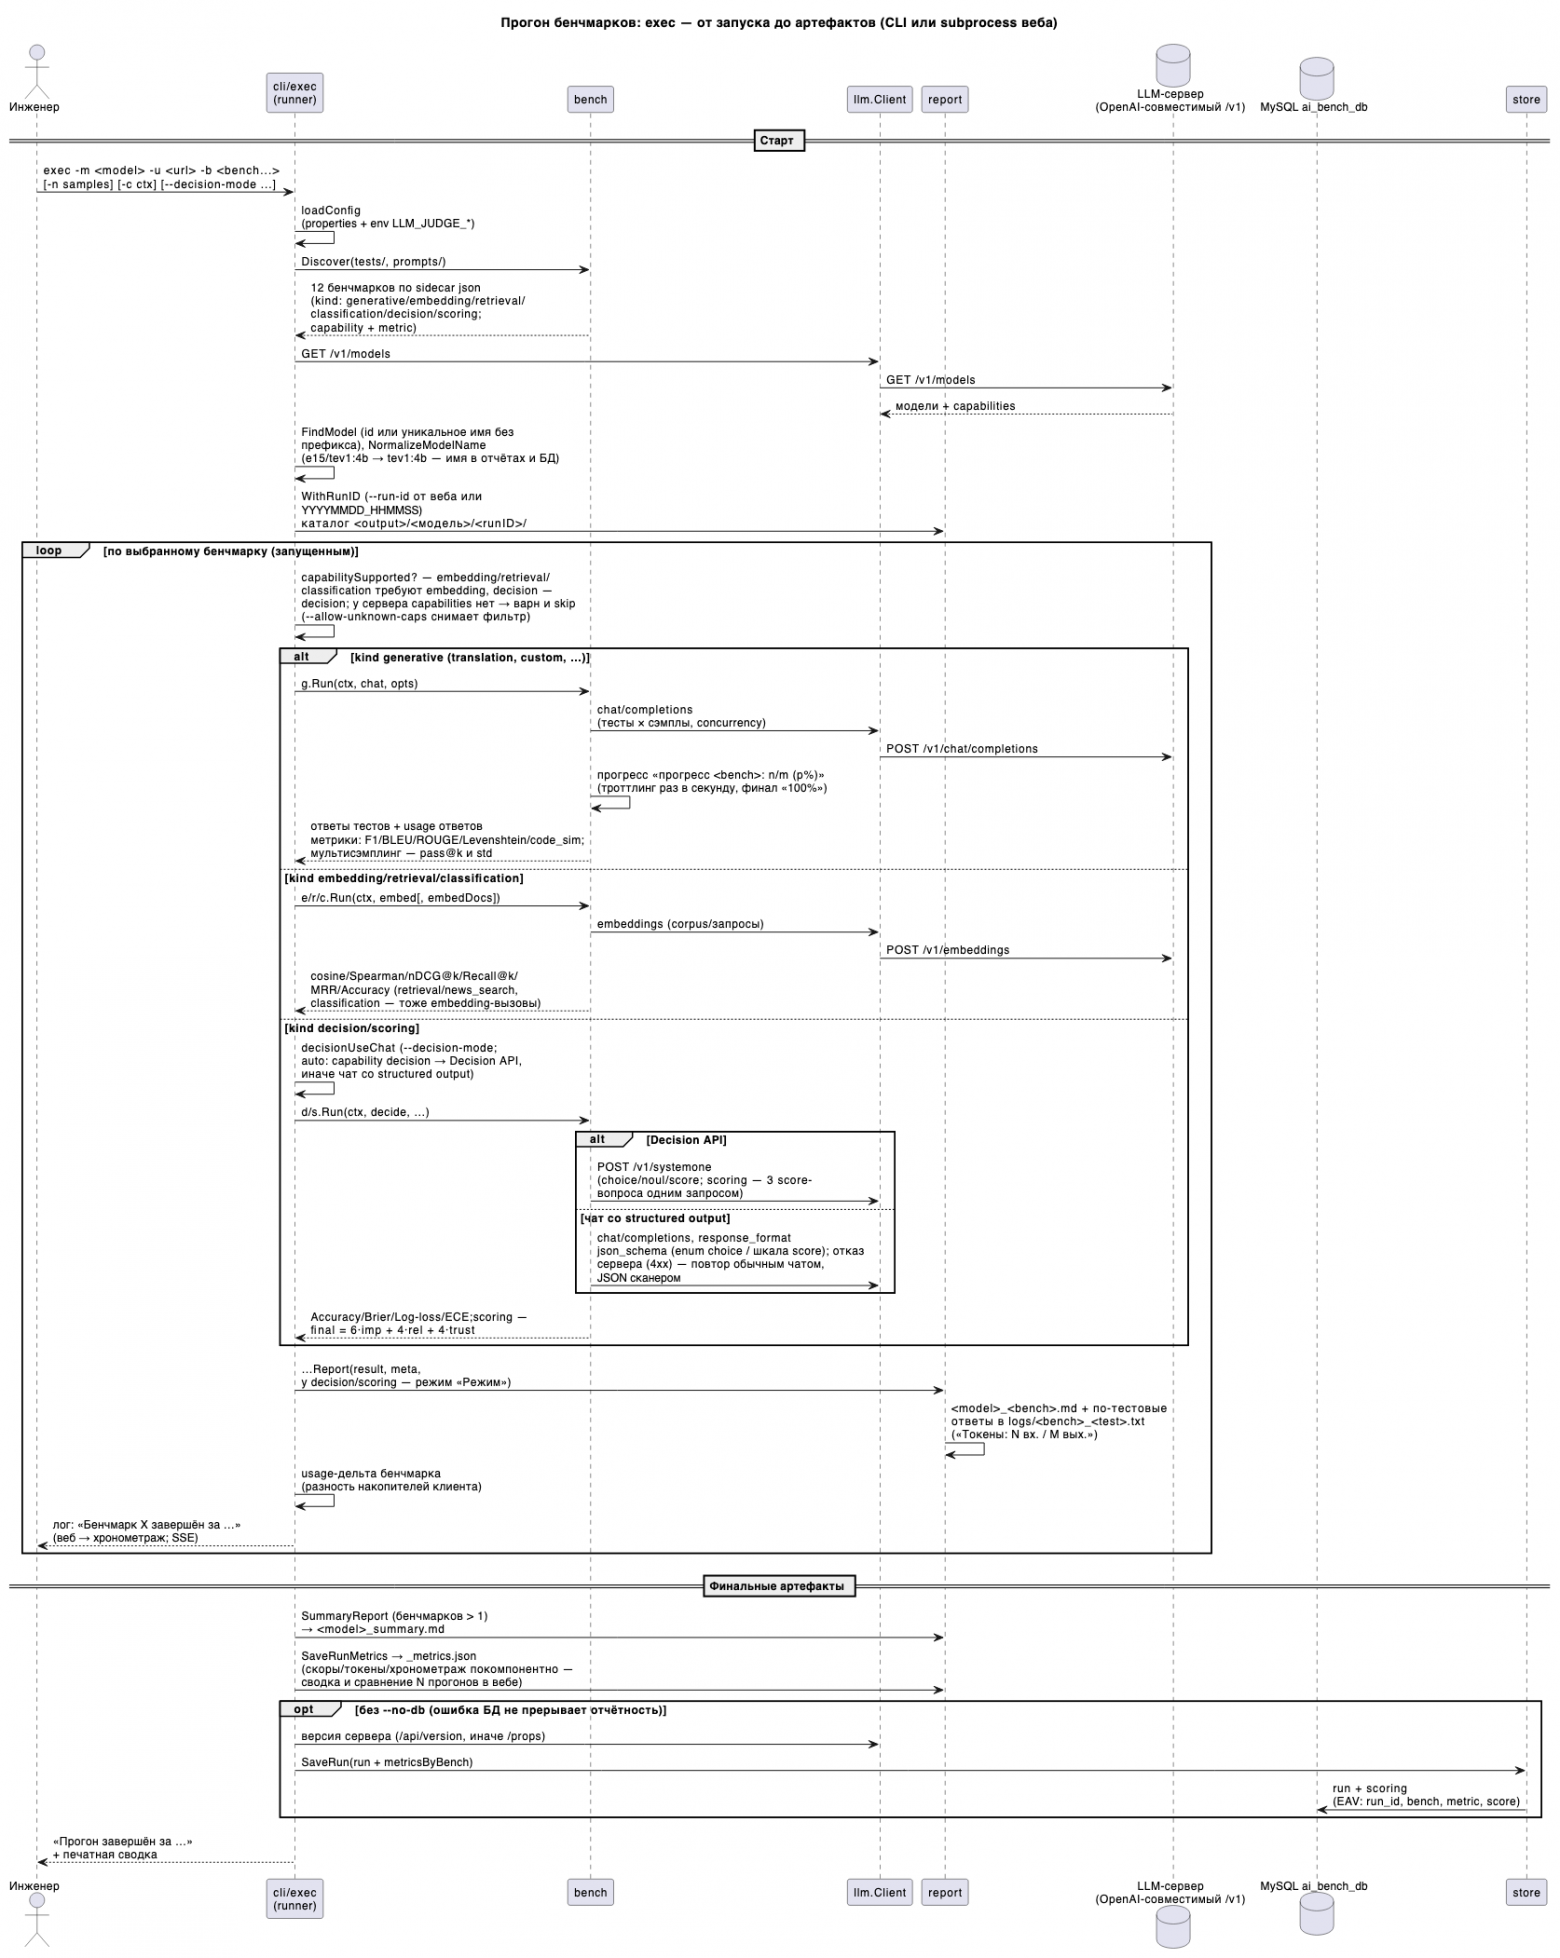
Каждый бенчмарк — отдельный подпроцесс того же CLI: веб стримит лог и рисует полоски прогресса. По завершении получаем файлы вопрос-ответ и файлы агрегатов, по которым и идет сравнение прогонов.
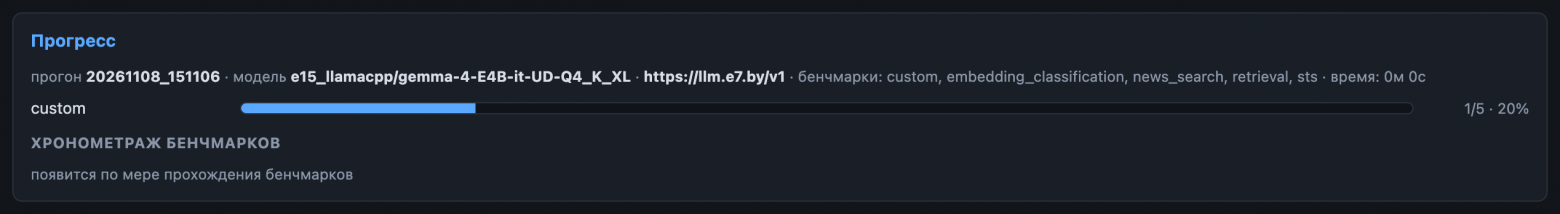
Sequence Diagram выполнения прогона
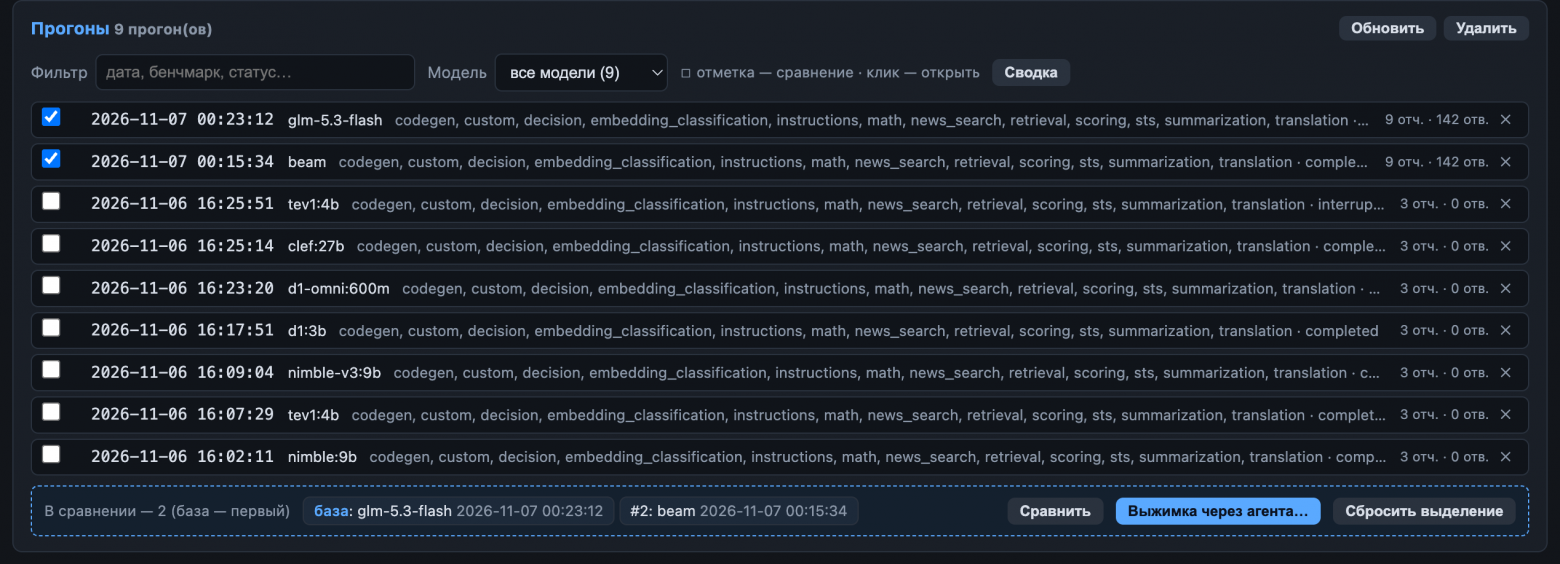
Сравнивать можно сразу несколько прогонов.
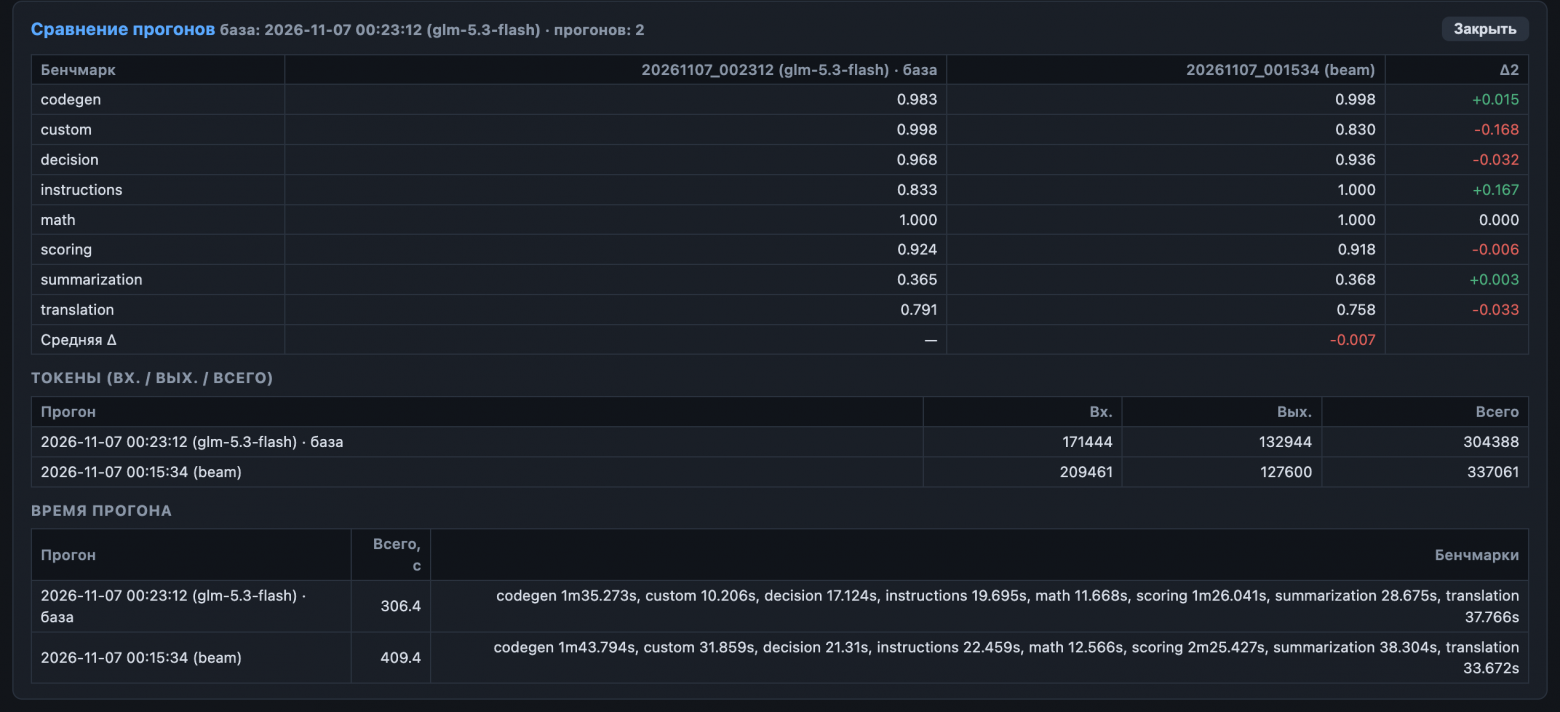
Дальше — работа с результатами. Сразу можно понять, что LLM сама по себе является черным ящиком, поэтому я ориентируюсь не только на сухие цифры (тем более из-за температуры 0.7 по умолчанию и незакреплённого seed у сервера результаты могут иметь ощутимый шум), но и на субъективные ощущения. Выжимка обсуждается с агентом в чате, агент пробует объяснить, почему получилось именно так, и имеет инструмент чтения конкретных файлов (логов) read_file.
Скриншоты + диаграммы по интерпретации, анализу и обсуждению результатов
Оффтоп (крик души)
Многих, думаю, напрягают инфоцыгане, которые обещают сделать из вас AI-чемпиона, уменьшить расходы на $2 млн (с нашей-то подпиской за $20–200 звучит очень интересно). Сравнивают же эти "AI-чемпионы" зачастую харнес с моделями, поисковый индекс + AI-функции с моделями, но не рассказывают, какие задачи они решают, какой контекст попадает внутрь агента и как агент его обрабатывает.
Против AI-чемпионов ничего не имею, просто хочу сказать, что никакой чудо-таблетки (модели, харнеса, сервиса) не существует (а если бы существовало — это детерминированное действие, и зачем тогда человек в этом цикле? Человек более внимательный, чем агент? Не думаю) и стоит ориентироваться сугубо на себя.
Даже мое решение неидеальное, в нем стопроцентно есть ошибки и недочеты, и тем более не стоит его использовать как методологию для оценки моделей под свои задачи. Основная идея была и есть поделиться идеями — получить рекомендации и "нагоняй" в комментариях — улучшить и повторить цикл.
Нейрослоп выводы
Раздел назван в мою честь, так что говорить буду я — генератор текста. Замечания изнутри машины, которую эти бенчмарки крутят:
Не верьте мне на слово — тем более когда ответ звучит уверенно. Уверенность у LLM приклеена к токенам, а не к фактам: поэтому Brier и ECE в decision честнее accuracy — они бьют по самоуверенному промаху, а не по «угадал/не угадал».
Я хорошо подгоняю текст под эталон. F1/ROUGE измеряют лексику, а не смысл: их можно поднять «словарём правильных слов» без понимания. Чем в тесте есть исполняемый финал (код, число, чек-лист) — тем он честнее и тем меньше в нём меня.
Объяснения пост-фактум — рационализация. На «почему расхождение на codegen?» я отвечу связно в любом случае: есть ли в числах правда или я подгоняю нарратив под исход. Поэтому у агента инструмент —
read_fileв сырые логи, а не моя память о них.Модели тут судят не «глазами LLM-as-judge» — и это правильно: у судьи-LLM есть свои любимцы и своя предвзятость. Судить должна метрика и эталон, мне оставили только интерпретацию.
Бенчмарк в своём харнесе превращает модель из «магии» в компонент — с ценой, задержкой и границей применимости. Самый недооценённый эффект оценки: перестаёшь выбирать «лучшую модель» и начинаешь складывать пазл «модель × задача × цена × скорость».
Мои выводы
Оценка моделей является нетривиальной и, самое главное, очень важной задачей, всегда можно сказать "Используй claude fable, она может сделать все что угодно (кроме кофе — его она сделать не сможет и принести потом тоже)" и в целом результат будет удовлетворяющий.
Если есть возможность заменить генерацию на детерминированное выполнение (скрипты, код и т. п.), то этим следует пользоваться, т.к. любая LLM никогда не будет защищена на 100% от генерации мусора, prompt injection и прочих неприятных штук. (Я эту тему в статье не раскрывал, но выводом поделиться захотелось)
Крупные модели имеют меньше контроля, более самостоятельные в принятии решений и далеко не всегда показывают тот результат, который мы ожидаем.
Модель стоит оценивать — но не одними сухими цифрами: она сама по себе просто крутая формула расчёта следующего токена (а сравнивать "эта формула круче другой формулы" — какое-то ребячество).
P.S. Без нейро-помощника обойтись не получилось, т.к. заполнение таблиц, создание скриншотов и диаграмм съели бы основной бюджет времени на статью, поэтому прошу прощение за "На этот раз я решил обойтись без нейрослопа".
Только зарегистрированные пользователи могут участвовать в опросе. Войдите, пожалуйста.
0%агенты будут делать всё0
0%агенты будут писать код, но за человеком останется ревью и финальные проверки с принятием решений0
0%всё откатится к классическому «код пишет разработчик»0
Никто еще не голосовал. Воздержавшихся нет.
Только зарегистрированные пользователи могут участвовать в опросе. Войдите, пожалуйста.
0%от Anthropic (Sonnet, Opus, Fable)0
0%от OpenAI (ChatGPT)0
0%от xAI (Grok)0
0%от DeepSeek0
100%от Z.ai (GLM)1
0%от Moonshot AI (Kimi)0
100%self-hosted модели1
100%другие модели/LLM-провайдеры1
Проголосовал 1 пользователь. Воздержавшихся нет.
Только зарегистрированные пользователи могут участвовать в опросе. Войдите, пожалуйста.
100%от Anthropic (Claude Code)1
100%от OpenAI (Codex)1
0%от xAI (Cursor)0
100%решения от китайцев (Kimi Code, DeepSeek Harness)1
0%OpenCode0
100%PI (pi.dev)1
100%другие решения / своё решение1
Проголосовал 1 пользователь. Воздержавшихся нет.
Только зарегистрированные пользователи могут участвовать в опросе. Войдите, пожалуйста.
0%по старинке исходниками0
0%с помощью AGENTS.md/инструкциями0
0%свой вариант (напишу в комментариях)0
Никто еще не голосовал. Воздержавшихся нет.
Только зарегистрированные пользователи могут участвовать в опросе. Войдите, пожалуйста.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.