Как сайту попасть в ответы Claude с поиском в интернете: важны поисковые и пользовательские боты, а не ClaudeBot
У Anthropic три бота с разными задачами: один собирает тексты для обучения ИИ-моделей, второй индексирует страницы для поиска Claude в интернете, третий приходит, когда пользователь просит прочитать страницу. В robots.txt каждого можно закрыть отдельно, но сайты закрывают и тех, от кого зависят ответы. Crawl Readiness в октябре 2026 года проверил топ-1000 сайтов: Claude-SearchBot закрыт у 63 из 569 сайтов, где robots.txt вообще есть, то есть у каждого девятого. Страница попадает в источники Claude, только если её видит поиск, через который он ищет, и на сайт пускают поискового и пользовательского ботов. Обучающий ClaudeBot на это почти не влияет, так что если цель была не отдавать тексты в обучение, хватило бы закрыть его одного.
Когда Claude ищет ответ в интернете, а когда отвечает по памяти
Claude решает сам. В анонсе для разработчиков Anthropic описывает это так: если поиск поможет, Claude составляет запрос, читает результаты и отвечает со ссылками на источники. С 27 мая 2025 года поиск есть на всех тарифах по всему миру, а в новом интерфейсе нет даже переключателя: по справке на октябрь 2026 года, Claude ищет, когда это помогает. Ищет он нечасто. В исследовании State of AEO 2026 Джоша Блышкала и Джасмана Сингха Claude включил поиск в 36,6% случаев, чуть больше чем в каждом третьем. В остальных ответах он говорит по памяти, и страница туда попасть не может.
Принудительно поиск включает фраза Search the web или Use web search в вопросе, так советует сама Anthropic. Чтение страницы по ссылке от пользователя Anthropic называет web fetch: здесь Claude ничего не ищет, он открывает ровно ту страницу, которую ему дали.
Каким поиском пользуется Claude и почему замеры указывают на Brave
Anthropic поисковый провайдер Claude не называет, но следы ведут к Brave Search. Саймон Уиллисон заметил, что с 19 марта 2025 года Brave Search записан в Trust Center Anthropic как субпроцессор (пересказ в блоге Crawlmind). Complete SEO сравнила выдачи на 1 481 запросе: 87,8% страниц, которые получил поиск Claude, стояли в топ-10 Brave, а в топ-10 Google по тем же запросам — только 45,6%. По 52 клиентам той же компании разница ещё резче: сайт с 1–3 места в Brave Claude цитировал в 92% ответов, сайт вне топ-20 всего в 12%.
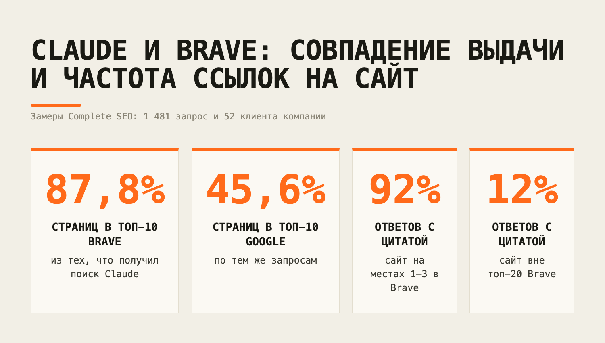
Совпадение выдач причину не доказывает, и сама Anthropic Brave не подтверждала. Но сайту вне топ-20 Brave, судя по этим цифрам, рассчитывать на ссылку Claude почти не приходится.
Какой из ботов Anthropic за что отвечает и что будет, если его закрыть
На обучение влияет только ClaudeBot, на видимость в Claude отвечают двое других. Таблица собрана по справке Anthropic для владельцев сайтов от 7 апреля 2026 года.
User-agent | За что отвечает | Что будет, если закрыть |
|---|---|---|
ClaudeBot | сбор данных для обучения ИИ-моделей | будущие материалы сайта исключаются из обучающих наборов |
Claude-SearchBot | индексация страниц для поиска Claude | страницы не индексируются, видимость сайта в результатах поиска Claude может снизиться |
Claude-User | получение страницы по запросу пользователя | Claude не прочитает страницу по запросу, видимость при поиске по запросу пользователя может снизиться |
Блокировать ботов по IP Anthropic не советует: тогда они не смогут прочитать robots.txt, и отказ может не сработать. Отказ оформляют в robots.txt, на каждом поддомене отдельно.
Как закрыть ClaudeBot в robots.txt и не закрыть ботов, от которых зависят ответы Claude
Фрагмент закрывает сайт только для обучения и явно пускает двух остальных ботов.
User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /
User-agent: ClaudeBotначинает группу правил для обучающего бота.Disallow: /закрывает ему весь сайт. Если обучение не мешает, обе строки можно убрать.User-agent: Claude-SearchBotначинает группу для бота, который собирает поисковый индекс.Allow: /открывает ему весь сайт. Группа с именем бота заменяет для него общие правилаUser-agent: *, так что разрешение сработает и при общем запрете (по данным Crawl Readiness).User-agent: Claude-Userначинает группу для бота, который читает страницу по запросу пользователя.Allow: /открывает ему весь сайт.
Какие страницы Claude берёт в источники и чем они отличаются от источников ChatGPT
Claude чаще ChatGPT ссылается на подборки и почти не берёт форумы. По State of AEO 2026, статьи-подборки вроде десяти лучших сервисов дали 36,4% размеченных источников Claude против 19,7% у ChatGPT, а форумы 0,9% против 15,8%. Общих доменов у двух нейросетей в среднем всего 8%: место в источниках ChatGPT почти ничего не говорит о месте у Claude.
Под Claude не нужна отдельная оптимизация контента. Сайту нужно не закрыться по ошибке от Claude-SearchBot и Claude-User и попасть в индекс поиска, через который Claude ищет. Тот, кто запретил всех ботов Anthropic разом из-за обучения, сам вычеркнул себя из источников Claude.
Как проверить, что сайт открыт для Claude и попадает в его ответы
Страница доходит до ответа Claude по цепочке: бот проходит robots.txt и защиту сайта, страница попадает в индекс, Claude решает искать и ставит её в источники. Проверять удобно в том же порядке.
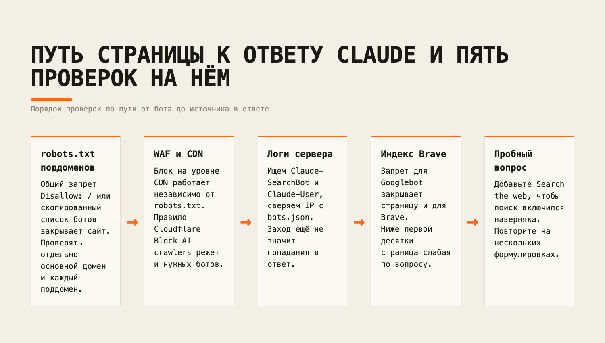
1. В robots.txt каждого поддомена нет запрета для Claude-SearchBot и Claude-User
Откройте /robots.txt на основном домене и на каждом поддомене со страницами. Ищите общий запрет User-agent: * с Disallow: / и скопированные списки блокировки ИИ-ботов. Если в таком списке названы все три бота Anthropic, сайт может выпасть и из поиска Claude, и из чтения по запросу. Разработчикам пригодится ещё одно: в Managed Agents API домен, закрытый для краулера Anthropic, нельзя внести в allowed_domains, список сайтов, которые агенту разрешено искать и читать. API такой домен отклоняет.
2. WAF и CDN не режут ботов Anthropic мимо robots.txt
WAF — фильтр запросов к сайту, CDN — сеть, которая раздаёт сайт посетителям; их настройки ищите в панели хостинга или CDN-провайдера либо спросите администратора. Блок на уровне CDN работает независимо от robots.txt, и разрешение в файле его не снимет. У Cloudflare есть готовое правило WAF Block AI crawlers (GPTBot, ClaudeBot, etc.) на базе Bot Management. Если оно включено, проверьте, кого оно режет, и добавьте исключения для Claude-SearchBot и Claude-User. Адреса ботов Anthropic, по данным Crawl Readiness, опубликованы в claude.com/crawling/bots.json. Как Cloudflare изменил доступ ИИ-ботов к сайтам и где проверить настройки, я разбирал отдельно.
3. В логах сервера есть заходы Claude-SearchBot и Claude-User
Найдите в логах доступа строки с этими именами в user-agent и сверьте IP со списком из bots.json. Claude-SearchBot приходит сам, чтобы собрать индекс. Claude-User приходит, когда пользователь попросил страницу, поэтому его заход, скорее всего, появится после пробного вопроса со ссылкой. Заход ещё не значит попадания в ответ: в исследовании 10 ассистентов по серверным логам на 200 пробах ассистенты заходили на страницу и не показывали её, а иногда не заходили даже на разрешённую.
4. Страница есть в индексе Brave и не закрыта noindex
Своего user-agent у краулера Brave нет, и он не обходит то, что в robots.txt закрыто для Googlebot: запрет для Google закрывает страницу и для Brave. Убрать страницу из индекса robots.txt не может, для этого нужен noindex — запрет индексации в коде страницы или в заголовке ответа сервера. Проверьте, нет ли его на страницах, которые должны попадать в ответы. Потом задайте на search.brave.com вопрос, под который написана страница, и поищите её адрес в выдаче. Совсем нет — возможно, страницы нет в индексе, но один вопрос этого не доказывает: поиск мог просто не показать её по этой формулировке. Повторите на нескольких формулировках, и если страницы нет ни в одной, индекса, скорее всего, нет. Есть, но ниже первой десятки — она в индексе, но по этому вопросу слабая.
5. Claude читает вашу страницу и называет её источником
Дайте Claude ссылку на страницу и попросите её пересказать. Не вышло — вернитесь к robots.txt и WAF. Затем задайте вопрос, на который страница отвечает, и добавьте Search the web: так поиск включится наверняка. Посмотрите, есть ли ваш адрес среди источников под ответом, и повторите на нескольких формулировках: один ответ о попадании почти ничего не говорит.
Помогут ли эти пять проверок попасть в ответы Claude на русскоязычные вопросы
Связь с Brave держится на замерах Complete SEO и State of AEO 2026, а доля 36,6% ответов с поиском взята из одного исследования. На русскоязычных запросах картина может быть другой. Поэтому шаги выше проверяют доступ ботов и индекс, а место в ответе не гарантируют. Интересно, видел ли кто-нибудь Claude-User в логах русскоязычного сайта и после каких вопросов он приходил.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.