Автоматическая обработка заказов в DIY-ритейле: от входящего письма до готового коммерческого предложения (часть 1)
Привет, Хабр! Меня зовут Александра, я Data Scientist в компании Рафт. Часто в DIY-ритейле можно столкнуться с такой проблемой: клиент присылает excel таблицу с десятками товаров, pdf файл на несколько страниц и письмо в духе «нужен еще гипсокартон 2500х1200х12,5 мм 10 листов». Все это за 5–15 минут менеджерам нужно превратить в нормальное коммерческое предложение.
Мы подумали: а давайте сделаем end-to-end ИИ-систему, которая сама разбирает любой входящий файл или сообщение, понимает, что нужно клиенту, подбирает релевантные товары и формирует готовое КП. Без траты на миллиард токенов и с ограниченным бюджетом.
В статье - честный разбор: что сработало, какие гипотезы не прошли, наш индивидуальный подход и как мы экономим на LLM.
Если вы тоже мучаетесь с неструктурированными заявками - добро пожаловать, сейчас будет полезно.
Содержание статьи:
Бизнес-контекст
Как устроен наш пайплайн
Классификатор
Извлечение позиций
Поиск товаров и сопоставление с каталогом
Расчет фасовки и единицы измерения
Как выглядит итоговая система
Заключение
Бизнес-контекст
В DIY-ритейле (строительные и отделочные материалы) большая доля входящих заказов от клиентов приходит в совершенно неструктурированном виде. Менеджеры по продажам ежедневно получают: текстовые сообщения, Excel-таблицы, многостраничные PDF с таблицами, Word документы, содержащие абзацы текста с товарами.
Источники заявок - WhatsApp, Telegram, Max, почта и другие. Заранее неизвестно, в каком именно вложении или тексте спрятана основная потребность клиента.
Одна заявка может содержать от 5 до 150+ позиций. При этом система должна уметь обрабатывать до нескольких тысяч таких заявок в день.
Мы считаем заявкой запрос клиента, если встречается такая тройка: наименование товара → количество → единица измерения.
Примеры заявок
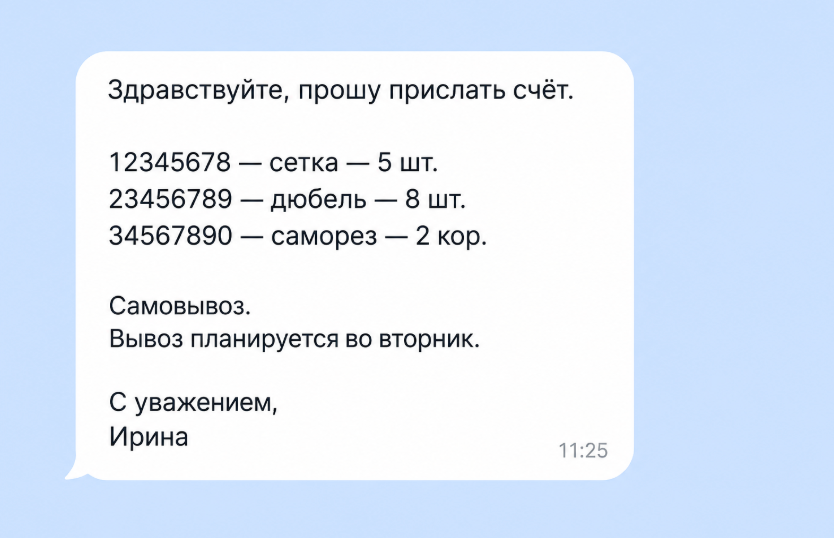
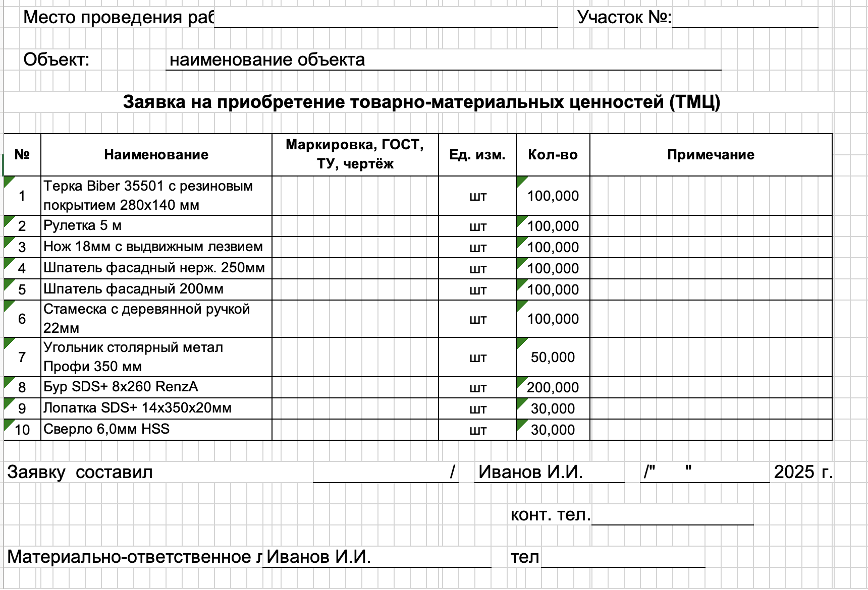
Пример. Сообщение + excel-файл с таблицей.
Сообщение: “Добрый день. Во вложении заявки, прошу выставить КП с доставкой на Ленина, д.45.”
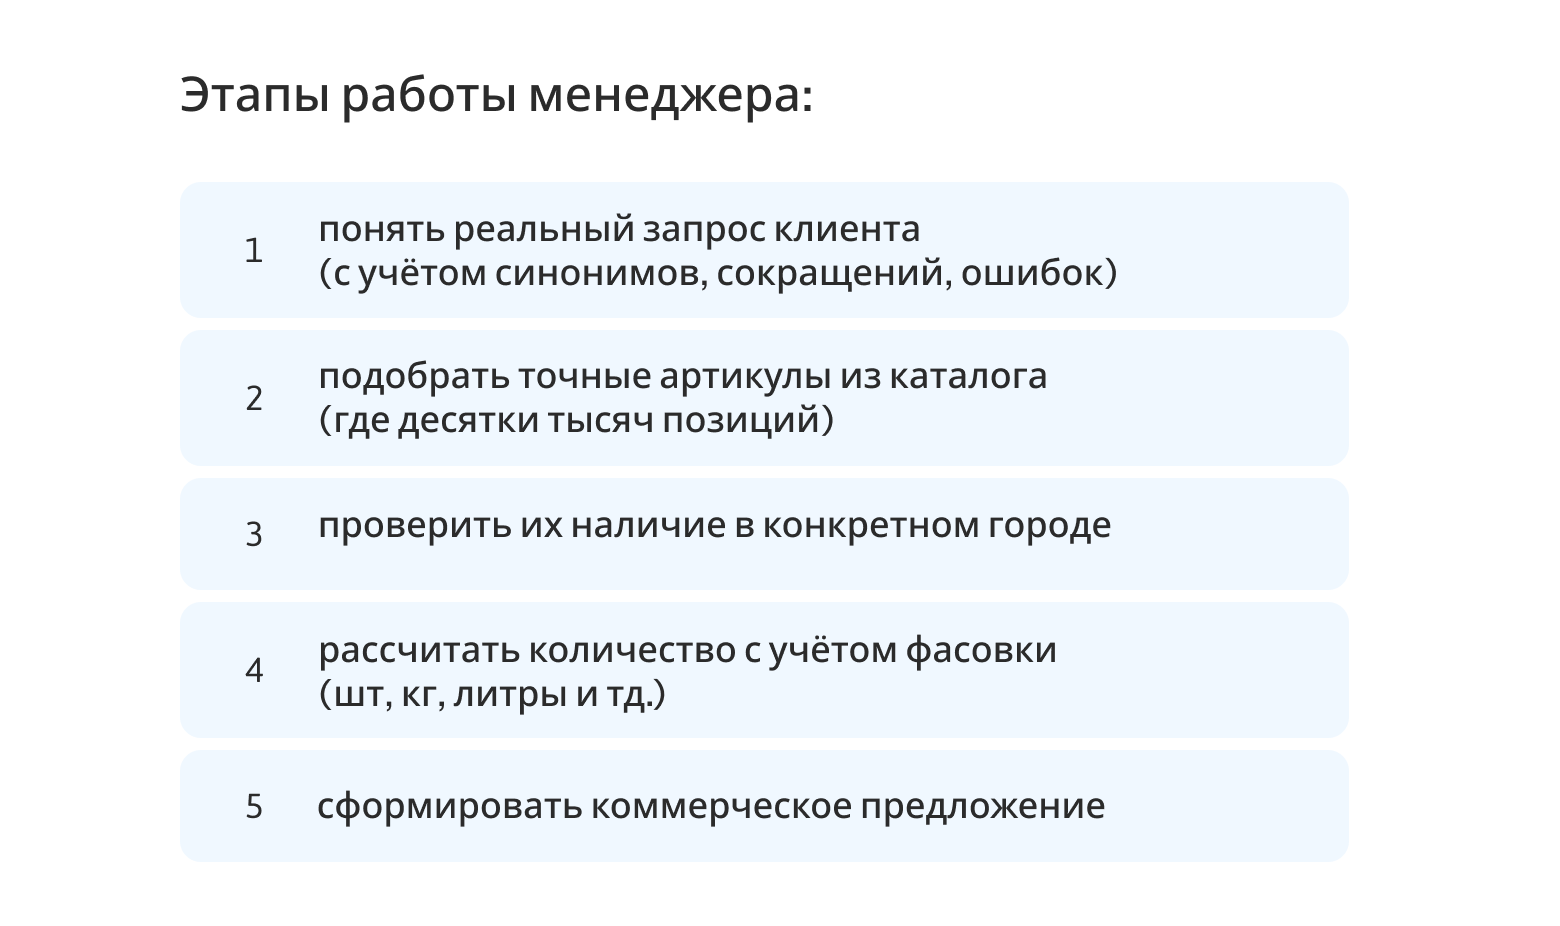
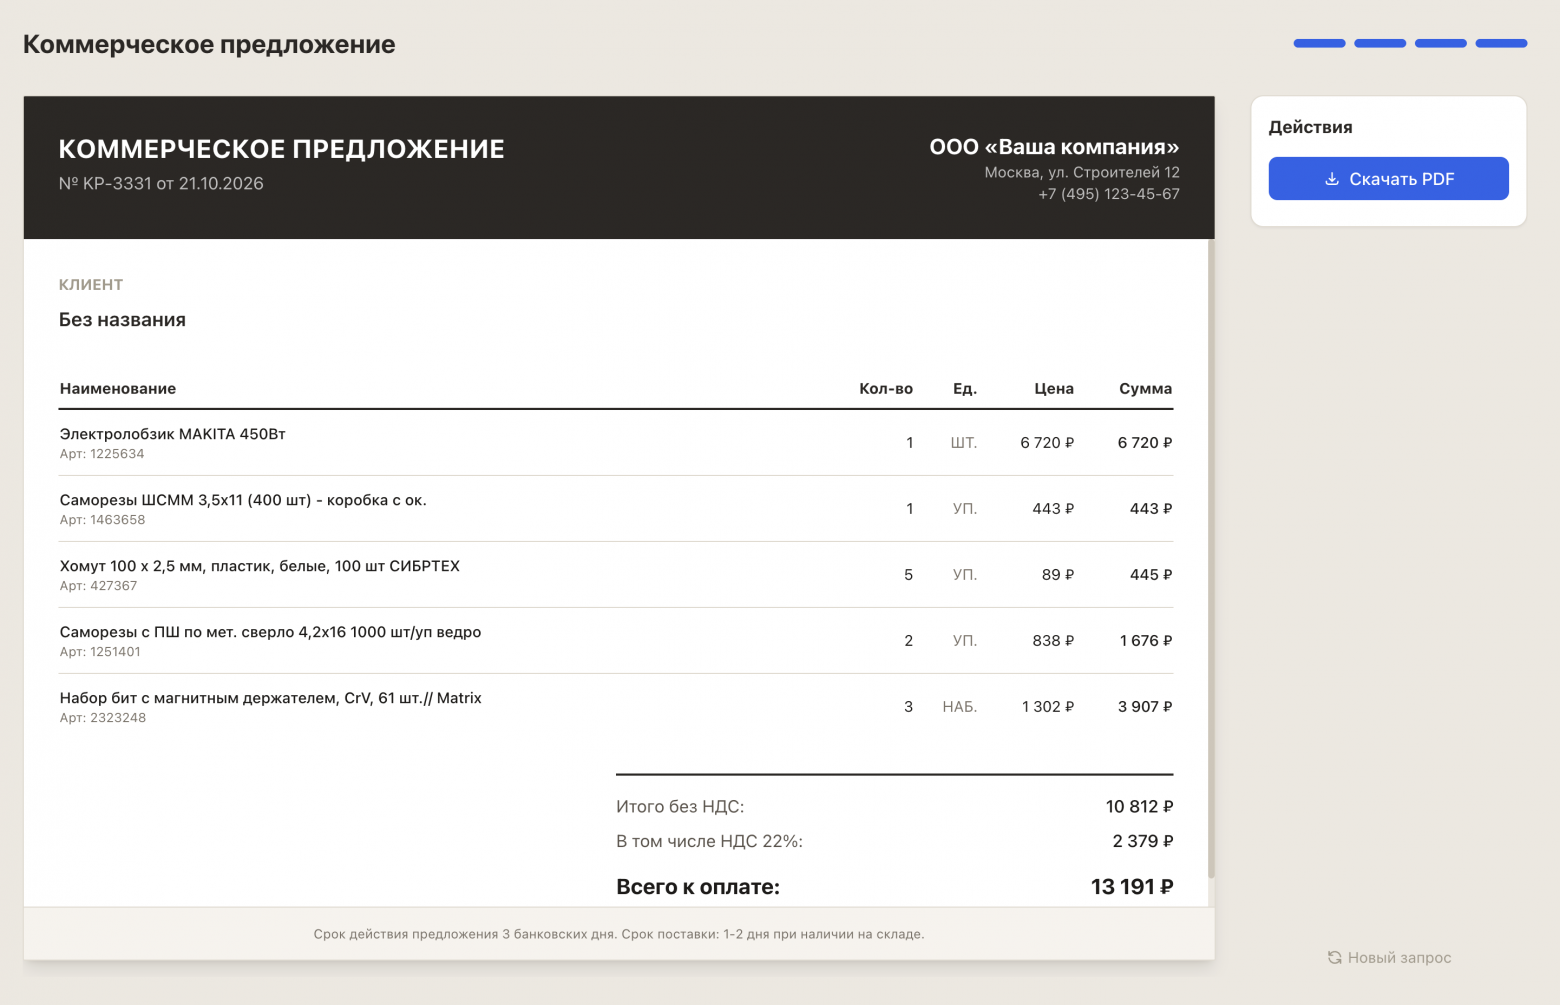
На выходе мы должны получить автоматически сформированное коммерческое предложение, которое включает:
подобранные товары из каталога,
скорректированное количество с учетом фасовки
степень уверенности: точное соответствие / приблизительное (нашли ближайший аналог) / не найдено
цены
итоговая сумма
Цель нашей системы - максимально автоматизировать этот путь от входящего сообщения/файла до готового КП, чтобы менеджер получал уже почти готовый документ, который остается только проверить, если что отредактировать и отправить. При этом важно, чтобы решение не тянуло за собой много расходов, а качество подбора оставалось достаточным для бизнеса: менеджер должен тратить время на проверку и точечные правки, а не на ручной поиск товаров.
Как устроен наш пайплайн
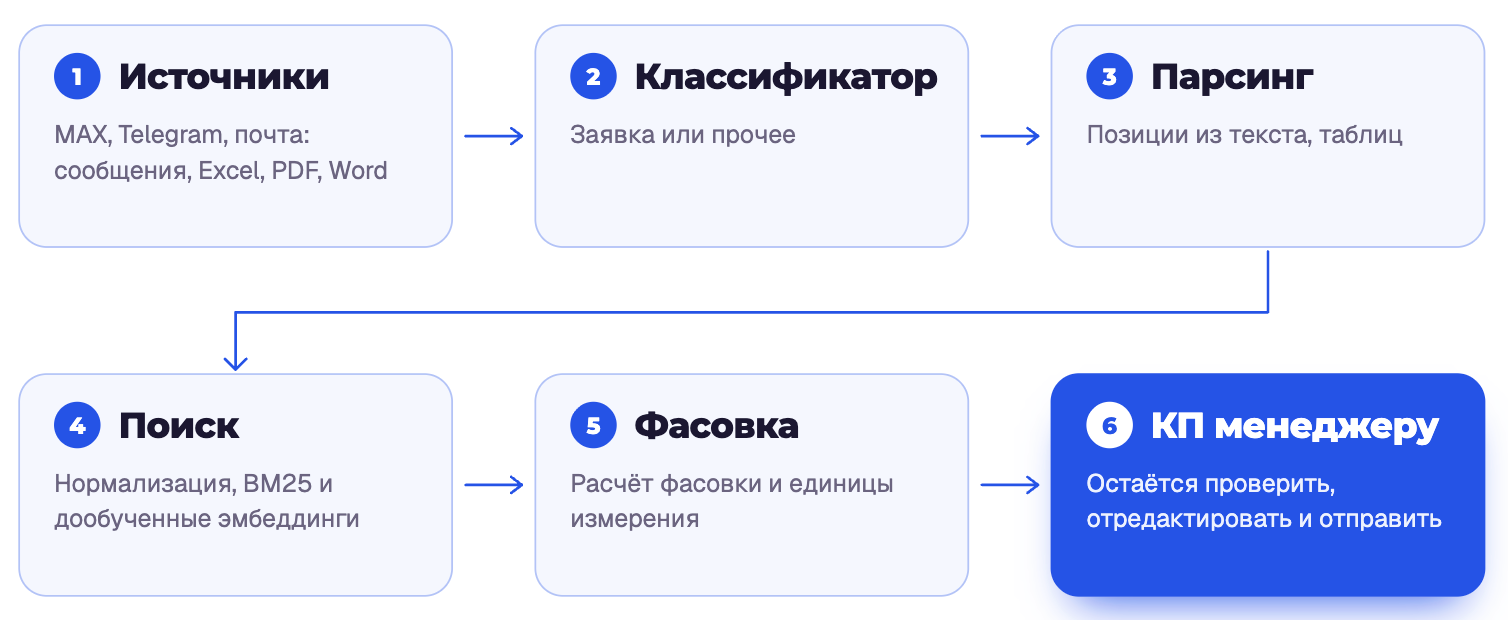
Чтобы превратить неструктурированные входящие заявки в структурированные коммерческие предложения, мы построили end-to-end пайплайн, который сочетает классические методы (регулярные выражения, эвристики) с современными ИИ-подходами (LLM, гибридный поиск).
Пайплайн работает в несколько последовательных этапов:
Загрузка и чтение файлов/сообщений
Классификация обращений
Извлечение позиций (парсинг)
Поиск и сопоставление с каталогом
Расчет фасовки и единицы измерения
Формирование коммерческого предложения
Классификатор
Для классификации хорошо бы подошла LLM, буквально за один промпт ей можно было бы объяснить, что является заявкой, а что - просто запросом доставки или жалобой.
Но мы решили пойти сложной дорогой и разработать собственный лёгкий классификатор на регулярных выражениях + эвристиках.
Почему?
Экономия токенов и денег на вызов LLM.
Скорость: классификатор работает за миллисекунды, без ожидания ответа от большой языковой модели.
Полный контроль и предсказуемость: нам важно понимать, почему именно это сообщение отсеяно, без «чёрного ящика» LLM.
Подход 1. По ключевым фразам.
Сначала мы пытались классифицировать заявку по фразам-просьбам («выставьте счёт», «сделайте КП» и т.п.).
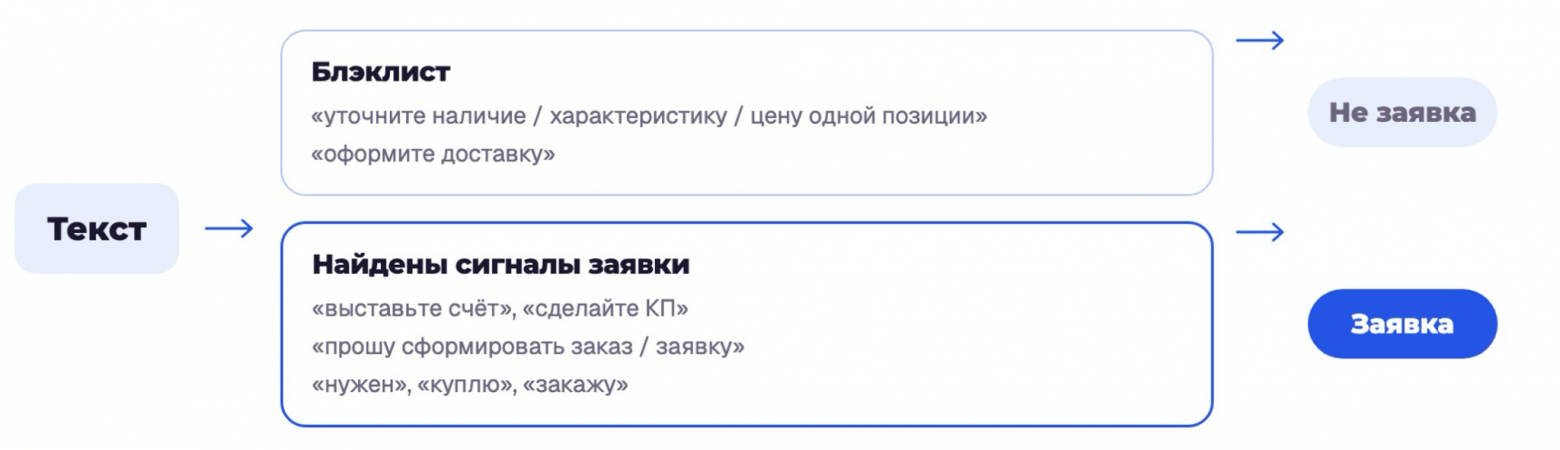
Однако с таким подходом мы увидели ряд проблем на реальных данных при тестировании.
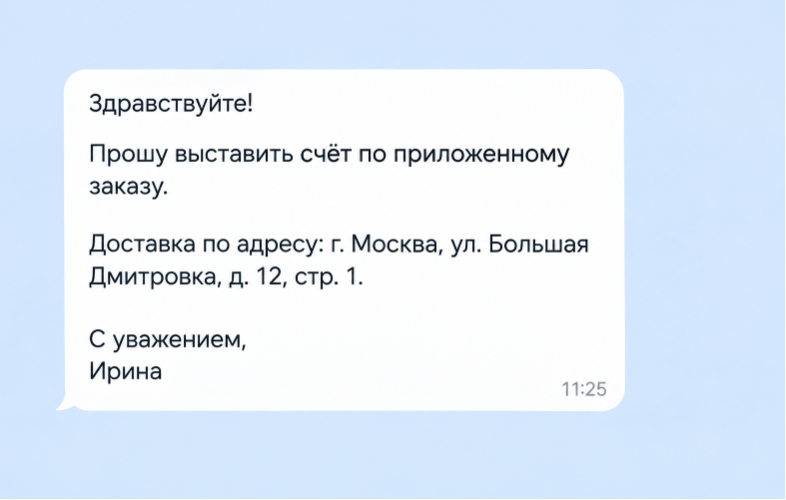
Первая проблема. В сообщение есть просьба выставить счет, а сама заявка находится в таблице или файле, но неизвестно в каком конкретно прикрепленном файле (клиенты часто прикрепляют реквизиты и прочие файлы).
Вторая проблема. Если в сообщении/файле нет ключевых слов, а представлены только товары, то будет классифицировано не заявкой.
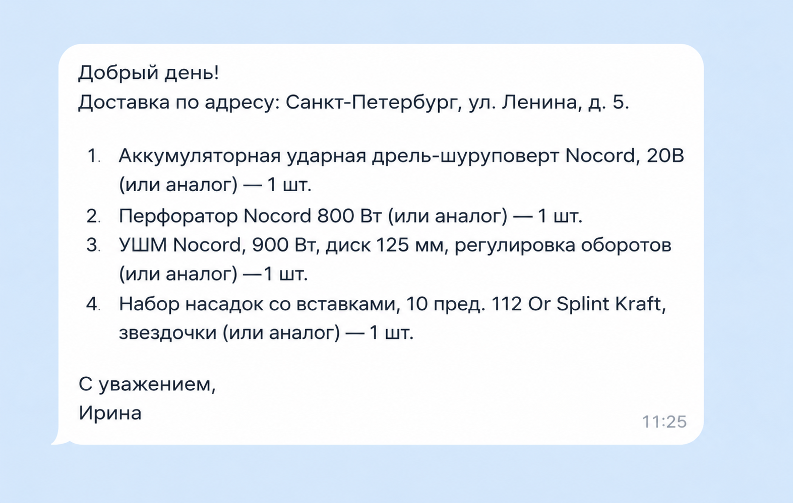
Подход 2. По наличию товарных паттернов.
Мы переосмыслили первый подход и перешли к трём независимым сигналам, не завязанным на конкретную фразу-просьбу, теперь основной сигнал - сам факт упоминания товаров, а не просьбы выставить счет.
Что ищем:
Паттерны вида «Название - Количество Единица»
Числовые паттерны количества + единицы: «1000 шт», «20 листов», «5 м³», «пару рулонов», «10–15 мешков»
Известный бренд рядом с единицей измерения
Заголовок таблицы-спецификации (отдельные паттерны под табличные форматы — Excel, PDF, Word)
Другие паттерны, которые характерны для товарных позиций.
Результат
На тестовом датасете классификатор показал F1 0,908 при recall 0,944 и precision 0,876. Нам важнее ничего не пропустить, поэтому recall мы ставили выше precision. Лишнее срабатывание не так критично: пустое вложение дойдёт до LLM, не найдёт позиций и вернется с пустым ответом.
Ограничения. Несмотря на улучшения, правило-based классификатор никогда не будет идеальным:
Он не понимает глубину текста и может плохо отрабатывать на сложных, нетипичных формулировках.
Новые бренды товаров - требуют апдейта словаря лемм.
Поэтому человеческий контроль остаётся обязательным. Все обращения отнесенные к «не заявка» попадают к менеджеру на проверку.
Извлечение позиций
После классификации мы переходим к ключевому этапу - вытащить из входящих сообщений и файлов конкретные позиции: наименование товара, количество и единицу измерения.
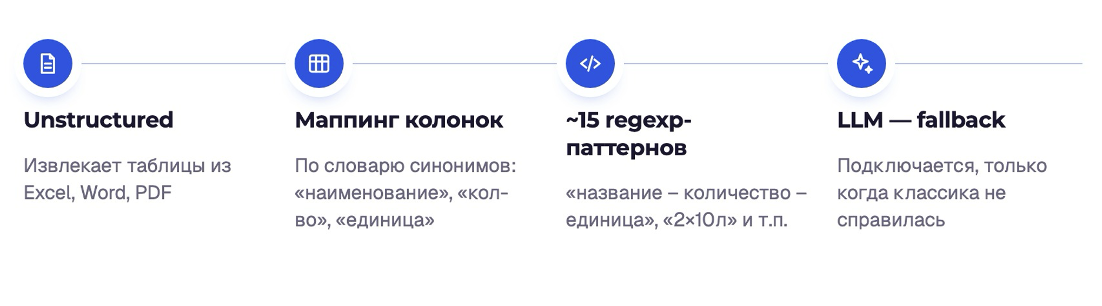
Мы решили протестировать гипотезу и использовать гибридный подход: сначала стараемся обрабатывать классическими методами (библиотеки + регулярные выражения + эвристики), и только в сложных случаях (≈30%) делаем фоллбэк на LLM.
1. Извлечение таблиц из документов
Часто заявки приходят в файлах: Excel, Word, PDF. Мы используем библиотеку unstructured — open-source решение для извлечения структурированного контента из документов. Она хорошо справляется с таблицами, текстом, заголовками.
Таблицы преобразуются в Pandas DataFrames.
Затем ищем нужные столбцы по списку синонимов и регекспов:
«наименование» → товар|продукт|название|наим.
«количество» → кол-во|кол.|количество
«единица» → единица измерения|ед. изм.|единица
Если столбцы найдены - маппим их в нашу тройку и чистим данные (убираем лишние символы, приводим единицы к стандарту).
2. Парсинг plain текста
Когда заявка просто представляет текст в сообщении или word документе, мы ищем позиции с помощью набора регулярных выражений. Эти паттерны собраны на основе анализа реальных заявок в DIY-ритейле и покрывают самые частые способы, которыми клиенты описывают товары. Это те же паттерны, что уже используются в классификаторе.
Всего около 15 основных паттернов, которые позволяют быстро извлекать большинство типичных записей без LLM.
3.Fallback на LLM для сложных кейсов
Если регулярки и unstructured не справились (сложные/нестандартные таблицы, пропущенные столбцы, новый формат текста) - делаем фоллбэк на LLM и просим извлечь позиции.
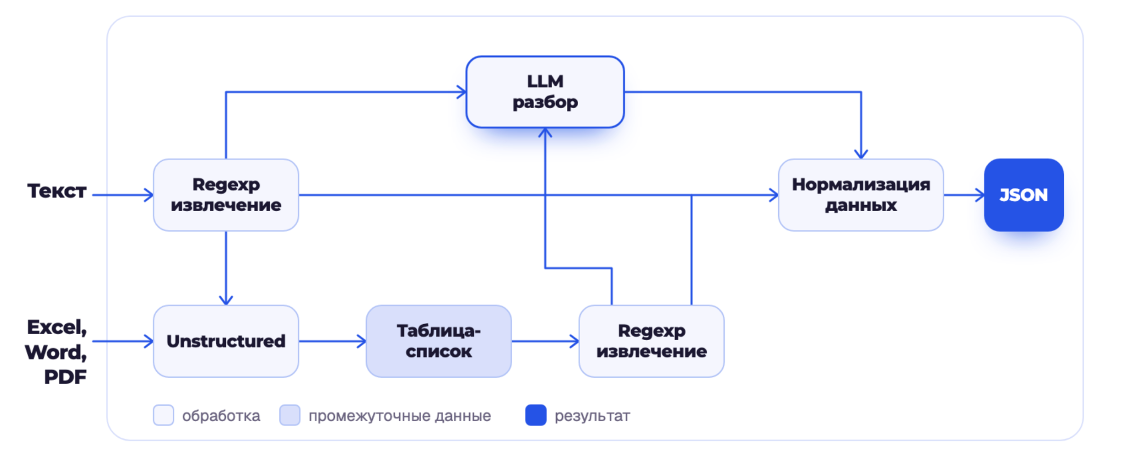
Но наша гипотеза не подтвердилась, на реальных данных мы увидели еще большее разнообразие формулировок, потерю позиций товаров, человеческие опечатки при написании сообщений. Под каждый новый кейс нужен был новый паттерн, а кейсов больше, чем успеваем писать паттернов.
В итоге перевернули пайплайн - LLM стала основным способом извлечения, regexp остался fallback-ом только для типовых таблиц. Модель понимает контекст, опечатки, синонимы, нестандартные формулировки, не привязана к единой структуре входного формата. Если бюджет позволяет - это один из самых быстрых и надежных способов, если данные очень неструктурированные. Мы протестировали - покрытие 90–95% случаев.
Выводы
Мы прогнали пайплайн на выборке реальных вызовов с Qwen3.6-35B-A3B. Это MoE-модель, в которой одновременно работают всего 3 млрд параметров, поэтому она и быстрая, и дешёвая.
Одно вложение (письмо, Excel, PDF или Word) в среднем обрабатывается за 1,5 секунды. Почти всё это время занимает сам вызов модели, а извлечение содержимого файла укладывается в 20 миллисекунд.
По токенам в среднем около 2,5 тыс. на входе и 0,4 тыс. на выходе. Даже на пиковой нагрузке расход остаётся небольшим.
Однако важно отметить, что примерно 80% стоимости вызова приходится на входные токены, а значительная часть промпта у нас одинаковая от заявки к заявке: системные инструкции и описание формата ответа. Такой повторяющийся префикс провайдер кэширует сам, и на нашей выборке в кэш попадало около 57% входных токенов. При заявленной провайдером скидке на кэшированные токены это даёт до 35% экономии на каждом вызове.
Поиск товаров и сопоставление с каталогом
После того как мы извлекли позиции из заявки («саморезы 3.5×41 - 1000 шт», «фанера 12 мм - 20 листов» и т.д.), нужно найти соответствующие товары в каталоге компании. Каталог - это десятки тысяч позиций с артикулами, названиями, характеристиками и фасовками.
Сложность задачи в том, что запросы приходят в любом виде, и под каждый нужно подобрать нужный товар из каталога.
Точный запрос: «Краска интерьерная моющаяся белоснежная 13кг MASTER» - нужно найти максимально точное соответствие по характеристикам.
Неточный запрос: «Шпатель 100мм 10 штук» - подбираем приблизительно похожий товар.
Жаргон: «клопы без бура» - нужно понять, что имеется в виду саморез.
Как работает поиск по каталогу
Сначала мы попробовали классический вариант с BM25 и ванильными моделями эмбеддингов, но столкнулись с тем, что модели, которые отлично понимают смысл фраз, путают «кабель 2×1,5» и «кабель 2×2,5». Для них это почти одно и то же, а для клиента два разных товара с разной ценой и назначением.
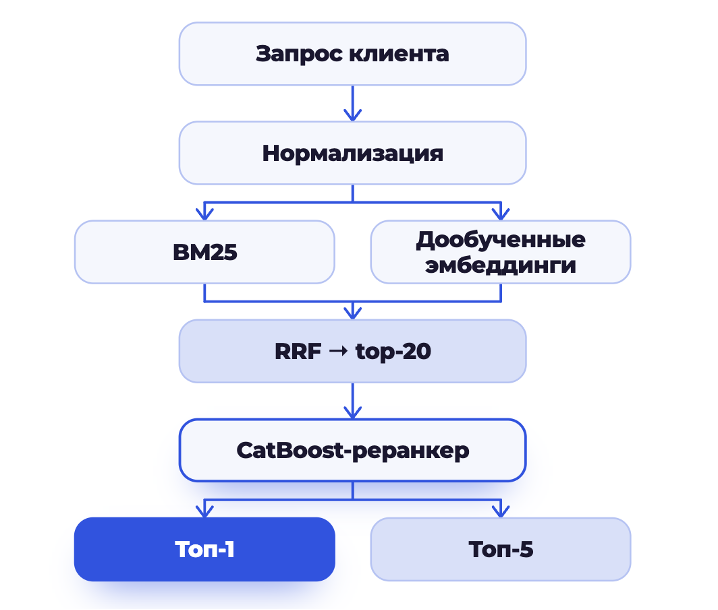
Мы остановились на таком варианте поиска по каталогу. В итоге нужный товар оказывается на первом месте в 85% запросов, а как мы к этому пришли, читайте во второй части: дообучение модели эмбеддингов и CatBoost-реранкер под строительный домен.
Расчет фасовки и единицы измерения
После того как система извлекла позицию из заявки и нашла подходящие товары в каталоге, остаётся последний шаг — превратить желаемое клиентом количество в реальные упаковки, банки, метры, которые есть в продаже.
Здесь нужно учитывать, что:
Нельзя продать 7,3 листа фанеры или 0,8 мешка цемента.
Клиент обычно хочет минимум перерасхода, но без дробных упаковок.
Для расходных материалов, как краска, нужно учитывать норму расхода по площади.
Для метизов, обоев, плитки - фасовка строго по коробкам/рулонам/пачкам.
Мы отказались от идеи полностью отдавать этот шаг LLM (хотя технически можно).
Почему?
LLM - отличный парсер и генератор идей, но ненадежный калькулятор, поэтому фасовочная логика - это детерминированные правила + простые алгоритмы. LLM подключается, только если в нашей базе данных не хватает информации о размерах товара, чтобы извлечь нужные размеры из описания.
Как это работает на примере с краской
Запрос: 1 ведро (14 л) белой краски.
Клиент просит «ведро», но в наличии только банки по 9 л и 2,7 л. Подходящей фасовки на 14 л нет, поэтому код подбирает комбинацию из того, что есть: 1 банка на 9 л и 2 банки по 2,7 л. Получается 14,4 л, чуть больше запрошенного: мы округляем вверх, потому что небольшой запас лучше, чем нехватка краски на объекте.
Результат: 1 банка на 9 л и 2 банки по 2,7 л
Вывод
Преимущества нашего решения:
Детерминизм - результат всегда воспроизводим, легко логировать и отлаживать.
Скорость - расчёт за миллисекунды.
Точность - низкий риск галлюцинаций модели.
Этот блок - преимущественно чистая математика и правила, получаем ощутимую экономию, когда в день сотни заявок.
Как выглядит итоговая система
Все, основная работа проделана, формируем коммерческое предложение и отправляем клиенту. Давайте посмотрим на нашем демо-стенде как выглядит процесс от входящей заявки до формирования КП.
Покажем работу системы на текстовом запросе из сообщения.
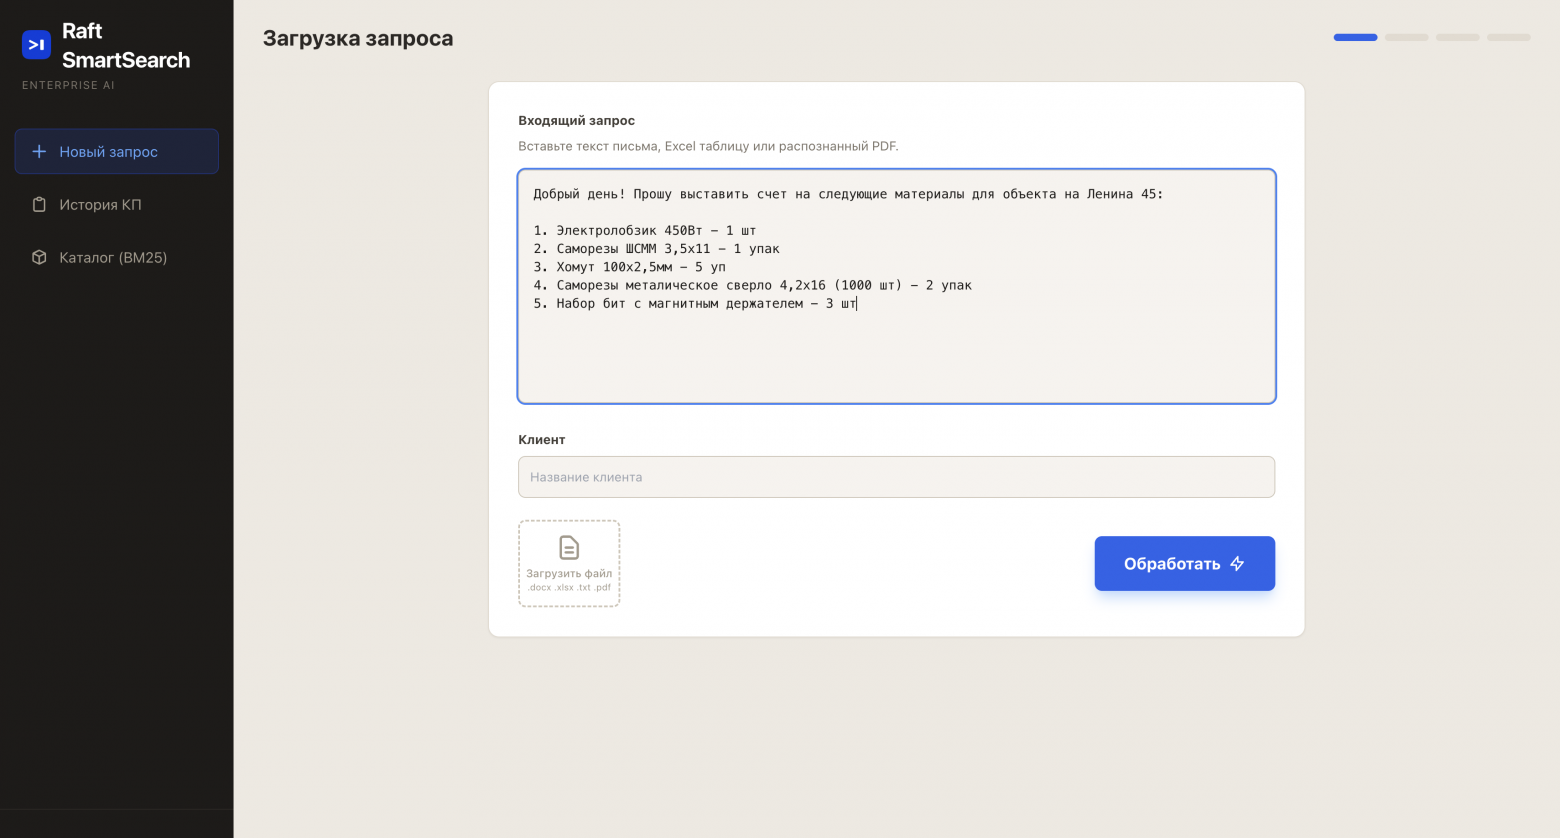
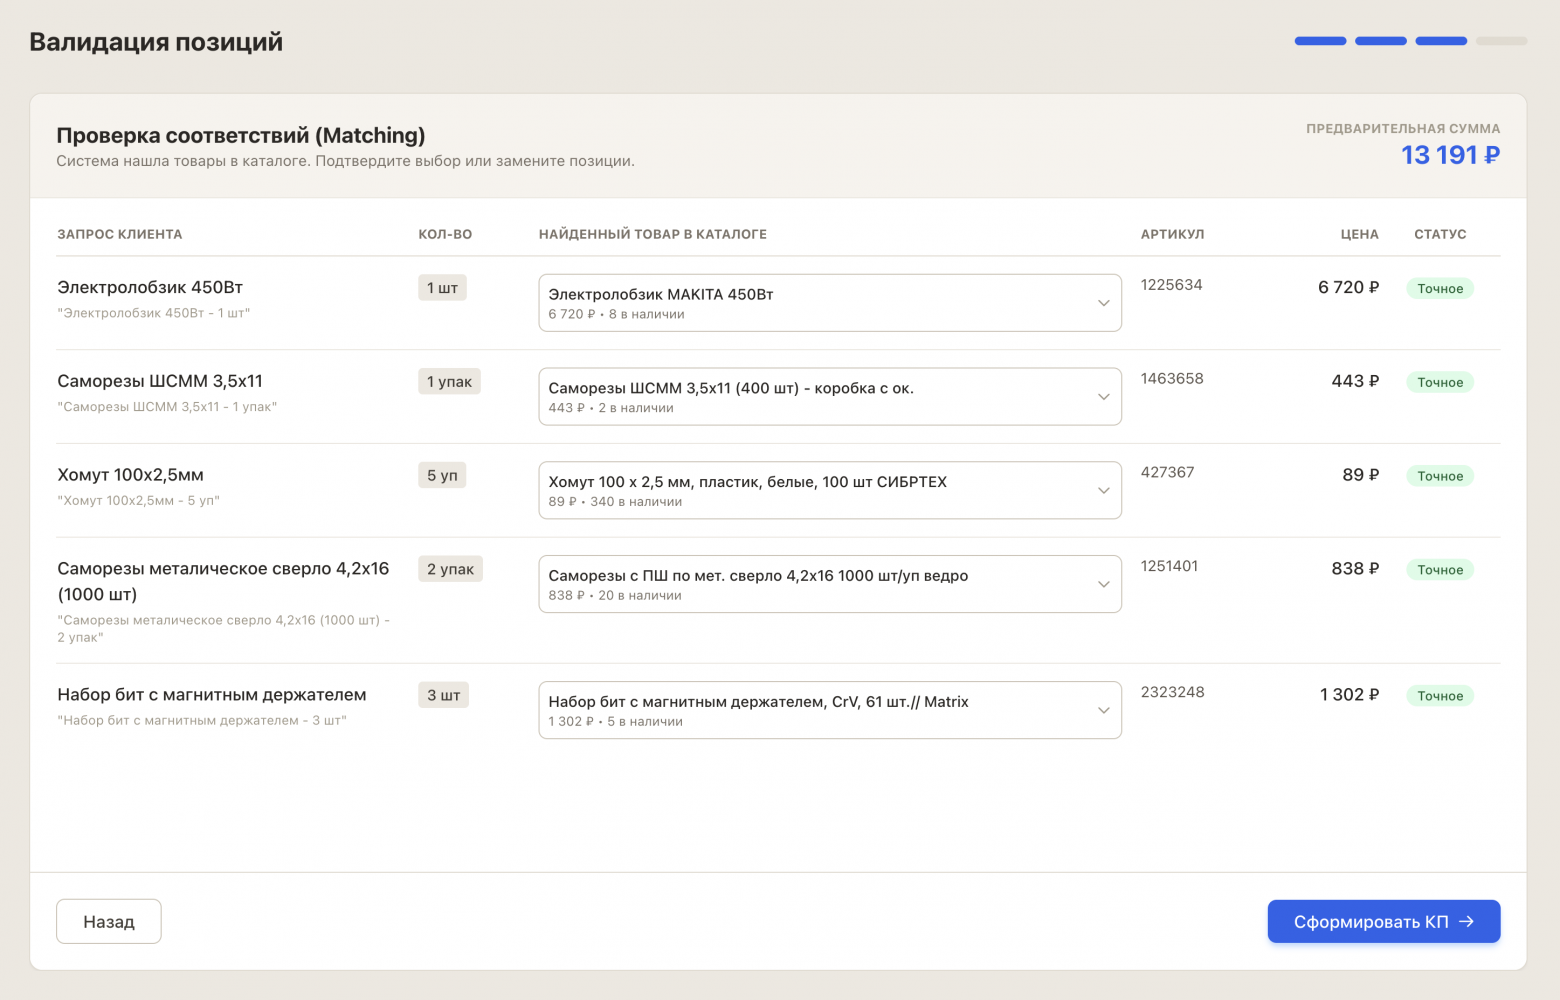
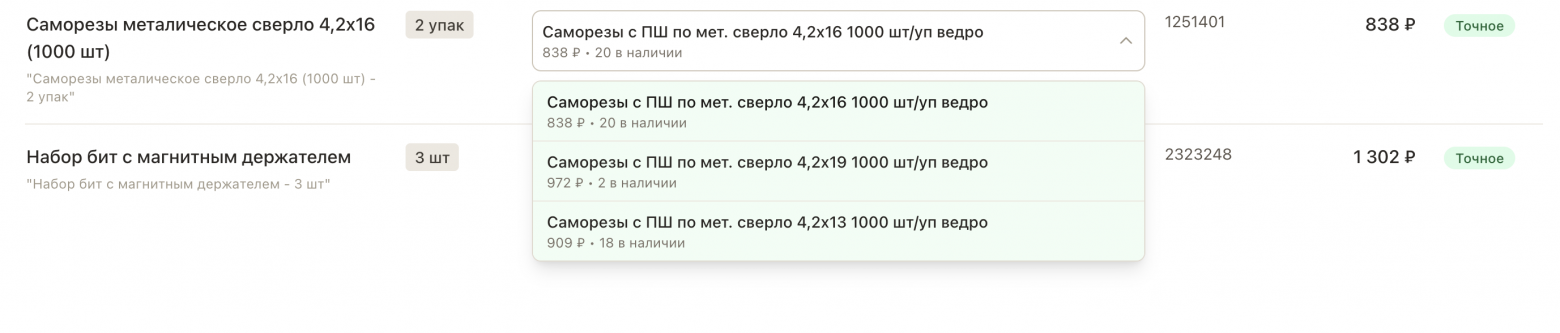
Для каждого товара менеджер может выбрать альтернативный из списка. Также выводится это точное или приблизительное совпадение, или товар не найден.
После того, как менеджер провел проверку подобранных товаров, то можно нажимать кнопку «сформировать кп» и получать итоговое коммерческое предложение, которое можно скачать и отправить клиенту.
Заключение
Мы построили end-to-end ИИ-систему, которая получает обращения клиентов и выдает готовое коммерческое предложение с подобранными товарами и их альтернативами. Классификатор находит заявки с качеством выше 90%, парсинг достаёт позиции в 90–95% случаев, а нужный товар из каталога оказывается на первом месте в 85% запросах
Главное, что мы снизили потенциальные расходы на облачные вычисления, оставив LLM только там, где без нее не обойтись - при парсинге неструктурированных заявок.
ИИ - инструмент, а не самоцель. Применяйте его вдумчиво, там, где это принесет ценность.
Во второй части подробнее обсудим поиск по каталогу и дообучение моделей под строительный домен.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.