Найти похожие заметки в Obsidian оказалось проще, чем безопасно их изменить
В тестовом хранилище Obsidian лежат две заметки с одним названием — Cache lifetime. Одна находится в Study/Caching, другая в Study/Systems. Плагин замечает сходство, но что делать с этой парой? Одинаковый термин ещё не означает одинаковое содержание: в одном файле может быть определение, в другом — пример или важное ограничение.
К этой задаче я пришёл после небольшого эксперимента, о котором писал 14 октября. Тогда я взял 40 синтетических заметок и разобрал десять найденных пар. Девять совпадений показались мне полезными, но только в четырёх случаях я уверенно создал бы ссылку. Выяснилось, что найти похожие заметки и решить, что с ними делать, — разные задачи. Этот вывод я сделал руками, ещё до появления в плагине рекомендаций: сам разбирал найденные пары и решал, что делать с каждой. Рекомендации в плагине выросли из этого ручного разбора.
Захотелось, чтобы после поиска приложение помогало выбирать действие: оставить заметки отдельно, связать их или аккуратно перенести часть информации. Для анализа пары я подключил языковую модель. Но почти сразу возник следующий вопрос: что, если рекомендация неверна, а приложение уже успело изменить Markdown?
В последних версиях Veynrel я занялся именно переходом от совета модели к записи на диск. Поиск, рекомендация и право изменить файл стали отдельными этапами. Покажу, как это работает, на одной паре заметок: от проверки цитат до точного diff и Undo.
Шесть скриншотов основного разбора сняты в настоящем Obsidian 1.13.7 на синтетических файлах с контролируемым локальным ответом. Они показывают работу интерфейса и защит, а не качество реальной LLM. Ниже отдельно описана новая серия из десяти настоящих модельных запросов; её единственный новый кадр подписан отдельно.
Две заметки с одним именем
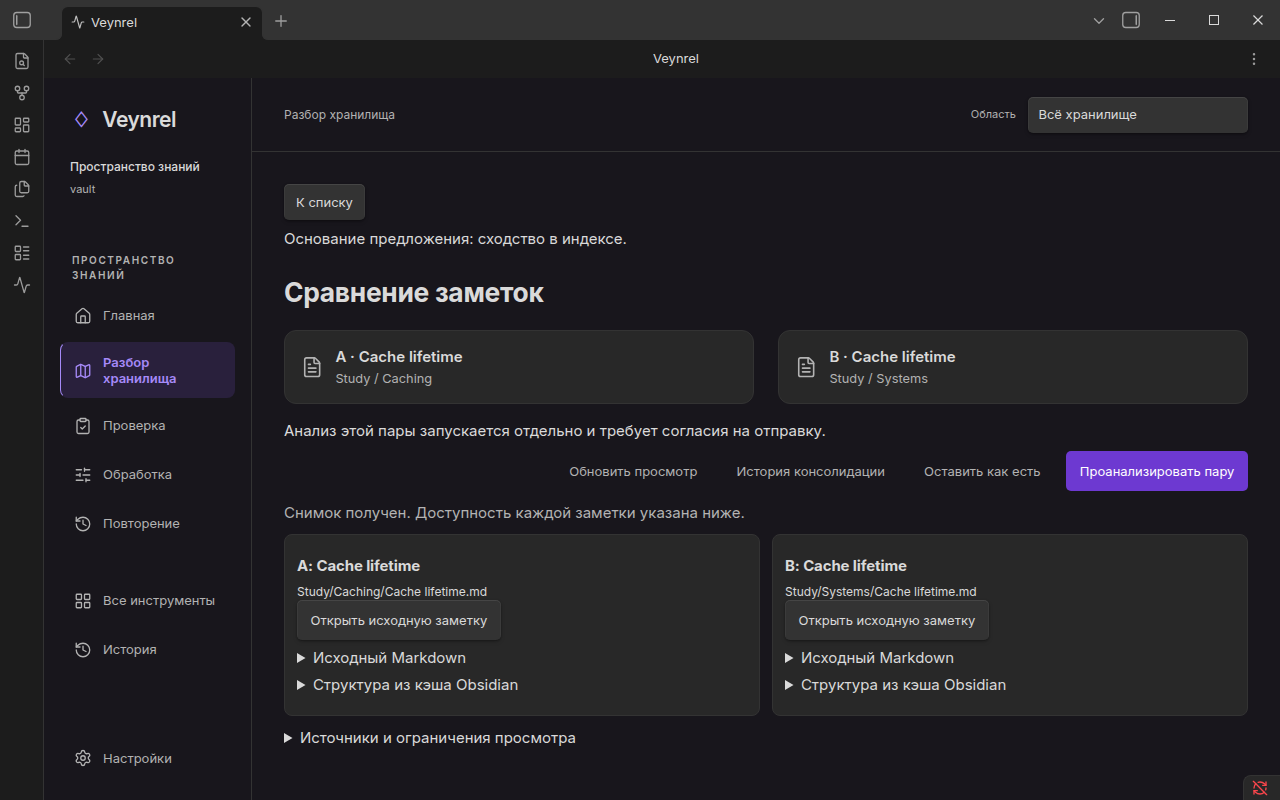
Два файла с одинаковым именем, но разными путями. До отдельного согласия на анализ модель ещё не получала их содержимое.
Семантический поиск устроен примерно так: текст делится на осмысленные фрагменты, для них получаются числовые векторы, а затем система сравнивает близость представлений заметок. Это помогает находить материалы, где мысль сформулирована разными словами.
Близость векторов не говорит, нужно ли объединять документы. Даже сходство 0.95 означает не «95% уверенности в дубликате», а лишь близость в выбранном векторном пространстве. Поэтому результат поиска я называю кандидатом. Он даёт повод открыть пару, но не команду на удаление, перенос или запись.
Дальше пользователь может изучить два сохранённых Markdown-файла и отдельно запустить анализ модели. Для удалённого провайдера это означает отправку текста наружу; поэтому плагин сначала показывает подготовленный запрос и требует согласия. Локальный Ollama возможен, но это тоже настраиваемый endpoint, а не повод скрывать факт передачи данных.
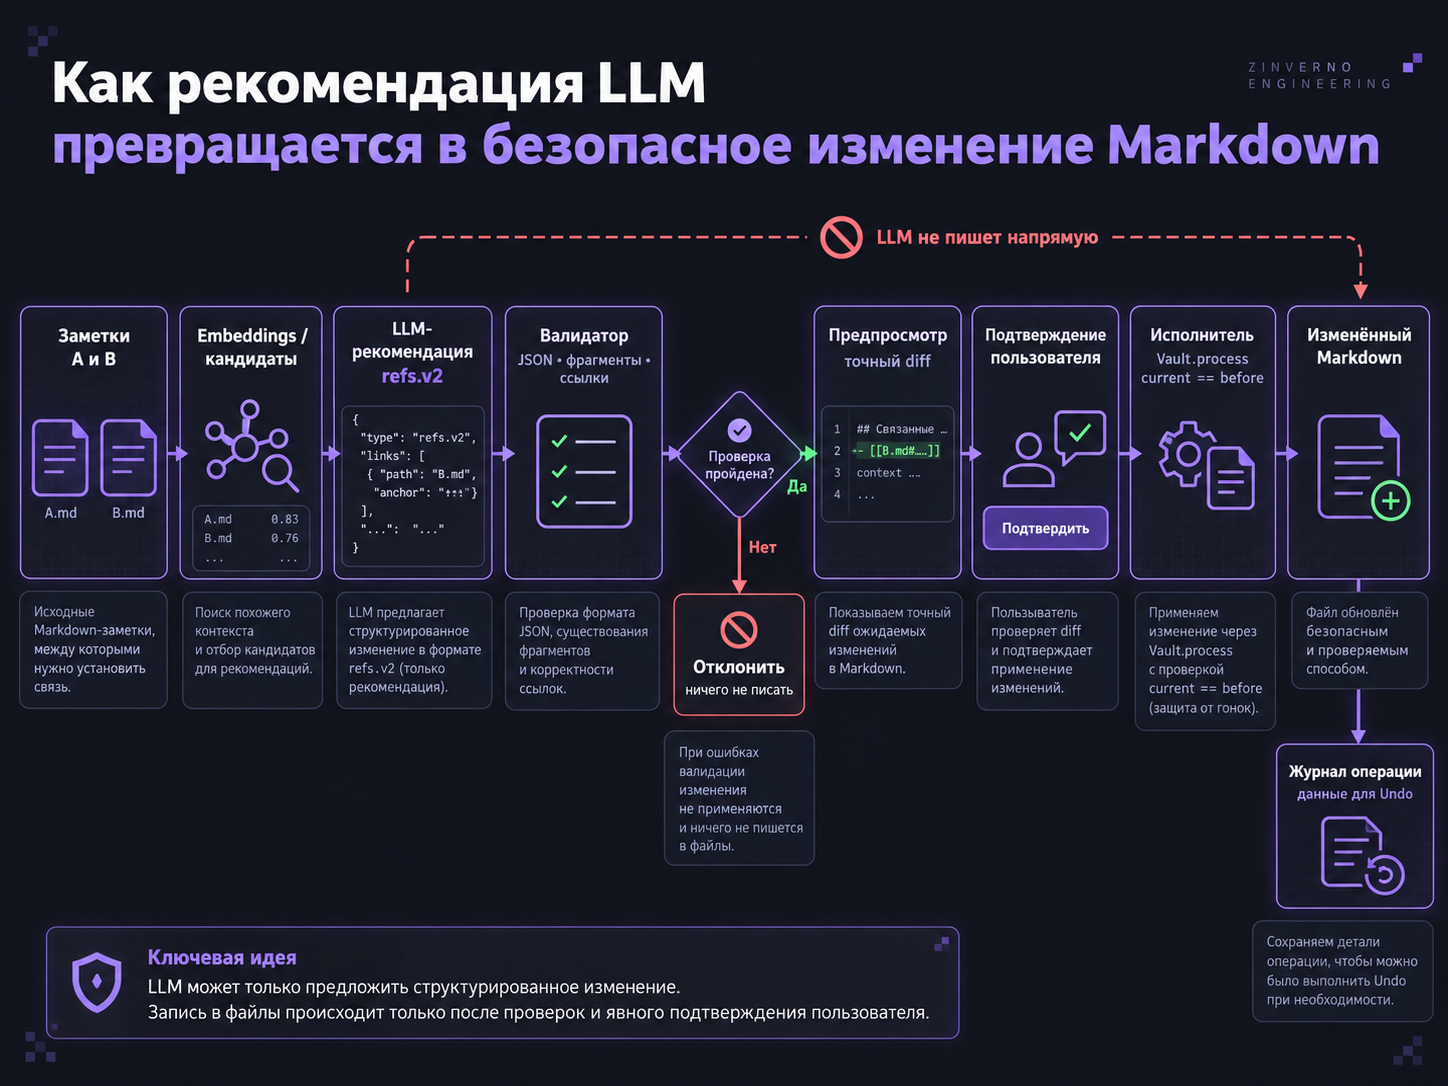
Первое искушение: поверить красивой цитате
Можно попросить LLM вернуть объект с рекомендацией и несколькими цитатами. На бумаге всё выглядит надёжно: текст подкреплён «доказательствами». Проблема в том, что сама же модель эти доказательства и формулирует. Ей ничто не мешает немного перефразировать исходник, перепутать две заметки или привести фразу, которой там вообще нет.
В Veynrel я разделил эти две роли.
До вызова модели локальный код читает сохранённые файлы и готовит каталог фрагментов. Для каждого есть исходная сторона (A или B), точный срез текста и идентификатор вида nonce:A:0. Каталог строится заранее, до согласия пользователя. В запрос уходят и эти фрагменты, и полные тексты обеих заметок; ограничение каталога не означает незаметного обрезания документа.
После ответа код не принимает произвольную цитату от модели. Он просит указать ID из каталога, находит исходный фрагмент и подставляет его сам.
Ниже сокращённый пример формы настоящего контракта refs.v2. Идентификаторы здесь условные: при реальном запросе у них случайный префикс, и они должны в точности совпадать с переданным каталогом.
{
  "schema": "veynrel.relationship.refs.v2",
  "relation": "partial_overlap",
  "claims": [{
    "id": "c1",
    "kind": "shared",
    "text": "В заметках пересекается тема срока жизни кэша",
    "evidenceA": "nonce:A:0",
    "evidenceB": "nonce:B:0"
  }],
  "explanation": {
    "text": "Есть общая тема, но контексты различаются",
    "evidence": ["c1"]
  },
  "recommendation": {
    "action": "add_link",
    "reason": "Сохранить обе заметки и связать их",
    "evidence": ["c1"]
  },
  "limitations": ["Проверены только эти два файла"]
}
evidenceA и evidenceB ссылаются на фрагменты входного каталога, а explanation.evidence и recommendation.evidence — на утверждения из claims, например c1. Если смешать эти два пространства ID, даже внешне правильный JSON должен быть отклонён.
Проверка ссылки на исходный текст в действующем TypeScript выглядит так (вырезан один небольшой участок функции):
const entry = typeof id === "string"
  ? catalog.fragments.find(f => f.id === id)
  : undefined;

if (!entry) {
  diagnostics.push({ field, side, code: "reference_unknown" });
  return null;
}
if (entry.side !== side) {
  diagnostics.push({ field, side, code: "reference_side_mismatch" });
  return null;
}
return entry.text;
Если ID выдуман или принадлежит другой заметке, проверка не исправляет ссылку «по смыслу». Она возвращает ошибку, и результат не попадает в следующий этап. Так же отклоняются неправильная схема, некорректные поля и устаревший исходный снимок.
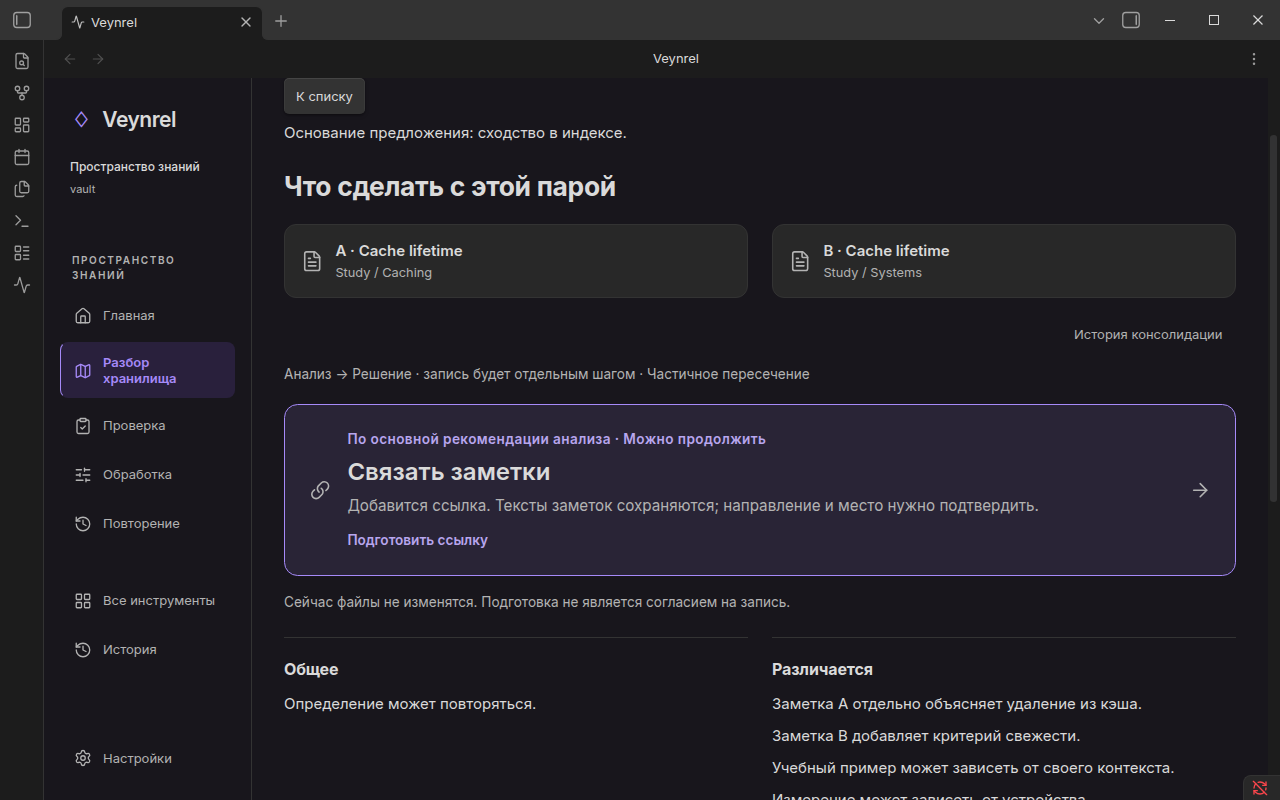
На тестовой паре модель предложила связь, а не слияние. Предложение пока не создаёт ни одной ссылки.
Проверка доказывает только, что цитата есть в нужной заметке. Разумен ли тезис, решает человек.
Совет «добавить ссылку» ещё не является правкой
Допустим, я согласен: эти документы стоит связать. Просто вставить [[Cache lifetime]] нельзя: файлов с таким именем два. Если записать неоднозначную ссылку, легко получить переход не туда. Ещё надо решить, какая заметка ссылается на какую, в какой абзац ставить ссылку и можно ли вообще его изменять. В Markdown бывают списки, кодовые блоки, таблицы, frontmatter и встроенные ссылки. Разрешить модели самой выбрать «удобное место» здесь было бы слишком смело.
Для этого рекомендация проходит через отдельный планировщик. Он не выполняет команду из JSON. Вместо этого переводит разрешённый тип рекомендации в параметры операции: направление, место, подтверждение. На неподдерживаемой структуре или при отсутствии нужных данных он может отказать.
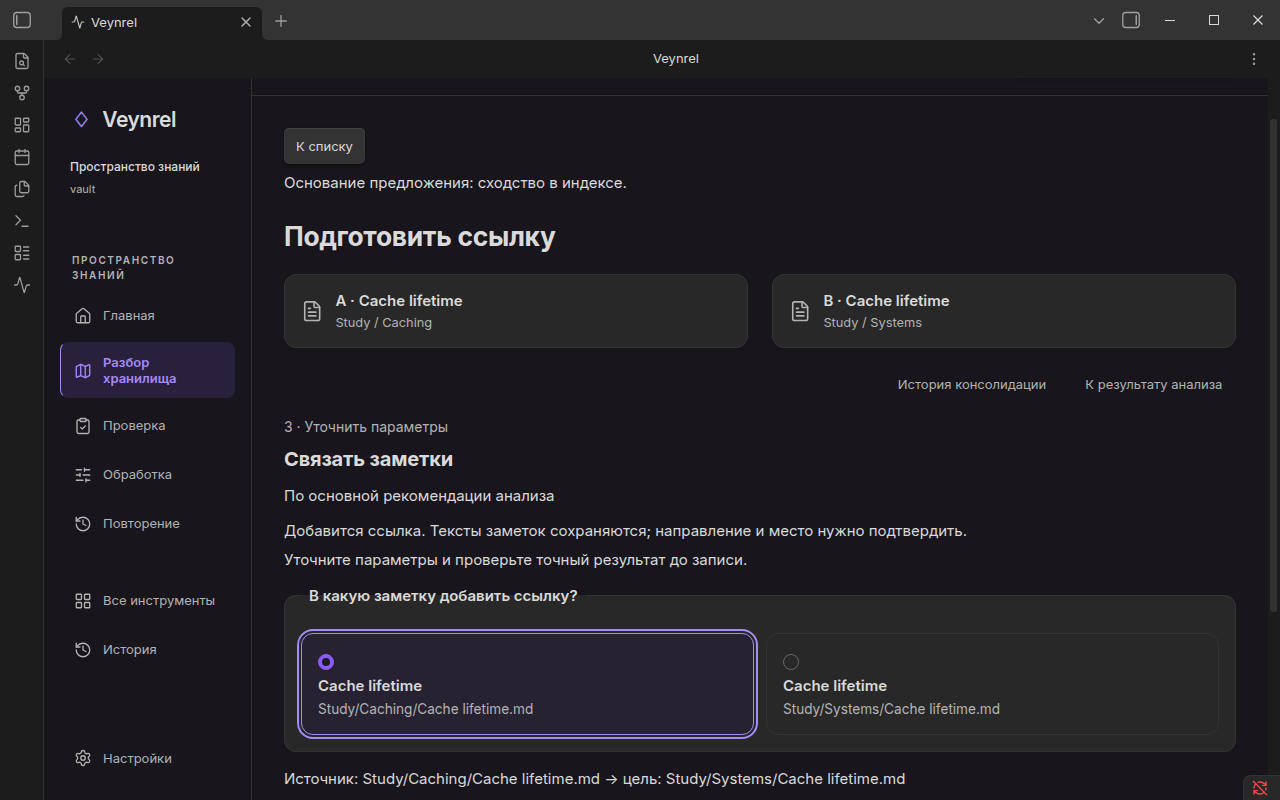
В этом примере изменяется Study/Caching/Cache lifetime.md, а цель — Study/Systems/Cache lifetime.md.
Для выбранного направления ссылка должна разрешаться именно в нужный объект файла Obsidian. В адаптере перед записью есть прямая проверка:
requireSafe(
  app.metadataCache.getFirstLinkpathDest(
    plan.targetPath.slice(0, -3), plan.sourcePath
  ) === plan.target.file,
  "stale"
);
Это отдельная защита от ошибки с одинаковыми названиями. Проверяется, куда Obsidian разрешит ссылку на самом деле. Если состояние ссылок или файлов изменилось, прежний план не считается пригодным.
И даже после этого запись не выполняется. План содержит ожидаемый Markdown до и после операции. Пользователь видит конкретный diff и отдельно подтверждает именно его.
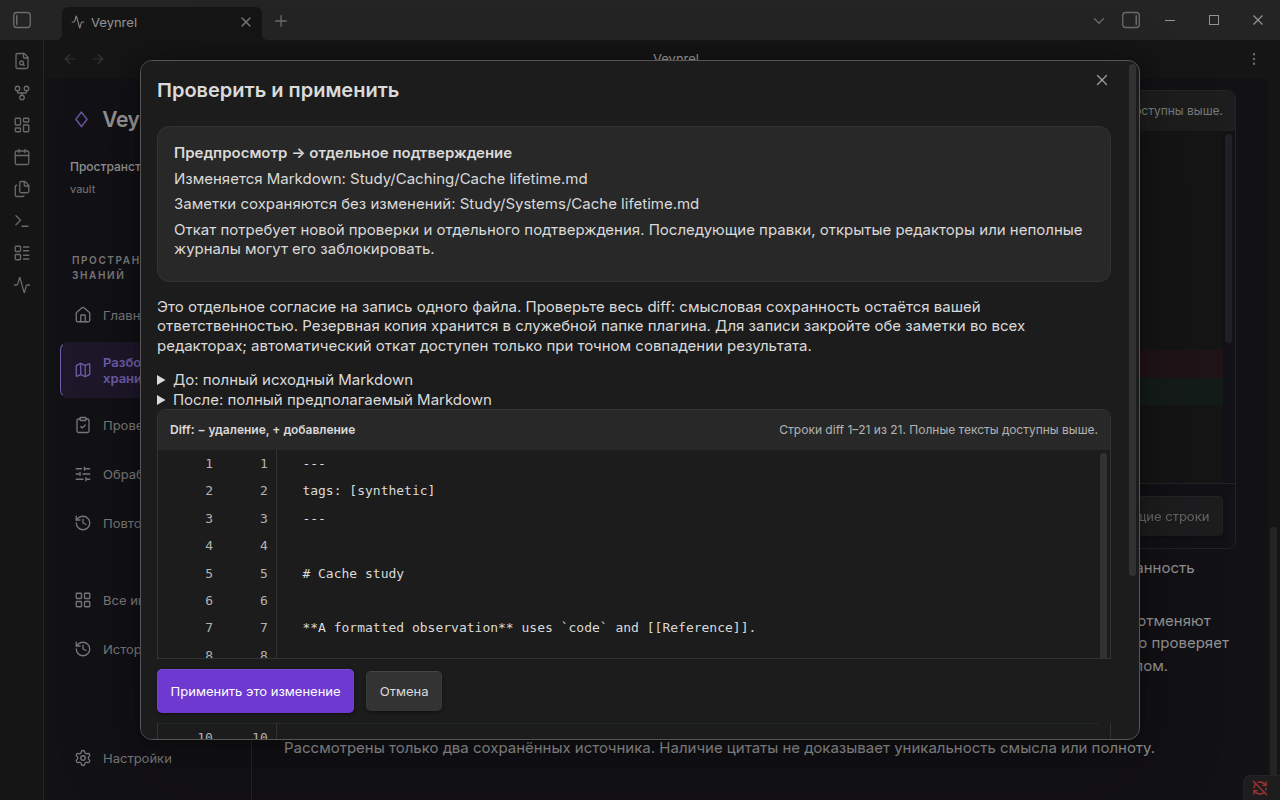
В этом окне показаны оба полных текста и diff; на снимке видна его верхняя часть. Применение потребует отдельного нажатия.
План не вырезает фрагмент по приблизительной цитате модели. Для обычной ссылки он строится из выбранного диапазона сохранённого документа. Если разметка неоднозначна, операция блокируется.
Между предпросмотром и сохранением проходит время
Предположим, я открыл diff, отвлёкся, дописал абзац в той же заметке и вернулся к кнопке «Применить». Даже если предложенная ссылка по-прежнему уместна, план уже рассчитан по старой версии файла.
Простейшая и опасная реализация выглядела бы так: взять подготовленное after и перезаписать документ. Моя ручная правка исчезла бы.
В Veynrel исполнитель проверяет план заново перед записью. Он перечитывает заметки и метаданные, проверяет целевой файл, блокирует запись при открытых затронутых редакторах (даже если их буфер пока совпадает: сохранение может стоять в очереди). После подготовки и сохранения журнала всё это перепроверяется ещё раз.
На практике перед Apply нужно закрыть вкладки с затронутыми заметками и повторить подтверждение. Это не самый удобный вариант, но у плагина нет надёжного способа остановить сохранение, уже ожидающее в редакторе; я предпочёл явный отказ риску затереть чужую правку.
Последняя граница стоит непосредственно в Vault.process() — API Obsidian для изменения файла относительно его текущего содержимого:
await app.vault.process(note.file, current => {
  check();
  guard(note);
  requireSafe(current === before, "conflict");
  return after;
});
Это фрагмент реального адаптера, без переименования функций. Условие current === before — главный инвариант: записывать рассчитанное after разрешено, только если прямо сейчас в файле находится ровно тот текст, на основе которого строили изменение. Никакой «почти такой же Markdown» и нормализации пробелов в этой проверке нет.
Кстати, нормализация переводов строк и BOM действительно используется в другом месте Veynrel: при поиске точных дубликатов. Но искать одинаковое содержимое и защищать запись от потерянного изменения — две разные задачи. Там нормализация уместна, здесь опасна.
Для одной заметки такой подход относительно понятен. Для нескольких файлов уже нельзя честно обещать одну общую атомарную операцию: первый файл может успеть сохраниться, пока запись второго завершится ошибкой. В проекте это отдельные исполнители и состояния восстановления.
Почему обычный Ctrl+Z здесь не подходит
Если бы задача заканчивалась записью, можно было бы хранить старый текст и по запросу возвращать его обратно. Однако после добавления ссылки человек может продолжить редактирование.
Представим такой порядок:
Плагин записал новое содержимое
after.Я вручную добавил ещё один абзац.
Через минуту нажал Undo для операции плагина.
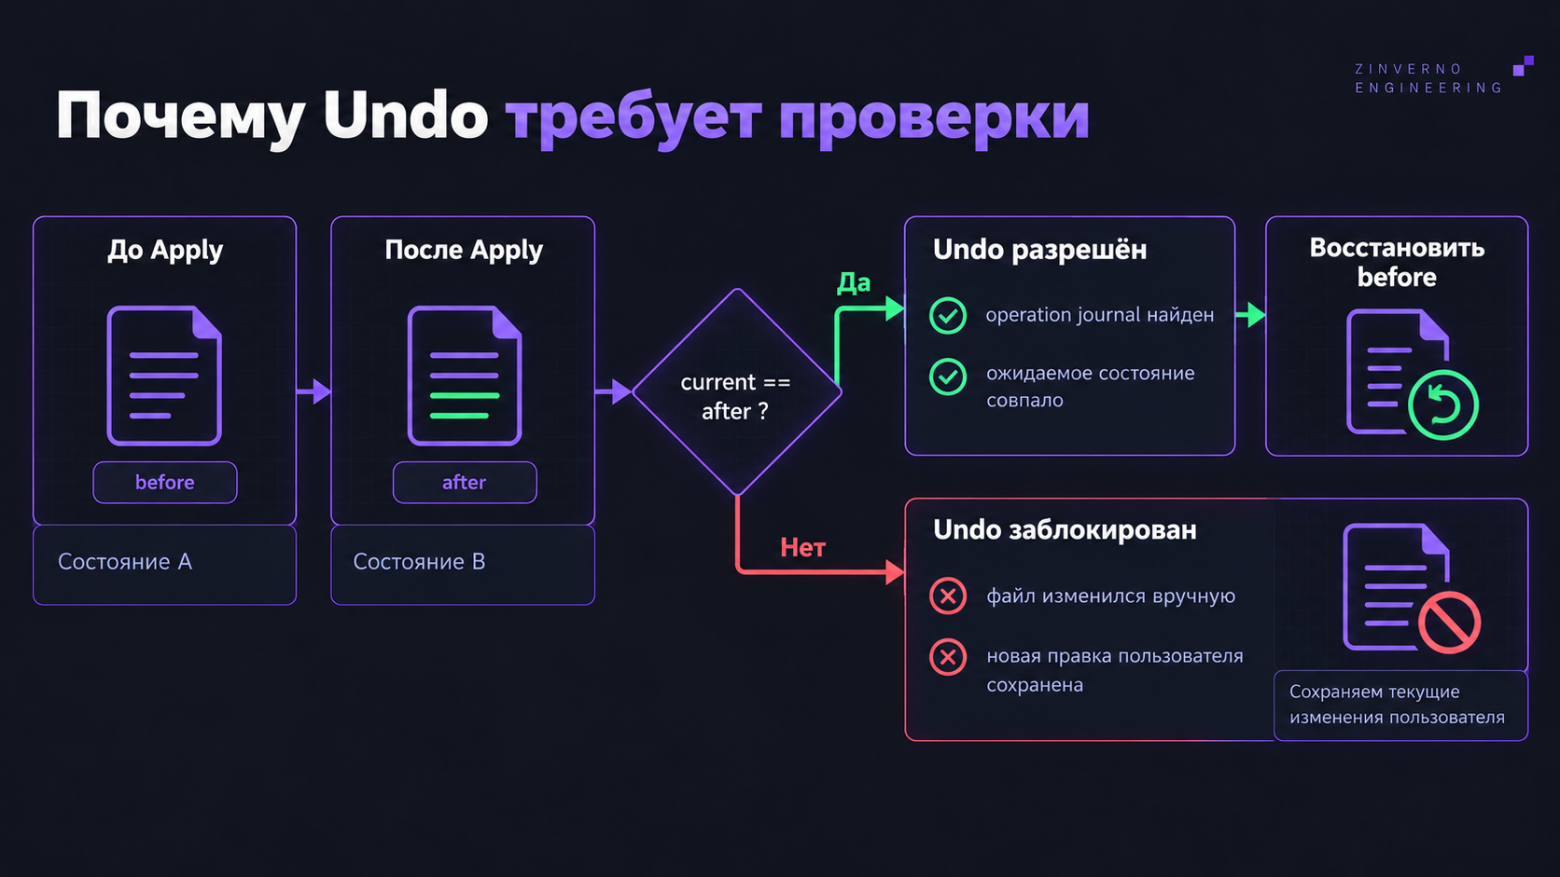
Безусловное восстановление before сотрёт и ссылку, и мой новый абзац. Поэтому отмена тоже должна проверять текущее состояние, а не просто исполнять обратную команду.
Для поддерживаемых операций Veynrel хранит устойчивый журнал с исходным и ожидаемым содержимым, контрольными суммами и копиями для восстановления. Журнал готовится до записи. После неё файл перечитывается, и лишь затем отмечается успех.
При Undo код заново убеждается, что содержимое всё ещё в точности равно записанному after, идентичность файла не изменилась, нет конфликтующих журналов и открытых затронутых редакторов. Только тогда допускается переход after → before. Если я успел дописать абзац, автоматическая отмена запрещается, а моя правка сохраняется.
Что, если приложение завершилось в неудобный момент? Например, Vault.process уже сохранил файл, а отметка applied в журнале не успела записаться. После перезапуска нельзя слепо повторять операцию. Система сопоставляет устойчивую запись с фактическим текстом и показывает восстановленное состояние. При этом она не делает произвольную восстановительную запись при запуске. Мне нужно было, чтобы после сбоя плагин мог сказать, что именно успело записаться.
Что проверялось на самом деле
Чтобы не оставлять весь рассказ на уровне «должно быть безопасно», вот несколько конкретных проверок из тестов stable Veynrel 2.2.1. Я прошёл эти сценарии сам и согласен с тем, как плагин ведёт себя в каждом из них.
Сценарий | Проверенный результат |
|---|---|
Модель вернула неизвестный или принадлежащий другой заметке ID | Ответ отклоняется; цитата не подменяется догадкой |
Пока модель отвечала, изменился исходный файл | Анализ устаревает и не публикуется как текущая рекомендация |
План строился для двух одноимённых файлов | Проверяется путь и точный целевой файл, не только имя |
После подготовки журнала, но до записи изменился Markdown | Применение прекращается; новая пользовательская правка остаётся |
После Apply человек добавил текст, затем запросил Undo | В истории |
Запись Markdown прошла, но отметка об успехе в журнале не сохранилась | После перезапуска состояние определяется как применённое; возможно отдельное проверяемое Undo |
Это результаты автоматических тестов с управляемыми сбоями, не статистика об ошибках реальных пользователей. Отдельный native-прогон в Obsidian подтверждал обычную цепочку Apply → History → Undo и восстановление исходных хешей Markdown. Он не равнозначен тесту всех вариантов прерывания на физических устройствах.
Проверки можно найти в файлах relationshipEvidence.test.ts, relationshipSession.test.ts, changePlan.test.ts и safeApply.test.ts. Сам механизм записи находится в obsidianSafeApply.ts.
Прогон на настоящей модели
Контролируемый ответ удобен, когда проверяешь запись и отмену. Но оставался вопрос: сможет ли настоящая модель пройти тот же путь без помощи сценария? 24 октября я провёл отдельную серию в Obsidian 1.13.7 с неизменённым Veynrel 2.2.1: десять последовательных запросов к DeepSeek через OpenRouter, точный ID — deepseek/deepseek-v4-flash-0731. Оставил production prompt, temperature=0, предел ответа 8192 токена и отключённое reasoning. Повторов и исправления JSON не было; backend-провайдер внутри OpenRouter мог различаться.
До первого запроса сохранил тексты, пути, порядок и SHA-256 десяти синтетических пар: от почти одинаковых заметок до противоречий и недостаточного контекста. Включил и обе Cache lifetime. Кандидатный список сформировали фиксированные искусственные векторы, поэтому этот опыт проверяет языковую модель и её интеграцию, а не embeddings. Полный отчёт по десяти парам содержит входные заметки, ответы модели, результаты проверок, время и стоимость каждого запроса.
Все десять ответов оказались читаемым JSON, прошли refs.v2, проверку ссылок на фрагменты и строгий валидатор. Пять раз модель предложила добавить ссылку, один раз рассмотреть объединение (consider_merge), ещё четыре раза ручной разбор. Для шести рекомендаций предварительная проверка (preflight) позволила перейти к выбору параметров операции. Это ещё не готовые правки и тем более не изменения файлов. До подтверждения, Apply и отдельного Undo я довёл только один сценарий. Медиана ответа — 4,07 секунды, диапазон — 2,44–10,00; суммарная стоимость, возвращённая API, — около $0,00227.
У Cache lifetime модель выделила общее содержание и предложила ссылку. В этом ответе один тезис упоминал и удаление просроченного значения, и пятиминутный пример, но выбранная цитата подтверждала только первое. Оба факта есть в исходной заметке, однако в привязанном фрагменте про пять минут ничего нет.
Получилось 10 из 10 технически валидных ответов, но как минимум один из них содержал тезис, подтверждённый своей цитатой лишь частично. Валидатор проверил реальность фрагмента и его принадлежность нужной заметке. Он не проверил, достаточно ли этой цитаты для всего утверждения.
Для пары LR01 модель предложила consider_merge. Но это не команда автоматически объединить два документа. После выбора параметров Veynrel построил план копирования одного выбранного абзаца из второй заметки в первую. Исходная вторая заметка оставалась без изменений. Я проверил точный план в интерфейсе, отдельно подтвердил Apply, затем выполнил Undo. Это был один полный сценарий изменения с последующим восстановлением, а не массовая проверка всех вариантов Merge.
Во время Apply изменился один Markdown-файл из двадцати в синтетическом наборе. Хеши всех двадцати сравнили, чтобы заметить случайные изменения остальных; после Undo каждый снова совпал с исходным SHA-256. Это подтверждает конкретную операцию копирования с откатом, а не универсальное слияние документов.
Полезность рекомендаций я оценил сам: прочитал все десять ответов вместе с исходными заметками. Семь считаю уместными, то есть я бы сделал то же действие, три спорные. Пара Cache lifetime среди спорных не числится: ссылка там уместна, хотя цитата к одному из тезисов неполная. Это оценка одного человека, да ещё автора плагина, поэтому она не показывает, как часто модель выбирает лучшее действие. Для этого рекомендации должны оценить другие люди.
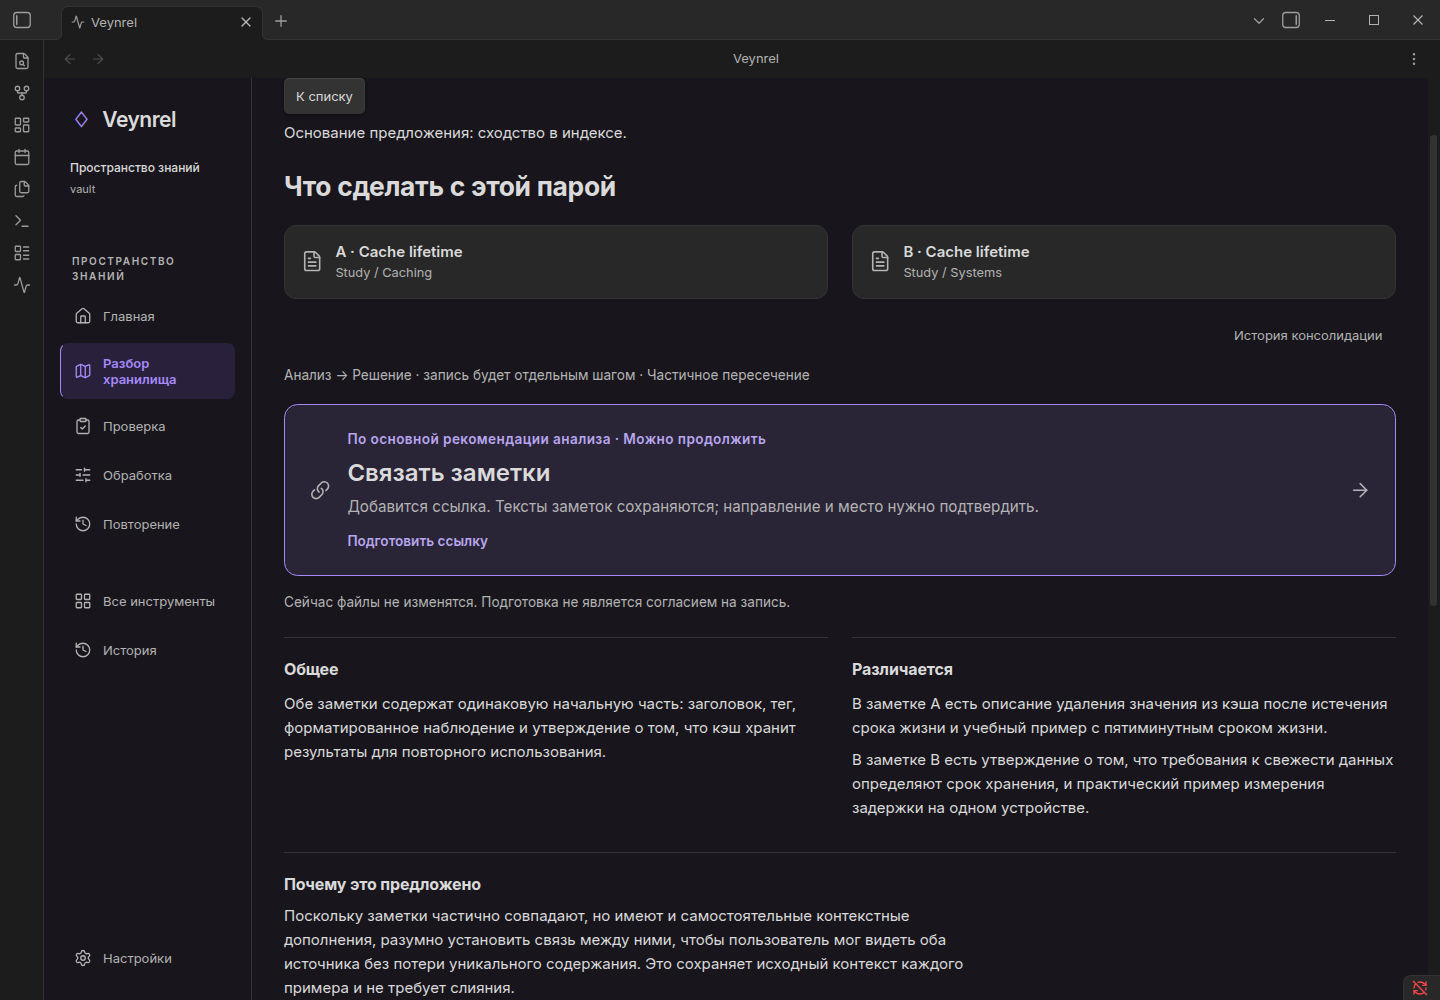
Новый real-model run, пара Cache lifetime: ответ deepseek/deepseek-v4-flash-0731 получен через OpenRouter в Obsidian 24 октября 2026 года. Validator принял ответ, preflight открыл подготовку ссылки; Apply для этой пары не выполнялся.
Где защита заканчивается
У плагина нет транзакционной файловой системы. Vault.process не имеет власти над всеми окнами, сторонними плагинами, синхронизацией и внешними приложениями одновременно. У многодокументных операций нет общей атомарности. Даже надёжный журнал позволяет обнаружить некоторые конфликты и не испортить файл при восстановлении, но не всегда может автоматически исправить любое частичное состояние.
И главное: в Veynrel есть другие генеративные инструменты, например создание новых атомарных заметок. Они имеют собственные подтверждения и умеют сообщать о частичных результатах, но не наследуют универсальный Undo из описанного здесь исполнителя. Я не переношу гарантию одной операции на все кнопки интерфейса.
Итог
Принцип получился простым: модель предлагает, код проверяет, человек выбирает, а записывает отдельный исполнитель, который может отказать. Не у каждой рекомендации должен быть изменённый файл: иногда лучший результат сравнения — оставить заметки как есть.
Открытым остаётся вопрос из прогона на настоящей модели: проверка видит, что цитата существует и взята из нужной заметки, но не видит, подтверждает ли она весь тезис. Похоже, дело не только в модели или промпте: пока один тезис может содержать несколько фактов при одной цитате, проверка этого не поймает. Нужны тесты на реальных данных, чтобы понять, насколько часто это случается.
Veynrel 2.2.1 — открытый плагин для Obsidian. Репозиторий. Шесть исходных кадров относятся к synthetic/native демонстрации с контролируемыми ответами. Новый кадр и раздел о настоящей модели относятся к отдельному real-model run из десяти запросов 24 октября 2026 года; его исходные заметки тоже синтетические. Человеческая оценка полезности этой серии проведена только мной. Технические фрагменты и проверки сверены с исходным кодом stable 2.2.1.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.