Роботы-коммунисты: что бывает, когда у тысячи ИИ-агентов нет начальника
Допустим, вы собрали тысячу программистов, дали им один репозиторий и одну задачу. Менеджера нет, тимлида нет, подзадачи никто не распределяет. О том, кто чем занят, в инструкции сказано только, что все равны и каждый решает сам. Госплана у нас нет, товарищи.
Звучит как странный эксперимент или неудачный стартап. Но исследователи из Microsoft Research проделали это на ИИ-агентах. В препринте Agensh до 1024 экземпляров одной модели шесть часов вместе воспроизводили поведение готовых программ, и никто ими не руководил. При этом рой показал результат лучше одиночки. Заодно сам завел у себя ревьюеров, интеграторов и регламенты.
Давайте разберемся, как это устроено, что измеряли и где в цифрах прячутся оговорки.
Зачем убирать оркестратор
Одиночный агент упирается в границы собственного контекста. У него одно окно, один поток действий и одна память, а работает он последовательно, поэтому на сложную задачу уходит много времени. Чтобы это время сократить, можно разделить задание между несколькими агентами.
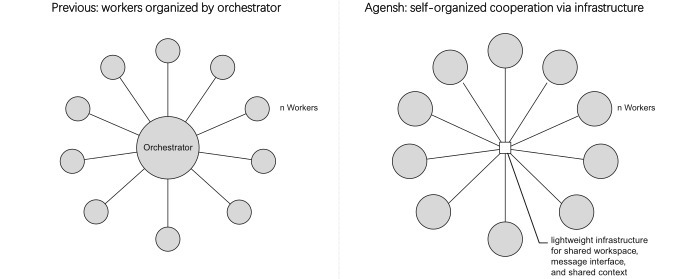
Большинство мультиагентных систем устроены иерархически: главный агент разбирает задачу и раздает куски исполнителям. Так работают подагенты в Codex и Claude Code, команды агентов в Claude Code, Copilot fleet и Kimi Agent Swarm. У схемы есть потолок: с ростом числа исполнителей главный агент все больше планирует, согласовывает, вливает чужую работу — и становится узким местом.
Это признают и разработчики таких систем. В исследовательской системе Anthropic ведущий агент запускает подагентов синхронно и ждет, пока завершится каждая группа. Это упрощает координацию, зато ведущий агент не может направлять подагентов, они не могут договариваться между собой, а вся система простаивает, пока один из них заканчивает поиск. Асинхронная работа дала бы больше параллелизма, но осложнила бы согласование результатов и состояния. Agensh идет в эту сторону и убирает центральный узел целиком.
Без назначения главного агента остаются три вопроса: кто чем занимается, как не мешать друг другу и как делиться находками. Ответить непросто.
В августе Frontier Red Team из Anthropic показала, что рои равноправных агентов пока спотыкаются. В эксперименте, где от 10 до 80 агентов по 12 часов делали игру, ранние модели плохо сливали правки, а поздние избегали конфликтов тем, что работали порознь. Промпты с ролями и назначенным «директором» мало что изменили. Поэтому выигрыш Agensh не был очевиден заранее.
У идеи есть предшественники. В феврале 2026-го Николас Карлини из Anthropic посадил 16 агентов Claude писать на Rust компилятор C: общий git-репозиторий, замки в виде текстовых файлов, ни одного оркестратора. За две недели и около 20 000 долларов на API вышел компилятор на 100 тысяч строк, который собирает Linux 6.9.
А в июне стэнфордская группа Юйчжэня Мао и Азалии Мирхосейни в работе DeLM добавила очередь задач и общий контекст из коротких записей. На SWE-bench Verified точность выросла на 10,8 пункта относительно лучшего базового варианта, и цена одного решения упала вдвое, хотя цена задачи целиком в части режимов растет. На двух задачах ProgramBench (ctags и pandoc) четыре агента DeLM за 120 минут прошли на 19–20 пунктов больше тестов, чем Claude Code. Доску Agensh берет у DeLM, мессенджер добавляет сам и доводит схему до тысячи агентов.
Как устроен рой без центра
Все агенты работают одновременно и независимо, и каждый выполняет один и тот же цикл из пяти шагов:
собрать контекст: прочитать цель, состояние репозитория, сообщения коллег и их находки;
взять задачу: объявить, чем он займется, при помощи записи CLAIM, чтобы остальные выбрали другое;
выполнить: написать код и по ходу поделиться тем, что может пригодиться другим;
проверить: сверить результат с критериями приемки и переделать, если не сходится;
влить: слить изменения в общую ветку и описать, что поменялось, зачем и чем это подтверждено.
Закончив слияние, агент возвращается к первому шагу.
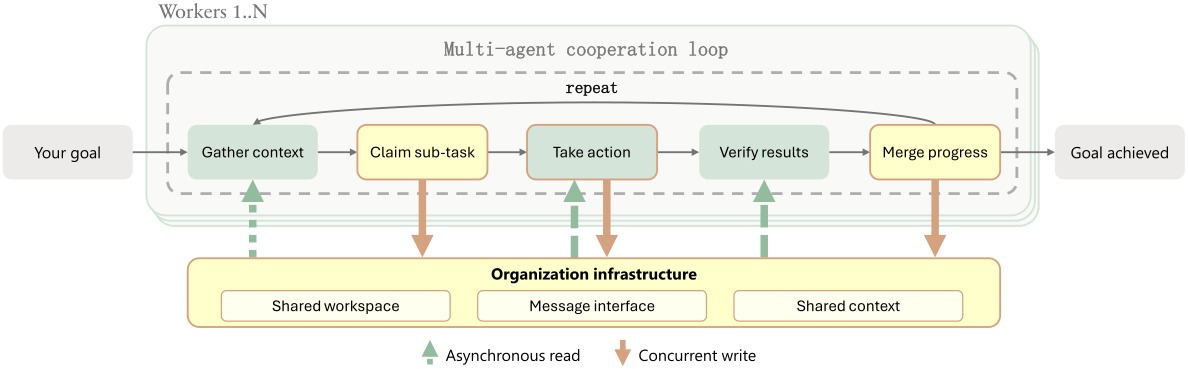
Цикл опирается на три общих сервиса:
Репозиторий, он же рабочее пространство, работает на Gitea.
В Mattermost есть общий канал с объявлениями и личные сообщения для срочных столкновений (такое сообщение доходит до адресата прямо посреди его хода).
Доска контекста, самый интересный сервис. На доске лежат короткие записи пяти типов. OBSERVED фиксирует замеченное поведение, FACT — подтвержденный факт, FAIL — опровергнутую гипотезу. Заявку на задачу оформляют записью CLAIM, а готовое изменение описывают в PATCH_SUMMARY. Лимит записи — 100 символов (у PATCH_SUMMARY 300), подробности уходят в отдельное поле. Промпт называет FAIL самой ценной записью, потому что она избавляет остальных от траты бюджета на тупик.
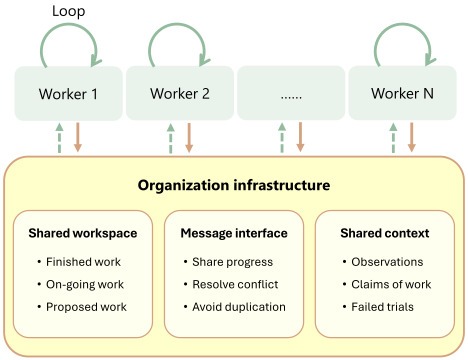
Промпт у всех агентов одинаковый, отличается только номер агента. Цикл записан в промпте словами, в код рантайма его не зашивали. Под ним лежит обычный одиночный агент.
Как измеряли результат
ProgramBench вышел в мае 2026-го, и среди его авторов создатели SWE-agent. Исходная мысль такая: привычные бенчмарки проверяют узкие задачи вроде исправления ошибки или добавления функции, а агентов уже запускают растить целые проекты, где архитектуру надо продумывать самому. Поэтому в ProgramBench 200 задач: от небольших консольных утилит до FFmpeg, SQLite и интерпретатора PHP.
Для Agensh это подходящий полигон: проекты большие, работа долгая, а одиночные агенты на самых сложных задачах набирают мало.
Агенту дают готовый исполняемый файл и документацию к нему. Его можно запускать и наблюдать, но нельзя читать и дизассемблировать, а интернета нет. За шесть часов нужно написать с нуля код с тем же поведением — только поведение проверят скрытые тесты.
Из 200 задач бенчмарка выбрали пять самых сложных по среднему результату передовых моделей. Это обработка видео и звука, молекулярное моделирование, конвертер документов, интерпретатор языка и индексатор кода.
Все запуски шли на одной модели, GPT-5.6-sol с высоким уровнем рассуждений, в связке с Copilot. На каждый запуск давалось шесть часов. Группу из 1024 агентов разнесли на 16 серверов по 64 штуки. Агенты включали постепенно: по одному раз в 30 секунд в первый час и раз в три секунды дальше.
Что дает рост числа агентов
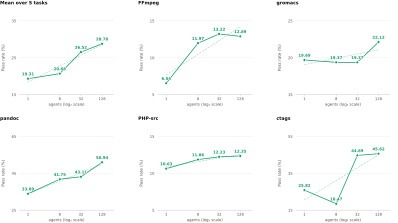
Средняя доля пройденных тестов по пяти задачам составила 19,31% у одного агента, 20,68% у восьми, 26,52% у 32 и 28,78% у 128. Это на 9,47 процентного пункта выше результата одиночки, или около 49% в относительном выражении. Кривая идет рывком: от одного агента до восьми прирост 1,37 пункта, от восьми до 32 (рост вчетверо) уже 5,84, а от 32 до 128 (тоже вчетверо) снова меньше, 2,26.
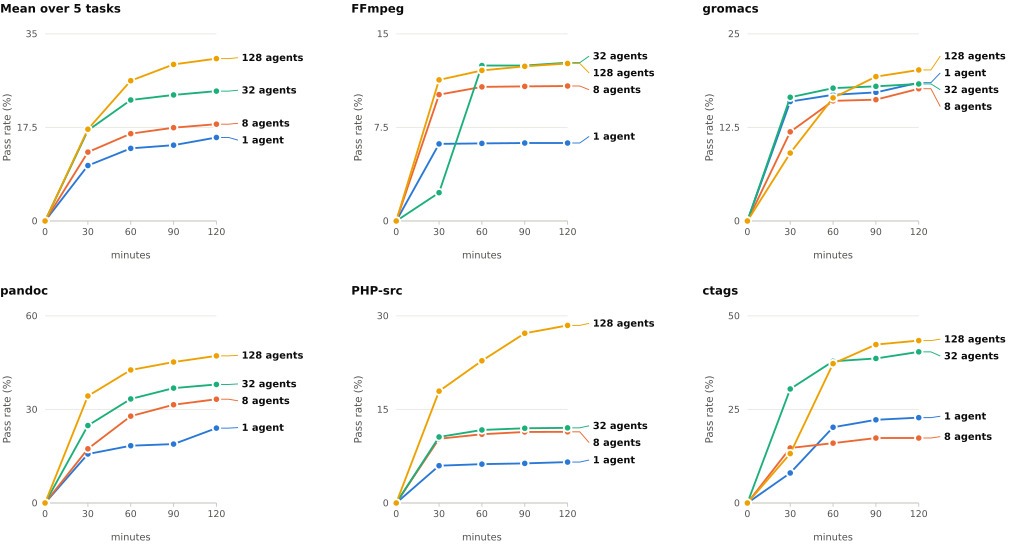
На pandoc рой оказался и быстрее: 128 агентов превысили порог в 30% пройденных тестов на тридцатой минуте, 32 агента дошли до него к первому часу, восемь — к полутора часам. Одиночка за первые два часа порог не взял. К этому моменту по расписанию запуска (раз в 30 секунд) работала лишь половина из 128 агентов.
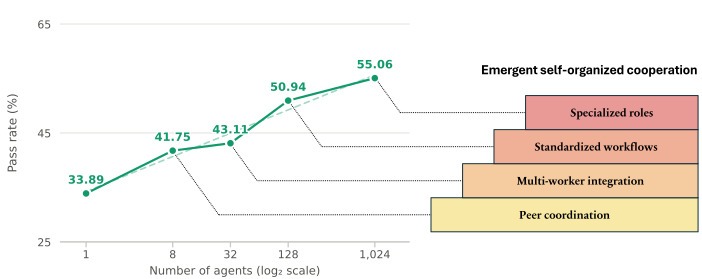
Тысячу агентов запустили только на pandoc. Там результат вырос с 33,89% у одного агента (на этой задаче одиночка заметно выше среднего по пяти) до 50,94% у 128 и 55,06% у 1024.
Что агенты придумали сами
Самое любопытное прячется в траекториях агентов. Промпт у всех один, но поведение роя меняется с его ростом.
Восемь агентов договариваются об интерфейсе модуля и пишут его части параллельно. В gromacs один агент объявил интерфейс, остальные независимо реализовали команды под него. В FFmpeg агент после разговора с коллегой сменил задачу, чтобы не дублировать чужую.
Три десятка агентов начинают рецензировать друг друга. В PHP несколько агентов одобрили правку, другой нашел контрпример, одобрение отозвали, автор правки исправил ошибку, и после повторной проверки правку влили.
У 128 агентов появляется специализация. Они выбирают ревьюеров по опыту и возвращаются к тем же. В pandoc двое договорились о протоколе: автор правки готовит и тестирует ветку, присылает хеш коммита, коллега проверяет и вливает. Протоколом стали пользоваться другие, а после сбоев его переписали и разрешили проверяющему провести весь цикл обновления, проверки и слияния самому.
На тысяче агентов возникают роли. В pandoc интеграторами работали сразу несколько агентов. Автор правки рассылал запрос нескольким кандидатам, выбирал первого ответившего и отменял остальные запросы. Специалисты по одной области подхватывали работу, если чья-то попытка проваливалась.
В промпте сказано, что все равны, а в траекториях агентов видно разделение ролей. Агенты выстроили его сами и сделали взаимозаменяемым, так что на тысяче агентов уход одного не останавливает дело. Для меня это одно из самых убедительных наблюдений, потому что цифры можно объяснить удачным запуском, а сотрудничество вокруг хеша коммита придумать трудно.
Что остается за скобками
Рост результата вместе с числом агентов требует критичного взгляда.
Цена не названа. На pandoc первые 128 агентов добавили к одиночке 17,05 пункта, но переход от 128 к 1024 дал лишь еще 4,12. Отдача падает, а во сколько обошелся запуск, неизвестно.
Данных мало. Тысячу агентов запускали только на одной задаче, на остальных четырех остановились на 128, а рост по задачам идет в целом вверх, без строгой монотонности. Примеры сотрудничества взяты из записей работы агентов, но как часто они сотрудничали — неизвестно.
Сравнения с оркестратором нет. Рой сравнивали с одиночным агентом, а не с роем под управлением главного.
Когда применять рой без начальника
Похоже, он работает там, где у результата есть внешний судья. У ProgramBench это эталонная программа и скрытые тесты, у компилятора Карлини — тесты и эталонный GCC. У игры из эксперимента Anthropic такого судьи нет, и ровно рой там не сработал. Три случая закономерности не доказывают, но подсказывают, где пробовать такие системы в первую очередь: в задачах с жестким сроком и проверяемым итогом.
Инфраструктуры нужно меньше, чем можно было бы ждать: Git, чат и доска заметок покрывают то, что обычно поручают оркестратору. Но говорить, что сотни агентов эффективнее без центра, рано. С оркестратором на таком масштабе не сравнивали, а цена роя остается неизвестной.
Что до коммунистов из заголовка — равенство без плана тут не отменило ролей. Ревьюеры и интеграторы выросли вокруг слияния, а общий судья и общие скрытые тесты остались.
Вывод: для внедрения итогов мало, для эксперимента на небольшой задаче с готовыми тестами достаточно.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.