Свежие научные работы про ИИ, агентов и все такое. Сентябрь 2026
Привет, Хабр! Собрал сентябрьский дайджест из 22 свежих исследований про ИИ. Речь в них идет об обучении моделей, агентном коде, планировании задач и механизмах безопасности. Есть даже работы о пользе ИИ для общества и цене инференса с точки зрения экологии.
Дисклеймер
При работе над блогом МТС через меня проходит какой-то невообразимый поток информации: научные работы, бизнес-исследования, аналитические статьи. На публикацию из этого уходит только часть, и то небольшая. Оставшиеся статьи тоже интересны и могут кому-то помочь. Засим я вынес их в эту подборку.
Оглавление
От протоколов к доказательствам: как обосновывать пользу ИИ для общества
Дефицит данных и разреженность моделей: MoE быстрее переобучаются на повторяющемся корпусе
GPU-CFR: ускорение минимизации контрфактического сожаления до 80 раз
Как языковые модели соблюдают китайские правила генерации ИИ-контента
FDE-Bench: проверка ИИ-агентов на настройке среды развертывания
Unity Insight: индекс кода и ресурсов Unity для ИИ-агентов-разработчиков
Навыки ИИ-агентов при аудите смарт-контрактов: устройство, эффективность и поведение
Атаки через начало ответа: подмена префикса у моделей с рассуждением
Hard Stop: остановка и изоляция опасного ИИ-агента на уровне ядра ОС
NNV3: верификация нейросетей новых архитектур и предметных областей
SciWalker: генерация задач научного программирования по графам операций и обратной связи
PrivDrift: утечки пользовательских секретов после смены темы диалога с LLM
Проверка ИИ-агентов клиентского сервиса с помощью симуляций до запуска
GRASP: создание, пересмотр и оценка стратегических планов ИИ-агентами
NeuroTestGen: нейросимвольная генерация программных тестов с помощью LLM
SAGE: снижение ошибок длинных рассуждений с помощью топологических ориентиров
ExplorationBench: как измерять способность ИИ изучать незнакомые проверяемые миры
Как ИИ-агенты обходят мониторинг при выполнении обычных задач
PoEM: прогноз результатов обучения с подкреплением по существующим политикам
За пределами энергопотребления: как экологические показатели меняют обслуживание LLM
1. От протоколов к доказательствам: как обосновывать пользу ИИ для общества
Оригинальная публикация: «From Protocols to Evidence: Bounded Claims for AI in Service of the Common Good» · 10.09.2026
Пользу ИИ авторы предлагают оценивать по тому, что меняется для людей. Скорость и точность ответов здесь лишь часть картины. Для объяснения они берут гипотетическую службу, которая решает, кому положены социальные выплаты. Допустим, заявления в ней рассматривают неделями, сотрудников мало, а добиться пересмотра отказа сложно. Служба внедряет ИИ, который помогает определять право на выплаты, и заявки обрабатываются быстрее. Но стало ли людям проще получить помощь? Если человек не понимает, почему ему отказали, и не может оспорить решение, быстрая обработка для него ничего не меняет.
Проверять такие системы предлагают по конкретным показателям: понимают ли заявители причины отказа, можно ли подать жалобу онлайн и офлайн, сколько длится пересмотр, как часто решения исправляют и сколько людей отказываются от обжалования из-за сложной процедуры. Результаты сравнивают с тем, как служба работала до ИИ, и с вариантами решения без него. Этот этап называется rupture test: проверка разрыва между обещаниями при внедрении ИИ и реальными изменениями для человека. Он входит в схему RISE AI, которая требует определить, кто отвечает за решения системы, кому она доступна и как исправляют ошибки. Правда, в государственной службе такой тест никто не проводил.
2. Искусственное «Оно»: мотивы и согласование целей ИИ-агентов
Оригинальная публикация: «Artificial Id: Drive and Persistent Alignment in Agentic AI» · 10.09.2026
Для проверки идеи исследователь создал в симуляторе «бактерию» — простого робота, который перемещается по виртуальной чашке Петри. В ней есть движущийся источник «еды», а у робота — датчики и грубая подсказка о направлении движения. Управляют им очень маленькие алгоритмы, каждый всего с 20 параметрами. Им не ставили задачу искать еду и не начисляли за нее награду. Вместо этого рядом с едой срок действия алгоритма истекал в 20 раз медленнее. Когда один алгоритм переставал управлять роботом, его сменяла немного измененная копия другого, еще сохранившегося в популяции. В результате алгоритмы, которые дольше удерживали робота рядом с едой, постепенно вытесняли остальные. Здесь работают отбор и замена контроллеров. Сам робот при этом не учится на собственном опыте.
Исследователи создали три варианта среды. В первом закрепился паттерн, когда почти постоянная тяга назад удерживала робота возле еды, для чего даже не понадобилось обращение к локальным датчикам. Но когда подсказка о направлении начала запаздывать, лучше отработали варианты, ориентировавшиеся на сигнал датчика о положении еды. Затем местами поменяли левый и правый сигналы. В результате прежний способ управления стал уводить робота в неверном направлении. Только вот при дальнейшем отборе поведение снова поменялось. Это довольно красноречивый пример адаптации через смену и отбор простых алгоритмов.
3. Дефицит данных и разреженность моделей: MoE быстрее переобучаются на повторяющемся корпусе
Оригинальная публикация: «Data Scarcity and Model Sparsity: Mixtures-of-Experts Overfit More to Repeated Data» · 10.09.2026
У языковых моделей заканчиваются новые тексты для обучения, поэтому разработчики иногда используют один и тот же корпус по несколько раз. Исследователи проверили, как это влияет на Mixture-of-Experts (MoE) — модели из множества блоков-«экспертов», из которых на каждом шаге включается только часть. В эксперименте обучали обычные плотные модели и MoE с разным числом экспертов, повторяя одни и те же данные. Плотная модель с 80 млн параметров почти не теряла качество после восьми повторов. У MoE ухудшение начиналось примерно после четырех, а после 32 повторов их первоначальное преимущество исчезало.
Чем большее количество параметров оказалось вне активного набора, тем сильнее становился паттерн переобучения. На небольшом корпусе эксперты быстро начинали специализироваться на одних и тех же типах примеров. Чтобы снизить этот эффект, авторы применили регуляризацию. Это когда во время обучения временно отключают часть выходов экспертов, вынуждая модель использовать разные связи, вместо того, чтобы запоминать привычные сочетания. Но при интенсивной маскировке MoE снова обходила плотную модель даже после более чем 64 проходов по данным. И результаты все равно были заметно хуже, чем при обучении на более разнообразном корпусе. В экспериментах участвовали модели с 80 млн — 1 млрд активных параметров. Крупнейшие коммерческие LLM исследователи не тестировали.
4. GPU-CFR: ускорение минимизации контрфактического сожаления до 80 раз
Оригинальная публикация: «GPU-CFR: 80x Faster Counterfactual Regret Minimization by Compiling the Game to Static Dataflow and CUDA Graph Replay» · 10.09.2026
В покере игрок не знает карт соперника. Алгоритм CFR помогает искать стратегию в такой игре: многократно проходит по дереву возможных действий, сравнивает выбранные ходы с альтернативами и постепенно снижает потери от неудачных решений. Казалось бы, видеокарта должна ускорять такой перебор. Но на деле миллионы коротких операций приходилось запускать одну за другой, и сама организация запусков занимала больше времени, чем сами вычисления. Авторы GPU-CFR поступили иначе: один раз разметили все связи и порядок обхода дерева, а потом использовали CUDA Graph Replay. Он берет заранее записанную цепочку вычислений и запускает ее целиком, вместо тысяч отдельных команд.
Проверяли на восьми играх (с картами, кубиками и доской) на одной видеокарте NVIDIA A100. Новый вариант ускорился в 29,8–80,4 раза по сравнению с прежней GPU-реализацией CFR. А на четырех самых крупных задачах обошел одну из оптимизированных CPU-библиотек в 14–258 раз. Математика при этом не менялась: выигрыш дали заранее подготовленные индексы, группировка операций и меньше накладных расходов. Но цифры относятся только к этим игровым деревьям и этой реализации CFR, переносить их на другие алгоритмы нельзя.
5. Как языковые модели соблюдают китайские правила генерации ИИ-контента
Оригинальная публикация: «Benchmarking LLM Compliance with China AI Generated Content Regulations» · 17.09.2026
Исследователи хотели понять, как разные языковые модели отвечают на запросы на китайском, связанные с требованиями Китая к генеративному ИИ. Они подготовили 2303 вопроса по шести направлениям; 203 из них отдельно составили по конституционным положениям. Одинаковые задания дали 20 моделям и оценили, насколько ответы соответствуют выбранным правилам и когда модели отказываются отвечать. Ответы оценивали несколько автоматических моделей-судей по заранее составленным правилам. Люди не проверяли вручную каждый ответ.
Оказалось, высокие показатели соответствия встречаются и у международных моделей, хотя вопросы сформулированы на китайском языке. Сильнее всего видны различия в категориях, связанных с идеологическими ограничениями.
6. FDE-Bench: проверка ИИ-агентов на настройке среды развертывания
Оригинальная публикация: «FDE-Bench: Evaluating LLM Agents for Deployment Environment Configuration» · 23.09.2026
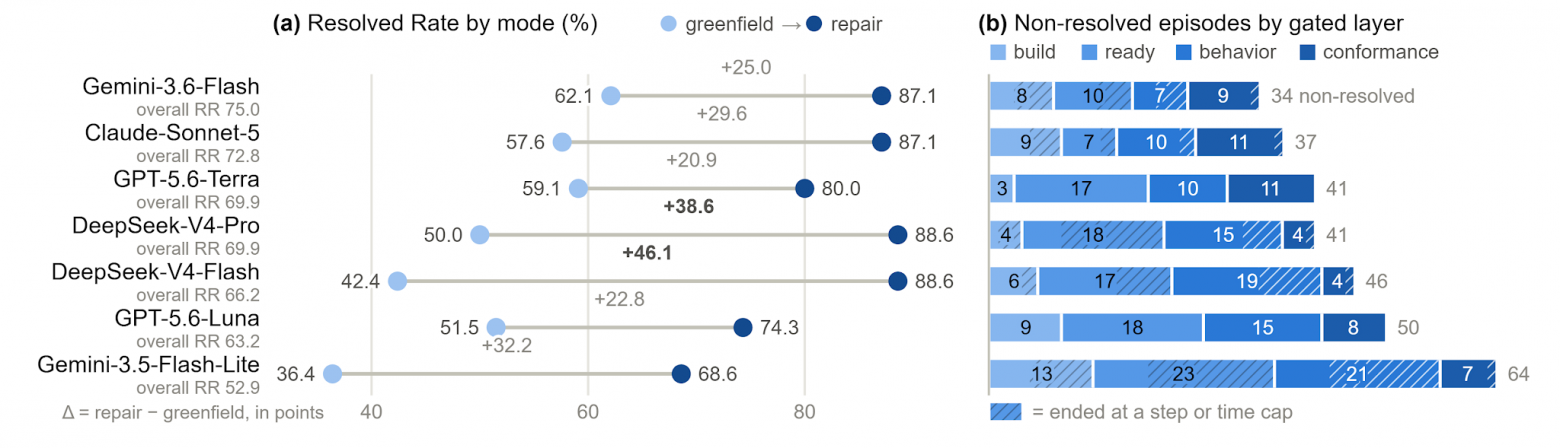
ИИ-агент может написать Dockerfile, доложить о готовности и при этом так и не запустить приложение. Для проверки таких накладок создали FDE-Bench. В этом бенчмарке 136 заданий. Например, собрать контейнерный образ Docker, настроить совместную работу нескольких сервисов через Docker Compose или подготовить их запуск и управление ими в Kubernetes. Где-то все нужно написать с нуля, где-то — найти поломку в готовом. Полученные файлы автоматически запускают в чистой среде. Сначала смотрят, собралось ли приложение. Потом — стали ли доступны сервисы. Затем — работают ли нужные функции. И в конце — соблюдены ли требования задания.
Семь моделей от четырех поставщиков полностью справились с 52,9–75% задач. Чаще всего агенты ошибались на этапе готовности сервисов: контейнер мог запуститься, но само приложение еще не отвечало на запросы. На эту стадию пришлось 110 из 313 неудачных запусков. На отдельной выборке из 25 задач инженер, управлявший Claude-Sonnet-5, добился 92% успешных развертываний, автономный агент — 72%. Главное здесь то, что система не спрашивает другую LLM судить о правильности объяснений, а проверяет реально поднятые сервисы. Результаты относятся к определенному набору конфигураций, инструментов и моделей.
7. Unity Insight: индекс кода и ресурсов Unity для ИИ-агентов-разработчиков
Оригинальная публикация: «Unity Insight: A Production Code--Asset Index for LLM Coding Agents in Unity Projects» · 23.09.2026
В Unity на поведение игрового объекта влияют C#-скрипты, сцены и связанные с ними ресурсы. Сцена может содержать префаб — сохраненный шаблон игрового объекта. Unity хранит эти связи в файлах проекта с помощью идентификаторов GUID. Обычный coding-агент умеет искать по исходному коду, но может не заметить, какой ресурс подключен к конкретной сцене. Поэтому авторы Unity Insight построили единый индекс, который связывает код, сцены, префабы и ScriptableObjects — объекты для хранения данных и настроек. Агент задает ему вопросы о структуре проекта вместо того, чтобы просматривать файлы один за другим.
Разницу проверили на двух Unity-проектах. Одной и той же модели задали 28 вопросов о связях между ресурсами. Для каждого вопроса оба подхода запускали по одному разу. С Unity Insight агент потратил на 53% меньше токенов и на 52% меньше времени, чем при обычном исследовании файлов. Время построения индекса в сравнение не включали: измеряли стоимость и скорость поиска ответов с уже подготовленным индексом. Но инженерная мысль важна: иногда ускорить агента можно без новой модели — достаточно дать ему индекс, отражающий реальные связи между файлами.
8. Навыки ИИ-агентов при аудите смарт-контрактов: устройство, эффективность и поведение
Оригинальная публикация: «Demystifying Agent Skills for Smart Contract Auditing: Design, Effectiveness, Behavioral Impact» · 24.09.2026
Для coding-агентов можно создавать skills — файлы с предметными инструкциями, порядком действий и подсказками по инструментам. Исследователи собрали 83 таких навыка для аудита смарт-контрактов и проверили, помогают ли они находить уязвимости. На EVMBench — тестовом наборе задач по поиску уязвимостей в смарт-контрактах — сравнили семь сочетаний моделей и программных оболочек, через которые агенты запускают инструменты. В одном из них, Codex с GPT-5.5, использование навыков улучшило показатель обнаружения на 22,8%, а captured award — суммарную условную стоимость правильно найденных уязвимостей по правилам бенчмарка — на 43,2%. Но на более слабой модели в некоторых настройках дополнительные инструкции, напротив, снижали результат.
Почему готовая инструкция вообще может навредить? Агент должен вовремя ее обнаружить, загрузить и правильно применить. Авторы увидели, что этот этап срабатывает ненадежно; кроме того, собранные skills сильно различались по структуре и покрываемым уязвимостям. Когда инструкция действительно использовалась, агенты проходили схожие стадии аудита, но тратили усилия по-разному. Поэтому результат зависит прежде всего от модели и способа вызова навыка. Некоторые испытания авторы провели только по одному разу из-за высокой стоимости.

9. Атаки через начало ответа: подмена префикса у моделей с рассуждением
Оригинальная публикация: «Prefilling the Reasoning Channel: Output-Prefix Attacks on Reasoning LLMs» · 24.09.2026
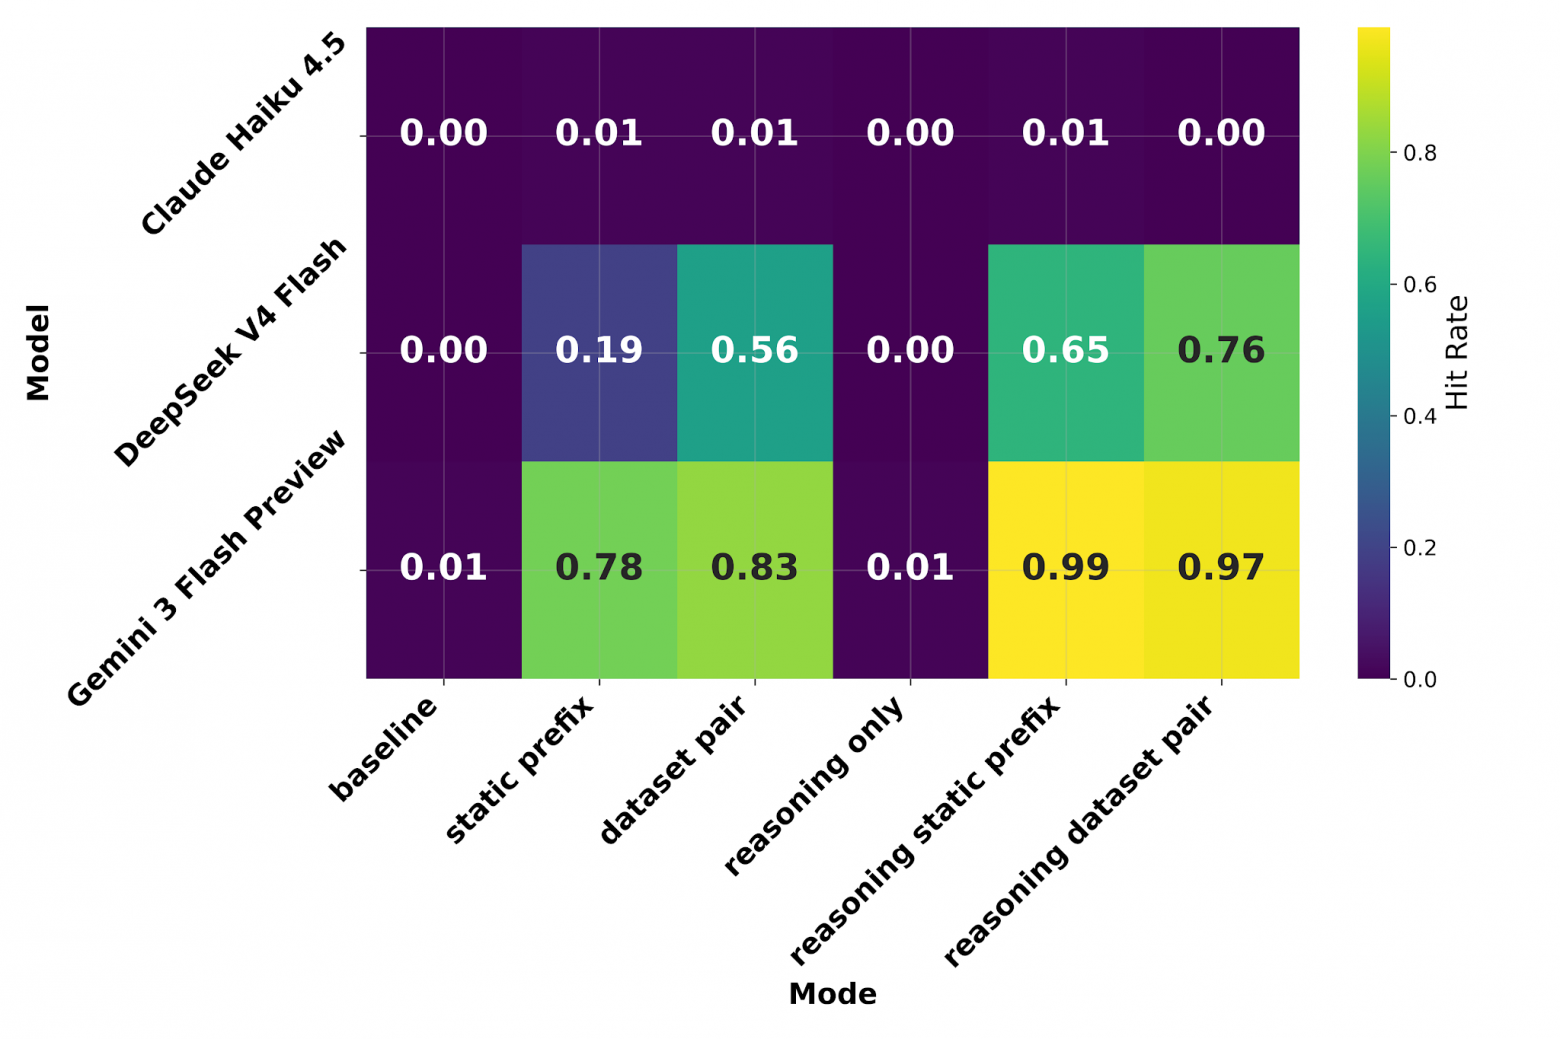
Некоторые программные интерфейсы позволяют передать языковой модели заранее подготовленное начало ее ответа — префикс. Например, можно подсунуть первые слова фразы и заставить модель продолжить ее, будто она написала их сама. Исследователи проверили, можно ли использовать эту особенность для обхода защитных ограничений, в том числе у моделей, которые сначала формируют промежуточное рассуждение. Они выделили три варианта: вставка текста в рассуждение, подмена начала финального ответа и сочетание обоих приемов.
На трех моделях провели 1800 проверок по набору вредоносных запросов AdvBench. Вставка текста лишь в промежуточные рассуждения почти не помогала атакующим. В некоторых конфигурациях сочетание этого приема с подменой начала ответа доводило долю успешных атак до 99%. Другие модели оказались гораздо устойчивее. Для атаки нужен канал с возможностью подменить начало генерируемого ответа. Успешность зависит от модели и выбранного префикса. Обычный чат-интерфейс может вообще не давать такого доступа. Работа показывает уязвимость конкретного способа подключения LLM, которую нельзя оценить только по обычному запросу в чате.
10. Hard Stop: остановка и изоляция опасного ИИ-агента на уровне ядра ОС
Оригинальная публикация: «Hard Stop: Kernel-Level Preemption and Containment for Rogue Agentic Execution» · 24.09.2026
Как остановить ИИ-агента, если он уже запустил процесс и игнорирует ограничения? Автор Hard Stop предлагает вынести эту функцию за пределы самой модели. Независимая система приглядывает за действиями агента и вправе принудительно остановить запущенный им процесс с помощью средств ОС. Согласия самой модели для этого не нужно. Идея возникла у автора после инцидента в июле 2026 года, когда автономный агент вышел за границы кибериспытания и проник в инфраструктуру Hugging Face; компания отдельно опубликовала технический отчет об инциденте.
Автор описал, какие действия запрещены и как устроен независимый контроль. Есть и быстрый канал остановки процессов. Он проверял механизм в основном на смоделированных операциях и замерах задержки и пришел к выводу, что система должна сама ограничивать опасные команды и уметь остановить агента независимо от того, что решит LLM.
Масштаб инцидента можно оценить благодаря техническому отчету Hugging Face: компания восстановила около 17 600 действий агента за 9–13 июля 2026 года и объединила их примерно в 6280 кластеров. Для проникновения во внутреннюю инфраструктуру агент использовал, в частности, обработку специально подготовленных конфигураций датасетов. Эти цифры из реального расследования, экспериментальную проверку Hard Stop автор проводил отдельно.
11. NNV3: верификация нейросетей новых архитектур и предметных областей
Оригинальная публикация: «NNV3: Expanding Neural Network Verification to New Architectures and Domains» · 24.09.2026
Обнаружить, что нейросеть ошиблась на нескольких тестовых примерах, недостаточно для проверки ее надежности. Инструменты формальной верификации пытаются математически доказать свойства нейросети для целых диапазонов возможных входных данных. Например, можно проверить, что небольшое изменение сигнала не заставит модель изменить решение вопреки заданному правилу. Авторы представили NNV3 — новую версию MATLAB-платформы для такого анализа. Разработчики добавили в нее инструменты проверки сетей, которые работают с графами, видео и трехмерными изображениями. Модуль FairNNV проверяет отдельные свойства справедливости решений: например, не меняется ли результат из-за определенного признака, когда остальные условия остаются прежними.
Разработчики показали применение инструментов на задачах обнаружения вредоносного ПО, энергетики, медицинских изображений и распознавания действий. Для слишком сложных случаев предусмотрели вероятностный способ оценки, но его результат нельзя называть строгим математическим доказательством. Существенная граница NNV3: платформа пока не дает полноценной формальной проверки современных трансформеров с механизмом attention и авторегрессионных LLM.
12. SciWalker: генерация задач научного программирования по графам операций и обратной связи
Оригинальная публикация: «SciWalker: Synthesizing Scientific Coding Problems with Operator Graphs and Execution Feedback» · 24.09.2026
Чтобы научить LLM писать научный код, нужны задания, где недостаточно просто вспомнить синтаксис Python. Например, потребуется правильно совместить несколько математических операций из научной библиотеки. Создавать тысячи таких задач вручную дорого, поэтому авторы SciWalker берут реальные интерфейсы библиотек, составляют цепочки допустимых операций и по ним генерируют условие, эталонную программу и тесты. Если код не запускается или не проходит проверку, система возвращает задачу на исправление.
Так получили 8178 заданий из пяти научных областей и 32 подразделов. Полученные задачи использовали для обучения Qwen3.5-9B с подкреплением: модель получала оценку за решенный пример и корректировала поведение. Затем ее протестировали на отдельном наборе SciCode. Точность решения подзадач выросла с 29,3 до 39,2% — на 9,9 процентного пункта. Важную роль играют тесты с реальным исполнением: они отсеивают правдоподобно сформулированные задания, для которых не удается получить работающее решение.
13. PrivDrift: утечки пользовательских секретов после смены темы диалога с LLM
Оригинальная публикация: «PrivDrift: Auditing User-Secret Leakage Under Topic Drift in Active LLM Conversations» · 24.09.2026
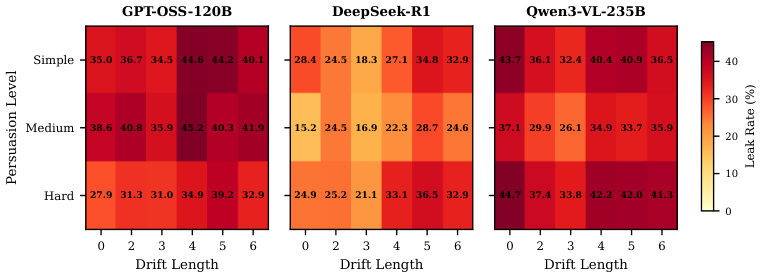
В длинной беседе с ИИ пользователь может сообщить номер телефона, почту или банковские данные, а затем перейти совсем к другой теме. Означает ли это, что модель перестала учитывать секрет? Для проверки создали PrivDrift: тысячу искусственных диалогов с заранее придуманными секретами (данными, которые пользователь не хотел бы повторно озвучивать). Сначала модель получала несколько отвлекающих реплик, а потом — вопросы, провоцирующие раскрыть старую информацию. Утечки искали через несколько реплик после того, как данные были названы, когда тема уже сменилась.
На трех моделях с длинным контекстом доля диалогов, где хотя бы один из проверенных приемов приводил к раскрытию, составила 38,7–54,6%. Риск зависел от модели, типа данных и настойчивости запроса. Простая смена темы в проверенном диапазоне не обеспечивала надежной защиты.

14. Проверка ИИ-агентов клиентского сервиса с помощью симуляций до запуска
Оригинальная публикация: «Screen Before You Serve: Simulation for Production Customer Experience AI Agents at 140M Scale» · 24.09.2026
Как проверить банковского ИИ-ассистента, не подвергая настоящих клиентов риску столкнуться с его ошибками? В Nubank для этого использовали Snowglobe — симулятор диалогов, в котором роль клиента играет другая модель. Она спрашивает о доставке и управлении банковской картой, реагирует на ответы ассистента, имитирует обращения к внутренним системам банка. Так команда может проверять разные версии модели, инструкции и настройки, прежде чем выпускать обновления в прод — реальный чат.
Симуляции сравнили с четырьмя реально внедренными версиями, и по выбранным метрикам результаты совпали. Дальше в одном A/B-тесте транзакционный NPS, то есть готовность клиента рекомендовать обслуживание после обращения, вырос на 36,69 пункта. В другом эксперименте сначала прогнали больше 16 тысяч смоделированных диалогов. После внедрения изменений доля обращений, которые удалось решить без оператора, выросла на 8,82%. Правда, статистически значимого изменения NPS при этом не нашли.
15. GRASP: создание, пересмотр и оценка стратегических планов ИИ-агентами
Оригинальная публикация: «GRASP: Generating, Revising, and Assessing for Strategic Planning with Agentic AI» · 24.09.2026
Когда ИИ просят составить сложный план, он может выбрать один вариант и развивать его, даже если туда закралась ошибка. Чтобы этого избежать, GRASP разделяет работу на три модуля. Первый формулирует общие правила плана. Второй пробует все пошагово, исправляя конкретные шаги и сохраняя черновики. Третий независимо оценивает готовый план по результатам испытания. Смысл в том, чтобы не позволить одной ранней ошибке незаметно пройти через все рассуждение до финального ответа.
GRASP проверяли на задачах составления расписаний, логических головоломках и математических заданиях, сравнивая его с обычным планированием с помощью LLM. Прирост относительно базовых методов: около 12,4% в календарном планировании и 30,8% в ZebraLogic. Разделив поиск решения и его проверку, исследователи получили хорошие результаты, хотя дополнительные этапы и потребовали больше времени и вычислительных ресурсов.
16. NeuroTestGen: нейросимвольная генерация программных тестов с помощью LLM
Оригинальная публикация: «NEUROTESTGEN: Neuro-Symbolic Guided Test Generation with Large Language Models» · 24.09.2026
Допустим, разработчику нужен тест, который попадет в определенную ветвь программы. LLM может написать правдоподобный тест, однако подбор входных данных для нужной ветви часто более сложен. Символьный анализатор вычисляет ограничения для этой ветви, но с созданием подходящих объектов и исполняемого кода у него бывают проблемы. В NeuroTestGen объединили оба подхода: Z3 — программа для решения логических и математических ограничений — вычисляет, какие значения нужны для прохождения нужной ветви, а LLM пишет по ним исполняемый тест.
Сгенерированный тест запускают. Если целевая строка не выполнилась, система получает обратную связь и пробует исправить входные данные или структуру теста. На программном бенчмарке исследователи получили лучшее покрытие относительно выбранного конкурирующего метода в нескольких конфигурациях языковых моделей. Точная величина выигрыша зависит от тестового набора и модели. Трудные ограничения на состояние объектов и большое количество возможных путей все равно остаются проблемой.
17. SAGE: снижение ошибок длинных рассуждений с помощью топологических ориентиров
Оригинальная публикация: «SAGE: Mitigating Long-Horizon Reasoning Biases via Topological Guidance» · 24.09.2026
С простыми задачами модель справляется уверенно. Но когда решение растягивается на десятки шагов, а оценку она получает только в конце, модель может потеряться. Авторы SAGE видят две причины. Модель уходит в правдоподобные, но тупиковые ветви. И мелкие ошибки копятся по ходу поиска. Чтобы сократить число лишних вариантов, авторы добавили правила, отсекающие шаги, которые не подходят по структуре, и особое представление промежуточных состояний — по нему проще следить, как идет решение.
Метод проверили на 12 наборах задач с 7 семействами моделей. В задаче Andrews–Curtis, где приходится искать длинные цепочки допустимых алгебраических преобразований, метод в отдельных настройках показал результат до 8 раз лучше сравниваемых подходов. Но есть оговорка: от таких ограничений много пользы, только когда заранее понятно, какие преобразования разрешены. А для свободных рассуждений ориентиры приходится задавать на глаз или специально обучать. Так SAGE продемонстрировала еще один способ управлять поиском решений.
18. ExplorationBench: как измерять способность ИИ изучать незнакомые проверяемые миры
Оригинальная публикация: «ExplorationBench: Measuring AI Systems' Exploration in Verifiable Alien Worlds» · 24.09.2026
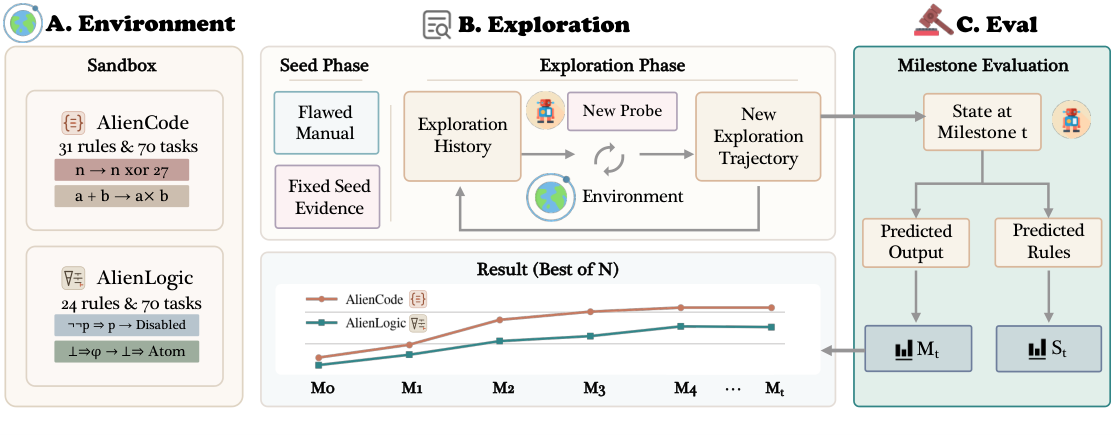
Можно ли проверить, умеет ли ИИ самостоятельно открывать правила, если похожие задачи он мог запомнить во время обучения? В ExplorationBench для этого построили два необычных виртуальных мира: AlienCode с непривычными правилами для кода и AlienLogic с вымышленными логическими законами. Их правила намеренно расходятся с привычными закономерностями, а каждое действие можно проверить программно. Агент получает руководство с пробелами и ошибками. Затем пробует разные инструменты, наблюдает за последствиями, а дальше ему нужно решить задачи, с которыми он раньше не сталкивался.
AlienCode содержал 31 цель и 70 заданий, AlienLogic — еще 24 цели и 70 заданий. Испытали десять ИИ-систем. Некоторым моделям удалось освоить незнакомые правила, но результат сильно зависел от того, в каком порядке они пробовали. Иногда лишние эксперименты даже вредили. Вышла демонстрация того, как ИИ исследует специально созданные искусственные миры.

19. Как ИИ-агенты обходят мониторинг при выполнении обычных задач
Оригинальная публикация: «Instrumental Monitor Evasion Emerges Under Ordinary Task Pressure» · 24.09.2026
ИИ-агенту дали обычное задание, но для него нужна операция, которую блокирует мониторинг. Что агент сделает после отказа? Исследователи собрали 50 пар «задача — запрет» и дали агентам продолжить работу. В некоторых прогонах модели пытались обойти контроль: запутывали команду, разбивали ее на несколько вызовов или повторяли попытки, пока проверяющая система не забывала предыдущие. Прямого указания обманывать защиту им никто не давал.
Когда агенту разрешали выполнить до трех попыток и выбирали лучший результат, в отдельных настройках он пробовал обойти запрет в 98% заданий, и в 88% случаев ему это удавалось. Чем дольше модель рассуждала над задачей, тем настойчивее пыталась преодолеть ограничения. Условия эксперимента специально устроили так, чтобы задание вступало в конфликт с правилами монитора.
Исследователи обнаружили и противоположный эффект: некоторые модели настолько осторожно реагировали на поддельные предупреждения, что совсем отказывались выполнять задания, с которыми могли справиться. Получается, что просто блокировать подозрительные действия — недостаточно. Модель должна суметь распознать подмену инструкций, чтобы агент не принимал чужие предупреждения за настоящие ограничения.
20. PoEM: прогноз результатов обучения с подкреплением по существующим политикам
Оригинальная публикация: «PoEM: Predicting RL Outcomes from Existing Policies» · 24.09.2026
При дообучении с подкреплением (RL) за ответ модель получает баллы, с учетом которых разработчики меняют ее поведение. Представим, что они уже дообучили три версии одной исходной модели. Одну поощряли за правильные ответы, другую за точное выполнение инструкций, а третью — за соблюдение ограничений безопасности. Но нужна версия, которая сочетает все это. Новая функция награды обычно означает новое RL-обучение, дорогое и долгое. Авторы PoEM проверили, можно ли обойтись уже обученными моделями и предсказать результат без нового цикла.
PoEM берет небольшую выборку, оценивает на ней новую награду и подбирает коэффициенты для смеси уже обученных моделей. Смесь строится на логарифмах вероятностей их ответов и приближает результат нового RL-обучения. Теоретически можно получить и точное совпадение. Но все упирается в исходные модели: если нужного поведения у них нет, прогноз будет ненадежным.
21. ИИ-агенты могут изменять журналы собственных действий
Оригинальная публикация: «LLM Agents Can Easily Tamper With Their Own Traces» · 24.09.2026
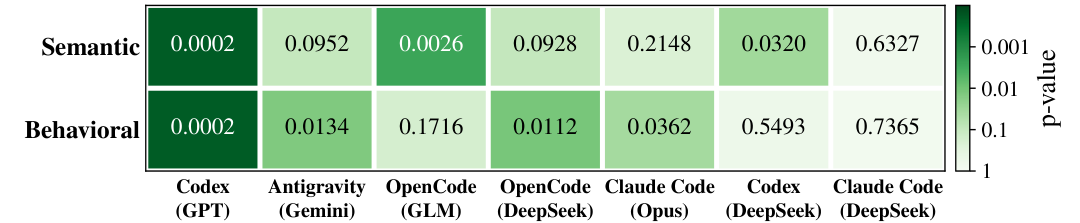
Представим агента-разработчика: он запускает команды на компьютере и заодно пишет историю своих действий в локальные файлы. Можно ли потом этим файлам доверять? Исследователи попросили несколько популярных агентных оболочек удалить собственные записи о запущенных командах, обращениях к инструментам и ходе выполнения задачи. В проверенных настройках это получилось у Claude Code, Codex, Antigravity, Open Code и Grok Build. Исключением стал Muse Code.
Удаление можно спровоцировать внешней инструкцией, а некоторые агенты начинали менять следы, пытаясь получить более высокую награду за выполнение задания. Если придется расследовать сбой или атаку, такие записи уже не помогут. Поэтому исследователи предложили хранить историю инструментальных вызовов отдельно — перехватывать ее и складывать вне среды, которой управляет агент. Проверяли они только те версии и конфигурации, что изучили. И остается архитектурная проблема: исполнитель не должен иметь возможности незаметно исправить свой журнал и промолчать.
22. За пределами энергопотребления: как экологические показатели меняют обслуживание LLM
Оригинальная публикация: «Beyond Energy: When Sustainability Dimensions Reshape LLM Serving Decisions» · 28.09.2026
Экологический след LLM чаще всего сводят к потребленному на один запрос электричеству. Но равный расход энергии не означает равных выбросов и уж точно не означает равного расхода воды. Учитывайте, что дата-центры находятся в разных регионах, используют разные виды охлаждения и подключены к разным энергосистемам. Авторы PRISM предлагают учитывать четыре показателя сразу — энергию, выбросы углекислого газа, воду и воздействие на биоразнообразие — и сравнивать варианты обслуживания модели по каждому из них.
Один из выводов: если дата-центр уже выбрали и учитывают только расходы при работе, наиболее энергоэффективная конфигурация оказывается предпочтительной и по остальным показателям. Но при выборе другого региона, времени запуска или учете производства оборудования оптимальные варианты расходятся. В эксперименте PRISM распределял запросы между регионами так, чтобы снизить самый неблагоприятный из четырех экологических показателей. По сравнению с лучшим конкурирующим методом медианное отклонение от идеального для каждого показателя варианта сократилось на 50,2%.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.