Куда девать старую почту, когда ящик переполнен: локальные архивы в почтовом клиенте CommuniGate Pro
разработчик отдела разработки мобильных приложений CommuniGate Pro
Рабочая переписка редко хранится в одном месте. Документы приходят по почте, детали обсуждаются в чате, встречи планируются в календаре. Длинную цепочку писем удобнее читать за компьютером, а расписание в календаре можно посмотреть и с телефона.
Мы небольшой командой разрабатываем клиентское приложение CommuniGate Pro, объединяющее почту, календарь, контакты и чаты. Оно работает на Windows, Linux, macOS, Android и iOS. Пишем на Dart и Flutter, поэтому большая часть кода у нас общая для всех платформ.
Это упрощает разработку и поддержку приложения и интерфейса, но возможности десктопной и мобильной версий все же различаются. Например, локальные почтовые архивы мы сделали только для десктопа. Этой задачей я как раз и занимался. Идея простая: пользователь переносит старые письма с сервера на компьютер, освобождает место в почтовом ящике и продолжает работать с письмами прямо в приложении.
В этой статье я расскажу, как встроил локальные архивы в общий проект, как проверял их на больших объёмах и как попутно реализовал ещё одну возможность - общий буфер длительных операций.
Зачем вообще нужны локальные архивы
У корпоративного ящика есть квота, которая обычно заканчивается в самый неподходящий момент. В старой переписке могут оставаться важные письма: договорённости с подрядчиком, документы, история проектов. Все это хочется сохранить, потому что иногда письмо трёхлетней давности бывает полезнее половины сегодняшних входящих.
Локальные архивы позволяют перенести письма с сервера на компьютер. В приложении сохраняются привычные действия: открыть переписку, посмотреть вложение, ответить или переслать сообщение. Архивы живут в том же дереве папок и выглядят как обычная почта, так что ради старых писем не нужно устанавливать отдельную программу и привыкать к ней.
Но ручной перенос писем имеет неприятный побочный эффект – требуется их регулярная сортировка. Сегодня ты место освободил, а через несколько месяцев опять нужно разбирать завалы.
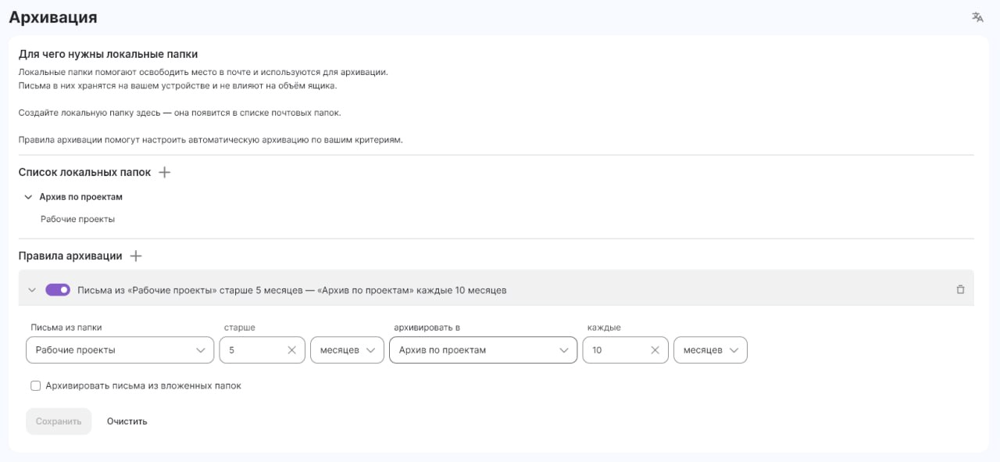
Для решения этой проблемы мы добавили автоматическую архивацию: теперь пользователь может настроить правило - выбрать папку, указать возраст писем, место назначения и периодичность обработки. При необходимости это правило можно распространить и на подпапки. Например, старую переписку по проектам можно переносить автоматически. Условия видны в настройках, и их можно изменить, когда меняется порядок работы.
Desktop-функция в общем проекте
Работа с архивами подключается в десктопной сборке, а мобильная версия использует общую часть приложения без этой функции. Так мы сохранили общий почтовый интерфейс и отделили возможности локального архива. Для небольшой команды это удобно: общие компоненты продолжают развиваться в одном проекте.
Логику архивов мы реализовали на Dart. Для файловых операций использовали стандартные API языка, плюс библиотеки из экосистемы приложения. Формат локального архива целиком спроектировали внутри проекта. Сейчас он объединяет письма, вложения и структуру папок. Сохранённый архив можно подключить обратно к приложению и продолжить работу с перепиской.
Flutter, конечно, не отменяет особенностей операционных систем. Доступ к выбранному каталогу и отображение содержимого писем мы проверяли отдельно на Windows, Linux и macOS. Общий код помогает переиспользовать работу, но результат всё равно нужно проверять на устройствах пользователей.
Из одной функции выросла другая
Вот здесь начинается самая интересная часть разработки.
Автоархивация работает одновременно с ручными действиями и синхронизацией почты. Пока пользователь вручную переносит письма в архив, приложение получает изменения с сервера или начинает обработку по правилу.
Некоторые действия затрагивают одни и те же данные. Я увидел эти пересечения еще в начале разработки и предложил добавить унифицированный буфер длительных операций для всего проекта.
Представьте электронную очередь в банке: приходите, берёте талон и ждёте, когда на табло появится ваш номер. Это очень удобно: не нужно выяснять, кто последний и не занял ли кто-нибудь ваше место. У буфера похожая роль: задачи становятся в очередь, а пользователь видит, какая из них сейчас выполняется. Причём самой системе неважно, пришли вы за выпиской или хотите сделать перевод. Так и наш буфер можно использовать для разных длительных операций в приложении.
Архивы и стали его первым применением. Сам буфер проектировался как самостоятельная возможность. К нему можно подключать другие длительные задачи и использовать общий порядок их выполнения, наблюдения и управления.
Я подготовил описание работы буфера: как задачи попадают в очередь, что видит пользователь и что происходит при остановке. Аргумент был связан с дальнейшей поддержкой. При развитии приложения вопросы очередности, прерываний и отображения результата возникали бы снова. Лучше было решить их один раз.
В результате у нас появился отдельный механизм, который умеет показывать очередь задач, состояние текущей операции и прогресс выполнения, а сведения о незавершённой работе сохраняются между запусками приложения.
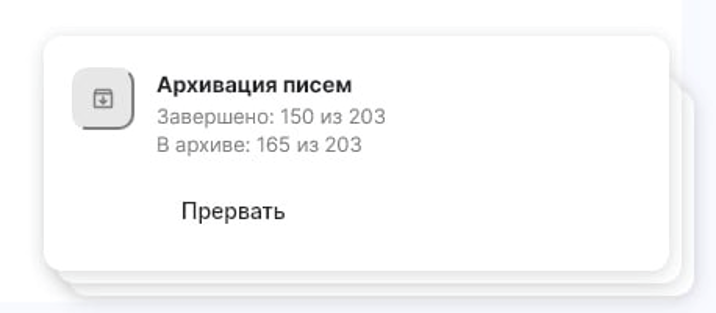
Позже мы использовали этот механизм для проверки и подключения существующих архивов. Так разработка архивации дала проекту сразу две возможности: сами локальные архивы и общую основу для управления длительными задачами.
Что делать, если перенос прервался на середине
Одна из самых неприятных ситуаций при работе с большими объемами данных – прерывание операции. Представим, что часть большой папки уже перенесена, и после этого пропало соединение. Или пользователь сам остановил задачу и закрыл приложение.
Сообщение «операция прервана» мало что объясняет. Важно показать, что произошло с письмами и какое действие доступно дальше. Поэтому при разработке мы уделили много внимания тому, как сохраняется состояние данных и интерфейса после остановки.
Сценарий | Что проверяем | Результат для пользователя |
Соединение пропало во время переноса | Сохранённые письма учитываются при продолжении; незавершённые не объявляются перенесёнными | Уже выполненная работа сохраняется, состояние оставшейся части видно |
Пользователь подтвердил паузу и перезапустил приложение | Выбранная пауза сохраняется | Задача остаётся остановленной до дальнейшего действия пользователя |
Письмо исчезло на сервере до переноса | Отсутствующее письмо не вызывает бесконечные повторы операции | Остальные письма могут быть обработаны; частичный результат сопровождается предупреждением |
Пользователь дважды нажал «Прервать» | Создаются один запрос паузы и одно окно подтверждения | Повторное нажатие не запускает второй процесс остановки |
Здесь важна разница между техническим прерыванием и намеренной паузой. Если человек сам остановил операцию, то после перезапуска приложения она должна оставаться остановленной. Восстановление учитывает и выполненную работу, и решение пользователя.
Как мы проверяли сложные сценарии
Некоторые ошибки зависят от порядка действий. Вручную попасть в нужный момент трудно - пока нажимаешь кнопку второй раз, первый запрос уже завершился.
В автоматических проверках мы управляли этим порядком. Например, тест начинал постановку задачи на паузу и временно удерживал завершение запроса, а затем имитировал второе нажатие «Прервать». После этого проверял, что запрос остался один, разрешал ему завершиться и проверял окно подтверждения.
Для разработчиков Dart/Flutter здесь полезен Completer: он позволяет точно выбрать момент завершения асинхронного действия. В тесте работали настоящий presenter и виджеты очереди, а сервис операций заменялся управляемым тестовым объектом.
Таким способом мы воспроизводили повторные нажатия, закрытие экрана и ошибки при остановке задачи. Такой сценарий можно запускать снова после изменений и проверять, что поведение сохранилось.
Что случилось, когда задач стало много
При большом количестве задач стали заметны затраты, которые почти не влияли на короткие проверки, в частности, время уходило на повторный пересчёт состояния очереди после каждого изменения.
Чтобы оценить эту работу отдельно, я использовал нагрузочный тест без почтового сервера и настоящих вложений.
Тест создавал временную SQLite-базу в памяти через Drift и заполнял очередь. Затем подключал наблюдателя за её состоянием и последовательно переводил элементы в завершённое состояние. Каждое обновление ожидалось через await, а его результат проверялся.
Время измерялось через Stopwatch. Подготовка данных не входила в замер; обработка обновлений и короткое ожидание событий подписки — входили. Отрисовка интерфейса не измерялась.
После сокращения повторных пересчётов в истории замеров зафиксирован такой результат:
Условия внутреннего теста | До оптимизации | После |
10 000 обновлений состояния с активной подпиской | 39,1 с | 5,1 с |
Это результат конкретного прогона, а не время переноса 10 000 писем. Полная архивация зависит также от размеров сообщений, вложений, соединения с сервером и диска.
Для меня полезным выводом стала необходимость проверять фоновую работу вместе с наблюдателями её состояния. Стоимость одного обновления может быть небольшой, но повторяется оно тысячи раз.
Где помог ИИ
Я использовал ИИ как компаньона при обсуждении решений, разборе ошибок, подготовке тестовых сценариев и анализе замеров.
Один из примеров — это совместная работа архивации и синхронизации. Мы рассматривали, какие действия могут начаться одновременно, где они затрагивают общие данные и что изменится при прерывании. Этот разбор помог спроектировать согласованное выполнение операций. После этого выбранное поведение проверялось тестами и нагрузкой.
ИИ помогал быстрее рассматривать возможные сценарии и находить вопросы, которые нужно было проверять в приложении. Убедительный ответ было особенно приятно читать, особенно если он совпадал с моей гипотезой. Поэтому окончательные решения я вручную проверял кодом, тестами и замерами: что останется после остановки, что покажет интерфейс и как изменится время выполнения.
Что получилось и что планируем дальше
Сейчас локальные архивы уже доступны пользователям десктопных версий CommuniGate Pro. Работают ручной перенос, автоматические правила и подключение существующих архивов.
При разработке мы также получили самостоятельный буфер длительных операций. Архивы стали первыми задачами, которые его используют; следующие возможности проекта смогут подключаться к тому же механизму.
Разработка продолжается. Мы планируем развивать работу с большими объёмами переписки и добавить импорт сторонних форматов. Для расширения есть основа: формат локального архива, общая очередь и повторяемые проверки сложных сценариев. Поддержка новых форматов и дальнейшее масштабирование ещё потребуют работы над совместимостью и производительностью. Но это следующие этапы, а не возможности текущей версии.
Если подводить итог этой разработки, я бы выделил следующее: когда делаешь длительную операцию, недостаточно просто написать код, который выполняет её от начала до конца.
Нужно заранее подумать о трех вещах:
что сохранится, если операция прервется?
как пользователь узнает, какая часть работы уже выполнена?
сможет ли он продолжить работу с того места, где остановился?
Те же вопросы возникают при импорте файлов, синхронизации документов и в других задачах, которые могут выполняться дольше, чем пользователь держит открытым один экран.
Пишите свои комментарии. Будет интересно узнать, какие сценарии прерывания длительных операций оказывались самыми неожиданными в ваших проектах и как вы с ними справлялись.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.