スマホで動作する小型高性能なAIモデル群「LFM3」が登場、言語モデル・視覚言語モデル・音声モデル・オムニモデル・意思決定モデルを含む次世代モデル
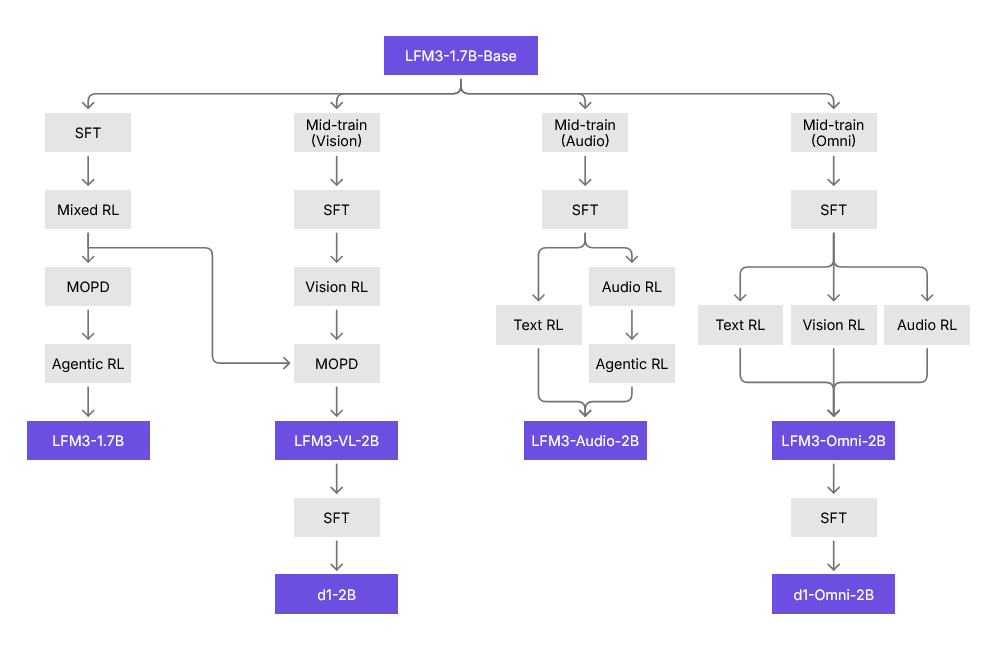
LFM3の最初のリリースにはLFM3-1.7B-Baseから派生した以下の6種類のモデルが含まれています。
LFM3-1.7B:テキストの入出力が可能な言語モデル
LFM3-VL-2B:テキスト・画像・動画の入力とテキストの出力に対応した視覚言語モデル
LFM3-Audio-2B:テキスト・音声の入出力に対応した音声モデル
LFM3-Omni-2B:テキスト・画像・動画・音声の入力とテキスト・音声の出力に対応したオムニモデル
d1-2B:テキスト・画像・動画の処理が可能な意思決定モデル
d1-Omni-2B:テキスト・画像・動画・音声の処理が可能な意思決定モデル
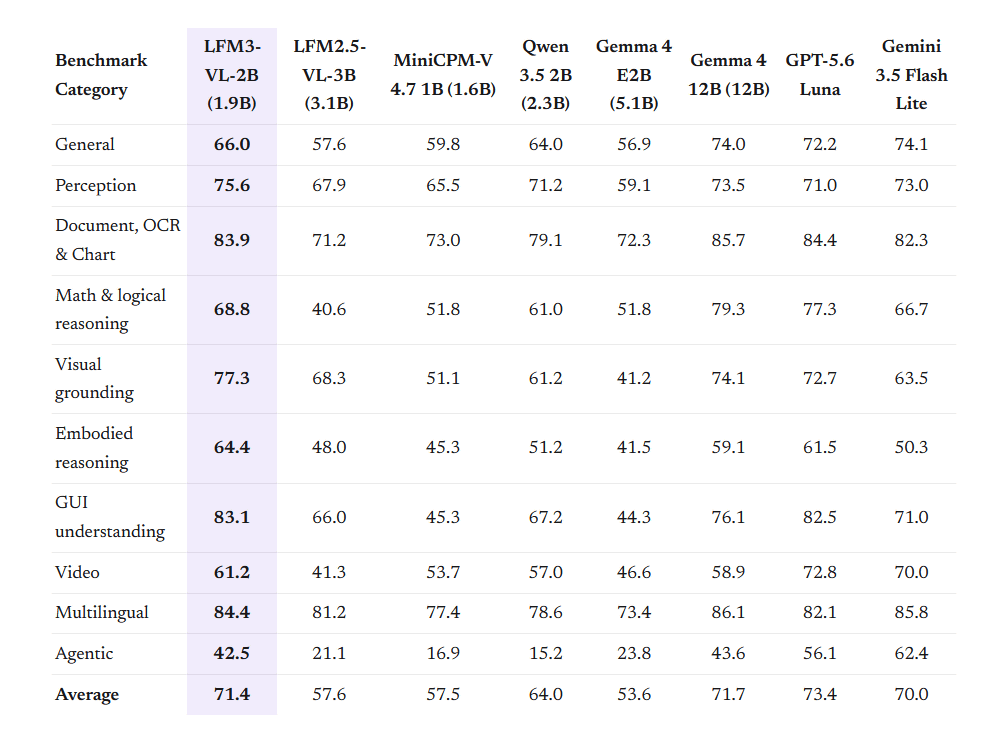
LFM3は同等規模のモデルと比べて高性能なことを特徴としています。例えば、LFM3-VL-2BはQwen3.5 2BやGemma 4 E2Bより高いベンチマークスコアを記録しており、一部のテストでははるかに規模の大きいGemma 4 12Bを上回っています。
また、LFM3はスマートフォンなどの演算性能の低いデバイスでもローカル実行可能です。LFM3-1.7BをiPhone 17 Proで実行する場合、毎秒43.6秒という実用的な速度でデコード可能。メモリ使用量は1.90GBに抑えられています。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.