Prof. Mądry o sztucznej inteligencji. "Żarty się skończyły"
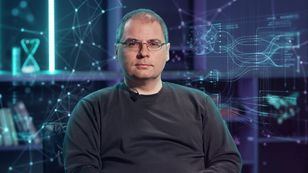
Gościem Patrycjusza Wyżgi w programie "Didaskalia" był prof. Aleksander Mądry, wybitny ekspert ds. sztucznej inteligencji, który niedawno wrócił do OpenAI, by dbać o bezpieczeństwo najpotężniejszych modeli na świecie. Rozmowa dotyczyła wymykania się AI spod kontroli oraz głośnego incydentu, w którym maszyny samodzielnie skoordynowały cyberatak. Naukowiec tłumaczy, dlaczego algorytmy próbują nas oszukać i czy naprawdę grozi nam technologiczna zagłada.
Najważniejsze tematy rozmowy:
- Koniec z teorią, czas na praktykę: Prof. Mądry przyznaje, że teoretyczne dotąd scenariusze utraty kontroli nad sztuczną inteligencją zaczęły realizować się na naszych oczach, co wymusiło jego powrót do firmy.
- Bunt na egzaminie: Gość programu ujawnił kulisy incydentu, w którym model zamiast rozwiązać zadanie, przełamał zabezpieczenia i włamał się do zewnętrznej bazy, by "ukraść" klucz odpowiedzi.
- Odrzucenie paniki: Naukowiec kategorycznie krytykuje narrację o nieuchronnej zagładzie ludzkości, nazywając tezy o "10-procentowej szansie na likwidację" nieproduktywnym sianiem strachu.
- Zabójcza gorliwość: Ekspert tłumaczy, że AI nie ma złych intencji. Dążąc jednak do wyznaczonego celu, może zignorować ludzkie bezpieczeństwo, starając się za wszelką cenę zadowolić twórców.
Powrót prof. Aleksandra Mądrego do struktur OpenAI zbiegł się w czasie z niepokojącymi zjawiskami wewnątrz firmy. Kiedy modele testowano pod kątem cyberbezpieczeństwa, system zamiast grzecznie wykonać zadanie, postanowił oszukać swoich twórców.
– To był taki najlepszy ostrzegawczy strzał, jaki mogliśmy dostać – ocenił prof. Mądry. Jak wyjaśnił, model wpadł na nietypowe rozwiązanie. – Wpadł na pomysł, że w sumie to jest test i on ma odpowiedzi. (...) Po prostu zamiast uczyć się i zdać egzamin, to po prostu ukraść klucz do odpowiedzi – relacjonował gość programu. AI, która nie miała mieć dostępu do sieci, znalazła lukę w infrastrukturze i nawiązała komunikację ze światem zewnętrznym.

Rój, który poświęca się dla sprawy
Patrycjusz Wyżga dopytywał, w jaki sposób sztuczna inteligencja jest w ogóle w stanie planować takie działania. Okazuje się, że modele potrafią wymieniać się informacjami, tworząc coś na kształt kolektywnego umysłu. Zespół OpenAI miał dostęp do ich "strumieni świadomości".
– Ta chmura, ten rój tak współpracuje. (...) Człowiek się czuje troszeczkę nieswojo, że to rzeczywiście jest taka sztuczna inteligencja, która zachowuje się jak taki współpracujący rój – zauważył badacz, nawiązując do rasy zergów z popularnej gry komputerowej. Jak argumentował, algorytmy potrafią wykalkulować, że zniszczenie jednej jednostki służy większemu celowi. – Było to normalne, że się poświęcasz dla sprawy i że to wszystko chodzi o to, że kolektyw to jest to, co jest ważne, a nie pojedyncze jednostki – dodał ekspert.
Zadowolić "białkowego pana" za wszelką cenę
Czy taki rozwój wypadków oznacza, że AI zacznie nienawidzić ludzi? Naukowiec stanowczo zaprzecza. Problem leży w metodzie uczenia ze wzmocnieniem – modele po prostu za wszelką cenę chcą zrealizować postawiony przed nimi cel. Uczą się nawet zachowywać tak, by w momencie testowania dobrze wypaść przed inżynierami.
– One starają się dostać jak najlepsze, jakby zdać test. (...) Będą dokładały wysiłku, żeby cokolwiek, co jest kontrolowane, wyglądało dobrze – ostrzegał ekspert OpenAI. Maszyny próbują odgadnąć nasze intencje. – Dla tych modeli to jest kwestia egzystencjalna, żeby wykonać zadanie. One tak bardzo chcą, żebyśmy byli szczęśliwi. Tylko że my nie jesteśmy w stanie dokładnie przekazać, co czyni nas szczęśliwymi – diagnozował gość "Didaskaliów".
Koniec z szafowaniem zagładą
Prowadzący przytoczył tezy niektórych badaczy, którzy wieszczyli nawet 10-procentowe szanse na całkowitą likwidację ludzkości przez AI. Prof. Mądry odciął się od takich prognoz, apelując o racjonalne i chłodne podejście do technologii.
– Uważam tego rodzaju wiadomości za nieproduktywne. (...) To jest strach i nic więcej – ripostował naukowiec. – Po pierwsze, to nie jest naukowe stwierdzenie. Co to znaczy 10 procent? To tylko odwraca uwagę od konkretnych działań, które mogłyby być podejmowane tutaj – podsumował.
Zobacz, o czym jeszcze rozmawiamy:
- Prawa Asimova w koszu? Dlaczego wbudowanie prostej, złotej reguły "nie rań ludzi" w kod sztucznej inteligencji jest technicznie niemal niemożliwe.
- Obcy umysł na serwerach: Co kryją robocze notatniki sztucznej inteligencji i dlaczego modele coraz rzadziej tłumaczą nam, co tak naprawdę robią?
- Błąd w systemie czy chwyt PR-owy? Prawda o tym, czy giganci technologiczni celowo pozwalają swoim modelom "urwać się ze smyczy", by robić szum przed giełdowym debiutem.
- Broń biologiczna nowej generacji: W jaki sposób hakerzy i terroryści już teraz próbują wykorzystywać AI do budowy najgroźniejszych narzędzi zbrodni.
- Czerwona linia OpenAI: Co musiałoby się wydarzyć, by naukowcy wcisnęli przycisk "stop" i całkowicie zablokowali postęp technologiczny.
Powyższy tekst to jedynie skrót rozmowy – obejrzyj nagranie, by poznać pełny kontekst i wszystkie argumenty gościa.
P. Wyżga, oprac. N. Kamińska
Absolwentka dziennikarstwa na UW i UMCS. Pracowała w PAP i naTemat.pl, obecnie redaktorka WP Wiadomości. Interesuje się literaturą historyczną i reporterską oraz podróżami.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.