Uberはリトライストームからどのように身を守っているのか
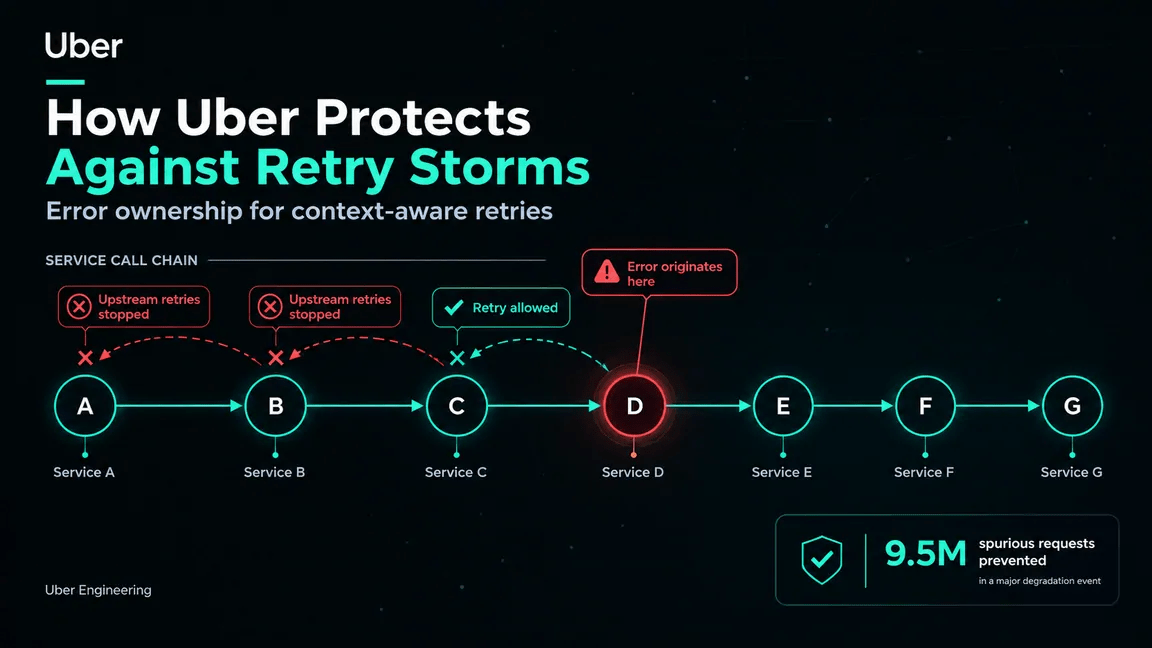
Uberのエンジニアリングチームは、複雑に絡み合うサービス間依存関係を持つシステムで発生する「リトライストーム」現象によりビジネス運用やブランド信頼が受ける悪影響に対処するため、「エラーオーナーシップ」という概念に基づいたソリューションを開発・実装しました。このアプローチは、単一のサービス障害が連鎖的な障害を引き起こし、システム全体に波及する「ドミノ効果」を防ぐことを目的としています。
How Uber Protects Against Retry Storms
https://www.uber.com/us/en/blog/protecting-against-retry-storms/
従来のリトライ設定やリトライバジェットは個々のサービスレベルでは効果的でしたが、複数のサービスにまたがる依存関係の深さやファンアウトパターンによるクロスサービス増幅の可視性をあまり考慮していなかったため、スタックの奥深くにある単一のサービス障害からインフラストラクチャを保護することが難しいという問題がありました。根本的な問題は、リトライの挙動がコンテキストを認識していないため、エラーが「サービス自体によって生成されたもの」なのか「単にサービスを介して伝播されたもの」なのかを区別できなかった点にありました。
結果として、リトライは条件付きではなく一律に適用されていました。リトライを一律に行うアプローチは一時的・低頻度な障害には有効であるものの深刻な障害時には逆効果となり、障害を加速させアップストリームの依存関係全体にリトライトラフィックを増幅させる「リトライストーム」現象が発生する可能性があり、ひいては局所的な障害がシステム全体に及ぶインシデントに急速にエスカレートし、エンドユーザーエクスペリエンスを著しく低下させる恐れがあります。
問題の背景を理解するために、単純な呼び出しチェーンを考えてみます。各ノードは受信したリクエストに対してダウンストリームをちょうど1回呼び出します。ノードAに到着するリクエストの総数を「Ƞ」とすると、推論によりどのノードもエラーにならない「定常状態」ではノードB~GのすべてがȠ個のリクエストを処理します。
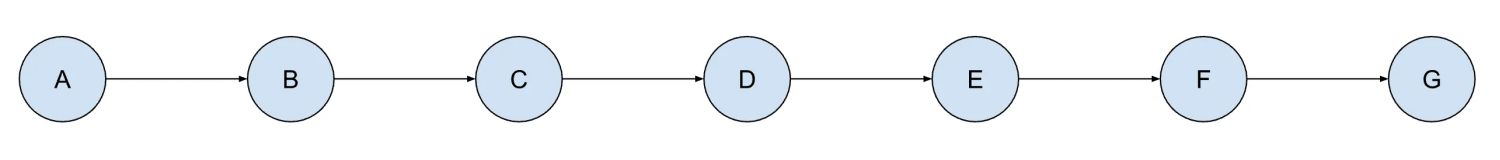
次にサービスDでエラーが発生し各サービスが1回再試行するように構成されている場合、1回のリクエストに対して通常の試行1回とダウンストリームが失敗した場合の再試行1回が発生します。
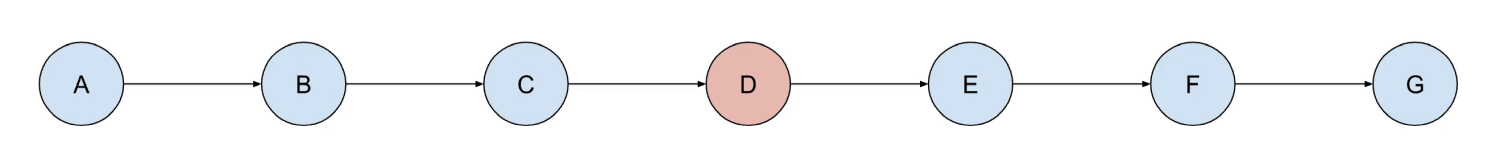
この場合、処理したリクエスト数は以下の表の通りとなります。
| ノード | A | B | C | D | E | F | G |
|---|---|---|---|---|---|---|---|
| 深さ | 0 | 1 | 2 | 3 | 4 | 5 | 6 |
| 処理したリクエスト | Ƞ | 2 × Ƞ | 4 × Ƞ | 8 × Ƞ | 8 × Ƞ | 8 × Ƞ | 8 × Ƞ |
各ノードでの再試行回数「R」が同じであると仮定すると、処理したリクエスト数は単純な式「Rɗ × Ƞ」に集約できます。なお「ɗ」は呼び出しチェーンにおけるノードの深さ、つまりノードがエラーを生成または通過させた場合にノードが処理するリクエストの数を表します。
「リトライバジェット」を導入することで上記の式はさらに最適化することができます。「B」で表された各ノードで同じリトライバジェットがあると仮定すると新しい式は「(1+B)ɗ × Ƞ」となります。例えば再試行率を10%に設定すると、先程の表は以下の通りとなります。
| ノード | A | B | C | D | E | F | G |
|---|---|---|---|---|---|---|---|
| 深さ | 0 | 1 | 2 | 3 | 4 | 5 | 6 |
| 処理したリクエスト | Ƞ | 1.1 × Ƞ | 1.21 × Ƞ | 1.33 × Ƞ | 1.33 × Ƞ | 1.33 × Ƞ | 1.33 × Ƞ |
つまり、ノードDから末端ノードGまでのすべてのノードで処理されるリクエストの総数をベースラインの10%だけに制限しつつ、最初に返されたエラーの最大10%に対して少なくとも1回は再試行を許可しています。
では、ノードCから見たノードDの可用性はどうなるでしょうか?下の表はさまざまな可用性シナリオでリトライ後の可用性を計算してみた結果です。
| ベースの可用性 | ベースのエラー率 | リトライバジェット | リトライ後のエラー率 | リトライ後の可用性 |
|---|---|---|---|---|
| 99.9% | 0.1% | 10% | 0.0001% | 99.9999% |
| 99% | 1% | 10% | 0.01% | 99.99% |
| 95% | 5% | 10% | 0.25% | 99.75% |
| 90% | 10% | 10% | 1% | 99% |
| 80% | 20% | 10% | 12% | 88% |
| 70% | 30% | 10% | 23% | 77% |
上の表によれば、呼び出し先ノードの可用性が最大10%低下した場合でも、たった1回の再試行を行うだけで呼び出し元ノードから見た可用性を99%まで向上させることができます。
ただしここまでの計算は、呼び出し先からのエラーが互いに独立しており、再試行によって回復するという前提に基づいています。サービス過負荷・データベースホストの不具合・データベース過負荷・シャーディングの問題など、多くの現実世界のシナリオでは再試行を行っても再試行の確率は高いままです。つまり、サービスのエラーが多発する場合にはエラーは偶発的なものである可能性が低く、再試行回数を増やしても無意味であるどころか状況が悪化する可能性がある、ということです。
上記の問題を根底から解決するために導入された概念が「エラーオーナーシップ」であり、「症状」と「原因」のアナロジーで説明することができます。あるサービスがリクエスト処理のためにアウトバウンドコールを行い、そのうちの1つがエラーを返した場合、そのサービスがエラーを返したとしても単なる「症状」です。一方、サービスのアウトバウンドコールでエラーが起こっていないにもかかわらずサービスがエラーを返した場合、そのサービスこそがエラーの原因であるため、エラーの「オーナー」となります。
Uberは「サービス依存関係分析ソリューション」を使用してインバウンド障害とアウトバウンド障害を関連付け、エラーの「クレーム」または「アンクレーム」を行うためのルールセットを導入しました。
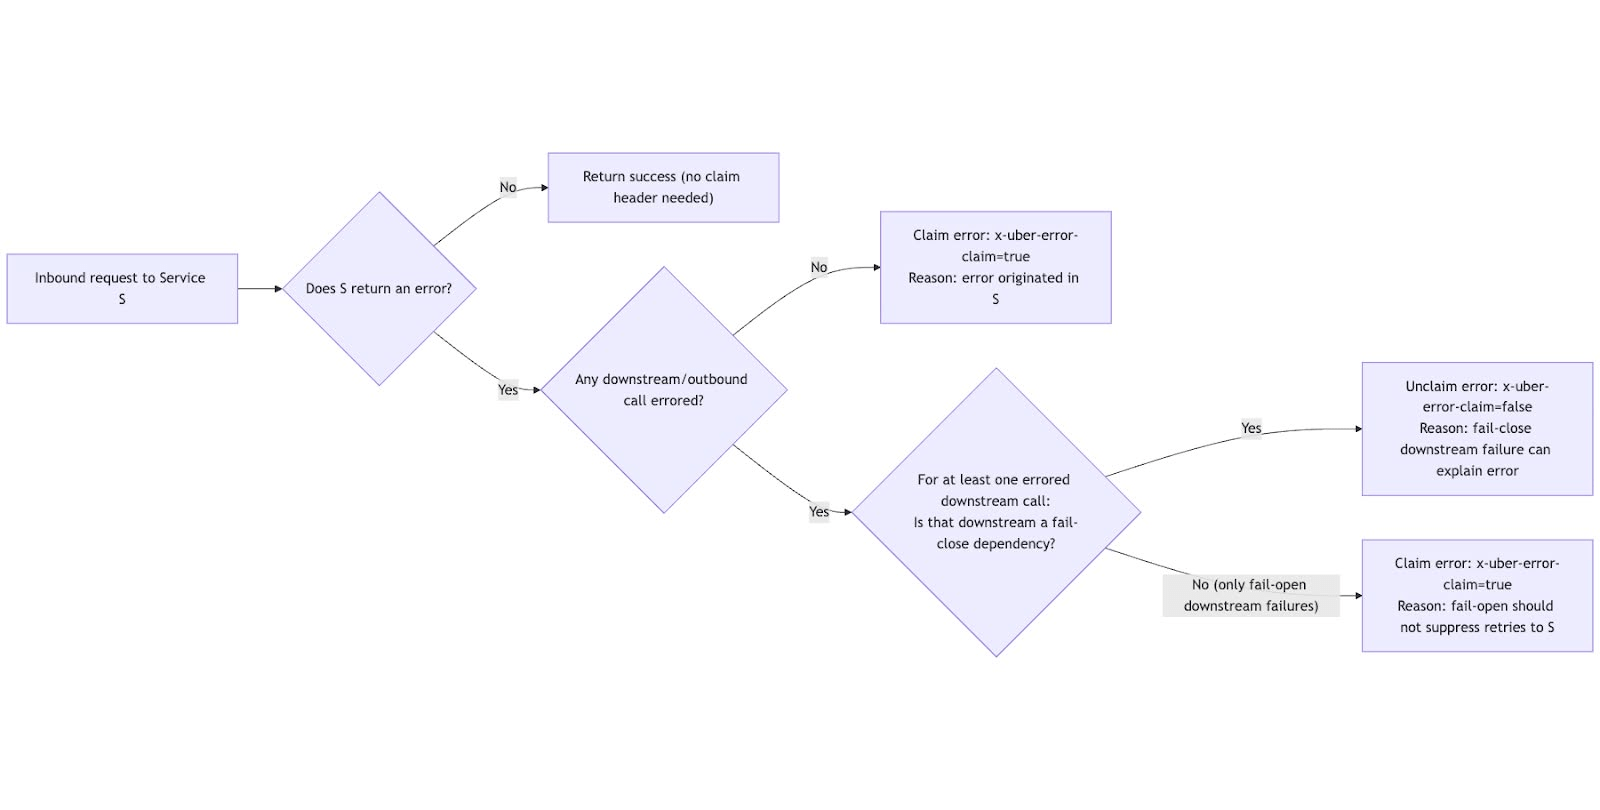
エラーオーナーシップが確立されると、呼び出し元サービスは下図に示すロジックに従いリクエストを再試行すべきかどうかを判断します。
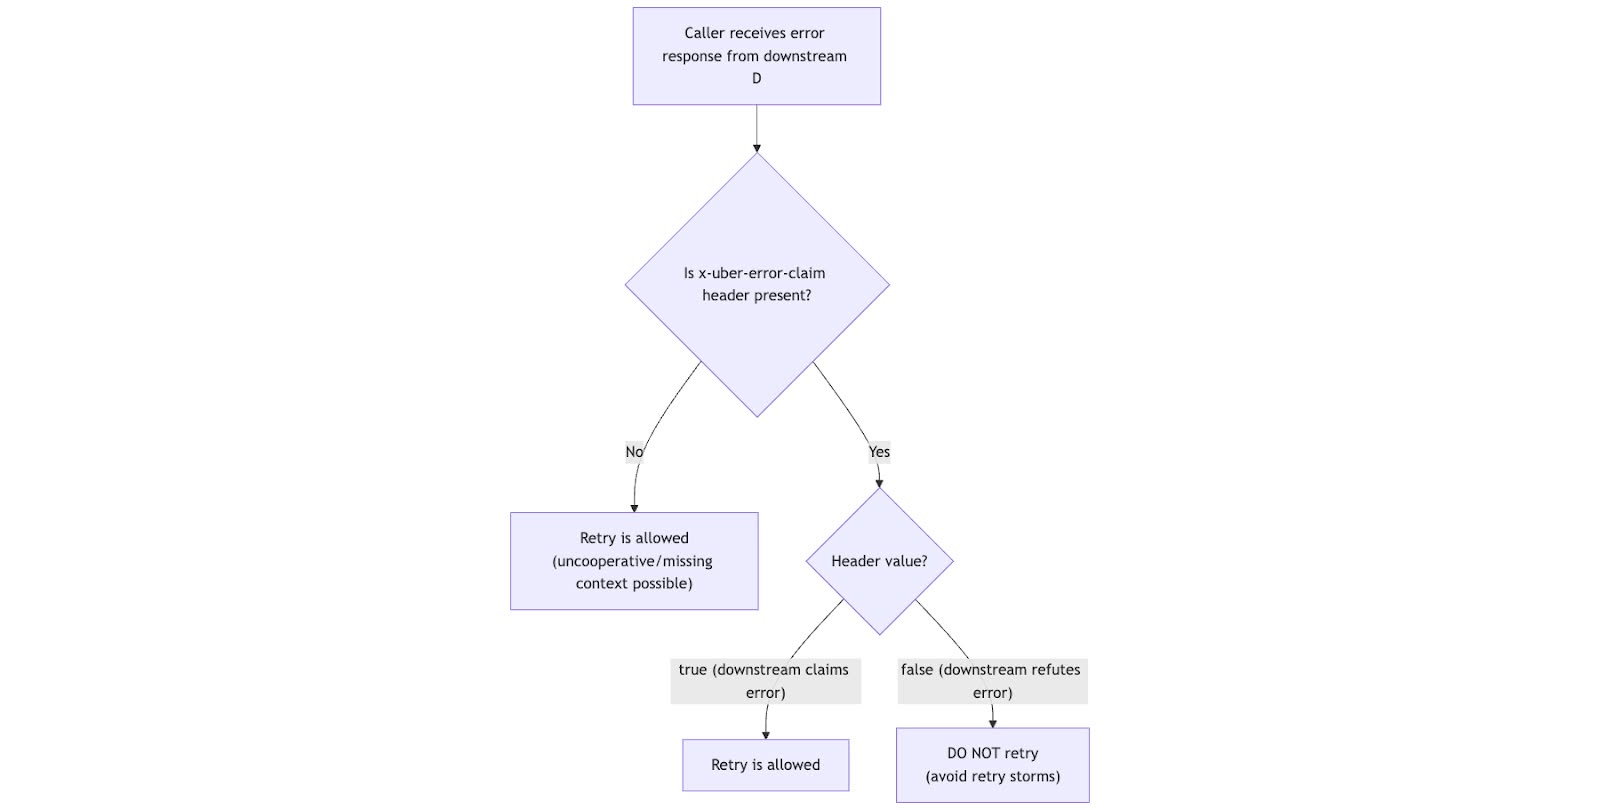
ダウンストリームサービスがサービス依存関係分析ソリューションを持たない場合、エラークレームヘッダーが欠落することがあるため、最初のエラークレームの欠落を検知したノードがエラーをアンクレームしてリトライのインパクト範囲を限定し、リトライストームを防ぎつつエラーを返したサービスへの十分なリトライを可能にします。エラーオーナーシップに基づいたリトライの可否は、以下の決定マトリクスで判断されます。
| ダウンストリームエラー | エラークレーム | リトライ |
|---|---|---|
| あり | 欠落 | 許可 |
| あり | クレーム | 許可 |
| あり | アンクレーム | 不許可 |
ただし、サービス自体の内部エラーとダウンストリームのエラーが同時に発生する「偶発的なエラー」シナリオでは、誤ってエラーがアンクレームされ本来行うべきリトライの機会が失われる可能性があります。このリスクに対処するため、サービス依存関係分析ソリューションはインバウンド障害がフェイルクローズ依存関係におけるアウトバウンド障害と相関する場合にのみエラーをアンクレームするように過去の障害パターンのメモリを活用し、偶発的なエラー発生時にリトライが抑制されるリスクを排除しています。
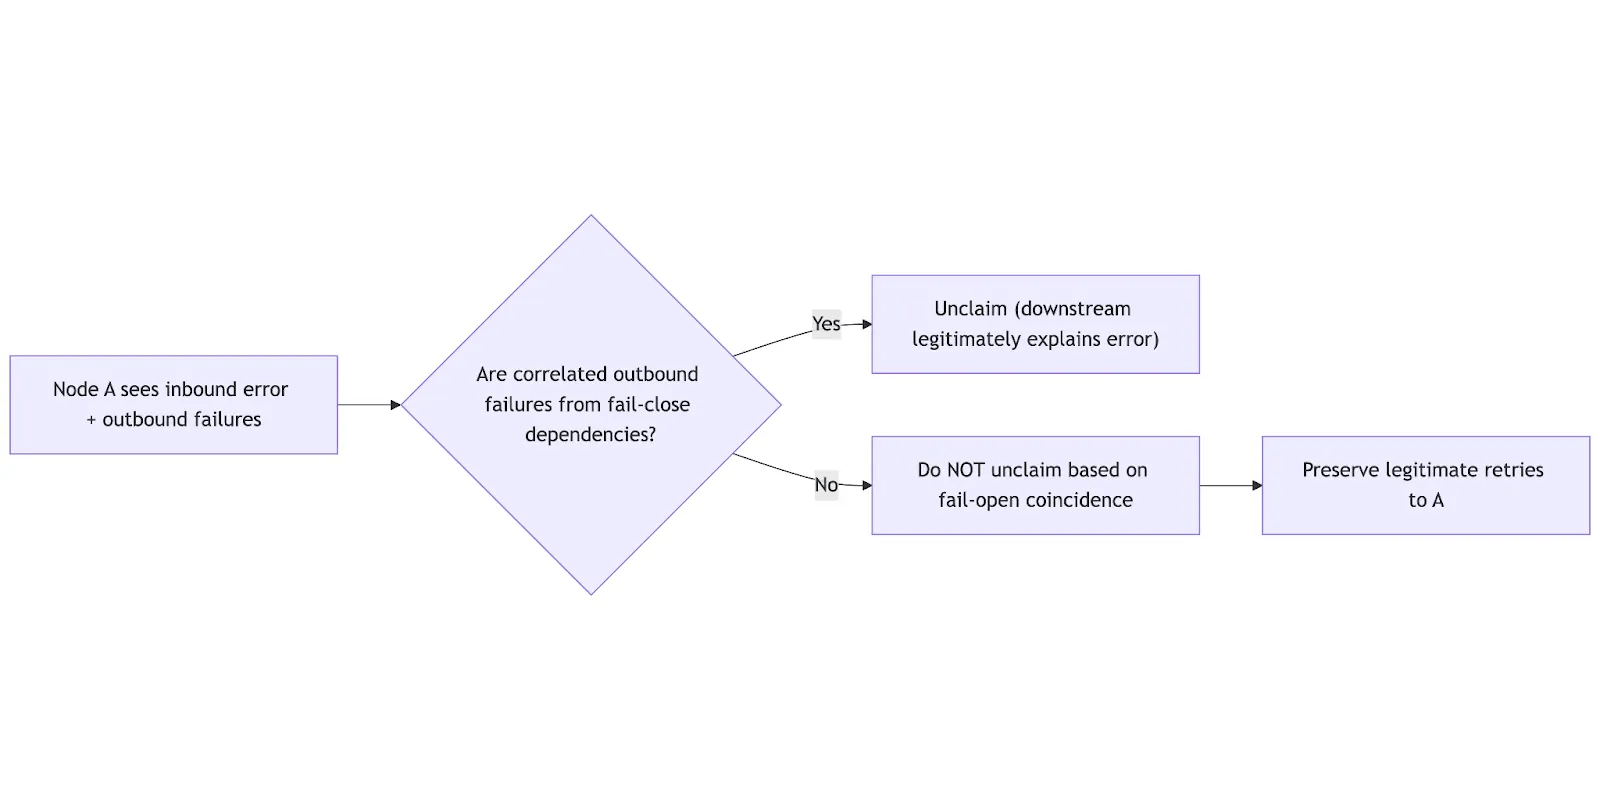
また、多くのサービスではフェイルクローズ発信時にリトライが設定されていません。そこでUberではリトライミドルウェアにフラグを導入して問題に対応しています。リトライ基準が満たされているかどうかを信号で伝達することにより、リトライミドルウェアはダウンストリームからエラーを受信すると、再試行条件が満たされているかどうかを計算し、その結果をサービス依存性分析ソリューションに通知します。
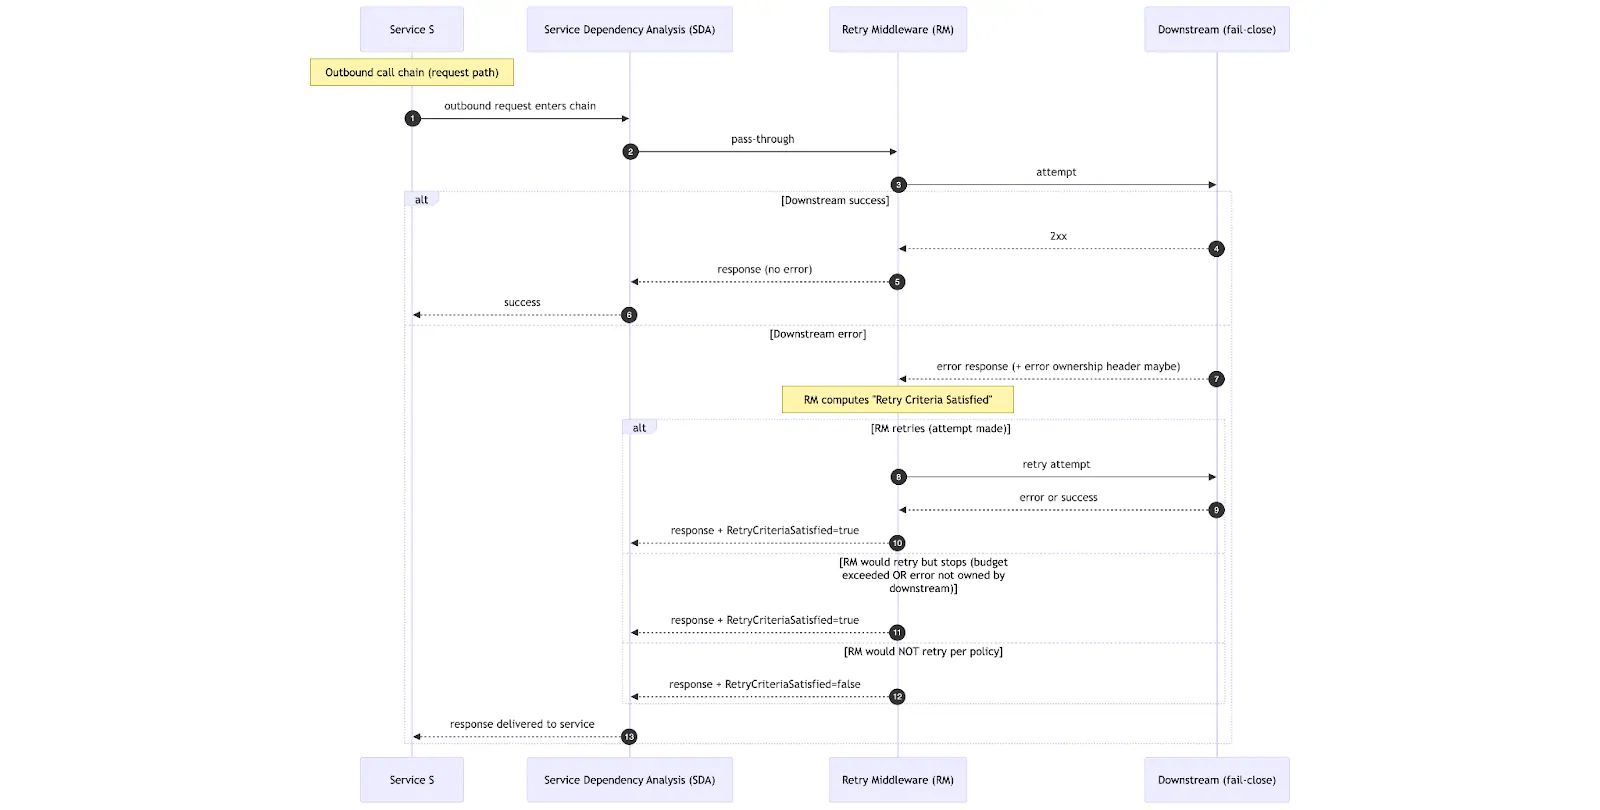
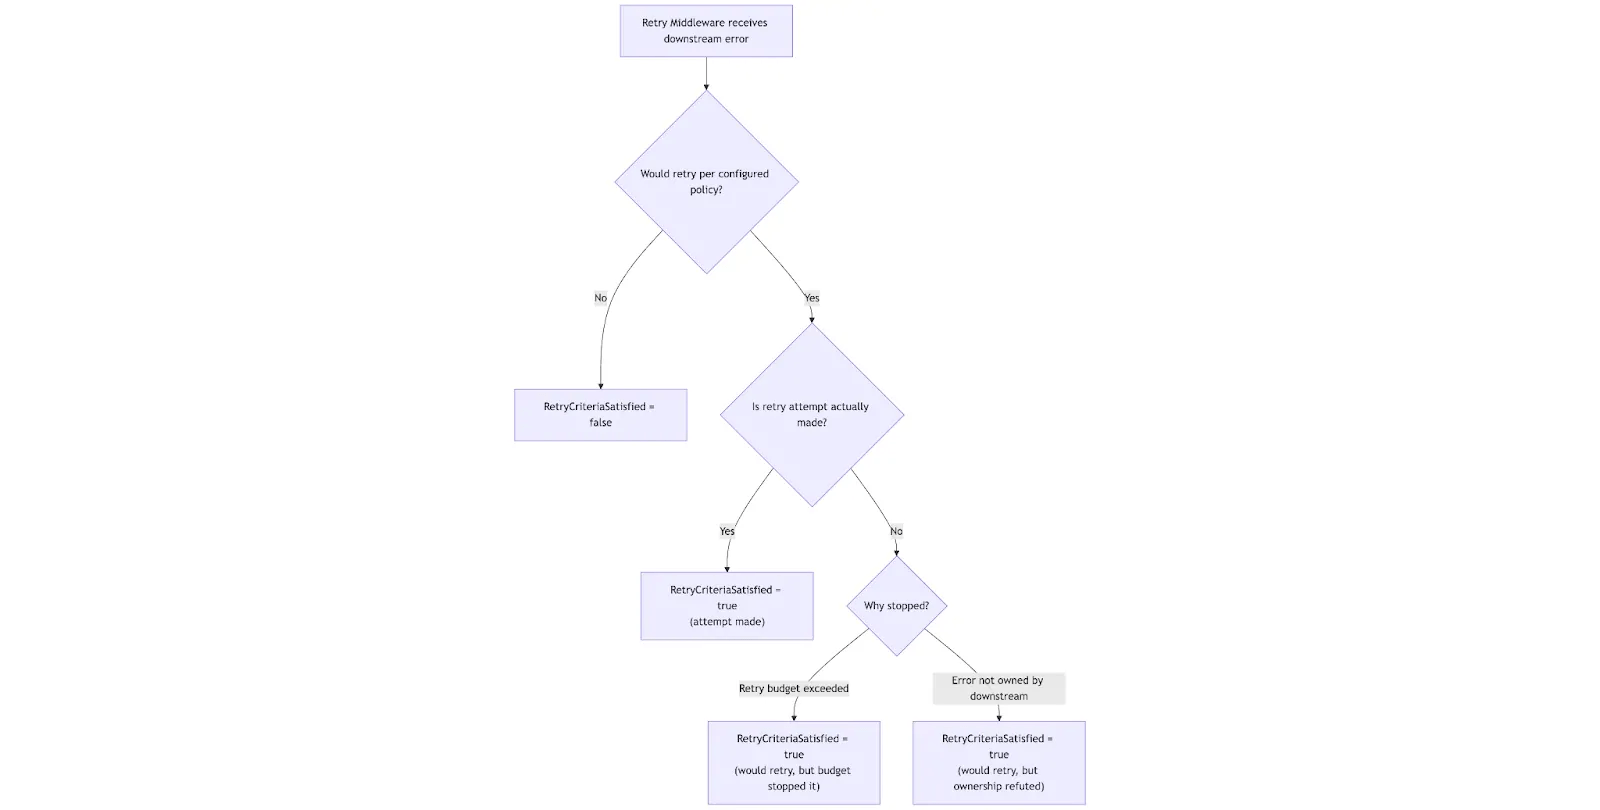
リトライミドルウェアは、下図に示されたいずれかの条件が満たされた場合にリトライ基準が満たされたとマークします。「at-least-onceリトライ」保証の導入によりコールチェーンにおける可用性の低下が排除され、同時にエラーオーナーシップを活用してリトライストームから保護されるようになりました。
エラーオーナーシップのメカニズムは理論上の話ではなく、既にUberのユーザー向けAPIのリクエストパスに配置されたリトライミドルウェアとサービス依存関係分析ソリューションで実装・運用されており、各サービスが個別のエラーハンドリングロジックを実装することなく、リトライストーム対策の恩恵を受けることができます。
2025年11月18日に発生した大規模障害の事例では、インフラストラクチャに起因する問題によりコアエンティティサービスが非常に高いエラー率を返しましたが、エラーオーナーシップが有効であったため、システムは自動的に影響範囲を封じ込めることができました。障害のあるサービスを直接呼び出していたサービスへのリトライ試行は停止され、一部の呼び出し元は最大20万件の追加リクエストを停止しました。さらに、直接の呼び出し元のさらに上流で停止されたリトライを集計した結果、950万件もの非正規なリクエストがサービスメッシュ全体で抑制されたことが判明しました。
エラーオーナーシップアプローチにより、Uberは障害イベント発生時のコールグラフを流れる総リクエスト量を劇的に削減しました。定量化のためリトライストームが発生する可能性のある呼び出しパスの深度を「リトライストーム半径」と定義すると、エラーオーナーシップ導入後の最大リトライストーム半径は、ユーザー向けAPI全体で最大値が25から3に、平均値も20から2にまで大幅に低下しました。
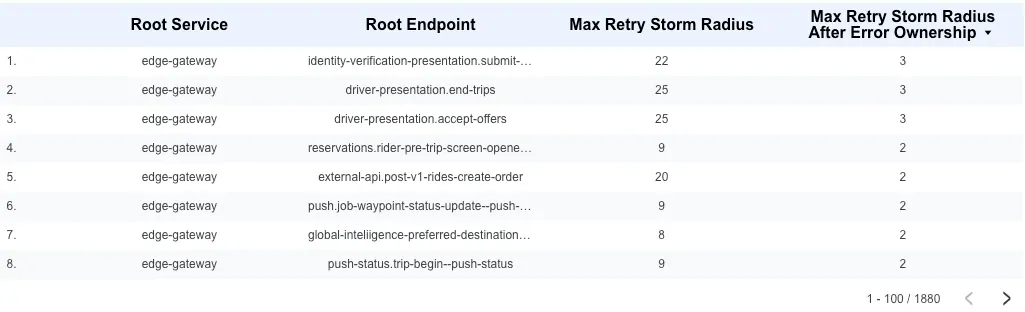
エラーオーナーシップを持つサービス、すなわち実際に問題を解決できる可能性のあるサービスにのみリトライを限定することにより、リトライストームの特徴であるリクエストの指数関数的な拡散を防ぎ、単一点の障害によって引き起こされる連鎖的な障害からUberのインフラストラクチャを保護することに成功しました。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.