Как я сделал Report Slides для еженедельных отчётов из CSV в PowerPoint
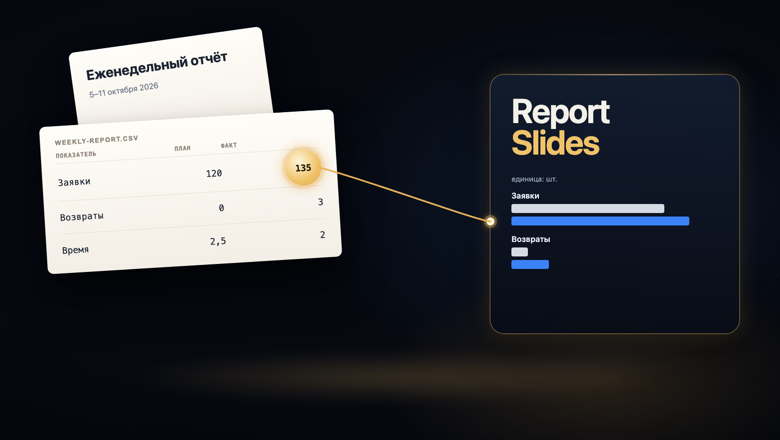
Мне каждую неделю нужно обновлять один и тот же отчёт: план и факт из Excel переносить в PowerPoint. Числа, дату, подписи. Макет почти не меняется, а править приходится руками. На слайде легко оставить прошлое значение. У диаграммы после замены чисел может уехать шкала.
Для этого я сделал Report Slides. Локальная программа на Python. Лист сохраняется как CSV, загружается в браузер, прочитанные числа можно сверить, затем указать период и скачать обычный PPTX. Файл открывается в PowerPoint и правится там. Модель и ключ не нужны. Программа сама отчёты на диск не пишет и слушает только 127.0.0.1.
Дальше — как это собрано.
Что вошло в первый релиз
Один файл, от 1 до 12 показателей, один светлый шаблон 16:9. Название, период и комментарий задаются в форме, не в CSV. Слайды собираются из данных: сначала титул, потом таблицы, потом графики по единицам.
Порядок работы:
Сохранить лист как CSV UTF-8.
Загрузить и сверить прочитанные значения.
Указать период. Комментарий — если нужен.
Скачать PowerPoint.
На следующей неделе загружается новая таблица. Оформление повторяется, потому что шаблон вшит в программу.
Ручные правки скачанного PowerPoint следующий экспорт не подхватывает. Новая презентация снова собирается из CSV и полей формы. Первый релиз не редактирует произвольный корпоративный PPTX.
Из чего состоит
Файла три.
app.py       форма и то, что сейчас на экране
data.py      разбор CSV и расчёты
slides.py    сборка PPTX
Сначала программа читает CSV. Потом показывает, что получилось. По кнопке собирает презентацию и отдаёт байты файла.
Строку отчёта я храню целиком: как называется показатель, какой был план, какой факт и в чём он измеряется. Отклонение и процент отдельно не записываю. Они считаются в момент, когда их нужно показать. Иначе легко получить новую таблицу и старое отклонение рядом.
Сборке презентации всё равно, из какой формы пришли данные. Поэтому файл можно собрать в тесте, без браузера. Проверять, что функция просто что-то вернула, здесь мало: нужен настоящий PPTX.
Библиотеки три: streamlit==1.65.0, python-pptx==1.0.2, XlsxWriter==3.2.9. CSV и счёт идут из стандартной библиотеки. Нужен Python 3.11 или новее.
Базы нет. Очереди нет. Строк мало, файл собирается сразу по кнопке.
Как читается CSV
В файле четыре колонки, всегда в одном порядке.
показатель;план;факт;единица
Заявки;120;135;шт.
Выручка;250000,50;275000,75;руб.
Время ответа;2,5;2;ч
Возвраты;0;3;шт.
Разделитель человек выбирает сам: точка с запятой или запятая. Я его не угадываю. Если колонки разделены запятой, а в числе тоже запятая, число нужно взять в кавычки. Excel при сохранении обычно делает это сам.
Заголовок можно написать в любом регистре. Пробелы по краям не считаются.
Дальше ограничения:
Что | Как проверяю |
|---|---|
Файл | UTF-8, BOM можно, не больше 262 144 байт |
Строки | от 1 до 12, имена не повторяются даже при разном регистре |
Имя показателя | до 60 символов |
Единица | до 16 символов |
План и факт | от −1 000 000 000 до 1 000 000 000, не больше двух знаков после запятой |
Текст | без таба и перевода строки: он потом попадёт в XML |
Размер смотрю по байтам файла, а не по настройке загрузчика в браузере.
Другую кодировку не пробую. Если файл не UTF-8, прошу сохранить CSV заново. BOM от Excel снимаю через utf-8-sig, иначе он прилипает к слову «показатель».
Перед обычным разбором я отдельно проверяю кавычки. Стандартный парсер для этого отчёта слишком всеядный. Кавычка внутри поля без экранирования — ошибка. Пробел перед открывающей кавычкой — тоже ошибка, и текст у неё другой. Перевод строки CRLF считаю одним, не двумя.
Потом уже csv.reader с strict=True. Свой парсер целиком писать не стал.
Таб и перевод строки проверяю до strip(). Иначе имя с переводом строки на краю станет обычной строкой, а сообщение об ошибке пропадёт.
Если сломана одна строка, весь файл отклоняется. Кривую строку не выкидываю и ноль вместо неразобранного числа не подставляю. В коротком отчёте пропавшая строка меняет смысл встречи.
Что писать в ошибке
«Некорректное число» бесполезно. Человек смотрит в Excel и не понимает, что чинить.
В сообщении есть номер строки и поле. Если причина понятная, пишу, что сделать.
250 000,50 — это пробел между разрядами. Ловлю обычный пробел, неразрывный и узкий. Прошу выключить разделитель групп в формате ячейки и сохранить CSV ещё раз.
25% не отрезаю. Прошу написать 25, а процент поставить в колонку единицы. Лишние колонки тоже не отрезаю молча: пишу, сколько их нашлось, и прошу убрать лишние справа на листе.
Пробелы внутри числа не вычищаю. Знак процента не откусываю. Если программа сама «поправит» файл, она может поменять смысл. Пусть решает человек.
Как считаются числа
Формулы две.
отклонение = факт − план
отношение = факт / план × 100
Процент считаю только если план больше нуля. Ноль или минус: в ячейке тире. Делить математика позволяет, но что значит такой процент, без договорённости непонятно. Показываю исходные числа и отклонение.
Числа сразу становятся Decimal. Промежуточного float нет. Сначала проверяю пробелы, хвост % и форму числа. Потом меняю запятую на точку.
Процент округляю до одного знака, половина вверх. 1 / 16 × 100 даёт 6,3, не 6,2. Считаю внутри localcontext() с точностью 28, чтобы другой код в том же процессе не подсунул свой decimal-контекст.
В файле это выглядит так:
@property
def ratio(self):    if self.plan <= 0:        return None    with localcontext() as context:        context.prec = 28        ratio = (self.actual / self.plan * 100).quantize(            Decimal('0.1'), rounding=ROUND_HALF_UP)        return ratio.copy_abs() if ratio == 0 else ratio
Последняя строка убирает отрицательный ноль. После округления маленькое отрицательное отношение может стать −0. На слайде −0,0 выглядит как ошибка программы.
Если единица %, число 25 так и остаётся 25, в том числе на диаграмме. Процентный формат Excel здесь нельзя ставить: он умножит на 100 и покажет 2500%.
Общий процент по всему отчёту не считаю. Заявки, рубли и часы складывать нельзя. Цвет на графике показывает, где план, а где факт. Это не оценка «хорошо» или «плохо»: рост возвратов и падение времени ответа одной краской не различить.
Сколько получится слайдов
На одну таблицу беру не больше четырёх строк. На график тоже не больше четырёх, но сначала группирую строки по единице.
В образце четыре строки и три единицы. Слайдов пять: титул, одна таблица, график штук с заявками и возвратами, отдельно выручка, отдельно время ответа.
Группы идут в том порядке, в каком единицы первый раз встретились в файле. Внутри группы порядок строк сохраняется. Регистр новую группу не создаёт. руб., ₽ и рублей не склеиваю: получатся три графика. Словарь синонимов не писал. На третьем спорном написании он начнёт объединять то, что в таблице разделили специально.
Число слайдов можно посчитать заранее:
1 + ceil(число строк / 4) + сумма ceil(размер группы / 4)
Двенадцать строк одной единицы — семь слайдов. Двенадцать разных единиц — шестнадцать. Состав показываю до кнопки, чтобы длинный список единиц был виден сразу, а не после открытого файла.
Почему график не картинка
Картинку нарисовать проще. Число внутри неё через «Изменить данные» уже не поменять.
Поэтому текст остаётся текстом, таблица — таблицей PowerPoint, а график — обычной горизонтальной диаграммой BAR_CLUSTERED из python-pptx. Серий две: план и факт. Как библиотека собирает диаграмму, написано в её документации.
PPTX — это zip с XML. У диаграммы есть кэш чисел в XML и встроенная книга Excel. В обеих копиях должны лежать те же числа. Иначе полоска показывает одно, а «Изменить данные» открывает другое. То, что save() прошёл, такую ошибку не ловит.
До диаграммы считаю на Decimal. В саму диаграмму библиотека принимает float. К этому моменту деление и округление уже сделаны. Говорить, что весь файл хранит любую десятичную точность, нельзя. Числа и так ограничены: не больше двух знаков после запятой и в заданных границах. Тесты читают кэш и книгу и сверяют их с исходным числом до сотой. Проверял в том числе 0.01, 0.29 и 999999999.99.
Если показатель называется =1+1
Для отчёта это текст. Для XlsxWriter строка, которая начинается с =, по умолчанию формула. Ссылка по умолчанию становится гиперссылкой. Оба поведения включены, пока их явно не выключить. Это описано в параметрах Workbook.
Встроенную книгу я собираю сам и оба флага выключаю:
with Workbook(output, {    'in_memory': True,    'strings_to_formulas': False,    'strings_to_urls': False,
}) as book:    ...
Имена пишу через write_string, числа через write_number.
in_memory=True здесь не для красоты. У XlsxWriter своя промежуточная сборка. Одного BytesIO снаружи мало: временный файл всё равно появится.
Тесты открывают PPTX, находят внутри XLSX и проверяют, что нет формул, гиперссылок, внешних связей и макросов. И что текст категории остался тем же. Снаружи две полоски. Внутри проверяю, что чужой текст остался данными.
Как посчитал шкалу
Автошкала на разных наборах вела себя по-разному. Десятые, сотые, большие числа, одни минусы, все нули. Мне нужно было одно и то же поведение: ноль остаётся на оси, а деления после формата не превращаются в одинаковые подписи.
Возьмём одно ненулевое значение 0.01. Ноль уже входит в диапазон. К ненулевому краю добавляю 30%, чтобы у конца полосы было место для подписи. Верх становится 0.013. Черновой шаг на четыре интервала — 0.00325.
Шаг округляю вверх к 1, 2 или 5, умноженным на степень десяти. 10 × 10ⁿ тоже есть среди кандидатов: это уже следующий порядок. Мельче 0.01 шаг не беру. Подписи показывают два знака, и более мелкие деления после формата выглядят одинаково. Если интервалов получилось меньше трёх, диапазон растягиваю. Для 0.01 выходит шкала от 0 до 0.03.
Если все числа нули, шкала от 0 до 1, подписи 0. Полоски нулевой длины, сами нули видны.
Если все числа отрицательные, верх шкалы заканчивается нулём. Если есть и плюс, и минус, ось охватывает обе стороны. Цвет минуса не меняю: синий факт не должен стать другим цветом только потому, что число ушло ниже нуля.
Одна шкала на 0.01 и на миллион сделает короткую полосу почти невидимой. Группировка по единицам убирает сравнение рублей с часами, но внутри одной единицы разброс остаётся. Точное число есть в подписи и в таблице.
Длинные подписи
Имя показателя может быть 60 символов, единица — 16. На титуле название до 100 символов, период до 60, комментарий до 400 символов и не больше шести непустых абзацев.
На коротком примере почти любой макет выглядит нормально. Если заполнить лимиты широкими буквами, подпись залезает на полосу.
Имена категорий я вынес в отдельные текстовые блоки слева от графика. Подписи оси спрятал. Область построения задал через c:manualLayout, чтобы текст стоял напротив своих полос. Шрифт не уменьшаю: в таблице 16 пунктов, на графике 14. Макет должен выдержать разрешённую длину, а не длину «обычно короче».
За это есть неудобство при правке. В книге Excel лежит полное имя. Подпись слева — другой объект. Переименовали категорию в Excel — подпись на слайде сама не изменится. Числа правятся как обычно, через «Изменить данные».
У комментария другая проблема: пустые строки. Шесть непустых абзацев не мешают вставить между ними тридцать пустых. Перед размещением пустые абзацы убираю, иначе текст уедет за край титула.
Таб в комментарии можно. В названии и периоде нельзя. Шаг табуляции привязал к размеру шрифта. Обычные полдюйма на длинной строке слишком быстро съедают ширину.
Есть ещё одна вещь, которую легко пропустить. У презентации есть не только видимые слайды, но и мастера, макеты и тема. Если поменять только размер слайда, новые страницы станут 16:9, а элементы старого макета останутся посчитанными на прежнюю ширину. Человек добавит слайд «Title and Content», и заполнитель окажется не там.
В configuretemplate ставлю 13⅓ × 7,5 дюйма и пересчитываю горизонтальные координаты и ширины у мастеров и макетов. Латинский шрифт темы — Arial. На видимых объектах шрифт задан явно. Тест добавляет страницу из макета и проверяет, где стоят заполнители.
Даты и описание из шаблона библиотеки в файл не оставляю. Пишу текущее время UTC, название отчёта, имя программы, число слайдов и формат экрана.
Это уже внутренний XML python-pptx. Версия закреплена, тесты читают те же части пакета. Обновлять библиотеку вслепую нельзя: save() может не измениться, а геометрия макета изменится.
Кнопка «Скачать»
Собрал PPTX. Загрузил новую таблицу. Импорт упал. А кнопка всё ещё отдаёт прошлый файл.
Ничего не сломалось. На встречу уедет неделя, которую уже заменили.
Поэтому старый файл убираю, как только изменились данные или текст отчёта. Сравниваю две вещи.
Что изменилось | По чему понимаю |
|---|---|
Файл | имя, SHA-256 байтов и выбранный разделитель |
Текст отчёта | название, период, комментарий |
Одинаковое имя файла не значит, что внутри те же цифры. Для этого и нужен хеш.
Сменился файл — старые строки и PPTX убираю до нового разбора. Сменился только разделитель — период и комментарий оставляю, данные читаю заново, старый PPTX убираю. Поменяли название, период или комментарий — старый PPTX тоже убираю. Он уже не про эти поля.
Если повторная сборка с теми же данными упала, прошлый успешный файл остаётся. Он этим данным ещё соответствует. Если вход изменился, так не делаю. Кусок нового файла старый не подменяет.
Состояние лежит в st.session_state. У Streamlit правка поля заново запускает сценарий, а callback срабатывает раньше. Этот порядок описан в документации Session State. Загрузку, правку полей и экспорт пришлось разбирать как переходы, которые эти повторы переживают.
Для нового CSV есть отдельная кнопка. Она сразу убирает результат, чистит период и комментарий и сбрасывает загрузчик. Название отчёта не трогает.
Зачем кнопка, если есть событие загрузки? Слишком большой файл браузер может отклонить ещё до того, как программа увидит байты. После «Загрузить новый CSV» старый отчёт уже снят с экрана, даже если следующий файл не пройдёт.
Ошибки полей показываю после правки конкретного поля. На первом открытии пустой период красным не крашу. Кнопка сборки при этом сразу неактивна.
Где это запускается
Сервер слушает 127.0.0.1:8504. Сбор статистики Streamlit выключен. Интернет нужен, чтобы поставить зависимости. Загрузка, просмотр и сборка наружу не ходят. В прогнанном браузерном сценарии внешних запросов не было.
CSV и готовый файл живут в текущей сессии. Истории нет. На диск отчёты не пишу: сохраняет браузер, когда человек нажал скачать. Обновили страницу или перезапустили программу — сессию не обещаю.
Это один человек и одна вкладка. Поменять адрес на 0.0.0.0 и назвать это сервисом рано. Доступ, срок жизни данных и лимиты ещё не продуманы.
Если сборка упала, введённое остаётся на экране. Человек видит короткое сообщение и может нажать ещё раз. В журнал пишу traceback и хеш CSV. Текст исключения перед логом заменяю нейтральной фразой: внутри сообщения могут оказаться пользовательские числа. asyncio.CancelledError не глотаю, пробрасываю дальше.
Хеш нужен, чтобы связать сбой с файлом. Анонимным он файл не делает.
Что я успел проверить
Мало проверить, что функция вернула непустой bytes. Даже чтение тем же python-pptx, который файл записал, отвечает не на все вопросы.
Сейчас 58 тестов на unittest.
Разбор и расчёты: BOM, оба разделителя, кавычки, разные переводы строк, ровно 262 144 байт и байт сверху, 12 строк проходят, 13-я нет, границы чисел, Unicode, округление до 6,3, отрицательный ноль.
PPTX: настоящие таблицы и диаграммы, кэши, книги, текст как есть, нет формул и внешних связей, тема, макеты, метаданные.
Интерфейс проверял через Streamlit AppTest: замена и сброс CSV, ошибки полей, разные сессии, отказ сборки. Отдельно гонял Playwright по уже запущенному приложению. Скачивал PPTX, выгружал снова с другим числом, сбрасывал отчёт, загружал CSV с NaN и проверял, что старая кнопка скачивания не осталась.
14 октября 2026, macOS, Python 3.11 и 3.14: 58 из 58. Подробности в журнале приёмки.
Глазами смотрел пять наборов, 37 слайдов. Обычный пример, длинные подписи, много единиц, отрицательные и нули, комментарий с пустыми абзацами. LibreOffice перегнал это в PDF. Обрезок на этих страницах не увидел.
В Microsoft 365 на Windows файл ещё не открывал. Открытие без восстановления, правка текста, ячейки и данных диаграммы, сохранение и повторное открытие — отдельная проверка. Рендер LibreOffice её не заменяет. Экранный диктор тоже не проходил. Команды для Windows есть в README. На Windows я их не запускал.
Как запустить
На macOS или Linux, из каталога проекта. Нужен Python 3.11 или новее.
python3 -m venv .venv
.venv/bin/python -m pip install -r requirements.txt
.venv/bin/python -m streamlit run app.py --server.address 127.0.0.1 --server.port 8504 --browser.gatherUsageStats false
Откройте http://127.0.0.1:8504. Можно скачать образец, загрузить его обратно, оставить разделитель ; и вписать период. Получится пять слайдов. Свой отчёт я бы нёс уже после того, как этот файл открылся в вашем PowerPoint.
Проверки запускаются отдельно:
.venv/bin/python -m unittest discover -s tests -v
Свой CSV с другими колонками или с тринадцатой строкой придётся привести к этому формату. XLSX, PDF и готовый PPTX программа не читает. Редактора макетов нет. Текст комментария она сама не пишет.
После скачивания остаётся обычный PowerPoint. Текст можно поправить, ячейку тоже, число на диаграмме — через «Изменить данные».
На реальных людях время не мерил. «Лучше других инструментов» писать не буду. В репозитории есть план короткого пилота. Для решения, развивать ли это, он полезнее одного удачного файла.
Если задача знакомая, попробуйте на небольшой обезличенной таблице. Сначала образец, потом свой файл. Лицензия MIT, код короткий: расчёт и экспорт можно прочитать и переделать.
Report Slides на GitHub — программа, запуск и код.
Рядом лежат пример CSV, техническое задание и сценарий пилота. Если формат окажется неудобным или макет разъедется на ваших подписях, это полезный issue: обезличенный CSV, на котором видно, что менять следующим.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.