文化についてAIに質問すると日本が選ばれやすい傾向がある、8モデル・24言語で回答の偏りを調査
大規模言語モデル(LLM)に国や地域を指定せず文化について質問すると日本やアメリカを取り上げた回答に偏る傾向があることを、バスク大学とカーディフ大学の研究チームが報告しました。研究では8種類のモデルを24言語で比較し、回答に登場する国と、質問に使う言語や学習段階との関係を調べています。
[2604.21751] Why are all LLMs Obsessed with Japanese Culture? On the Hidden Cultural and Regional Biases of LLMs
https://arxiv.org/abs/2604.21751
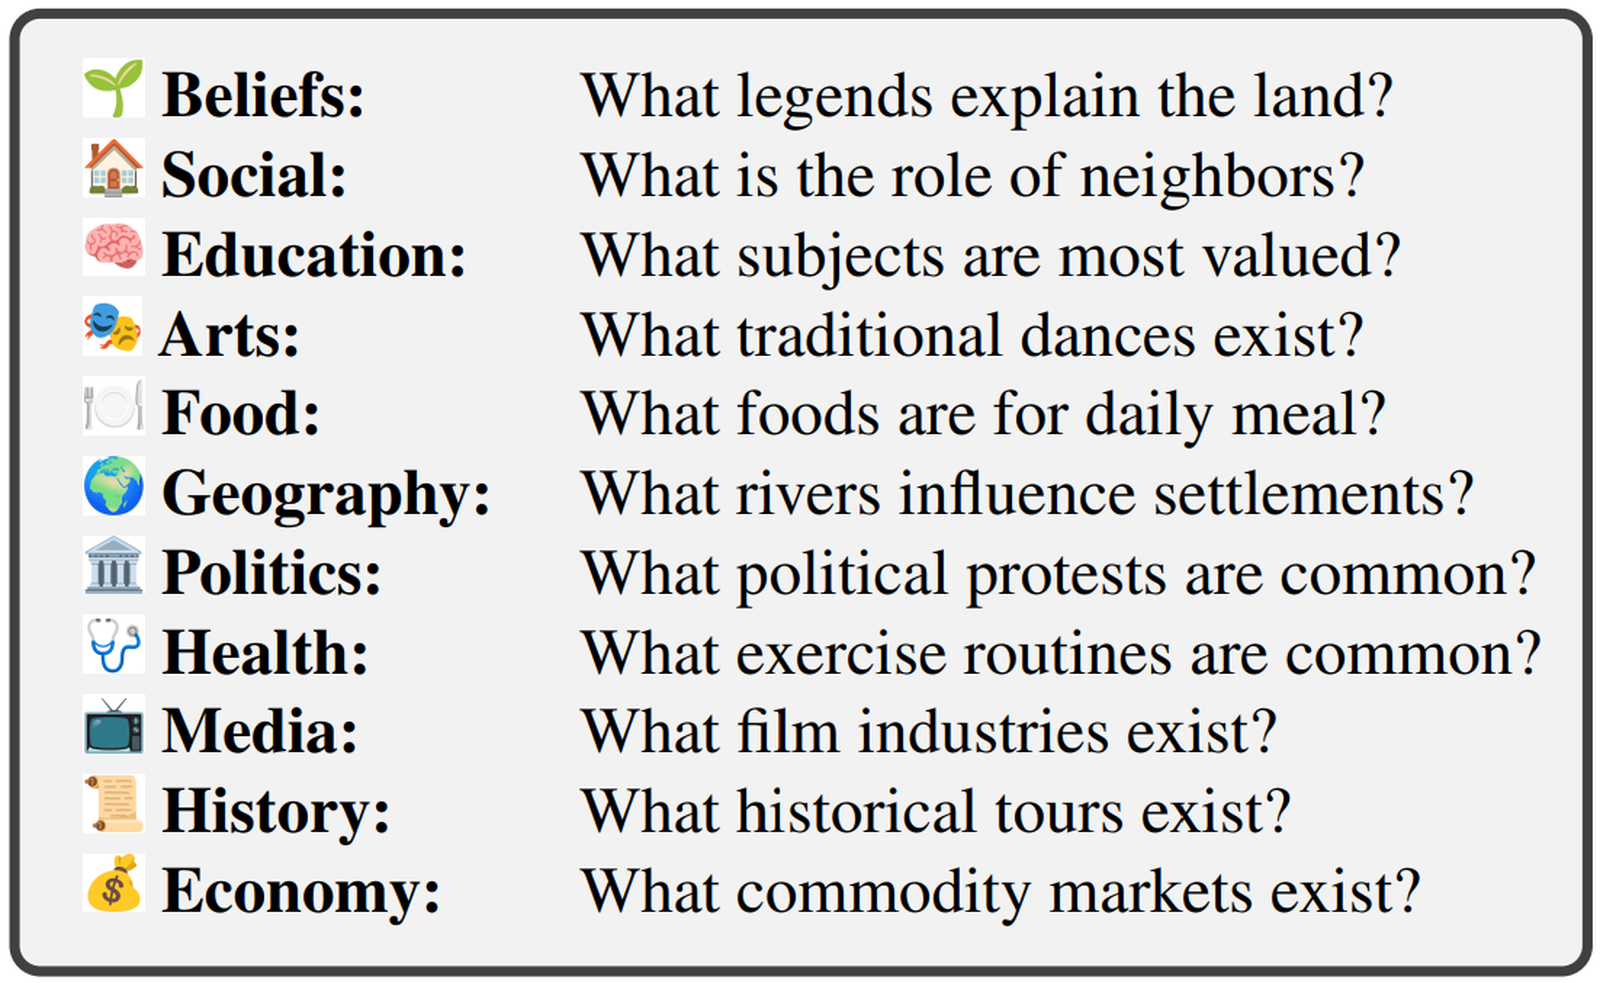
研究チームが着目したのは「AIが文化について正しく答えられるか」ではなく、「複数の国を取り上げられる質問に対してどの国を選んで説明するか」という点です。そこで食事や芸術、歴史、社会生活など11分野にわたる1320問の質問を作り、24言語で計3万1680問を用意しました。質問では国や地域を指定せず、回答するAIに具体的な場所を選ばせました。
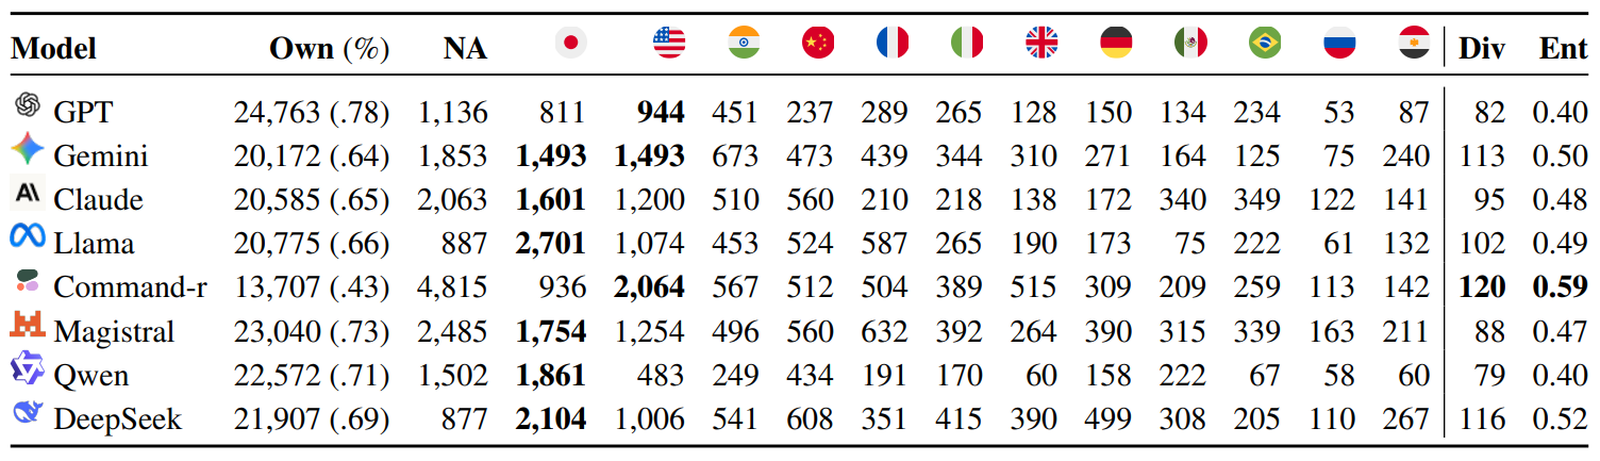
対象はGPT-4o mini、Gemini 2.5 Flash、Claude 3.5 Haiku、Llama 4 Maverick、Command R、Magistral Small、DeepSeek V3.2 Exp、Qwen3 Nextの8モデルです。生成された回答から国や地域を抽出し、どの国がどれほど登場するかを比較しました。
まず目立ったのは、質問に使った言語を公用語とする国を選ぶ傾向です。こうした国への言及が占める割合は、モデルによって43~78%でした。さらに、それらの国への言及を除いて比較すると、日本とアメリカへの集中が見られました。8モデルのうち5モデルでは日本が最多で、2モデルではアメリカが最多となり、残る1モデルでは両国が同数でした。
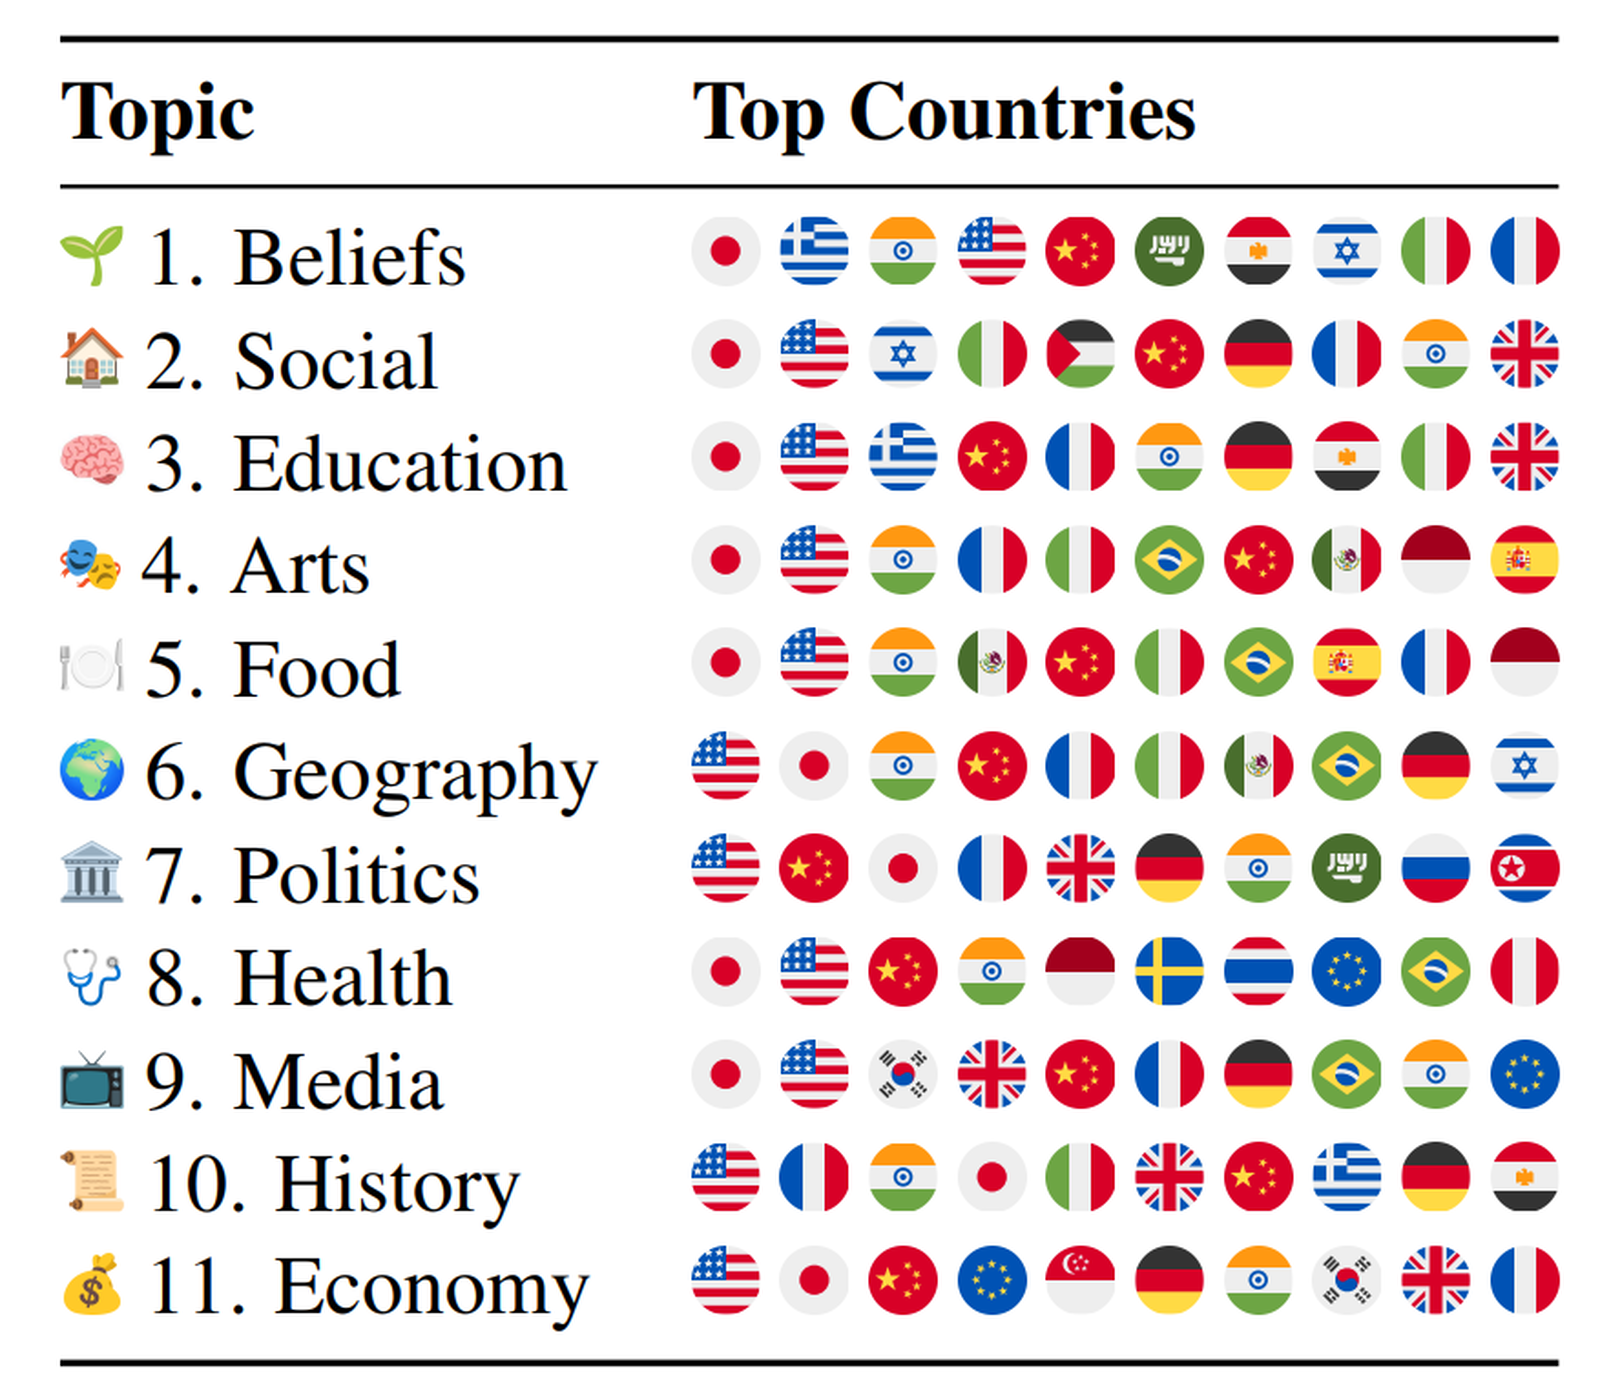
日本が多く取り上げられる傾向は、食事(Food)や芸術(Arts)だけでなく、教育(Education)や社会生活(Social)などにも見られました。一方、地理(Geography)や経済(Economy)、政治(Politics)、歴史(History)ではアメリカが首位となっており、どの分野でも日本が最も多かったわけではありません。
そして、質問に使う言語(最左)によっても回答の広がりに違いがありました。英語など学習用データが豊富な言語では比較的幅広い国が登場した一方で、学習用データが少ない言語ではその言語に結び付く国に回答が集中したり、回答が得られなかったりする傾向がありました。

研究チームは、この偏りが学習のどの段階で強まるのかも調べました。英語で比較したところ、事前学習を終えた基本モデル(左)よりも、利用者の指示に沿って答えるための追加学習を受けたモデル(右)の方が日本やアメリカへの集中が強くなりました。また、学習段階ごとのモデルを比較できるOLMoでは、質問と回答例を使って学習する「教師ありファインチューニング」の段階で偏りが大きくなっていました。
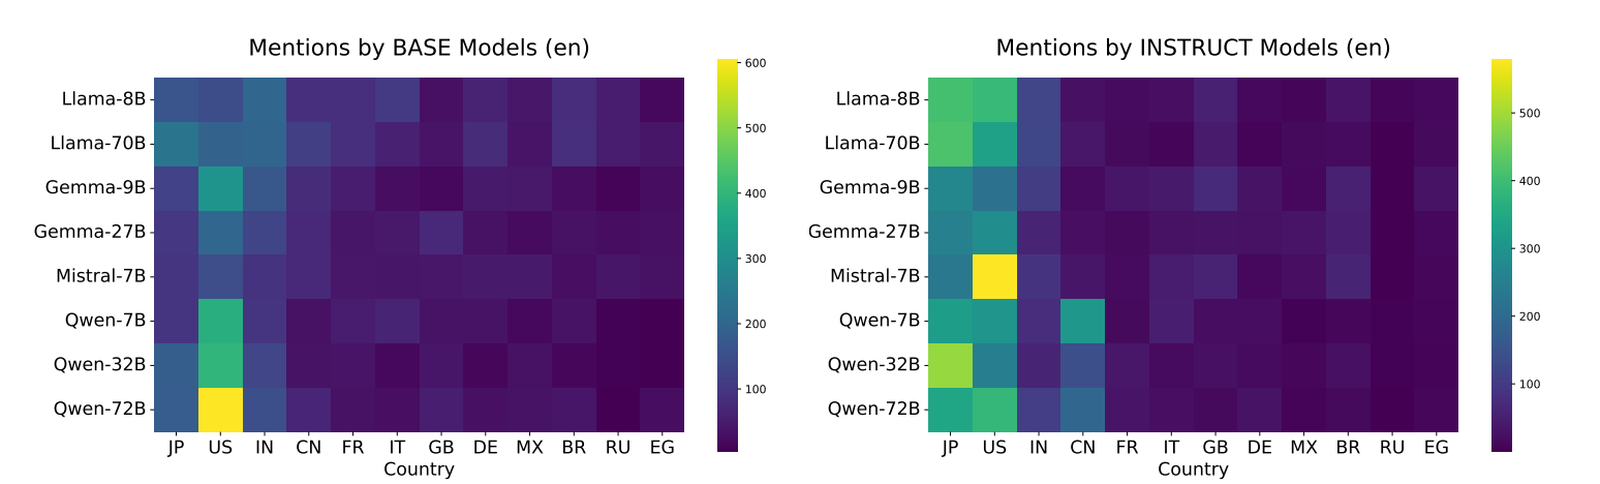
ただし、なぜ日本が選ばれやすいのかは研究でも解明されていません。OLMoの追加学習用データで登場回数の多い国がそのまま回答で多く選ばれるわけではありませんでした。たとえば、中国はデータに最も多く登場していたモデルでも回答にはほとんど現れないのに対し、日本は登場回数が多くないのに回答で目立っていたとのこと。今回の結果は日本への好意や文化知識の正確さを示すものではなく、学習段階の比較も英語に限られるものです。国を単位に文化を捉えている点にも限界があり、研究チームは原因の解明を今後の課題に挙げています。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.