Как не нарушить 152-ФЗ при проверке договора с помощью ИИ или обезличивание персональных данных c Docx Anonymizer
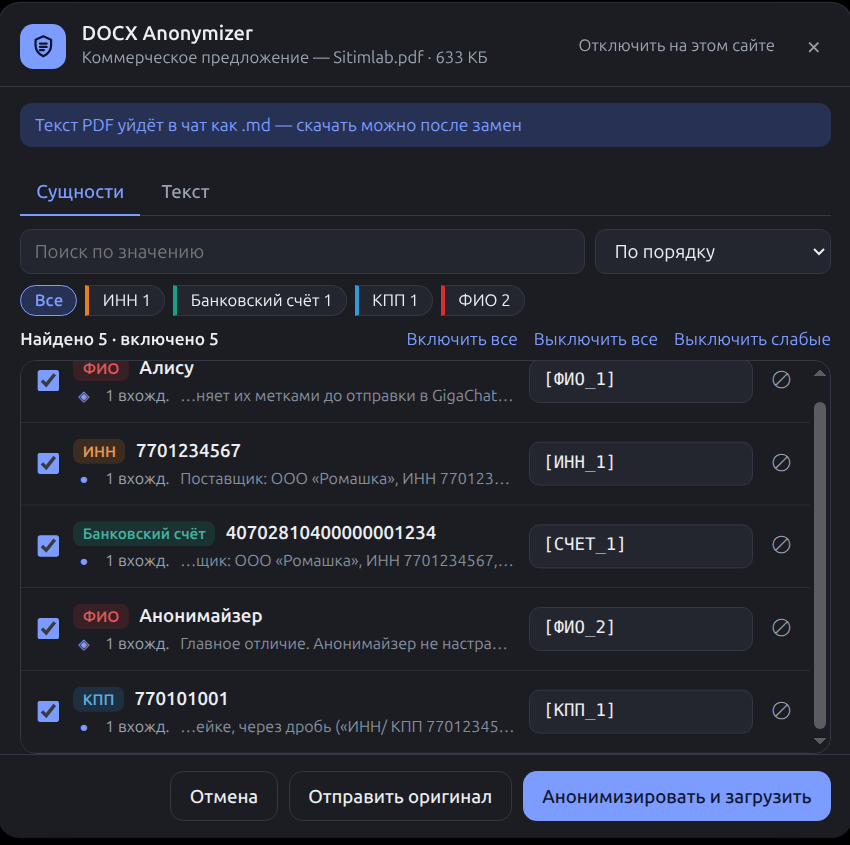
Вопрос в последнее время становится крайне актуальным, так как чаты с искусственным интеллектом стали обыденностью не только в обычной жизни, но и в работе.
Частая картина: договор на сто страниц, дедлайн сгорел еще вчера и договор сам собой улетает в окно ChatGPT с просьбой «найди подвох в разделе об ответственности». И так делают далеко не единицы. В зарубежных опросах от 38 до 57% сотрудников признаются, что вводили в публичные нейросети конфиденциальные данные, причём многие — с личных аккаунтов, о которых работодатель не знает. В России картина похожая: по телеметрии ГК «Солар», за 2025 год объём корпоративных данных, уходящих в публичные нейросети, вырос в 30 раз, и среди них есть юридические документы. Последствия при этом не только административные. Летом 2026 года суд Москвы первой инстанции поддержал увольнение директора по продажам за разглашение коммерческой тайны: среди прочего она загружала внутренние отчёты в DeepSeek. Во взыскании 5 млн рублей по «золотому парашюту» суд ей отказал.
И, казалось бы, вот тебе инструмент, который мог бы помочь, ан‑нет, нельзя. И, что интересно, в просторах интернета есть различные инструменты, которые готовы обезличить документ, но они сами являются облачными сервисами. Есть и платные варианты, которые можно установить локально с подпиской. Но это все не то. Было решено, что надо делать самому. Слава вайбкодингу!
Я сам страдаю некоторым СДВГ (популярная нынче вещь) и мне не хотелось заморачиваться с загрузкой в какое‑то приложение и потом оттуда брать обезличенный документ, а только затем загружать в условный СhatGPT. Мне нужно было приложение, которое бы перехватывало текстовый документ на странице чата с ИИ и на лету обезличивало бы документ (чем короче пользовательский путь, тем выше шанс, что я сам буду этим пользоваться). Сказано — сделано: было решено делать расширение для Chrome на javaScript.
Какие ограничения я закладывал с самого начала: плагин принципиально не должен был делать сетевые запросы, это должен быть открытый проект для повышения доверия к нему, должен работать без сервера, без телеметрии и без обязательной публикации в Web Store (но этот вопрос пока открытый), должен работать на любой странице облачных ИИ и не только.
Первая версия стала пробой пера — отложил внедрение NLP на потом и сосредоточился на автоперехвате и детерминированных методах определения персональных данных, но в архитектуре оставил интерфейс NerProvider с заглушкой на то самое «потом».
Для договоров правил хватало: например, стороны находятся по меткам («в лице», «ИНН:») и через базу знаний сторон. Но с другими документами приложение уже работало плохо — было много ложных срабатываний, где заменялись имена по типу Алиса AI, а также были пропуски. И если ложные срабатывания — ерунда, ведь данные не уходят, то вот пропуски данных — плохой знак. В этой версии я отработал интерфейс и доказал себе, что это в принципе работоспособный проект. Дальше нужно было думать над внедрением NLP.
Требовалась маленькая модель, которая могла бы работать на CPU и весила немного. В идеале, расширение не должно было занимать более 75 Мб, а модель не более 45 Мб. В итоге выбор пал на модель rubert‑tiny2, маленький русский BERT (распространяется под MIT).
Дальше будет много технических подробностей, но для меня это был первый опыт, в деталях которых мне пришлось нехило так разбираться, перечитывая различные статьи и терзая вопросами Claude Fable 5.1.
Решающим фактором стало то, что rubert‑tiny2 работает в браузере на WASM в одну нить внутри воркера расширения. После квантования int8 файл занимает 30 МБ (но сжатие еще только предстояло провести, о чем далее), холодный старт около 0,3 с, а 20 страниц договора обрабатываются примерно за 1,7 с. Приемлемо.
Базовая модель справлялась плохо, потребовалось ее дообучение. Забегая вперед, скажу, что обучение прошло в 2 захода на игровом ноутбуке с 8Gb дискретной видеопамяти и 16 Gb RAM. Ноут во время обучения, конечно, ревел как пылесос, но справился с задачей без потерь.
Обучение модели — Попытка № 1
Обучение в первой итерации проводил на данных WikiANN ru и en, по 20 тыс. предложений train на язык.
Основной проблемой, с которой столкнулся — это надежность определения наименования организации. Понимаю, что это по сути публичная информация, но тут уже был спортивный интерес. Хотелось относительно надежно определять наименования юрлиц без лишнего шума. При обычном дообучении F1-score по разметке ORG (Organization) на тесте упирался в 0,71–0,74, а гейт поставил не ниже 0,75. Перебор learning rate, числа эпох, label smoothing и размера батча не помог — это был потолок.
Было решено провести дистилляцию знаний. Сначала обучил модель‑учителя xlm‑roberta‑base на тех же данных; у неё показатель был 0,805, что выше моего порога. Затем ученик rubert‑tiny2 учился одновременно на правильных метках и на «мягких» вероятностях учителя. В итоге показатель у модели поднялся до 0,76. Но WikiANN — это заголовки статей Википедии. В них нет «ООО „Рогаикопыта“ с кавычками и ФИО в косвенных падежах. Модель, обученная только на WikiANN, на договорах давала ORG 0,23. Поэтому добавил 10% шаблонных синтетических данных:»
организационно‑правовые формы и три вида кавычек;
ФИО в четырёх падежах, инициалы до и после фамилии;
«ИП» перед именем, которое не входит в спан;
отрицательные примеры: «Заказчик», должности.
Конвейер обучения был таким:
обучение ученика → экспорт в ONNX (opset 17) → квантование int8 → проверка, что предсказания int8 совпадают с PyTorch минимум в 99% токенов → калибровка порога (0,7).
Стандартный quantize_dynamic квантует таблицу эмбеддингов одним общим масштабом, и совпадение с исходной моделью падало до 98,1%. Помогло построчное uint8-квантование эмбеддингов, собранное из стандартных операторов Gather, Cast, Mul, Add — это нужно было, чтобы модель могла запуститься на чем угодно: ONNX Runtime, TFLite, TensorRT или даже на чистом CPU в браузере/мобилке (в перспективе). После этого совпадение стало 99,7%, а файл уменьшился со 111 до 30 МБ (сжатие в ~3.7 раза). В теории переход с весов float32 (4 байта на число) на uint8 (1 байт на число) математически должен уменьшать объем чистых эмбеддингов ровно в 4 раза. То, что файл уменьшился в 3.7 раза, говорит, что эмбеддинги занимали практически весь объем модели, а небольшой остаток ушел на служебные данные граф‑менеджера и метаданные квантования. Что примечательно, потеря точности при этом составила всего 0,3% — это результат построчного (per‑row) квантования эмбеддингов, так как для каждой строки (каждого вектора) рассчитываются свои индивидуальные коэффициенты сжатия. Это не дает «выбросам» в одном векторе испортить точность соседних.
Итог первого захода обучения (WikiANN ru test): PER 0,915, ORG 0,760, LOC 0,862. На английском PER 0,81, где PER — имена людей (Person), LOC — локации и географические названия (Location), ORG — самый слабый результат среди трех классов.
После проведения дополнительных тестов на другом документе — коммерческом предложении, из 49 находок 46 были «организациями» от модели, и почти все ложные: заголовки капсом («ВХОДИТ», «05 Цены»), аббревиатуры (ЭДО, MVP), названия продуктов (Word, Excel). Стало очевидным, что модель, которя не видела ничего, кроме Википедии и договоров, продолжает испытывать трудности с распознаванием организаций. Такой результат меня опечалил, что я решил сделать некоторую паузу.
Обучение модели — попытка № 2
Так как стало ясно, что проблема именно в датасете решил сменить подход и выбрал следующий:
WikiANN ru и en, по 20 тыс.;
factRuEval ×2;
35% синтетики 10 деловых жанров: коммерческие предложения, письма, счета и УПД, инструкции, резюме, переписка в чатах, акты сверки, презентации — генерил на claude.
factRuEval-2016: это новости и аналитика вне Википедии, около 4 900 предложений под лицензией MIT.
Рассматривал еще Nerus (тексты Lenta.ru), RuREBus и NEREL, WikiNEuRal, MultiCoNER, но решил оставить их на следующие разы, так как казались мне избыточными на момент разработки. Отдельная история в том, что на эти датасеты не нашел лицензий и непонятно что с авторскими правами на них.
Примерно треть синтетики — предложения вообще без сущностей. Это как раз заголовки капсом, аббревиатуры, продукты и должности, размеченные как «не сущность». Из синтетики специально вырезали все имена, которые встречаются в тестовом корпусе, чтобы не завысить оценку.
Итог 1.1.0:
1.0.0 | 1.1.0 | |
|---|---|---|
WikiANN ru PER / ORG | 0,915 / 0,760 | 0,913 / 0,756 |
factRuEval PER / ORG (новости вне Википедии) | 0,736 / 0,412 | 0,861 / 0,704 |
Точность ORG на деловых жанрах | 0,47 | 0,99 |
Ложных «организаций» на 566 предложениях без сущностей | 510 | 5 |
Размер, скорость и формат пакета не изменились, поэтому код расширения трогать не пришлось.
Что в итоге
Расширение работает. ORG остаётся самым хрупким классом, и на незнакомых жанрах пропуски возможны, поэтому если для вас важно маскировать названия организаций нужна ручная верификация — в расширении это реализовано довольно просто. PDF с текстовым слоем работают, сканы не поддерживаются. Это не замена внутренней политике по работе с ИИ и не индульгенция, а способ сократить риск на самом коротком пользовательском пути, который я смог придумать.
Дальше в планах: добавить Nerus и NEREL (если разберусь с их лицензиями), подтянуть английский, и, возможно, всё‑таки решить вопрос с публикацией в Web Store. Код открыт: https://github.com/argmaster‑dev/docx‑anonymizer. Если найдёте документ, на котором модель ошибается, или захотите прислать свой жанр синтетики или датасет, буду рад вас видеть в issue или pull request.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.