От хаоса к порядку: как управлять техническим долгом с помощью ИИ
Всем привет! Меня зовут Ира, я лид группы проектов, обеспечивающих полный цикл работы службы поддержки в компании «Совкомбанк Технологии».
В блоге «Совкомбанк Технологий» уже выходила статья, где я поделилась тем, как мы с командой организовали работу с техническим долгом на легаси-проекте. Там я выделила ряд проблем, с которыми тогда столкнулась. В этой статье продолжу данную тему и расскажу, как мы закрываем технический долг с помощью искусственного интеллекта.
Существует распространенное мнение, что ИИ отлично подходит для использования в новых проектах, создания прототипов и MVP, где можно с нуля попросить модель написать компонент, запрос или даже небольшой сервис, а в глобальном легаси-проекте от него мало пользы. Но сегодня я расскажу вам, как можно использовать ИИ для систематизированного рефакторинга и закрытия технических задач в подобных проектах на примере нашего опыта.
Когда внутри одного приложения существуют сразу несколько архитектурных эпох, первое желание — это сесть и просто написать искусственному интеллекту: «Перепиши нормально».
Считаю, что такой вариант – один из самых опасных в пользовании ИИ. Результат c таким размытым ТЗ может выглядеть значительно лучше исходника, успешно пройти поверхностное ревью и при этом изменить поведение системы. К тому же, в следующей задаче с таким же ТЗ ИИ сможет принять другое решение – совсем неверное.
Что для искусственного интеллекта может означать промпт: «Перепиши нормально»?
Вынести функции, поменять архитектуру, заменить библиотеку, изменить API, переписать классовый компонент, поменять управление состоянием, оптимизировать рендеринг или переименовать сущности? Для модели все это потенциально является рефакторингом, в то время как для production-системы — это разные изменения с разным уровнем риска.
Логично, что наши промпты должны быть сложнее. Они могут быть поделены на правила и небольшие повторяемые операции.
Примеры повторяемых операций:
Зафиксировать текущее поведение тестами.
Отделить чистые утилиты, проверить наличие аналогов в проекте.
Вынести состояние и сайд-эффекты в хуки.
Разделить крупный JSX, вынести отдельные компоненты.
Запустить проверки.
Просмотреть итоговый diff.
Упрощенные примеры правил:
Никогда не изменяй data-testid.
Ищи аналоги утилит в src/shared.
Используй из стилей только scss.
Конечно, такой подход будет давать результаты намного лучше. Однако любая повторяемая последовательность действий в проекте становится отличным кандидатом для повторяемого навыка (skill). Любые правила должны иметь единый источник истины, для ИИ лучше всего эту роль играет AGENTS.MD.
Не стоит также забывать о том, что эти операции нужны не каждый раз, поэтому нам необходимо изначально проанализировать компонент и составить план.
В итоге мы остановились на таком порядке действий:
Добавляем в AGENTS.MD общие предпочтения по технологиям и подходам, а также информацию, которая может быть необходима нескольким скиллам.
Создаем навыки для повторяющихся действий: покрытие тестами, вынос утилит и хуков, разделение компонента и прочее.
Создаем навык refactor, который будет анализировать компонент и выполнять роль оркестратора для остальных навыков.
Что мы добавили в AGENTS.md:
Пометили LEGACY папки и библиотеки в них, поскольку в нашем AGENTS.md уже были прописаны структура и стек проекта.
Уточнили, что проект находится в стадии перехода на Feature-Sliced Design (FSD). Часть кода уже переведена на FSD, остальное – legacy-артефакты, требующие постепенного рефакторинга.
Прописали строгие правила нейминга и принятые соглашения вроде “вместо TypeScript
enumрекомендуется использоватьas const”.
Отдельно хочу отметить, что в AGENTS.md мы разместили правила и примеры для документации JS Doc и тестов, а также для нейминга веток и коммитов, так как они требуются практически для любой задачи.
Создание навыков (skills)
Важный момент: прежде чем создавать новый навык, обязательно подумайте – нельзя ли закрыть его функциональность линтером, сниппетом или другим скриптом.
Например, у нас возникло желание сделать скилл, который анализировал бы зависимости в хуках, удалял бы лишние и добавлял бы недостающие. Но это может запросто сделать и линтер: быстрее, лучше и дешевле.
Навыки стоит использовать там, где действительно нужно «подумать». Также существует множество готовых скиллов, которые уже есть в общем доступе. Например, для более свежих проектов наши коллеги подключают:
vercel-react-best-practices и vercel-composition-patterns, чтобы соблюдались лучшие практики и паттерны
playwright-e2e-testing для покрытия e2e-тестами
Навыки, которые мы создали конкретно для нашего проекта:
test-first
Один из самых важных навыков. Его задача – написать unit-тесты до начала рефакторинга React-компонента, чтобы зафиксировать текущее поведение и гарантировать, что рефакторинг его не сломает.
Ключевой момент – правильно описать, когда нужно запускать этот навык, а когда не стоит:
«Используй, когда пользователь собирается отрефакторить компонент (особенно legacy .js или классовый), в том числе перед отделением логики от представления. Срабатывай по «зафиксируй поведение тестами», «покрой тестами до рефакторинга», «защити рефакторинг тестами», «тесты до изменений», «TDD для рефакторинга», «не сломай компонент при рефакторинге», даже если слово «тесты» не сказано. НЕ срабатывай на обычное написание тестов для нового кода, запуск
npm test, snapshot-тесты или вопросы о стеке — там рефакторинг не подразумевается.»tailwind-to-scss-conversion
В проекте одновременно существовали SCSS, CSS Modules, Tailwind с префиксом tf-, UI-компоненты на Tailwind и локальные inline styles. Даже простая кнопка могла смешивать несколько подходов:
Button
  className={tailWindClassMerge(
    'tf-flex tf-items-center tf-px-4',
    disabled && 'tf-opacity-50'
  )}
  style={{ minWidth: 120 }}
>
Так как изначально проект был написан с помощью SCSS, а tailwind был добавлен лишь на часть функционала (около 20%), мы приняли решение вернуться к истокам.
Описали скилл tailwind-to-scss-conversion по следующим пунктам:
Контекст: префикс для tailwind, использование classNames для объединения классов и так далее
Алгоритм действий
Важные правила
Чек-лист проверки
migrate-to-rtk
Скилл для миграции на rtk с других библиотек (swr, react query) – переписывает сами запросы, ищет компоненты, в которых используются эти запросы и исправляет их использование там. В описании содержит примеры, как выглядят запросы до и после преобразования.
extract-utilities
Скилл, который выделяет чистую (без состояния и JSX) логику из React-компонента в утилиты. При этом он должен:
Найти существующие аналоги по всему проекту (shared/lib, utils/helpers).
Принять решение: вынести на общий уровень, оставить в компоненте или заменить на идентичный дубликат (дедупликация).
Здесь удобно использовать проектный скилл, так как места, где могут встречаться аналоги, уже известны. К тому же, из-за того, что проект начинали писать очень давно, в функциях часто встречается устаревший синтаксис, и мы описали примеры его обновления.
В описании указали триггеры срабатывания:
«Вынеси утилиты/helpers из компонента»
«Убери дубликаты/повторную логику»
«Найди аналог функции в проекте»
«Замени дубликат на существующий»
«Вынеси чистые функции на общий уровень»
На что не реагировать:
«НЕ срабатывай на вынос состояния/эффектов (это wr-extract-hooks), разметки (wr-split-presentation) или стилей».
В остальном структура навыка остается та же: контекст, шаги, чек-лист.
extract-hooks
Этот навык предназначен для выноса хуков. Структура у него не отличается от структуры остальных навыков, но правила сложнее, а шагов больше, так как здесь мы должны учитывать контекст компонента. Использовать этот навык необходимо до перевода классового компонента на функциональный.
Тут также у компонентов были свои тонкости. Например, часть логики необходимо было оставлять до обновления библиотек, поэтому нам помог именно вручную описанный скилл.
split-presentation
Этот навык нужен для того, чтобы выделить дублирующийся и крупный JSX из React-компонента в отдельные под-компоненты и привести его к чистому «представлению». Этот навык важно запускать после extract-hooks и extract-utilities.
review-changes-for-refactor
Для того, чтобы сделать ревью изменений после рефакторинга, мы используем отдельный навык, так как при рефакторинге велик шанс задеть что-то лишнее. Он не просто проверяет изменения, но и дает список мест, которые стоит тщательно проверить при тестировании задачи.
Оркестратор – навык refactor
Отдельные навыки хорошо решают конкретные задачи, но разработчику всё равно приходится определять, какие из них нужны для очередного компонента и в каком порядке их запускать. Для этого мы создали refactor — навык, который сначала анализирует компонент, а затем составляет план и подключает остальные навыки по необходимости.
Его шаги мы сформулировали так:
Изучи компонент и связанные с ним файлы. Определи, где находятся запросы, состояние, сайд-эффекты, преобразования данных, разметка и стили. Отметь зависимости от legacy-библиотек.
Проверь существующие тесты и выдели поведение, которое важно сохранить: условия отображения, действия пользователя, состояния загрузки, ошибки и результаты запросов.
Составь короткий план рефакторинга. Укажи, какие навыки понадобятся, какие шаги стоит исключить и где есть риск изменить поведение. Покажи план разработчику до внесения изменений.
Если поведение не защищено тестами, запусти test-first. Зафиксируй значимые сценарии до изменения компонента.
Найди чистые функции и преобразования данных. Через extract-utilities проверь аналоги в shared/lib и utils/helpers, затем реши, что переиспользовать, вынести или оставить на месте.
Разбери состояние, эффекты, подписки и обработчики через extract-hooks. Если компонент классовый, планируй его перевод отдельно и учитывай зависимости, которые пока нельзя обновить.
После отделения логики раздели крупный JSX через split-presentation. Сохрани публичный API компонента и data-testid.
Если компонент использует tf- классы, запусти tailwind-to-scss-conversion.
Миграцию запросов через migrate-to-rtk выполняй только тогда, когда она входит в согласованный объём задачи.
После каждого существенного изменения запускай подходящие тесты. В конце проверь tests, coverage, lint и typecheck.
Просмотри итоговый diff через review-changes-for-refactor: проверь, что изменения соответствуют плану, а поведение, которое не собирались менять, осталось прежним.
Навык refactor не будет выполнять все пункты каждого файла. В небольшом компоненте может не быть ни запросов, ни Tailwind, ни логики для выноса.
Задача refactor:
Выбрать нужные действия.
Объяснить порядок действий.
Не расширять рефакторинг просто потому, что модель нашла ещё один участок кода, который хочется улучшить.
Также мы предусмотрели точки, в которых навык должен остановиться и показать проблему разработчику. Например, две похожие утилиты могут по-разному обрабатывать пустое значение. Или при миграции запроса выяснится, что старый и новый варианты отличаются поведением при ошибке. Это уже не механический перенос кода: сначала нужно решить, какое поведение ожидается.
Результаты в цифрах
Переходим к самому интересному — результатам.
В нашей выборке участвовало 36 компонентов. Когда мы начали использовать проектные навыки для рефакторинга, нам хотелось понять, действительно ли этот подход помогает команде или мы просто перекладываем привычную работу на ИИ.
Поэтому мы решили оценивать не количество написанного кода и не число запущенных навыков, а показатели, которые напрямую влияют на процесс разработки:
скорость выполнения задач
трудозатраты на ревью
количество ошибок после изменений
Почему выбрали именно их?
Время рефакторинга показывает, насколько быстрее мы можем работать с техническим долгом. Количество замечаний на ревью помогает оценить качество первоначального результата и объём доработок. А баги после изменений — пожалуй, самый важный показатель для legacy-проекта, где основная задача рефакторинга заключается в улучшении внутренней структуры кода без изменения существующего поведения.
Для сравнения мы использовали два подхода: привычный ручной рефакторинг и рефакторинг с использованием проектных skills и оркестратора refactor.
Чтобы сравнение было осмысленным, было важно учитывать не только размер компонента, но и его сложность. Например, два компонента по 500 строк могут требовать совершенно разных усилий: один содержит преимущественно JSX, а второй — запросы, управление состоянием, обработчики событий и множество зависимостей.
Поэтому при анализе результатов мы ориентировались на компоненты сопоставимой сложности и оценивали три показателя:
Время выполнения рефакторинга
Здесь важно учитывать полный цикл работы, а не только время, за которое ИИ сгенерировал изменения.
В оценку вошли анализ компонента, подготовка плана, написание или актуализация тестов, сам рефакторинг, запуск проверок и исправление обнаруженных проблем до передачи задачи на ревью. Так мы оцениваем именно затраты разработчика, а не скорость генерации кода моделью.
Количество замечаний на code review
Мы учитываем замечания, которые требуют изменений в коде: ошибки в логике, нарушение архитектурных соглашений, дублирование существующих утилит, некорректное использование хуков и другие проблемы, связанные с качеством реализации.
При этом стилистические комментарии, не требующие исправлений, разумно исключить из оценки.
Среднее количество замечаний рассчитывается как отношение общего числа замечаний к количеству проверенных задач.
Эта метрика важна, поскольку рефакторинг не заканчивается на написании кода. Если разработчик быстро подготовил изменения, но затем несколько часов исправляет замечания, реальная экономия времени оказывается значительно меньше.
Количество багов после рефакторинга
Здесь нас интересуют именно регрессии — ошибки, которые появились в результате изменений и отсутствовали до них.
Например, компонент перестал корректно обрабатывать ошибку запроса, изменилось поведение формы или перестал работать один из пользовательских сценариев.
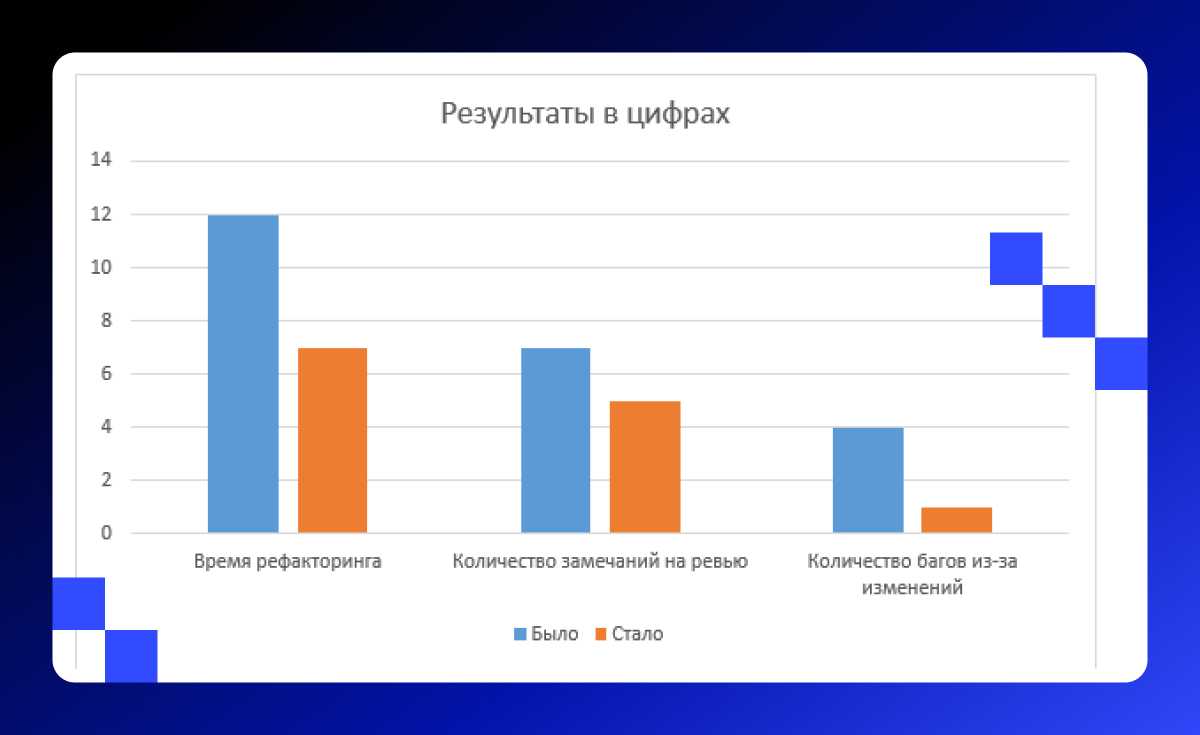
Время рефакторинга сократилось с 12 до 7 часов в среднем. Это снижение примерно на 42%.
На практике мы стали тратить меньше времени на рутинные операции: поиск существующих утилит, выделение логики, подготовку тестов и приведение кода к принятым в проекте соглашениям.
Дополнительный эффект — мы стали чаще рефакторить небольшие компоненты прямо во время выполнения бизнес-задач. Раньше подобные улучшения нередко откладывались, потому что требовали отдельного времени. Теперь некоторые локальные изменения занимают минуты, а не часы.
Среднее количество замечаний на ревью уменьшилось с 7 до 5, то есть примерно на 29%.
Мы связываем это в том числе с тем, что модель получает конкретные правила проекта из AGENTS.md, а после рефакторинга запускается отдельный навык review-changes-for-refactor. В результате часть потенциальных замечаний обнаруживается ещё до того, как код попадает к ревьюеру. При этом человеческое ревью никуда не исчезает: оно остаётся обязательной частью процесса.
Количество багов после изменений снизилось с 4 до 1, что соответствует уменьшению на 75% в нашей выборке.
Здесь особенно полезным оказался подход test-first. Перед изменением компонента мы стараемся зафиксировать его существующее поведение тестами. Это помогает обнаружить ситуации, когда код после рефакторинга выглядит чище, но работает уже немного иначе. Дополнительную защиту дают ограничения оркестратора: он не должен самостоятельно расширять объём изменений, менять публичный API или принимать неоднозначные решения без участия разработчика.
Конечно, к этим цифрам мы относимся с осторожностью. Выборка небольшая, компоненты отличаются по сложности, а на результат влияют опыт разработчика, качество исходного кода и характер задачи. Поэтому считать полученные проценты универсальной оценкой эффективности ИИ было бы неправильно.
Но для нашей команды результаты стали достаточно убедительным сигналом: рефакторинг стал занимать меньше времени, количество замечаний на ревью сократилось, а регрессий после изменений стало меньше.
Итоги
Наш эксперимент показал, что ИИ может быть полезен не только для создания новых компонентов и прототипов, но и для системной работы с техническим долгом в большом legacy-проекте. За счёт проектных навыков нам удалось сократить среднее время рефакторинга примерно на 42%, уменьшить количество замечаний на ревью на 29% и снизить число багов после изменений в исследованной выборке.
Но главный результат для нас даже не в процентах, а в том, что рефакторинг часто воспринимался как отдельная большая задача, до которой сложно добраться между бизнес-приоритетами. Теперь мы можем постепенно улучшать кодовую базу, не выделяя каждый раз значительные ресурсы на подготовительную работу.
А как у вас обстоят дела с техническим долгом? Используете ли вы ИИ для рефакторинга legacy-кода или пока доверяете ему только небольшие изолированные задачи? Будет интересно узнать о вашем опыте в комментариях.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.