Я потерял пароли всех пользователей, и это был не взлом. Как мой сайт пережил аварию Яндекс Облака
Всем привет! Я делаю Workaem, агрегатор IT-вакансий. Здесь уже были две статьи про него: что видно, когда вакансии лежат в своей базе, и откуда приходят пользователи. Третью я собирался писать совсем про другое.
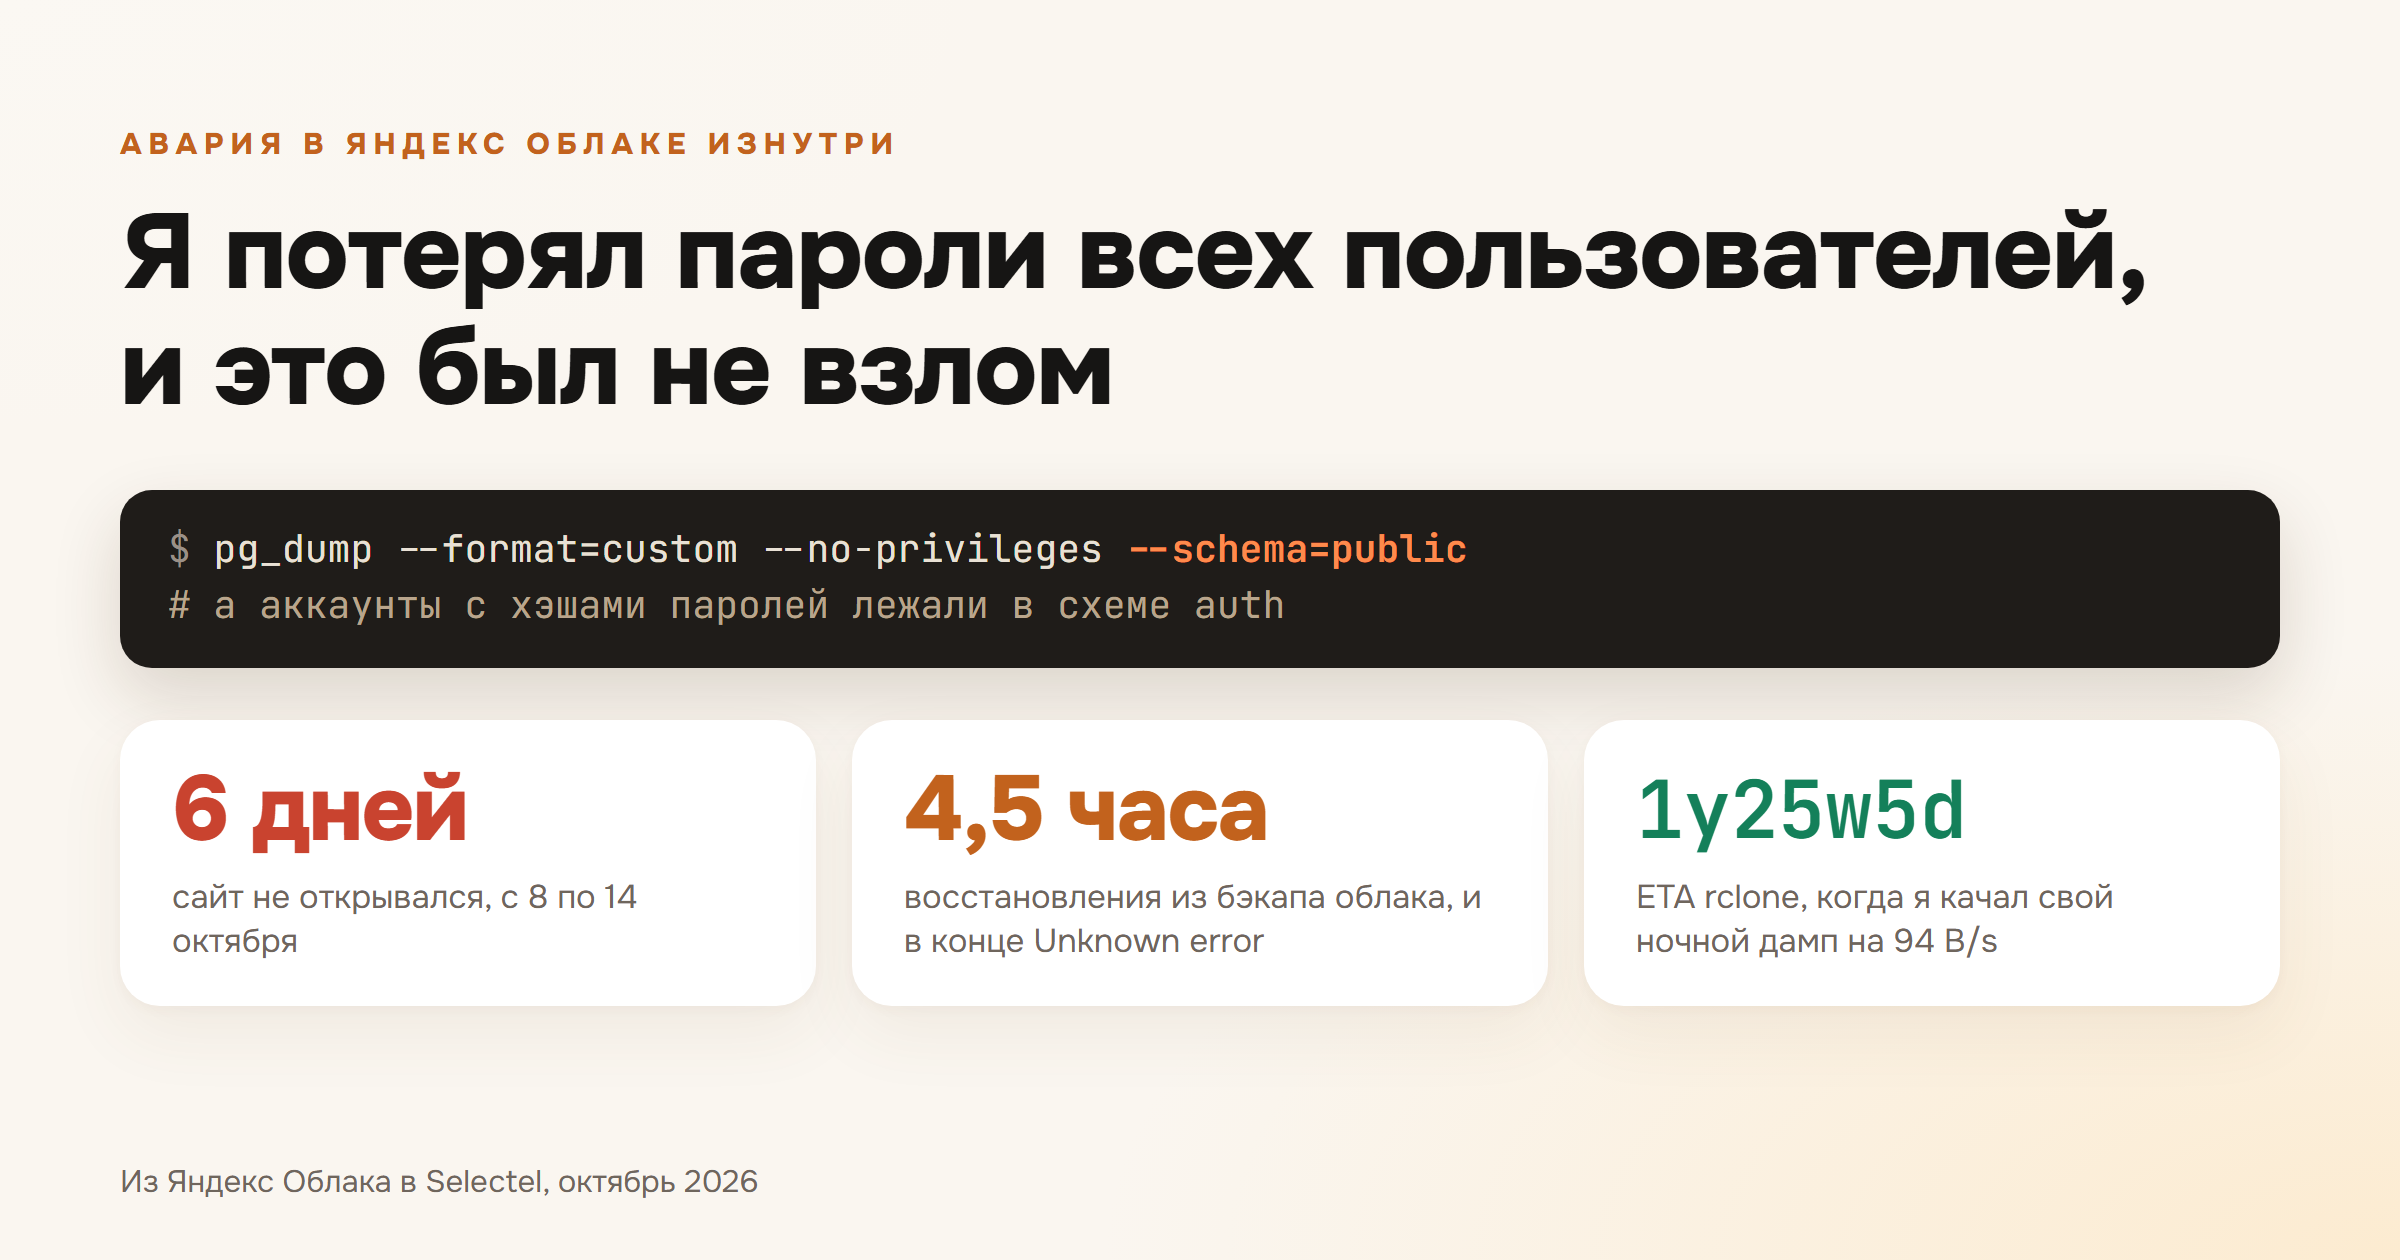
С 8 по 14 октября сайт не открывался вообще. Не тормозил и не падал с ошибкой, а просто не отвечал. Дата-центр, в котором жили сервер и база, остановился, и шесть дней я вытаскивал данные из облака в аварийном режиме и переносил все к другому провайдеру.
Пишу по горячим следам, пока помню, что и в каком порядке у меня ломалось. Сразу: большая часть проблем ниже это мои собственные решения, принятые задолго до аварии. Авария их просто обнажила. Если у вас прод и бэкап живут у одного провайдера, дальше как раз про вас :)
Коротко для тех, кто прошлые статьи не видел. Workaem собирает IT-вакансии с карьерных сайтов компаний, ATS, джоб-бордов и телеграм-каналов, склеивает дубли, считает, насколько вакансия живая, и показывает вилку на фоне рынка. Сейчас в каталоге почти 40 тысяч вакансий от 2 500 с лишним компаний, около 9 тысяч из них в России и СНГ. И больше 90% каталога приходит не с hh, а в основном прямо с сайтов компаний.
Сайта просто нет
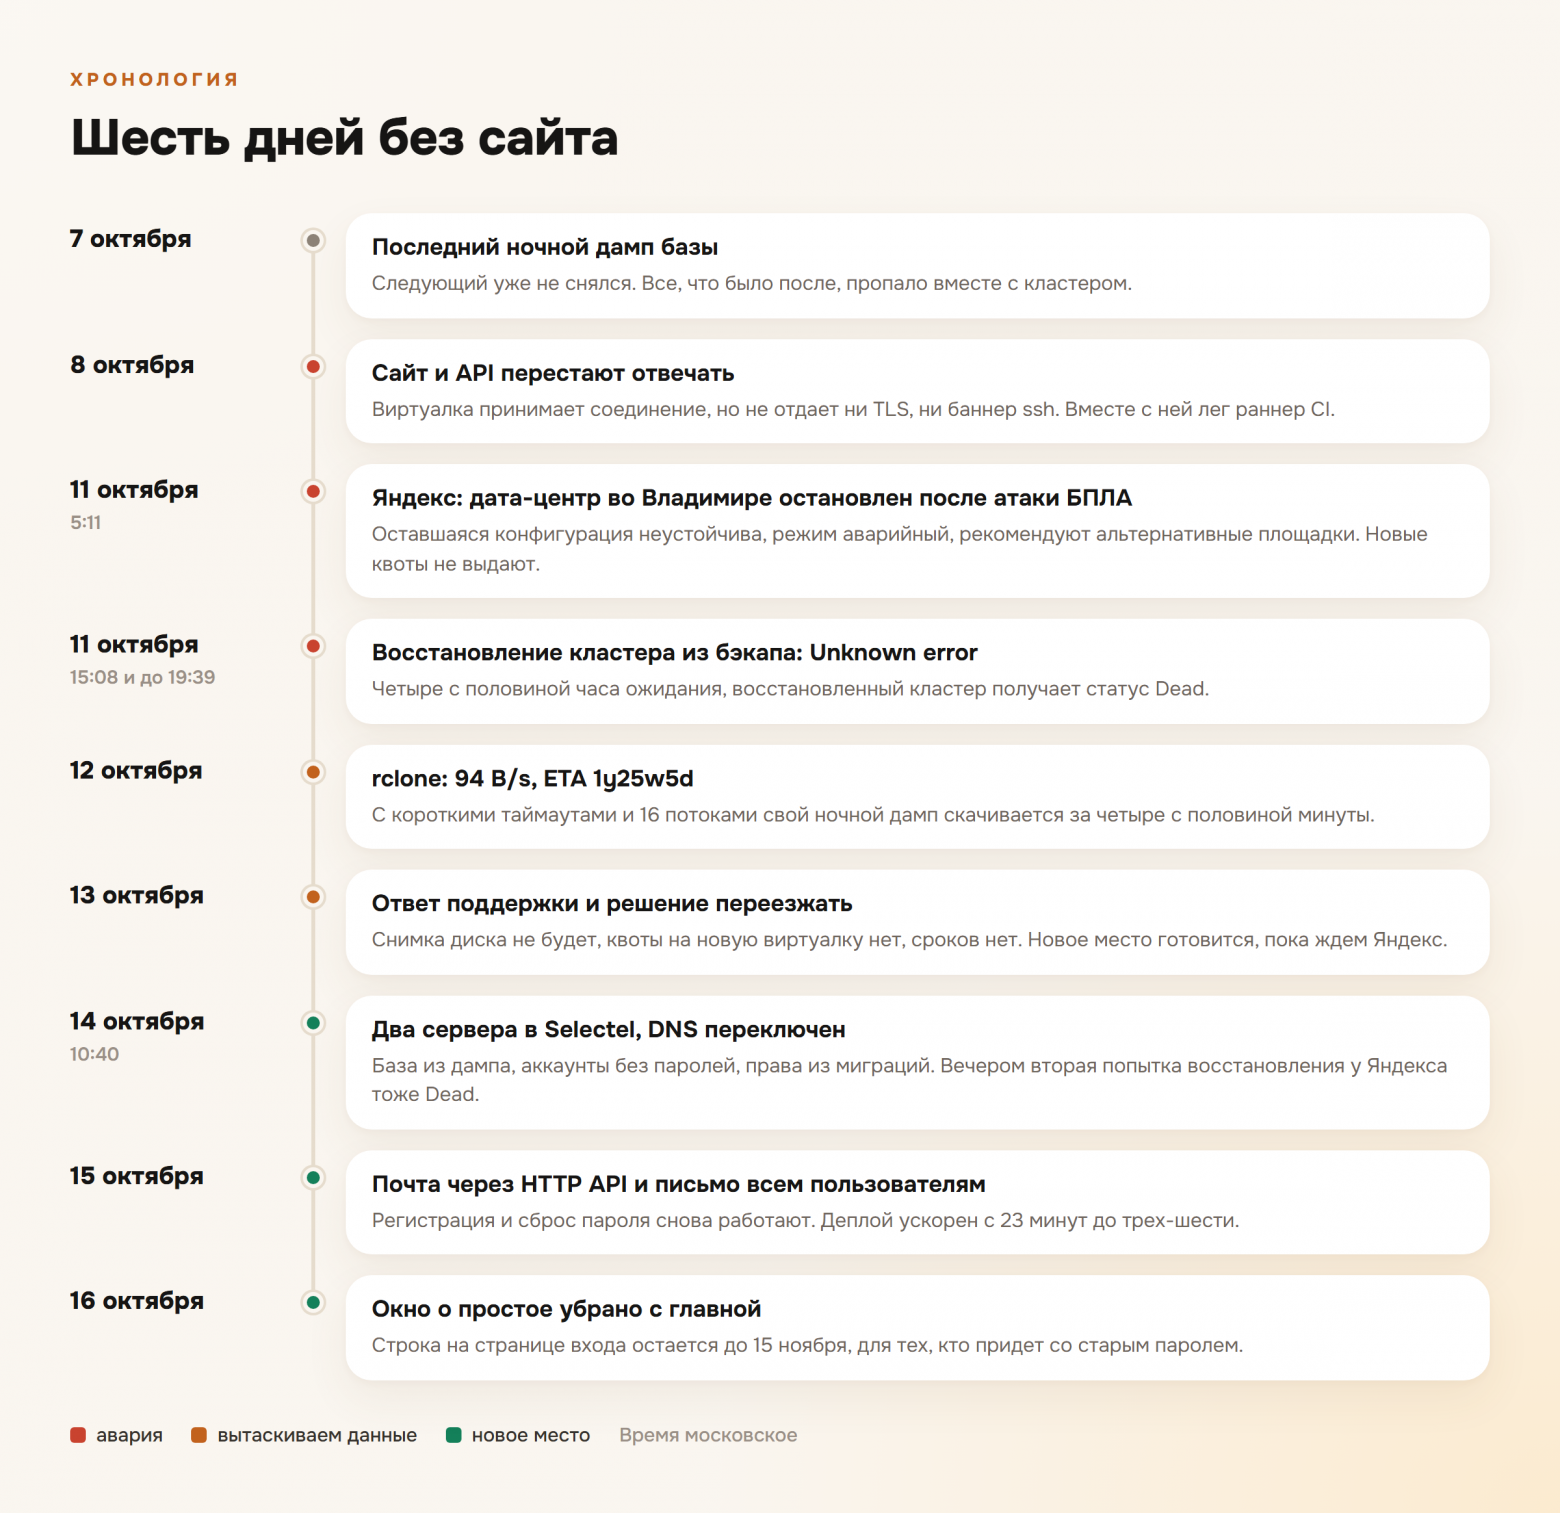
В ночь на 8 октября не снялся ночной дамп базы. Последний остался от 7 октября, дальше тишина. Сайт и API отвечали таймаутом, а сама виртуалка вела себя странно: соединение на 22, 80 и 443 принимала, но не отдавала ни TLS, ни даже баннера ssh.
Connection timed out during banner exchange
Вместе с ней лег и раннер GitHub Actions, он жил на той же машине. Так что, даже если бы я что-то починил в коде, выкатить это было бы некуда.
Что случилось, Яндекс объяснил в обновлении по инциденту:
Зона доступности ru-central1-b остается недоступной. Причиной инцидента стал пожар, произошедший в результате атаки БПЛА на дата-центр Яндекса в Сасово и затронувший часть инфраструктуры Yandex Cloud. Работа дата-центра полностью остановлена.
В этой зоне и жили моя виртуалка и база. Сначала я надеялся, что это вопрос пары дней. А 11 октября в 5:11 в канале алертов появилось второе сообщение:
В результате атаки БПЛА повреждена инфраструктура дата-центра Яндекса во Владимире. Работа дата-центра полностью остановлена. Пострадавших нет, профильные службы уже работают на месте устраняют последствия.
Хорошо, что пострадавших нет. На этом фоне все, что дальше, конечно, мелочи. Но мелочи, которые надо было как-то решать.
По технической части. Оставшуюся конфигурацию Яндекс назвал неустойчивой, режим работы платформы аварийным и прямо порекомендовал «задействовать любые другие альтернативные планы по аварийному восстановлению». А в следующих сводках добавил, что выдача квот на дополнительные ресурсы приостановлена. То есть облако само честно сказало: переезжайте. Как потом оказалось, совет был правильный. Только переехать внутри самого облака тоже не получалось, на вторую виртуалку моей квоты не хватало.
Бэкапы есть, а восстановить нельзя
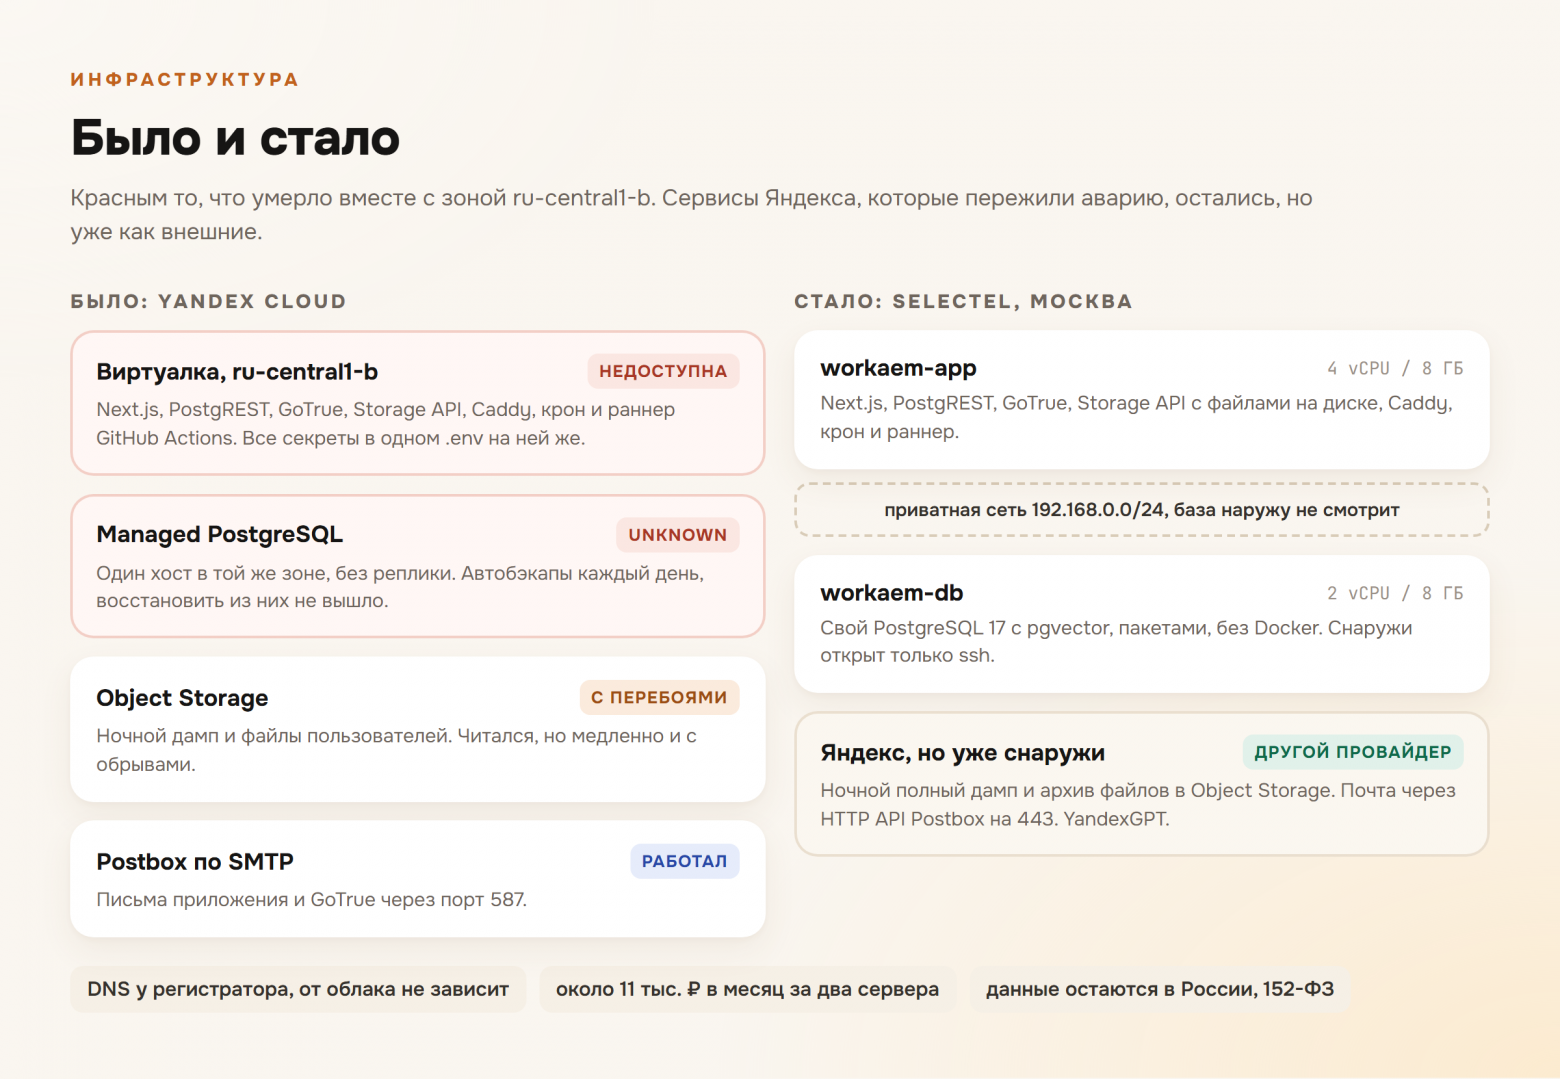
База жила в управляемом PostgreSQL от Яндекса, и бэкапы у кластера снимались каждый день, автоматически. В консоли они так и висели, со статусом Done за каждый день до 6 октября включительно.
Восстанавливать из них я пробовал дважды, в зону, которая работала. Первая попытка шла четыре с половиной часа и закончилась ошибкой «Unknown error», восстановленный кластер получил статус Dead. Через три дня вторая попытка, и снова Dead. Как потом объяснила поддержка, в аварийном режиме платформы так и бывало, и это понятно: восстанавливался в те дни не я один.
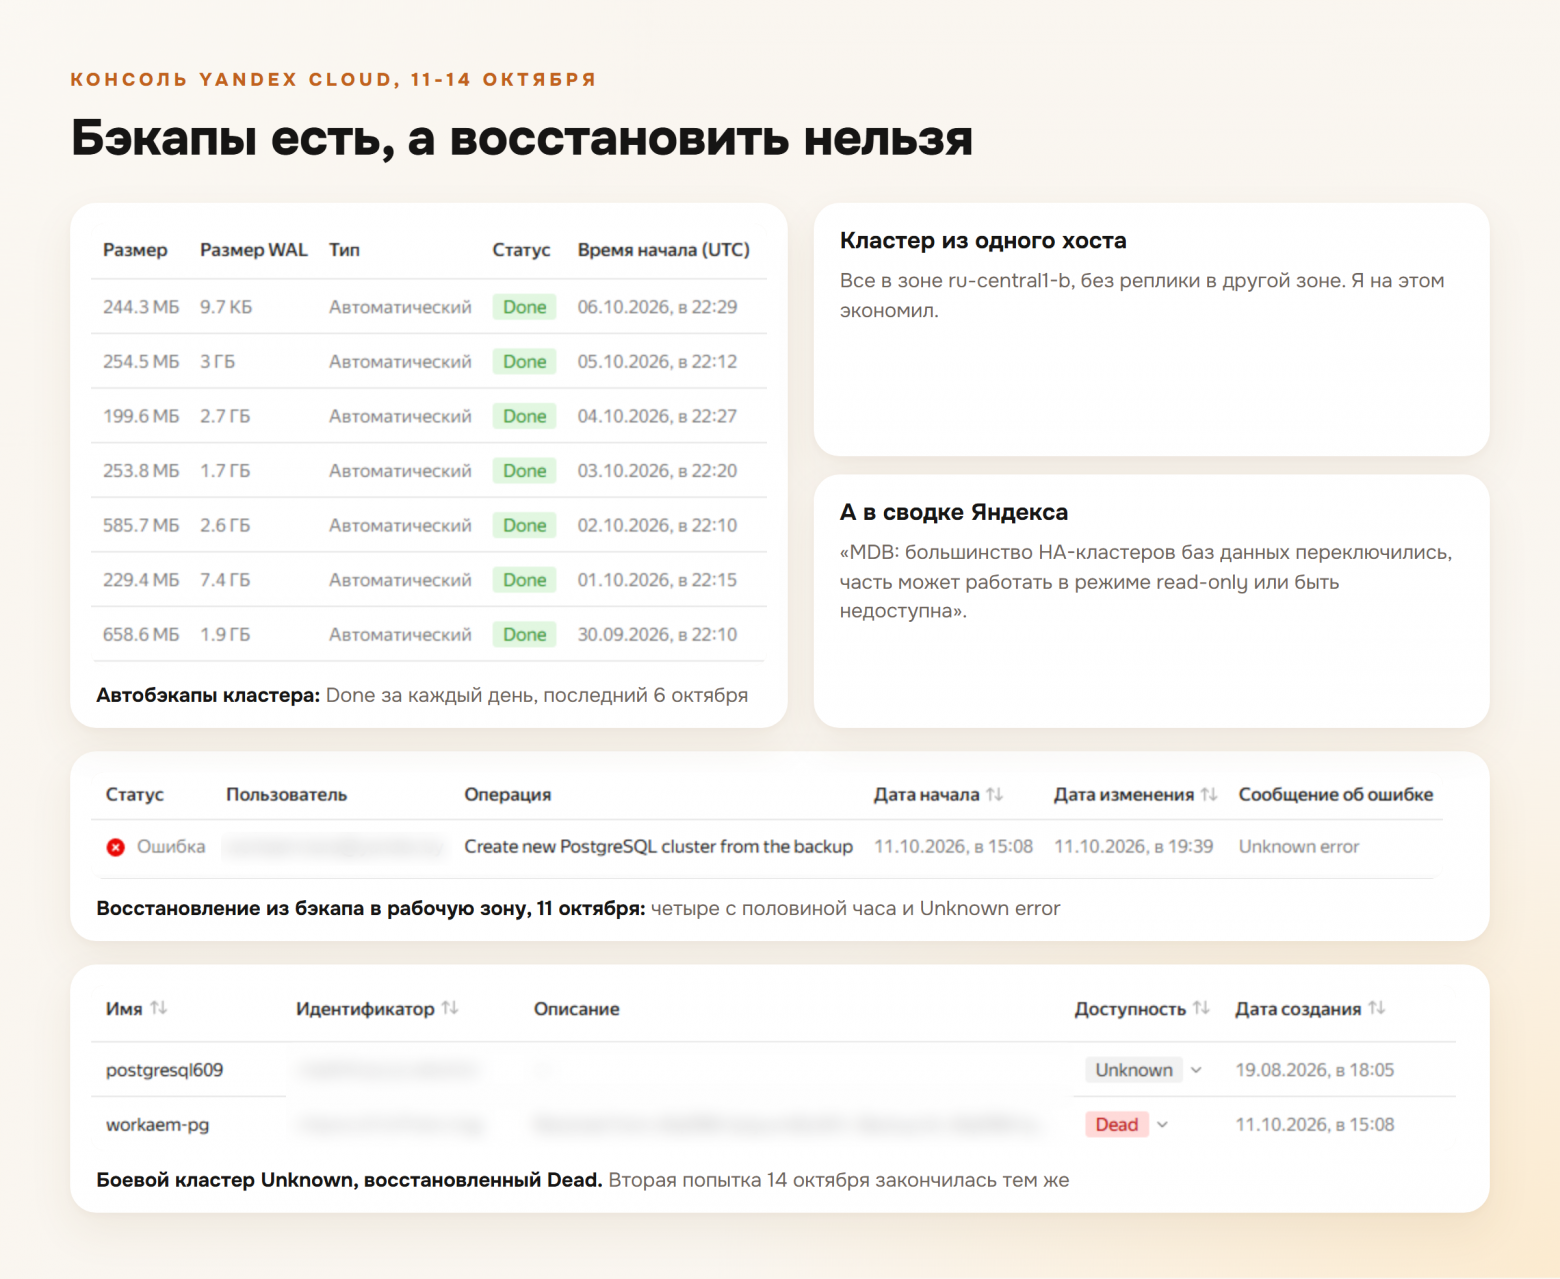
Тут главное признание этой статьи. Кластер у меня был из одного хоста, без реплики в другой зоне. Я на этом экономил. А в сводке Яндекса было отдельно сказано, что большинство HA-кластеров переключились. То есть кластер с репликой, скорее всего, аварию пережил бы, а мой просто встал со статусом Unknown и так в нем и стоит.
Яндексу досталось сильнее, чем мне
Сразу скажу, чтобы дальше не было двусмысленности: претензий к Яндексу у меня нет. За три дня у них выбило два дата-центра, и выбрали это не они. В эти ночи без ресурсов остались целые зоны со всеми клиентами, и каждый хотел свои данные прямо сейчас. Мой маленький сайт в этой очереди был одной строчкой.
И в такой ситуации Яндекс, по-моему, делал все, что мог. Сводки в канале алертов выходили по несколько раз в день, и в них не было ни «все под контролем», ни обещаний, которые потом пришлось бы забирать назад. Честно: режим аварийный, сроков пока нет, если можете, поднимайтесь на других площадках. 12 октября вышел подробный FAQ с рецептами по каждому сервису: как выгрузить диски виртуалок, как быстрее скачать данные из хранилища, что делать с базами. Один из этих советов мне потом и помог, про него ниже. А про виртуалки там было написано, что данные восстановит тот, кто сохранял снимки дисков. Снимков у меня не было, и это уже мой недосмотр.
13 октября я написал в поддержку: что лежит, что уже пробовал и о чем прошу. При таком потоке обращений я был готов ждать несколько дней, а ответ пришел в тот же вечер:
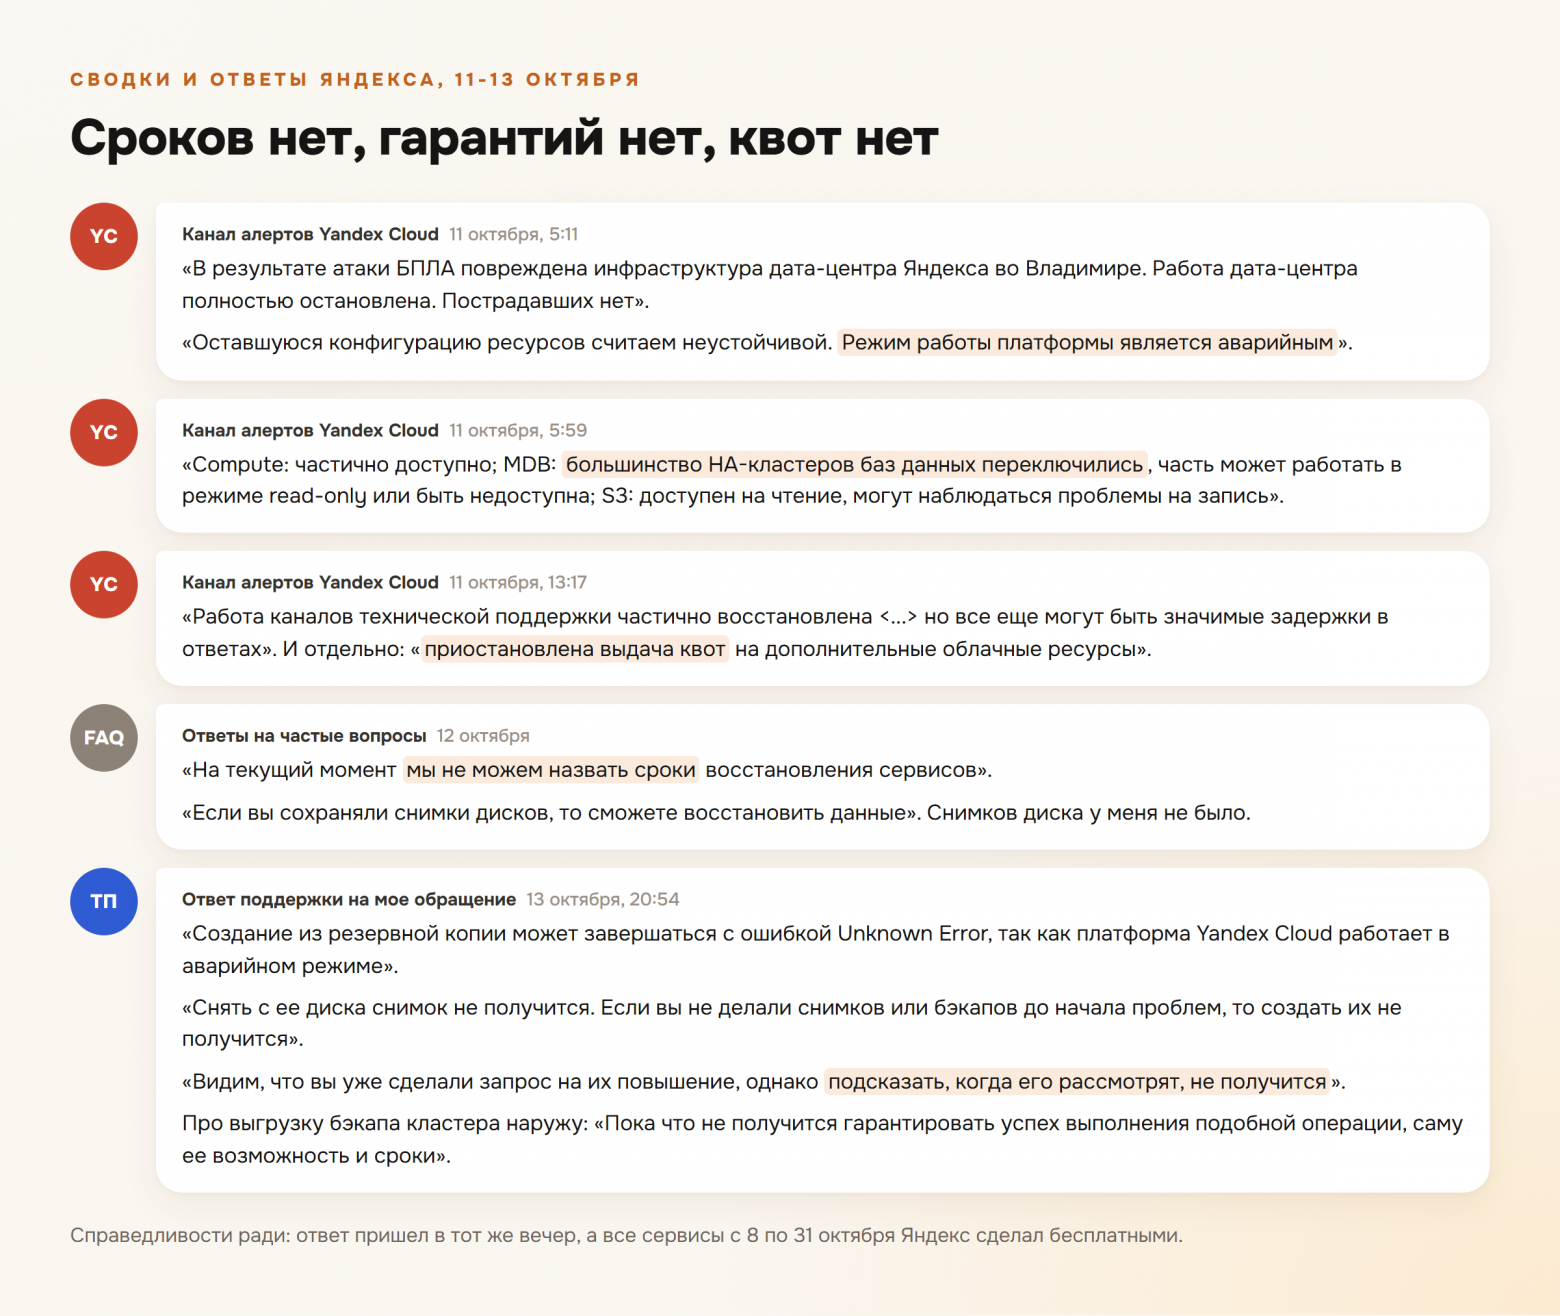
Ответ был честный, без отписок. Снять снимок диска сейчас нельзя. Квоту на новую виртуалку при такой нагрузке быстро не дадут. Восстановление из бэкапа в аварийном режиме может падать, его можно повторить или подождать, пока автоматика поднимет кластер сама. Выгрузку бэкапа во внешнее хранилище команда как раз прорабатывает, но гарантировать пока ничего не может. Заявку я оставил и понимаю, что она у них далеко не одна.
А еще Яндекс сделал все сервисы бесплатными с 8 по 31 октября, и хранилище с моим бэкапом все это время читалось. Медленно, но в ту неделю медленно было у всех. Без него переезжать мне было бы просто не из чего.
Ждать или переезжать
Первой мыслью было подождать. Яндекс чинил круглосуточно, и все время казалось, что вот-вот. Я всерьез думал, не подождать ли неделю.
Но для маленького сайта неделя без работы это много, а от ожидания ничего не зависело. Поэтому решил делать и то и другое: готовить новое место, пока Яндекс восстанавливает свое, и переключить DNS в самом конце. Обиды тут никакой, это ровно то, что Яндекс сам и советовал.
Тут помогло решение, принятое когда-то совсем по другой причине. Домен и DNS у меня у регистратора, и от облака переключение никак не зависело.
Единственная копия, которая была моей
Оставался ночной дамп, который я когда-то настроил сам, на всякий случай. Он ложился в Object Storage того же Яндекса. Тоже, если подумать, моя ошибка: бэкап у того же провайдера, что и прод. Выжил он благодаря тому, что Яндекс хранит объекты сразу в нескольких зонах, и авария одной зоны их не унесла. Но рассчитывать на это заранее я не имел права.
Читаться он, правда, читался с трудом. Первая попытка скачать бэкапы выглядела так:
Transferred: 791.250 MiB / 4.900 GiB, 16%, 94 B/s, ETA 1y25w5d
94 байта в секунду и полтора года до конца. Хранилище в те дни держало нагрузку всех, кто так же спасал свои данные, и отдельное соединение то еле шло, то подолгу замирало на нуле. Помогли две вещи. Короткие таймауты, чтобы rclone не ждал зависшее соединение вечно, а бросал его и открывал новое. И много параллельных потоков на один файл. Ну и я перестал качать все подряд и взял только последний дамп:
rclone copy yc:<бакет>/db-backups/<последний дамп>.dump ./backup --multi-thread-streams 16 --timeout 1m --contimeout 30s --low-level-retries 100 --retries 20
Transferred: 472.357 MiB / 472.357 MiB, 100%, 6.036 MiB/s, ETA 0s
Elapsed time: 4m33.8s
Четыре с половиной минуты вместо полутора лет :)
И это ровно тот рецепт, что был в FAQ Яндекса: высокая параллельность скачивания и, если надо, несколько машин сразу. Так что за него отдельное спасибо.
В бэкапе не оказалось самого важного
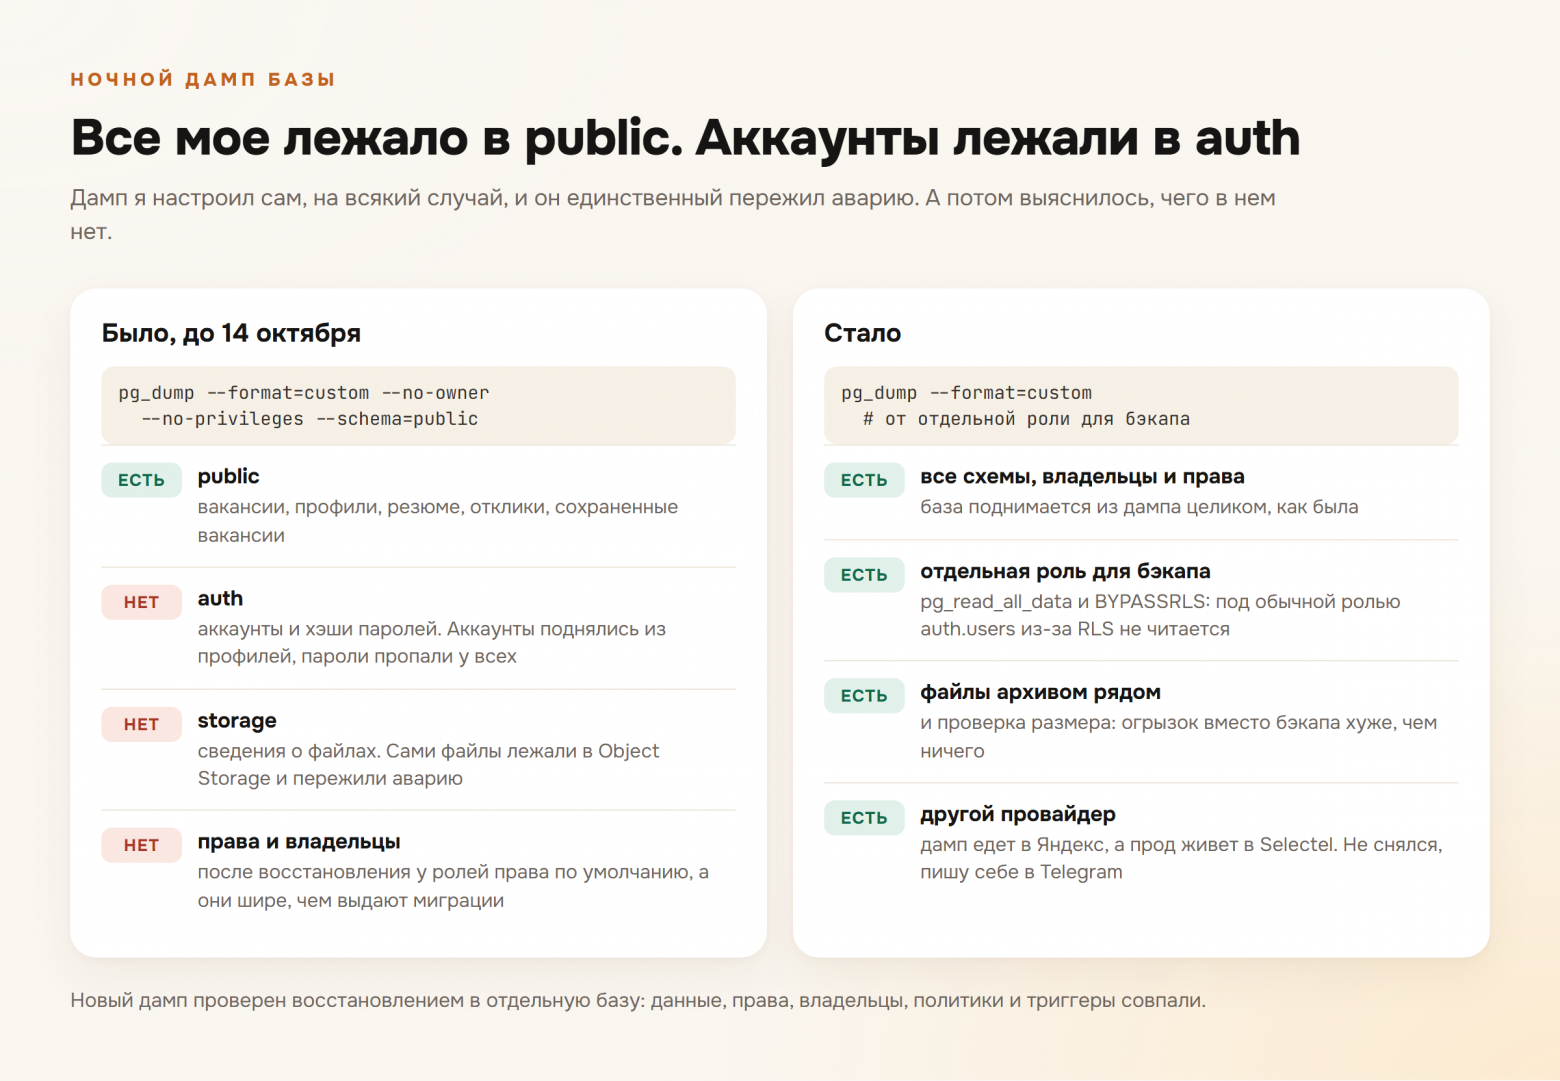
Радовался я недолго. Дамп снимался вот так:
pg_dump --format=custom --no-owner --no-privileges --schema=public ...
Когда я это настраивал, мне казалось, что все важное лежит в public. Все мое там и лежит: вакансии, профили, резюме, отклики, сохраненные вакансии. А аккаунты пользователей лежат в схеме auth, которую создает сервер авторизации (у меня это self-hosted GoTrue), и хэши паролей там же. Про эту схему я просто не подумал. Сведения о файлах лежат в схеме storage, ее в дампе тоже не было.
Флаг --no-privileges оказался жестче. Без прав дамп восстанавливается в базу, где у ролей права по умолчанию, а они шире, чем выдают мои миграции. Например, право писать в любые колонки своего профиля, включая служебные, которые должен менять только сервер. База из такого дампа работает, все открывается, и ничего не подсказывает, что она дырявая. Права я переиграл из миграций, все GRANT и REVOKE по порядку файлов, и только после этого пустил на базу приложение.
Аккаунты пришлось собирать из того, что было. В таблице профилей есть id и email, этого хватает, чтобы заново создать строки в auth.users с теми же id, и все связи сходятся. Только без паролей.
Пара граблей тут же:
- вставлять надо от роли самого GoTrue: на auth.users включен RLS, и от любой другой роли вставка в него упирается;
- токены вроде confirmation_token писать пустой строкой, а не NULL. GoTrue читает их как строку, и на NULL у него ломается чтение пользователя;
- триггер, который создает профиль при регистрации, висит на auth.users и не лежал ни в миграциях, ни в дампе public. Без него новый пользователь регистрировался бы без профиля.
В итоге данные всех пользователей на месте, а пароли пропали у всех. Не утекли, а именно пропали: хэшей просто нигде нет. Войти можно через Яндекс ID или VK ID, им пароль не нужен, или задать новый пароль через «Забыл пароль?». А для этого нужна почта. Про почту ниже, там своя история.
Если выгрузка бэкапа кластера получится, хэши можно будет вернуть по тем же id тем, кто еще не задал новый пароль.
Новый дом
Куда переезжать, выбирал недолго. Данные пользователей должны оставаться в России, это 152-ФЗ, а провайдер должен быть другой. Взял Selectel: два облачных сервера в Москве, в одной приватной сети. На первом приложение, GoTrue, PostgREST, хранилище файлов, Caddy, крон и раннер. На втором свой PostgreSQL 17 с pgvector, пакетами, без Docker. База слушает только приватный адрес, снаружи у этого сервера открыт один ssh. За оба сервера выходит около 11 тысяч рублей в месяц.
Из Яндекса я при этом ушел не целиком. Письма по-прежнему идут через их Postbox, ИИ-функции работают на YandexGPT, ночные бэкапы лежат в их Object Storage, а вход через Яндекс ID никуда не делся. Переехали только сервер и база, то есть то, что жило в одной зоне.
Первый сервер с первого раза не создался:
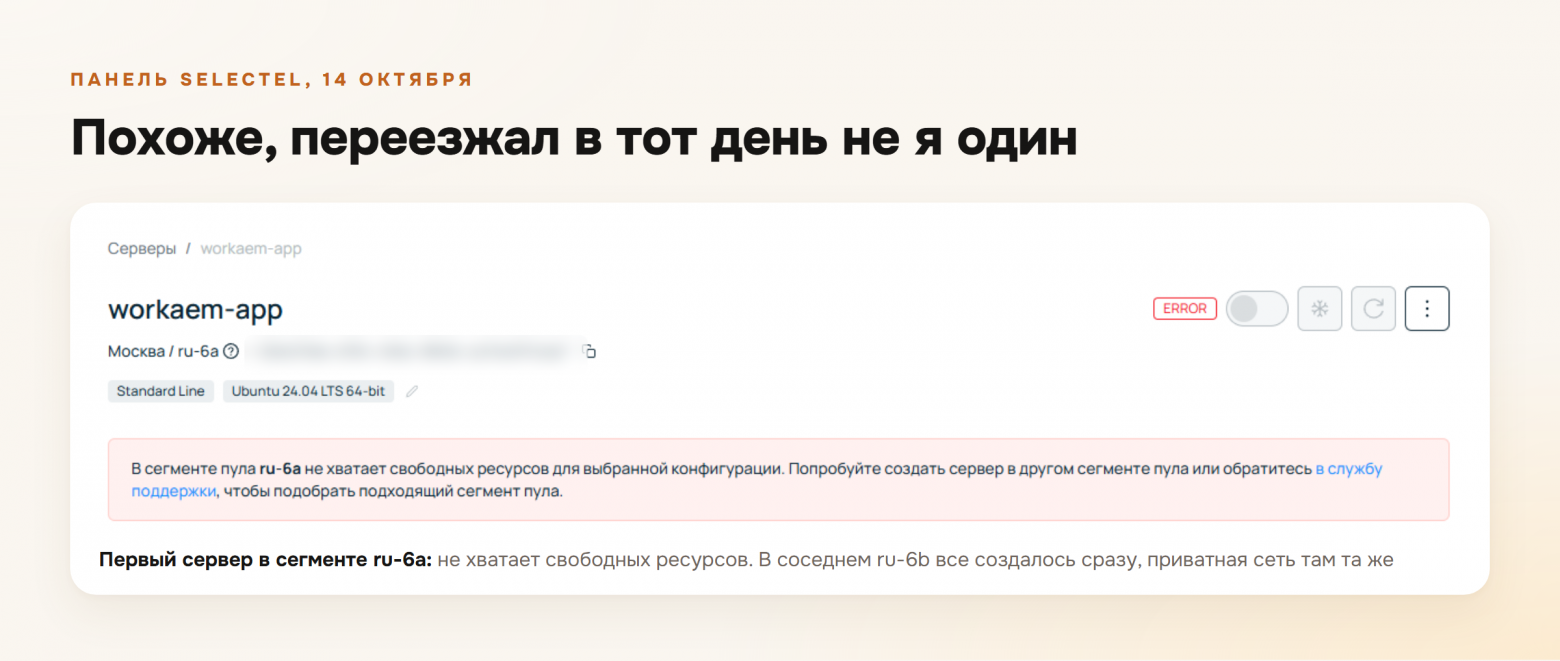
«В сегменте пула ru-6a не хватает свободных ресурсов для выбранной конфигурации». Похоже, переезжал в тот день не я один. В соседнем сегменте ru-6b все создалось без вопросов, а приватная сеть там та же.
Дальше восстановление по шагам, порядок тут важен:
1. Роли и базовые схемы, затем первый запуск GoTrue и хранилища: свои схемы они создают сами.
2. Из дампа схема и данные public, пока без индексов и ключей.
3. Аккаунты из профилей.
4. Проверка, что каждая ссылка на auth.users находит строку. Считать от суперпользователя: под обычной ролью auth.users из-за RLS выглядит пустой.
5. Индексы, ключи, триггеры и политики.
6. Права из миграций.
7. Бакеты и файлы. Файлы пользователей лежали в том же Object Storage, на чтение оно работало, и их я просто перезалил.
DNS я переключил 14 октября около 10:40 по Москве, и сайт открылся уже с новых серверов. Первый прогон CI и деплоя на новом раннере прошел зеленым. Ночи я ждать не стал и прогнал весь конвейер вакансий руками сразу после переезда: за неделю каталог заметно устарел, про это ниже распишу.
Секреты жили в одном файле
Следующая неприятность нашлась очень быстро. Все ключи жили в одном .env на той самой виртуалке, и копии у меня не было. Вместе с виртуалкой ушли:
- ключи VAPID для браузерных пуш-уведомлений. С новыми ключами старые подписки не работают, подписываться нужно заново;
- ключ сервисного аккаунта Google для Indexing API. У себя я нашел только его идентификатор, а сам ключ Google показывает один раз, при создании;
- секреты релеев на Cloudflare Workers, через которые сервер ходит в Telegram и на пару сайтов, куда из российского дата-центра не попасть;
- и еще по мелочи, вроде секрета для бота игры.
Все это пришлось выпускать заново и раскладывать по местам. Ничего сложного, но список длинный, и составлять его лучше заранее.
Почта, которой нет
Теперь про почту. Selectel по умолчанию закрывает исходящие 25, 465 и 587, чтобы с его серверов не слали спам, и открывает по тикету. Пока порт закрыт, ни одно письмо не уходит. А значит, новый пользователь не может подтвердить почту, а старый не может сбросить пароль. Не работало ровно то, что после переезда было нужно всем.
Хуже того, закрытый порт оказался не просто закрытым. Пакеты молча отбрасываются, а у nodemailer по умолчанию две минуты на соединение. Каждый запрос, который где-то внутри отправлял письмо, висел эти две минуты. Форма обратной связи у человека. И ответ платежному шлюзу на уведомление об оплате. Первым делом я урезал ожидание:
nodemailer.createTransport({
  // ...
  connectionTimeout: 10_000,
  greetingTimeout: 10_000,
  socketTimeout: 30_000,
});
Тикет я отправил, но ждать не хотелось, и тут выяснилось, что от порта почта может вообще не зависеть. Postbox, почтовый сервис Яндекса, которым я и так пользовался, принимает письма по HTTP API, совместимому с Amazon SES v2. А 443 у Selectel открыт. Теперь приложение подписывает запрос по SigV4 и отправляет письмо обычным HTTPS. AWS SDK ради одного запроса я тащить не стал, подпись своя, на 70 строк, и сверена с эталонным примером из документации AWS.
С письмами самого GoTrue сложнее, он умеет отправлять их только по SMTP. Зато у него есть Send Email Hook: вместо отправки GoTrue вызывает ваш адрес с подписью по стандарту Standard Webhooks, и дальше письмо ваше. Мой роут проверяет подпись, собирает письмо из тех же шаблонов и отправляет тем же HTTP API. На этом пути тоже нашлась пара граблей:
- при смене почты имена хэшей у GoTrue перепутаны: token_hash_new идет на текущую почту, а token_hash на новую. Это сделано ради совместимости, но если поверить названиям, ссылки уедут не туда;
- адрес хука GoTrue проверяет при старте, даже если хук выключен, и без секрета просто не запускается.
Письма пошли 15 октября, через сутки после переезда. Все эти сутки зарегистрироваться по почте было нельзя, только через Яндекс ID и VK ID. Порты мне теперь не нужны, SMTP остался запасным путем.
Как сказать человеку, что старый пароль не подойдет
Человек вводит старый пароль, видит «неверный пароль» и не понимает почему. Рассказать про аварию надо было там, где он с ней столкнется.
Получилось три места. Строка на странице входа: что случилось и что пароль надо задать заново. Окно на главной, один раз. И запись в разделе обновлений.
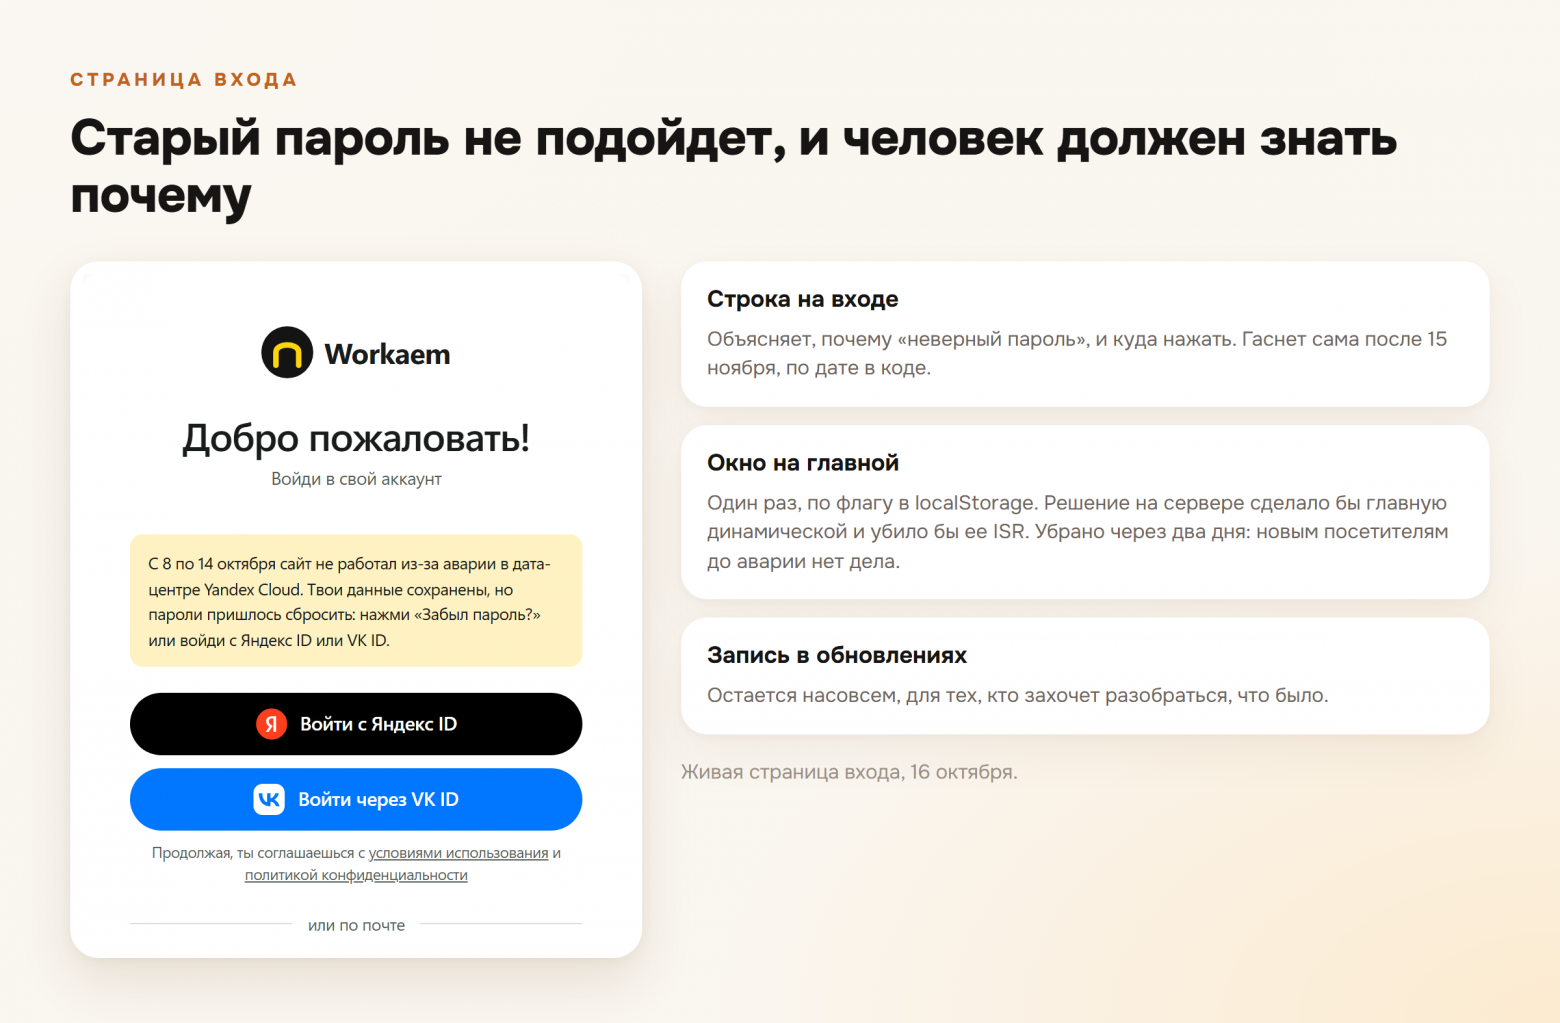
Окно показывается только в браузере, по флагу в localStorage. Главная у меня отдается из ISR-кэша, и решение «показывать или нет» на сервере сделало бы ее динамической, а заодно поменяло бы то, что видит поисковик. Строка и окно гаснут сами после 15 ноября, по дате в коде, чтобы через месяц никто не читал про аварию, которую все уже забыли.
Окно, кстати, я убрал через два дня. Оно встречало каждого нового посетителя и закрывало ему главную, а тому, кто пришел впервые, до моей аварии нет никакого дела. Строка на входе осталась: она нужна тому, кто придет со старым паролем.
И письмо всем пользователям, когда заработала почта:
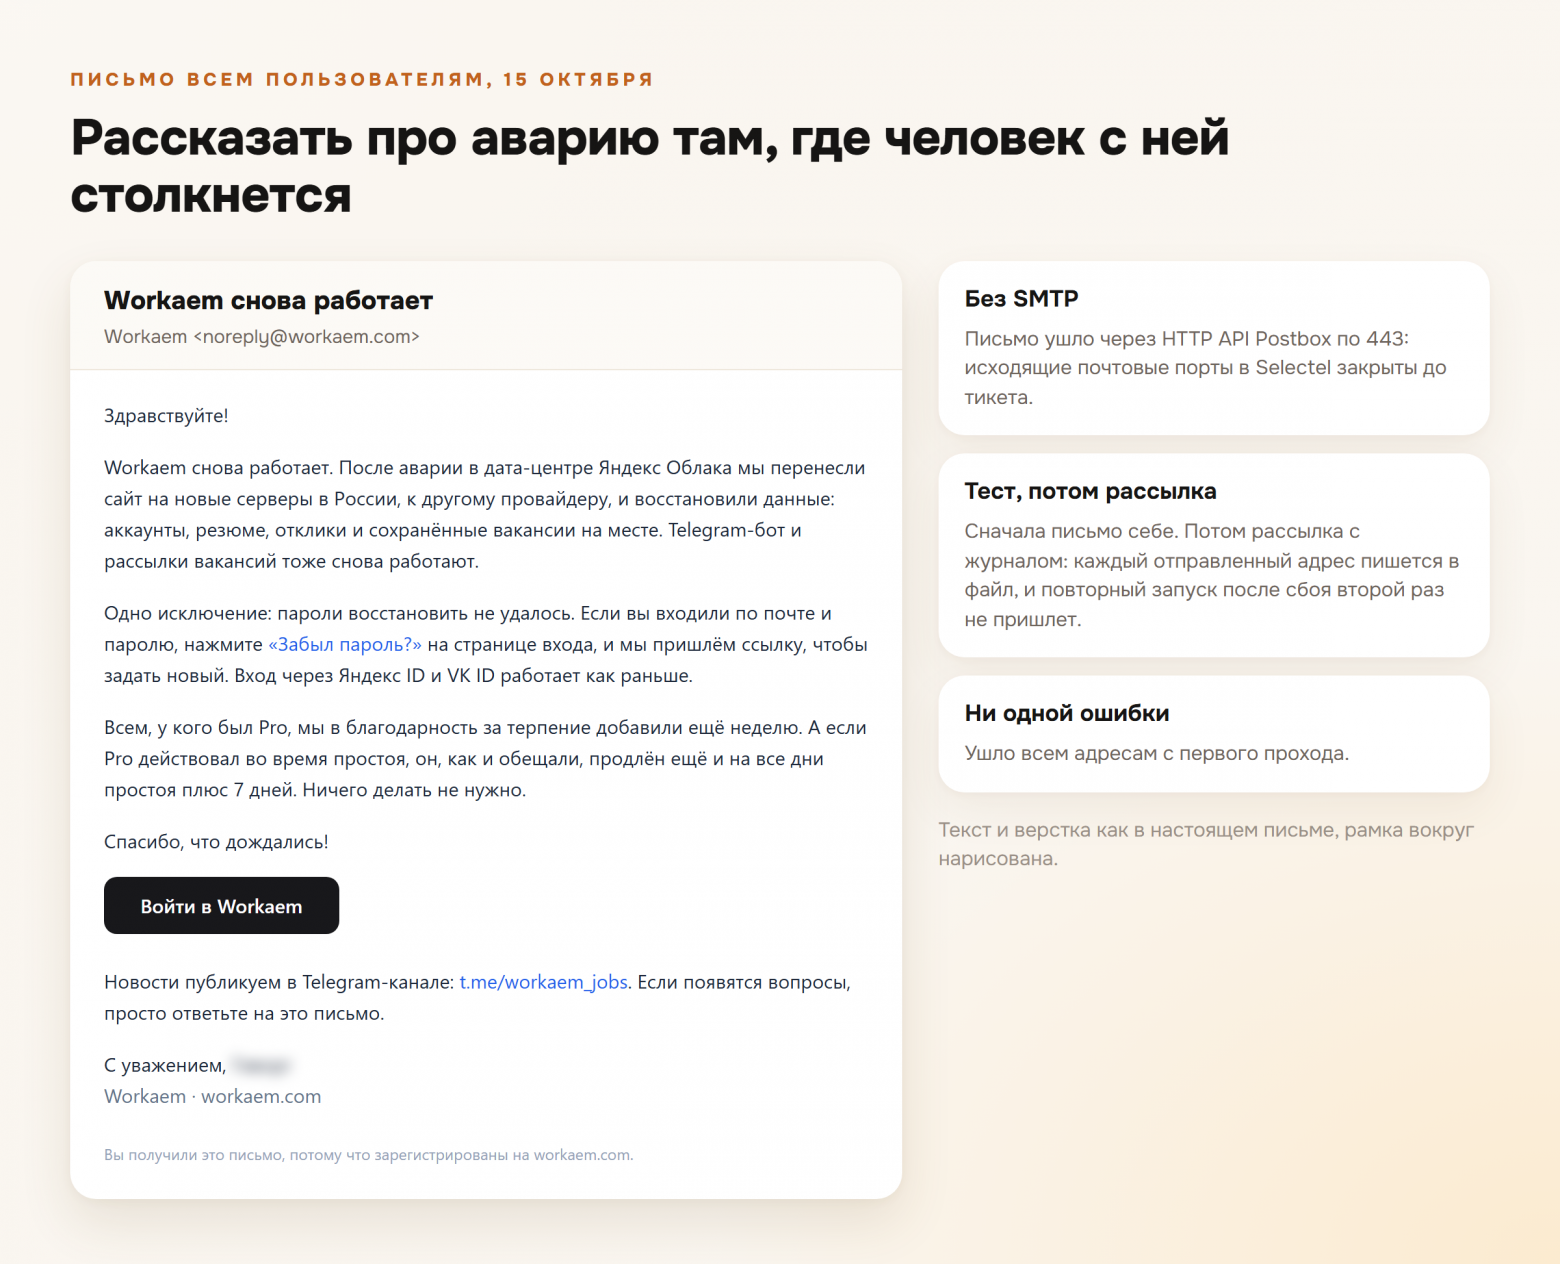
Отправлял его тем же HTTP API, разовым скриптом. Сначала тестовое письмо себе, потом рассылка с журналом: каждый отправленный адрес пишется в файл, и повторный запуск после сбоя никому не пришлет письмо второй раз. Ушло без единой ошибки.
Отдельно про платную подписку.
Тем, у кого Pro действовал во время простоя, я продлил его на все дни простоя и еще на неделю сверху, это было обещано и в окне, и в письме. Тем, кто покупал Pro раньше и у кого он успел закончиться, подарил неделю.
Еще одно место, про которое легко забыть, это политика конфиденциальности. Там написано, где хранятся данные, и написано было про Яндекс. Переписал на Selectel, а обещание «шифрования при хранении» убрал совсем. Диски новых серверов не зашифрованы, и оставлять неправду в юридическом тексте нельзя, даже если ее никто никогда не проверит.
Неделя таймаутов для поисковиков
Больнее всего было за поиск. В прошлой статье я писал, как медленно поисковики начинают доверять молодому домену. А тут шесть дней, когда робот приходит и не получает ничего. Даже не 503 «временно недоступно», а просто тишину: машина, которая могла бы отдать заглушку, умерла первой.
Для агрегатора вакансий это хуже, чем для обычного сайта. Вакансия живет несколько недель, и неделя без обхода это закрытые вакансии, которые висят в выдаче открытыми, и новые, которые в выдачу так и не попали. Когда сайт поднялся, конвейер в первые же сутки закрыл 6 437 вакансий и добавил 5 858 новых. В обычный день и то и другое исчисляется сотнями и лишь изредка переваливает за тысячу.
О новых и закрытых вакансиях Google я сообщаю через Indexing API, а у него квота 200 адресов в сутки. Закрытым я отдаю не больше половины: за просроченные вакансии в выдаче Google наказывает сайт, но если отдать закрытым все, новые будут ждать сутками. С Яндексом и Bing проще, через IndexNow за раз можно отправить тысячи адресов.
После переезда я проверил карты сайта, robots.txt, разметку и коды ответов, переотправил карты в Вебмастере и Search Console и разово отправил в IndexNow главные разделы, подборки и страницы компаний. Остальное поисковики должны досмотреть сами.
А вот чего я не сделал, хотя мог. В первый же час переключить DNS на страницу с 503 и Retry-After у любого другого провайдера. Для робота это значит «временно, зайди позже», и это гораздо лучше, чем неделя таймаутов. DNS, как выяснилось, был полностью в моих руках, а я до этого просто не додумался.
Что сломалось уже после переезда
Сайт открылся, и следующие сутки я искал то, что сломалось тихо. Нашлось немало, и почти всегда по одной причине: что-то жило только на старом сервере.
Игра на поддомене отдавала 404 на все подряд. Caddy читает ее статику из тома, а строка про этот том была только в docker-compose на старой виртуалке. В репозитории ее не было никогда.
Ежедневный снимок схемы базы упал при первом же запуске. Скрипты ходили в базу с sslmode=verify-full и корневым сертификатом управляемого PostgreSQL Яндекса, которого на новом сервере, понятно, нет.
Кнопка привязки Telegram в кабинете перестала строить ссылку на бота. Переменная NEXT_PUBLIC_* вклеивается в бандл при сборке, а сборка в Docker видит только то, что явно передано в build args. Этой переменной в compose из репозитория не было. Теперь тест сверяет каждую NEXT_PUBLIC_*, которую читает код, с Dockerfile и compose, и следующая такая переменная упадет уже в CI.
Потом я сел и прошелся по базе списком. Если будете переносить Postgres из дампа, вот что я бы проверил:
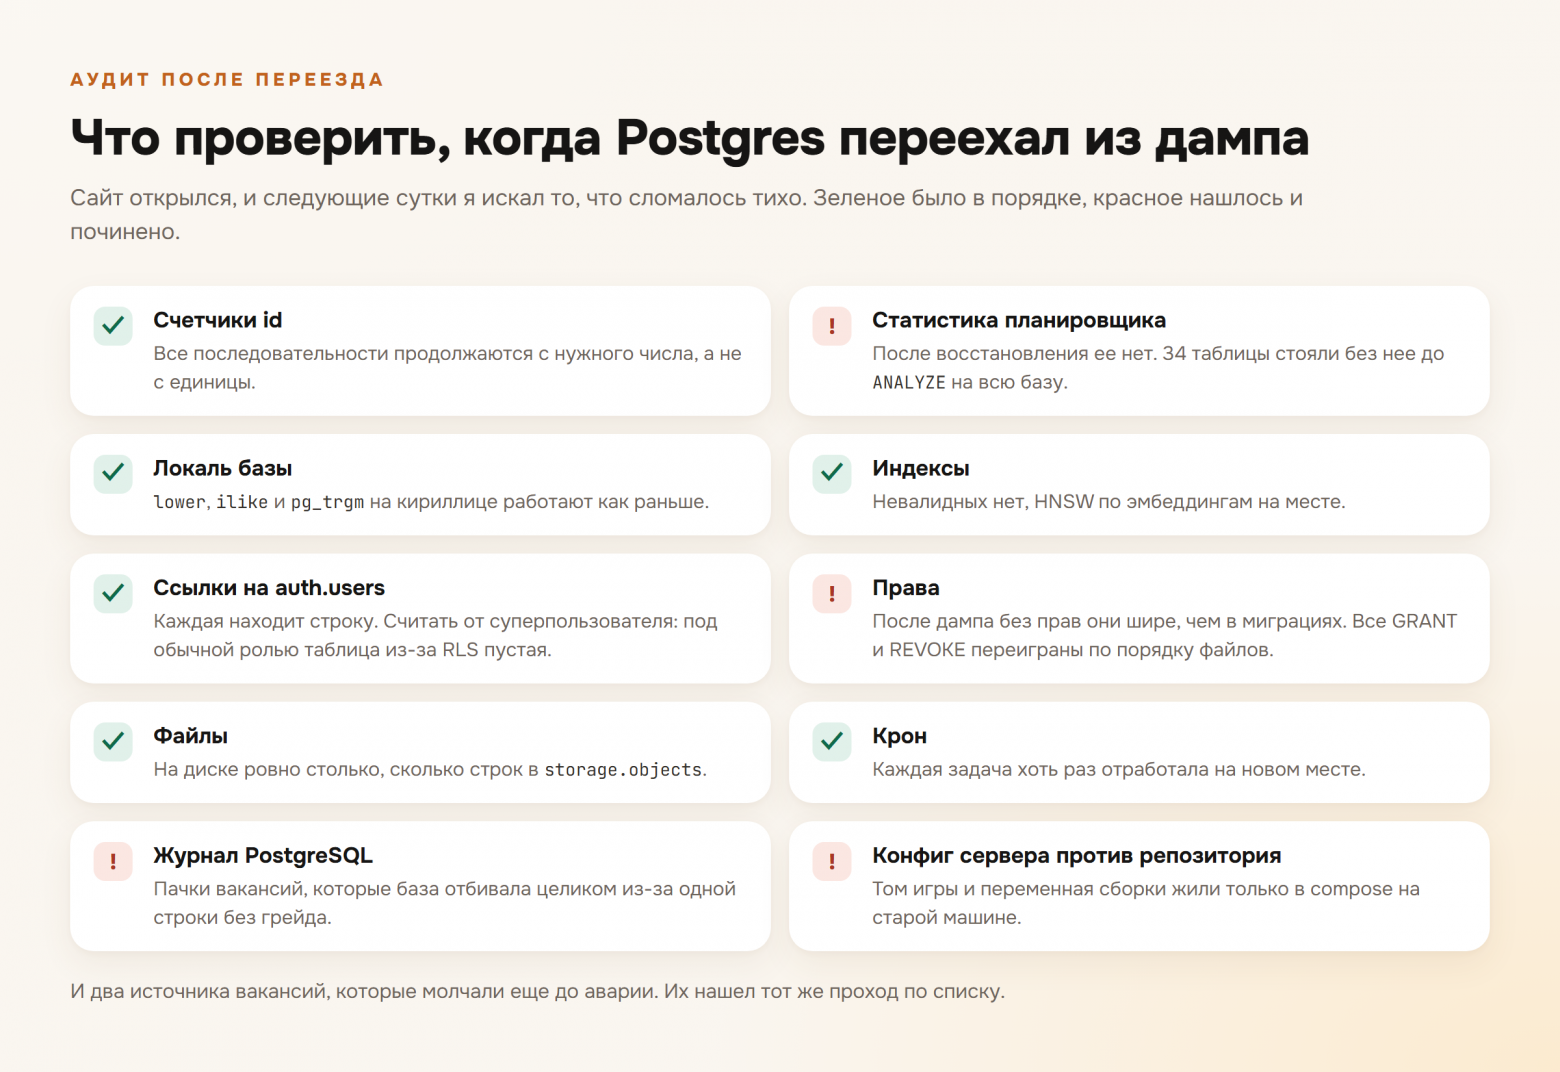
Самым неожиданным для меня была статистика. После восстановления из дампа у таблиц нет статистики планировщика, и 34 таблицы так и стояли без нее, пока я не запустил ANALYZE на всю базу. Автовакуум дошел бы до них сам, но когда-нибудь потом, а запросы шли уже сейчас.
А еще я впервые за все время открыл журнал PostgreSQL. На управляемом кластере он был где-то в консоли, и я туда не заглядывал. Здесь это файл на диске, и в нем нашлась ошибка, которая, судя по всему, была и раньше. Вакансии пишутся пачками, и если хоть у одной в пачке не было грейда, база отбивала всю пачку вместе с соседями. PostgREST в пачке подставляет недостающему ключу NULL, а не default колонки, а колонка обязательная. Две потерянные пачки на каждом прогоне.
И две вещи к аварии отношения не имели вовсе. Хабр Карьера и часть российских карьерных сайтов молчали у меня с конца сентября, то есть еще до аварии, и этого никто не заметил, включая меня. Нашел их тот же проход по списку. Сейчас оба источника снова приносят вакансии, а Хабр к тому же читается целиком раз в сутки.
Деплой на сорок минут
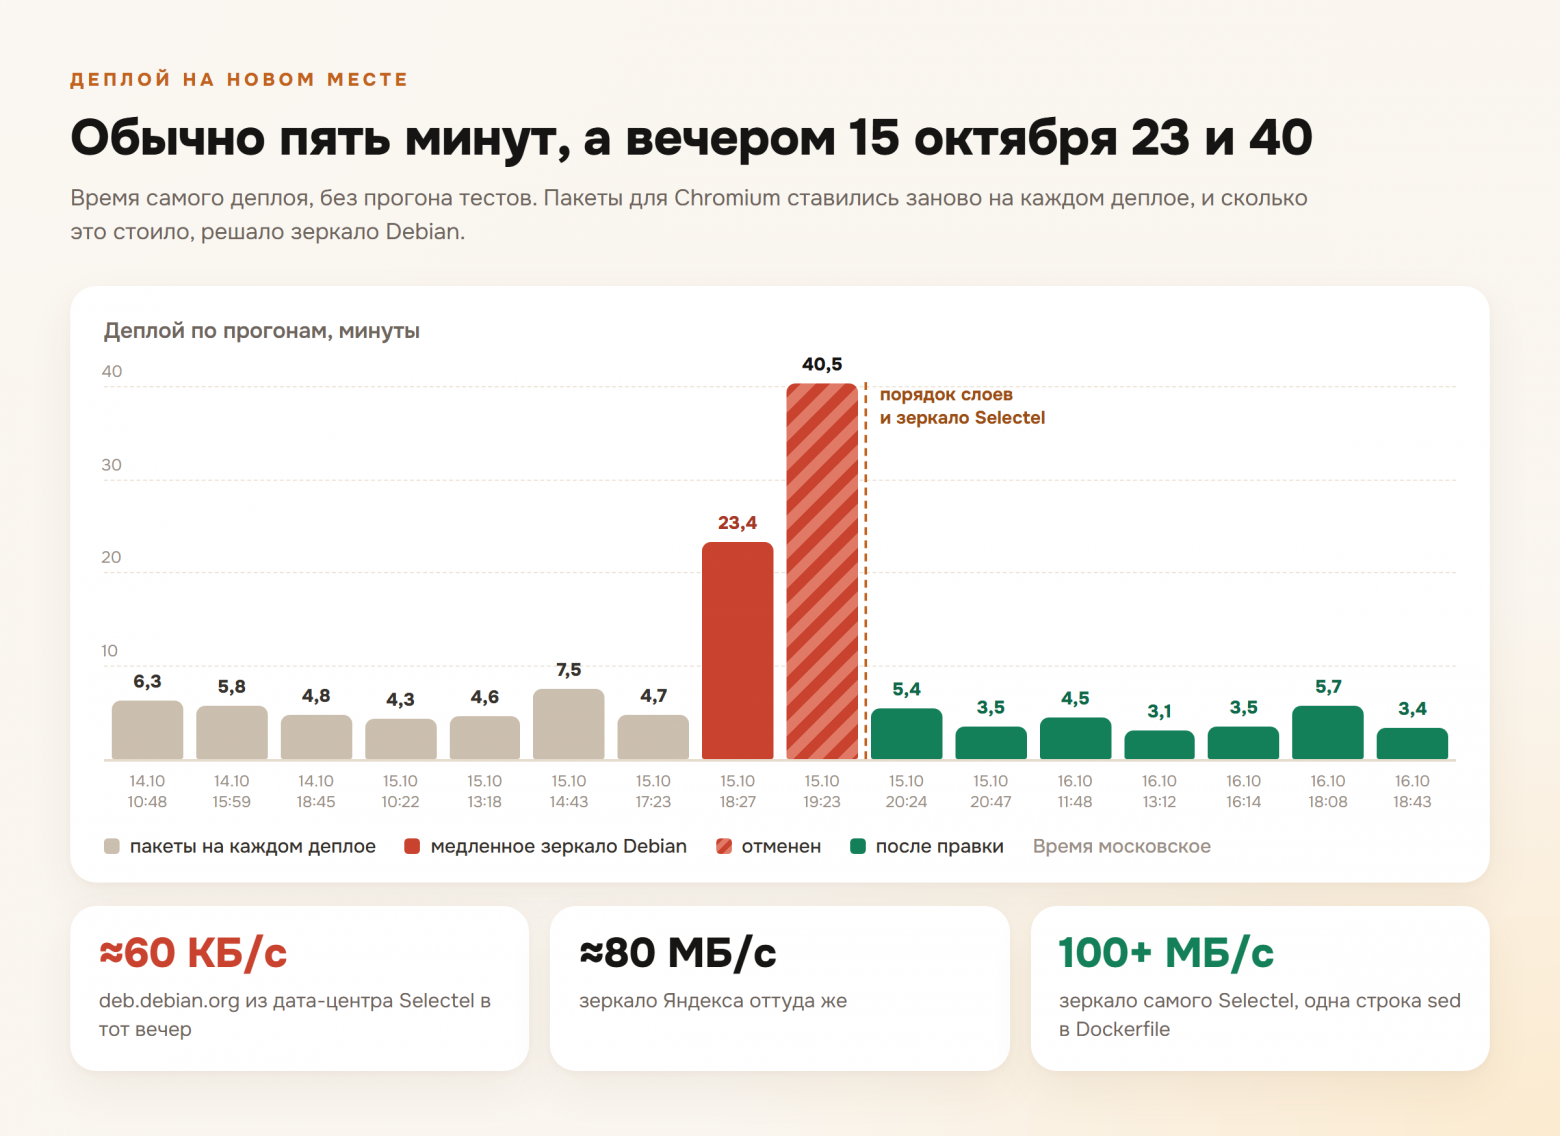
Последним вылезло почти смешное. Обычно деплой на новом месте шел минут пять, но вечером 15 октября один прогон занял 23 минуты, а следующий я отменил на сороковой. Большую часть этого времени ставились системные пакеты для Chromium, он у меня рисует PDF резюме. Причин оказалось две, и обе мои.
Первая в Dockerfile. В финальной стадии копия собранного приложения стояла раньше apt-get, а она новая на каждом коммите и сбрасывает кэш всех слоев после себя. Пакеты ставились заново при каждом деплое всегда, просто пока зеркало отвечало быстро, это стоило минуту-другую, и я не замечал. Теперь сначала идет все, что меняется только вместе с зависимостями, и лишь в конце сама сборка:
RUN node ./node_modules/playwright/cli.js install-deps chromium \
&& apt-get update && apt-get install -y --no-install-recommends fonts-dejavu-core ca-certificates curl
COPY --from=browser /ms-playwright /ms-playwright
сборка меняется на каждом коммите, поэтому она последняя
COPY --from=builder /app/.next/standalone ./
Вторая причина снаружи. deb.debian.org отдавал в дата-центр Selectel около 60 КБ/с. Зеркало самого Selectel отдает оттуда больше 100 МБ/с, зеркало Яндекса около 80. Одна строка в Dockerfile:
RUN sed -i 's|http://deb.debian.org|http://mirror.selectel.ru|g' /etc/apt/sources.list.d/debian.sources
Сейчас сам деплой, без прогона тестов, идет от трех до шести минут, и от настроения зеркала Debian больше не зависит.
Что я теперь делаю иначе
Банальная вещь, которую я, конечно, знал и раньше: бэкап, из которого ни разу не восстанавливались, ничего не гарантирует. Знал, но ни разу не пробовал. Теперь так.
Ночной дамп уезжает в Object Storage Яндекса, то есть ровно туда, откуда я только что уехал. Звучит как ирония, но в этом и есть смысл: прод и бэкап у разных провайдеров, и авария одного не уносит оба. А хранилищу Яндекса я после этой недели все же доверяю, оно свою аварию пережило.
Дамп снимается со всей базы, со всеми схемами, владельцами и правами. Снимает его отдельная роль с pg_read_all_data и BYPASSRLS: под обычной ролью auth.users из-за RLS не читается. Скрипт проверяет размер дампа, потому что огрызок вместо бэкапа хуже, чем ничего, а если бэкап не снялся, мне приходит сообщение в Telegram.
Новый бэкап я восстановил в отдельную базу и сравнил: данные, права, владельцы, политики и триггеры совпали. Пока это сделано руками и один раз. Проверку по расписанию я еще не сделал, и это первый пункт в списке.
Копия секретов теперь живет вне серверов. А все, что настроено только на сервере, рано или поздно умрет вместе с ним: тома, переменные сборки, строки в compose. Перед выводами я теперь сверяю конфиг на сервере с репозиторием.
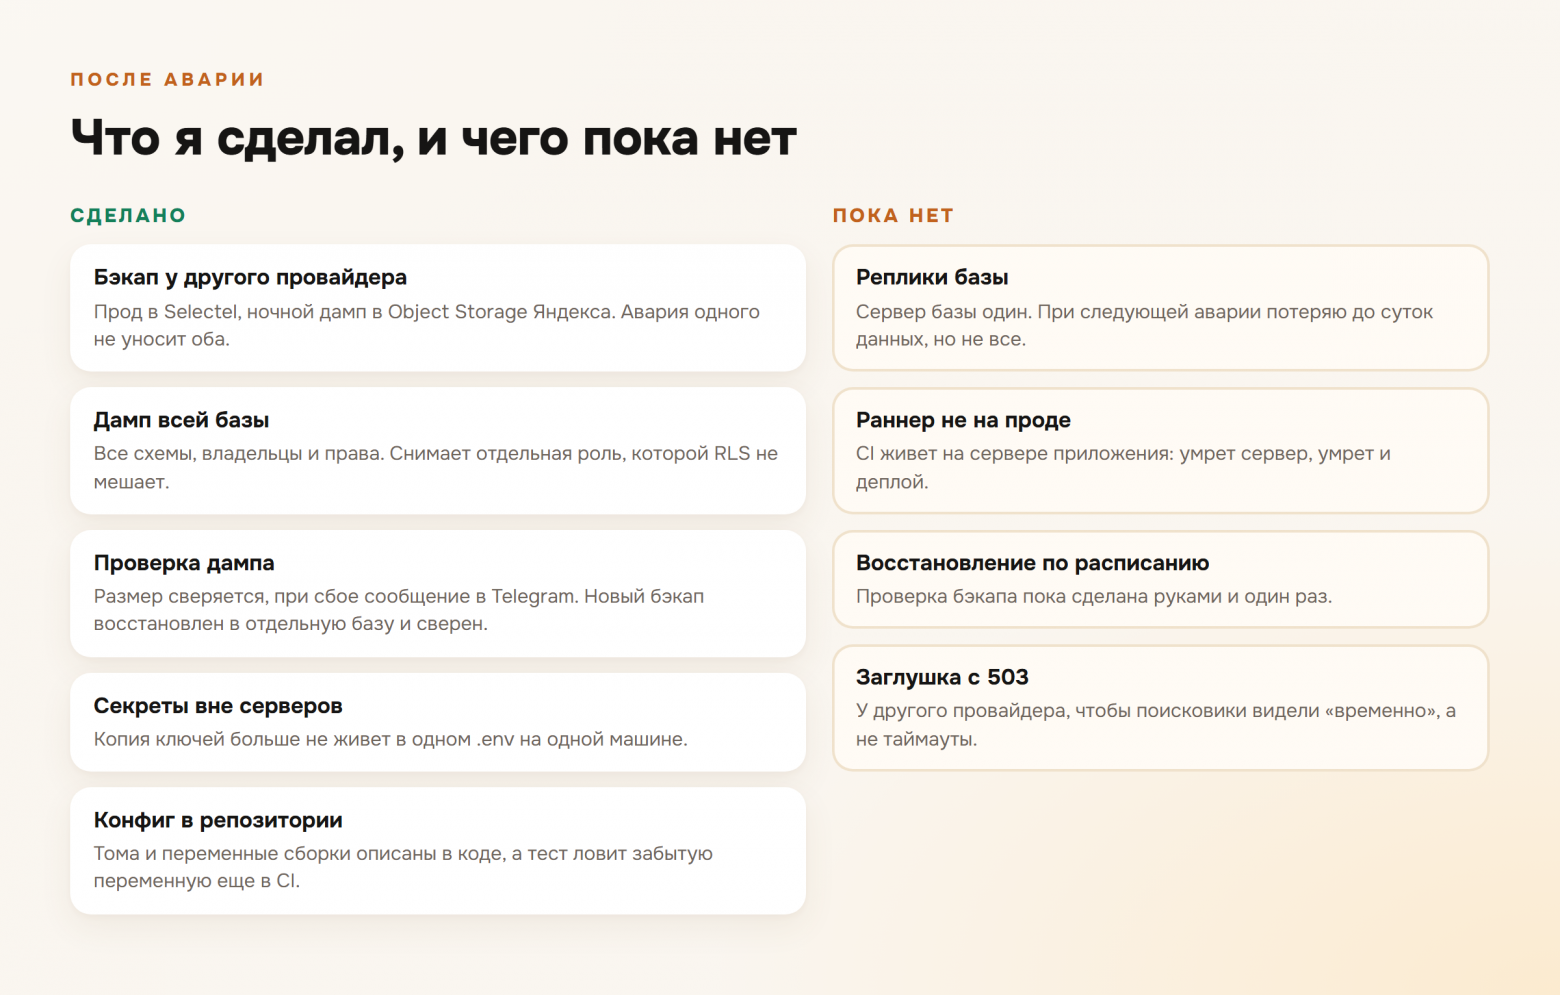
Чего я так и не сделал. Реплики базы нет и сейчас, сервер базы один. При следующей аварии я потеряю до суток данных, но не все, и на этом этапе проекта такой размен меня устраивает. Раннер CI все так же живет на сервере приложения: облачные раннеры GitHub для моего аккаунта недоступны, биллинг не принимает российский адрес. Умрет сервер, умрет и деплой. Зато теперь есть инструкция, как поднять все с нуля, проверенная на настоящем собственном переезде.
Что в итоге
Шесть дней без сайта для маленького проекта это много. Но могло быть и хуже: данные целы, а у меня появился первый настоящий опыт переезда прода, причем сразу в боевых условиях, без репетиций и с живыми пользователями по ту сторону. Про свою инфраструктуру я за эту неделю узнал больше, чем за все время до нее. Следующий переезд, если он когда-нибудь понадобится, будет по инструкции, а не по наитию.
Отдельное спасибо и слова поддержки команде Yandex Cloud. Неделю они разгребали и продолжают разгребать аварию, которую никто из них не выбирал, и при этом находили время отвечать таким, как я. Надеюсь, дата-центры скоро вернутся в строй.
Проект Workaem снова ожил и живет все также на workaem.com :)
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.