Резолвер здоров, а страницы не открываются: как я сделал отказоустойчивый DoH на MikroTik
В филиальной сети перестала открываться страница, которая до этого работала неделями: сборка Tailwind с CDN уходила в таймаут, остальной интернет жил нормально. Я полез на роутер и увидел картину, которая не сходится с симптомом: :resolve отдаёт валидный адрес, DoH отвечает Status:0, монитор состояния пишет «здоров». Всё зелёное — и при этом у людей не открывается.
Ответ оказался в двух адресах: 8.6.112.0 и 8.47.69.0. Это настоящий ответ Cloudflare, но из той сети до него нет маршрута. Проверка уровня «получил IP или нет» такого не ловит никогда: адрес есть, он валиден, и он бесполезен.
Дальше — путь от первого .rsc до версии 0.4.1. Что я хотел, что сделал не так, каким кодом это проверяется сейчас и где решение до сих пор не тянет. Главная сложность оказалась не в Cloudflare, а в RouterOS: активный DoH-апстрим там ровно один, и отказоустойчивость в него не встроена — её приходится писать самому.
С чего началось
По умолчанию RouterOS прогоняет DNS локальной сети через роутер, и участок «роутер → провайдер» идёт открытым текстом. Мне это не нравилось по двум причинам: содержимое запросов видно на пути, и ответы на этом пути подменяются. Вторая причина не теоретическая: на замерах 26 октября 2026 простой DNS отдавал подменённые ответы даже при запросе напрямую к 1.1.1.1 и 8.8.8.8.
Включить DoH оказалось делом одной строки: /ip dns set use-doh-server=... verify-doh-cert=yes. Я поставил фильтрующий резолвер Cloudflare Family, проверил, что имена разрешаются, и решил, что задача закрыта. Через несколько дней позвонили из филиала.
Первым подозреваемым была фильтрация — в первой версии по умолчанию стоял именно Family, а «не открывается» чаще всего значит «отфильтровано». Подозреваемый не подошёл: ответ приходил Status:0 и с валидной A-записью, и точно такая же пара адресов приходила с обычного, нефильтрующего эндпоинта. Тогда я выключил DoH и прогнал те же имена через простой DNS — те же два адреса. Дальше оставалось проверить уже не резолвер, а маршрут до ответа.
Проверять надо с клиента, а не с роутера: /tool fetch не отличает мёртвый маршрут от отказа HTTP-сервера. Клиентская проверка выглядит так:
nslookup cdn.tailwindcss.com
curl -sS -o /dev/null --max-time 10 \
  --resolve cdn.tailwindcss.com:443:8.6.112.0 \
  -w '%{http_code} %{time_total}s\n' https://cdn.tailwindcss.com/
С шлюза эта команда отдавала 302 примерно за 0,2 секунды, из филиальной сети — таймаут. Один и тот же адрес, разный результат: вопрос был не в DNS, а в том, есть ли до этого адреса путь.
Что я хотел получить и чего RouterOS не умеет
Требований было три, и все — про поведение при отказе, а не про «включить шифрование»:
запросы из локальной сети уходят в интернет по HTTPS и с проверкой сертификата;
клиенты, которые ходят на роутер как на резолвер, не обходят это своим открытым DNS;
когда основной эндпоинт перестаёт отвечать, сеть переезжает на резервный сама, и так же сама возвращается обратно.
Первые два пункта RouterOS закрывает настройкой. Третий — нет, и причина не в прошивке: use-doh-server — один. Списка апстримов не существует, а конструкция /ip dns static-server type=doh, которую советуют в некоторых инструкциях, не синтаксис RouterOS вовсе: такого пути в системе нет, и резервирования он не даёт.
Что схема гарантирует и чего не гарантирует:
Гарантирует | Не гарантирует |
|---|---|
Трафик роутер → апстрим идёт по HTTPS с проверкой сертификата | Что клиент не пойдёт своим DoH по 443 или DoT по 853 |
Активен один DoH-апстрим; при отказе монитор переключает на второй и возвращает обратно | Что провайдер DNS достоин доверия: выбор Cloudflare, Google или Quad9 — это выбор третьей стороны |
Классический DNS (UDP и TCP 53) из локальной сети перенаправляется на роутер | Что недостижимый ответ станет достижимым: сменой резолвера это не лечится |
Ещё два ограничения выяснились сразу и стоили вечеров. Первое: servers при включённом DoH — это только bootstrap для имени эндпоинта, а не резерв. Если DoH не отвечает, RouterOS не откатывается на servers — разрешение имён просто останавливается. Второе: адреса эндпоинтов надо закрепить статикой, иначе получается замкнутый круг — проба ходит по имени, имя надо разрешить, а резолвер уже мёртв.
Рабочая часть выглядит скромно: четыре статические записи для двух хостов (основного и резервного), один апстрим, проверка сертификата.
/ip dns static add name=$dohHost address=$dohServerA ttl=1d comment="DoH bootstrap"
/ip dns static add name=$dohHost address=$dohServerB ttl=1d comment="DoH bootstrap"
/ip dns static add name="dns.google" address=8.8.8.8 ttl=1d comment="DoH bootstrap (fallback)"
/ip dns static add name="dns.google" address=8.8.4.4 ttl=1d comment="DoH bootstrap (fallback)"
/ip dns set servers=$dohServers
/ip dns set use-doh-server=$dohUrl verify-doh-cert=yes
И отдельным шагом — якорь доверия. Здесь я ошибся в первый раз, и ошибка была не в коде, а в чтении документации: в статьях встречается параметр builtin-trust-anchors, которого в RouterOS нет. Настоящий параметр — builtin-trust-store, и встроенное хранилище цепочку Cloudflare не покрывает. Итог выглядит страшнее, чем есть: с verify-doh-cert=yes и без импортированного CA разрешение имён останавливается полностью, вся сеть остаётся без DNS, а в журнале появляется no trusted CA certificate found (6).
Корень для Cloudflare — SSL.com TLS ECC Root CA 2022, а не DigiCert и не GlobalSign: цепочка там Cloudflare Inc → SSL.com → Comodo AAA. Для резервного хоста нужен свой корень; про это отдельный раздел ниже, потому что именно на нём ломается откат.
Первая версия: три ошибки, которые видно только в поле
Версия 0.1.0 от 22 октября 2026 формально делала всё, что я задумал: DoH, принудительный DNS для локальной сети, проверка состояния и переключение. Она же научила меня главному: скрипт, который «проверяет состояние», может быть опаснее его отсутствия.
Ошибка первая: проверка судила тип ответа, а не ответ. Код смотрел, что :resolve вернул значение типа ip, и на этом успокаивался. Пара 8.6.112.0 / 8.47.69.0 — валидный адрес, и на этом проверка заканчивалась. Более того, в собственной таблице проверок 0.1.0 эта пара записана как real IP. Не опечатка, а дефект метода: я проверял, что резолвер ответил, вместо того чтобы проверить, что он ответил пригодным.
Ошибка вторая: проба ходила через переключение. Чтобы проверить эндпоинт, скрипт ненадолго переставлял use-doh-server и смотрел, что получится. Побочный эффект обнаружился не сразу: каждая плановая проверка снимала локальную сеть с DoH. Резолвер исправно работал, только уже без шифрования, и это происходило каждые три минуты.
Ошибка третья: резервом был открытый DNS. Логика «если шифрованный канал упал, вернёмся на простой» выглядит разумной, пока не измеришь, что приходит по простому каналу. На замерах 1.1.1.1 и 8.8.8.8 отдавали подменённые ответы — то есть откат в plain DNS превращал заметную аварию в незаметную, что хуже: админ видит «интернет работает», а часть имён уже подменена. Плюс к этому при неудачном переключении роутер оставался на мёртвом эндпоинте: проверки после переключения не было.
Мелочи того же периода: принудительный DNS был сделан через dst-nat to-addresses=<ip роутера> (работает, но адрес захардкожен, а правило умеет получать флаг invalid) — заменено на action=redirect; политика скрипта стояла полным набором прав вместо read,write,policy,test.
Версия 0.2.0 меняла пять вещей, и все пять — про одно: перестать доверять внешнему признаку.
Было в 0.1.0 | Стало в 0.2.0 |
|---|---|
апстрим по умолчанию — фильтрующий Family | стандартный резолвер, фильтрация — осознанная опция |
откат в простой DNS | второй DoH-эндпоинт |
здоров, если ответ имеет тип | здоров, если ответ пригоден по содержимому |
проба переключает | проба — HTTPS-запрос к DNS-JSON API, |
неудачное переключение оставляло на мёртвом эндпоинте | проверка после переключения и откат при неудаче |
Проверять надо ответ, а не тип
Критерий пригодности получился коротким: три контрольных имени, и ответ считается плохим, если он пустой, если это 0.0.0.0 (так отвечает фильтрующий резолвер) или если он попадает в известную пару-заглушку. Имена выбраны не случайно — это те, что реально ломались: example.com, cdnjs.cloudflare.com, cdn.tailwindcss.com.
:foreach d in=$probeGood do={
    :local ip ""
    :do { :set ip [:tostr [:resolve $d]] } on-error={ :set ip "" }
    :local stub 0
    :if ([:len $ip] > 0) do={
        :foreach p in=$stubPrefixes do={ :if ([:find $ip $p] >= 0) do={ :set stub 1 } }
    }
    :if ($stub = 1) do={ :set stubSeen 1 }
    :if (($ip = "") or ($ip = "0.0.0.0") or ($stub = 1)) do={
        :set bad ($bad + 1)
    } else={
        :set good ($good + 1)
    }
}
Здесь же спрятана вторая ловушка, которую я нашёл позже, чем хотел. Проверка содержимого идёт через живой резолвер, а он отвечает из кеша. Основной эндпоинт мог умереть, кеш — ещё держать валидные ответы, и монитор видел «здоров». Переключение откладывалось на время жизни TTL. В 0.3.1 это вылечено: отказ определяется по состоянию эндпоинта (проба не прошла) вместе с проверкой содержимого, а не только по ответам из кеша.
С неверными часами проверка сертификата не может пройти в принципе. Плохая дата выглядит ровно как «DoH лёг», и скрипт без защиты жёг бы попытки переключения бесконечно. Поэтому первым делом монитор смотрит дату и отказывается работать, если она вне диапазона 2025..2035 — причём проверяются и прошлое, и будущее: дата из будущего проходит проверку «год больше 2025» и всё равно ломает verify-doh-cert.
Пара 8.6.112.0 / 8.47.69.0 — почему смена резолвера не помогает
Пара 8.6.112.0 / 8.47.69.0 — не блокировка и не артефакт фильтра. Это реальный ответ Cloudflare, до которого из части сетей просто нет маршрута, — поэтому смена бренда резолвера ничего не меняет.
Самая дорогая часть истории — не код, а то, сколько времени ушло на это понимание. Замеры 26 октября 2026 с трёх точек:
Запрос | Ответ |
|---|---|
DoH, стандартный эндпоинт, российский провайдер | сначала |
DoH, Family-эндпоинт, та же точка | та же пара |
простой DNS к | та же пара, Google отвечал |
те же вопросы с точки в Германии |
|
|
|
то же из филиальной сети за другим провайдером | таймаут соединения |
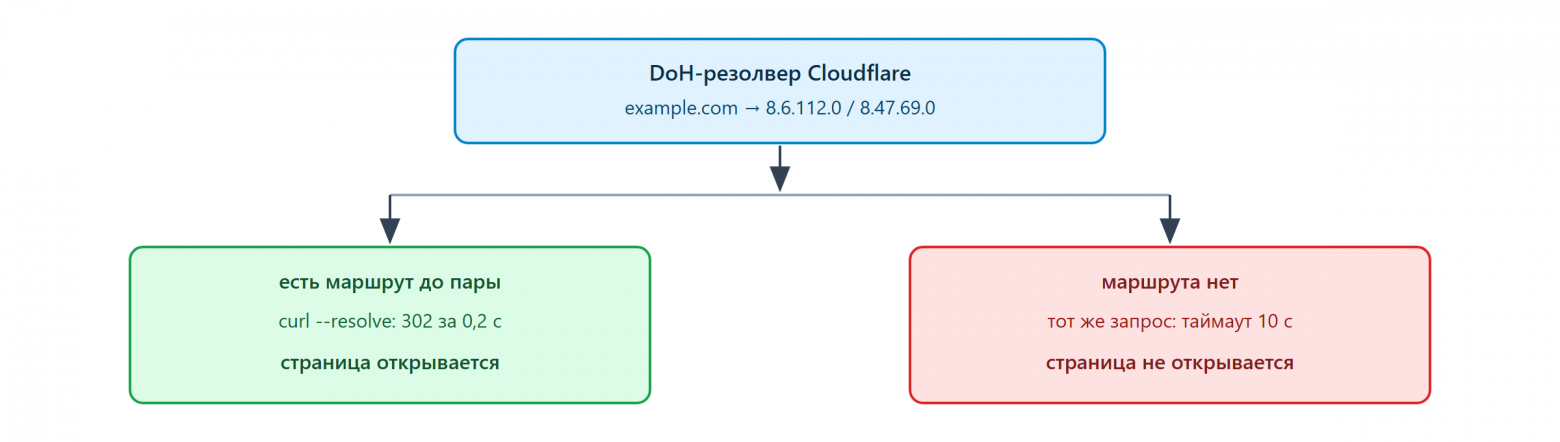
Один и тот же ответ DNS в двух сетях: где маршрут до пары есть, страница открывается, где нет — таймаут.
Не помог и трюк с type=FWD forward-to=1.1.1.1: роутер отправлял запрос простым DNS и получал ту же пару.
Что реально лечило, по итогам проверки на филиальной сети: провести маршрут до пары (или до затронутых префиксов) через рабочий туннель; закрепить достижимые адреса статикой для нужных имён; сменить точку выхода, а не вывеску резолвера. Все три варианта неприятны, и все три — про сеть, а не про DNS. Честнее назвать это пределом: правкой DNS нельзя сделать недостижимый адрес достижимым.
Для монитора я сделал отдельное состояние stub: он пишет в журнал измеренные ответы и не переключается, потому что второй эндпоинт вернёт ту же пару. Из этого случая вырос главный критерий всей схемы: проверять содержимое ответа, а не факт ответа.
Как устроена цепочка сейчас
Сегодня это четыре ступени, упорядоченные по убыванию предпочтительности: основной DoH, второй DoH, третий DoH (опционально, пустой адрес отключает ступень) и простой DNS как последний резерв (по умолчанию выключен). Активна всегда ровно одна — таково ограничение RouterOS.
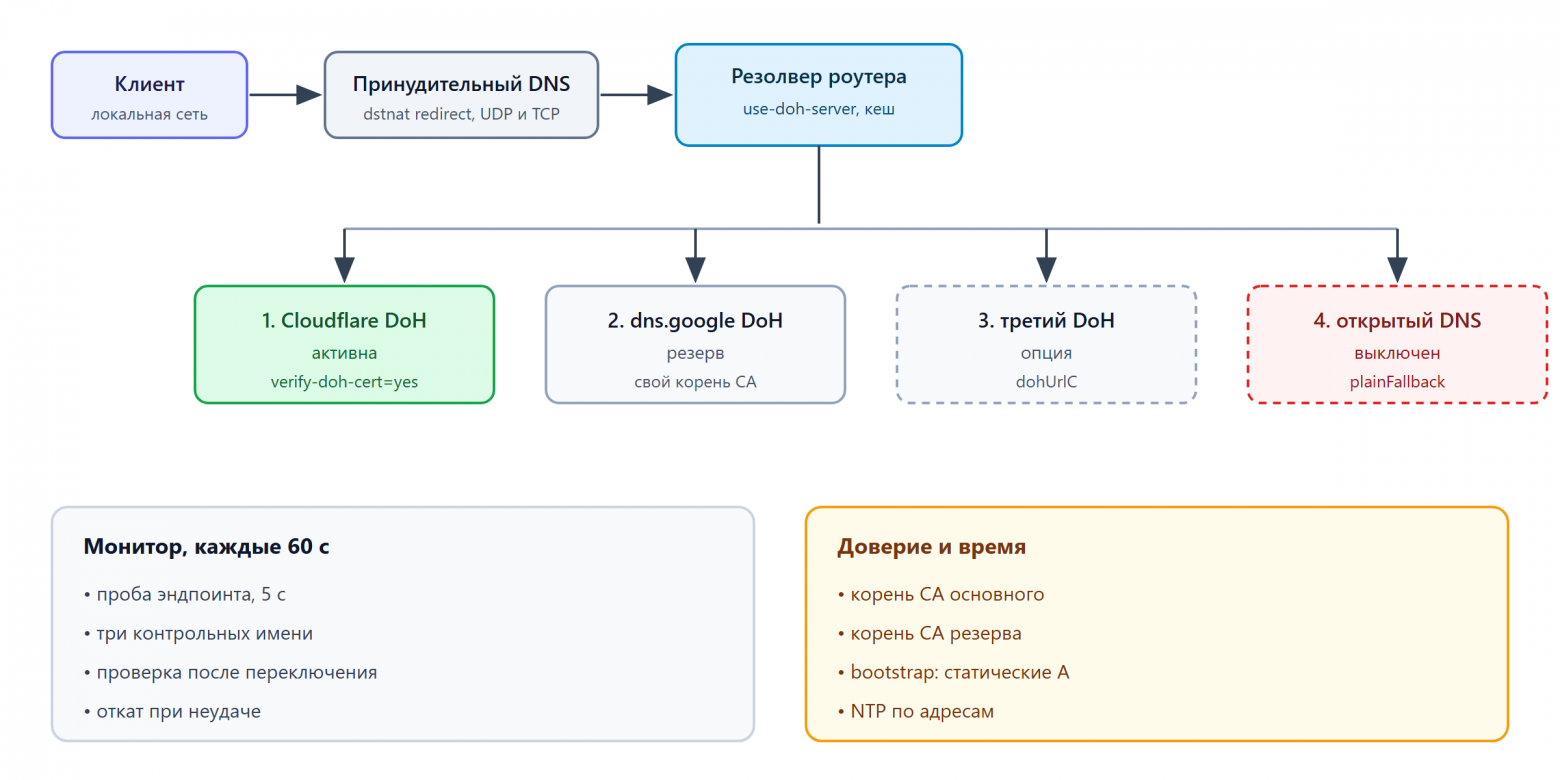
Путь запроса и четыре ступени цепочки: клиент, принудительный DNS, резолвер роутера, эндпоинты DoH и монитор.
Монитор — это скрипт по расписанию (60 секунд по умолчанию). Он держит состояние в глобалах, пишет в журнал только при переходах, чтобы сломанный резолвер не забивал лог, и помечает записи заглавным именем состояния, чтобы их можно было ловить журнальным монитором.
Логика переходов — не набор условий, а автомат с двумя порогами. Порог failureThreshold (2) требует двух плохих прогонов подряд до переключения, recoveryThreshold (2) — двух хороших до возврата. Это гистерезис против дребезга: при интервале 60 секунд переключение занимает около двух минут устойчивой деградации, возврат — столько же.
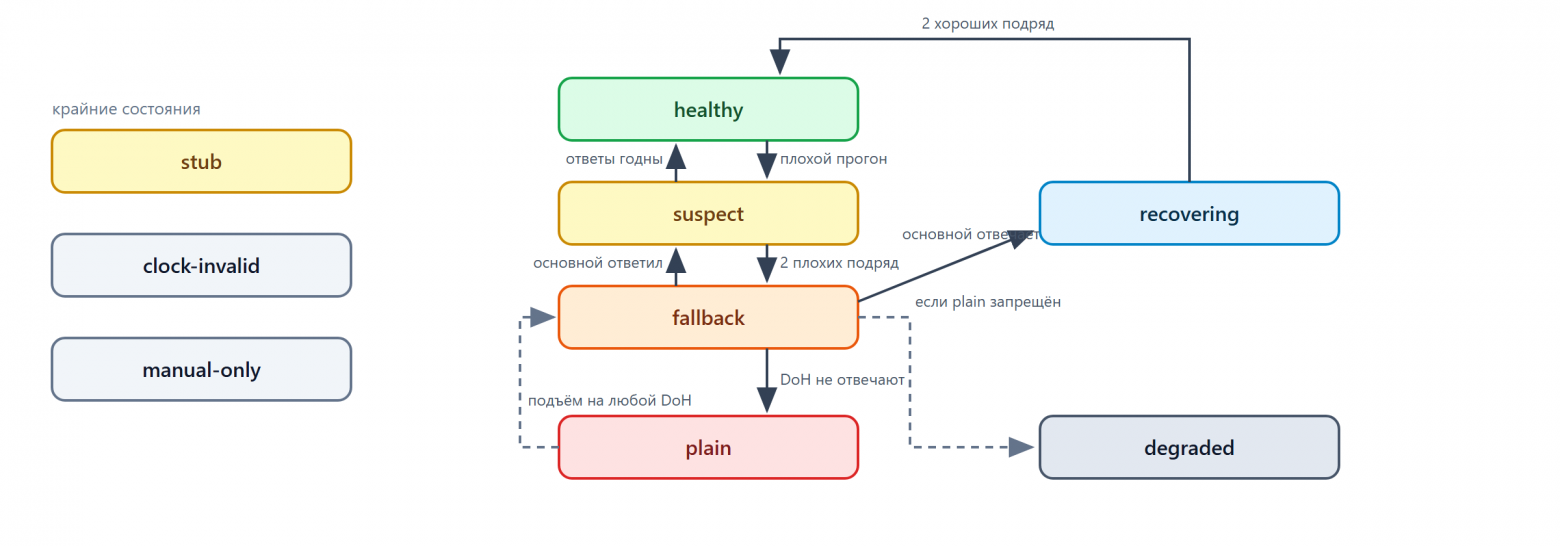
Состояния монитора и переходы между ними; крайние состояния переключения не выполняют. Схемы раздела — по коду routeros/05-dns-health-monitor.rsc.
Состояние | Когда | Что делает |
|---|---|---|
| хотя бы одно контрольное имя вернуло пригодный адрес | работает на основном, счётчики сброшены |
| плохой прогон, порог не достигнут | остаётся на основном, считает дальше |
| основной не отвечает | работает на резерве |
| основной снова отвечает, порог возврата не достигнут | остаётся на резерве, считает вверх |
| не отвечает ни один DoH и | открытый DNS, в журнал |
| ответы — пара-заглушка | ничего: смена эндпоинта не поможет |
| недоступны все, простой резерв запрещён | сохраняет текущую конфигурацию |
| дата вне | останавливается: проверка сертификата невозможна |
|
| работает только вручную, без переключения |
Два свойства я считаю обязательными: без них схема бесполезна. Резерв проверяется до переключения, а результат переключения — после, с откатом на основной, если резерв не разрешает имён: иначе роутер спокойно паркуется на эндпоинте, который открывает TCP, но молчит. И попыток на инцидент не больше трёх (maxAttempts), после чего монитор ждёт восстановления основного и не забивает журнал.
Это управляемое переключение, а не прозрачное. Резерв — другой оператор, с другими ответами, другой фильтрацией и другой геолокацией CDN. После переключения сеть получает не «то же самое, только через другой канал», а «другой резолвер».
Проба без побочных эффектов и с таймаутом
Проба в первых версиях была грязной: ответ складывался во временный файл в /file, файл удалялся, и на этом месте жили гонки — не удалили, удалили не тот, удалили в тот момент, когда следующий прогон его читает. В 0.4.0 проба переписана на чтение тела в память:
:local probeA "unreachable"
:do {
    :local rA [/tool fetch url=$probeUrlA http-header-field="accept: application/dns-json" mode=https as-value output=user duration=5s]
    :local bodyA ($rA->"data")
    :if (($rA->"status") = "finished") do={
        :if (([:find $bodyA "\"Status\":0"] >= 0) or ([:find $bodyA "\"Status\": 0\"] >= 0)) do={ :set probeA "ok" } else={ :set probeA "bad-status" }
    } else={ :set probeA "unreachable" }
} on-error={ :set probeA "unreachable" }
Два варианта записи — "Status":0 и "Status": 0 — нужны потому, что провайдеры сериализуют JSON по-разному, и проверка, знающая только один вариант, молча не находила ответ.
В 0.4.1 к каждому вызову добавился duration=5s. Причина не косметическая. Эндпоинт, который принимает соединение и молчит, держит /tool fetch столько, сколько даст сеть. Прогон выходит за интервал планировщика, следующий запуск накладывается на предыдущий — а наложение отсекает защитный флаг DNSMonitorRunning. То есть без таймаута сеть в такой ситуации не переключилась бы вообще, пока висит первая проба: защита от наложения превращалась в запрет на работу.
Переключение выглядит так — проверка резерва, смена апстрима, пауза, проверка разрешения имён, откат при неудаче:
:if ($probeB = "ok") do={
    :set DNSFailoverAttempts ($DNSFailoverAttempts + 1)
    /ip dns set use-doh-server=$dohUrlB verify-doh-cert=yes
    /ip dns cache flush
    :delay 3s
    :local test ""
    :do { :set test [:tostr [:resolve "example.com"]] } on-error={ :set test "" }
    :if ([:len $test] > 0) do={
        :set DNSMonitorState "fallback"
        :log warning ("FALLBACK: switched to fallback DoH (" . $dohUrlB . "), example.com -> " . $test)
    } else={
        /ip dns set use-doh-server=$dohUrlA verify-doh-cert=yes
        /ip dns cache flush
        :set DNSMonitorState "degraded"
        :log error "DEGRADED: fallback DoH did not resolve either — rolled back to the primary; check the CA for the fallback host"
    }
}
Два этих куска — проба и переключение — и есть весь механизм. Остальное в мониторе это счётчики, журнал и защита от наложения прогонов.
Третий эндпоинт, счётчик и возврат из открытого DNS
Версия 0.4.1 — про надёжность, а не про новые возможности. Четыре изменения, и каждое — исправление того, что раньше было недоделано.
Было | Стало |
|---|---|
проба без ограничения времени |
|
третий эндпоинт переключался без проверки | проверка после переключения и откат, как у второго |
| растёт на каждом: второй, третий, простой DNS |
из состояния | выход на любой рабочий DoH |
Ограничение «не больше трёх попыток на инцидент» имеет смысл, только если считает все переключения. Пока он рос на первом, длинная цепочка могла прокручиваться дальше задуманного, и документация расходилась с поведением.
plain — состояние с пониженной приватностью, и держать его дольше необходимого нельзя. Раньше монитор ждал именно основной эндпоинт: если тот лежал час, а второй был жив, сеть час жила без шифрования. Теперь выход из plain — на любой работающий DoH.
Грабли, которые стоили времени
Часть граблей — про RouterOS, часть — про мою невнимательность.
Резерву нужен свой корень доверия
Самая обидная. Резервный хост по умолчанию — Google, а его цепочка кончается не на SSL.com. Если корень для резерва не импортирован, verify-doh-cert=yes отклоняет его, переключение не даёт разрешения имён, и монитор откатывается на основной. Формально всё правильно, фактически — вы сидите на мёртвом основном, а система уверена, что сделала всё, что могла. В журнале это видно строкой DEGRADED: fallback DoH did not resolve either.
device-mode=home выключает половину схемы
На устройствах в режиме home RouterOS отклоняет и /tool fetch, и создание планировщика с сообщением not allowed by device-mode. DoH и принудительный DNS при этом работают — а монитор нет: без fetch он не может опросить эндпоинты. На RB4011iGS+ я это и увидел. Раньше в этой ситуации монитор честно сообщал «оба эндпоинта недоступны», что было ложью: сеть-то работает. Теперь он различает причины и уходит в состояние manual-only с записью MONITOR_DISABLED_BY_DEVICE_MODE. Включается планировщик переводом устройства в advanced — это решение владельца устройства, с подтверждением и перезагрузкой.
Quad9 не говорит на языке пробы
Проба ходит в DNS-JSON API. Cloudflare и Google его поддерживают, Quad9 на запрос вида ?name=...&type=A отвечает DoH unable to decode BASE64-URL. Как апстрим Quad9 работает, как звено цепочки — всегда выглядит недоступным. Резервом пришлось ставить Google.
Что ещё
Статические записи /ip dns static перекрывают ответ DoH — это и ловушка, и инструмент: ими можно закрепить внутреннее имя или, наоборот, задать type=NXDOMAIN. redirect не действует на клиентов, которые уже ходят на роутер как на резолвер: их запрос отвечается локально и в dstnat не попадает, поэтому «отдельный резолвер для одной рабочей станции» через dst-nat молча не работает. Скрипты 01 и 02 не идемпотентны: повторный импорт добавляет вторую запись, второе правило NAT и второе правило фильтра. И документация отстаёт от тега: в шапке AGENTS.md написана версия 0.4.0, README в блоке состояния сообщает «покрытая версия 0.4.0, последний тег v0.3.1», а тег 0.4.1 уже выпущен. Читая инструкцию, сверяйтесь с датой и с кодом.
Общий знаменатель у этих граблей один: ошибка была не в команде, а в том, что я считал доказательством. Ложное «здоров», откат в открытый DNS, роутер на мёртвом эндпоинте — всё это следствия проверки, которая смотрела не туда.
Что получилось
Числа я пересчитал сам 29 октября 2026 на ветке main и на теге v0.4.1 — не переписал из README, потому что README измерялся 26 октября и уже разошёлся с репозиторием.
Что | Значение | Чем посчитано |
|---|---|---|
Файлов под git | 41 |
|
Скриптов RouterOS | 7, всего 552 строки |
|
Из них монитор | 314 строк |
|
Вызовов | 5, все с | поиск по файлу |
Проверенных устройств | 6 |
|
Проверенных версий RouterOS | 2 (7.23.1 и 7.24.5) | там же |
Объектов Zabbix в модуле | 8 элементов, 5 триггеров, 2 дерева сервисов |
|
Про пять вызовов стоит сказать отдельно, потому что это единственное место, где я поправляю прошлый обзор — в том числе свой. Обзор версии 0.4.1 на sysadministrator.ru говорит о шести вызовах /tool fetch, посчитанных поиском по duration=5s. Поиск по этой строке находит шесть вхождений, но шестое — в шапке-комментарии файла. Настоящих вызовов пять, и таймаут стоит на всех пяти; на теге v0.4.1 картина та же. Уточнение мелкое, но именно так и появляются числа, которые потом расходятся с кодом.
Что проверено руками (по чек-листу docs/verification.md, прогоны на RouterOS 7.23.1):
JSON-проба: код
200, тело 251 байт,"Status":0найден поиском по телу;переключение: основной эндпоинт подменён на
https://192.0.2.1/dns-query, сеть ушла на резерв,use-doh-serverсменился;откат: недоступны оба — конфигурация не тронута, в журнале строка про сохранение текущей;
защита часов: при неверном годе монитор пишет
clock looks wrongи больше ничего не делает;фильтр: состояние
stubпри паре-заглушке, без переключения.
Для парка добавился модуль Zabbix: коллектор по SSH снимает с роутеров состояние DoH (/ip dns use-doh-server, три контрольных имени) и состояние VPN (пиры WireGuard, возраст рукопожатия), складывает в trapper-элементы, а наверху висят триггеры и два дерева сервисов. Состояние теперь видно по парку, а не по одному роутеру, до которого надо дойти.
Условия проверок
Чтобы числа выше можно было воспроизвести или оспорить:
Устройства: Chateau PRO ax (7.24.5, контроллер), cAP ax (7.24.5, клиент), RB4011iGS+ (7.24.5, режим
home), hAP ax² (7.24.5), RB951Ui-2HnD (7.24.5), RB2011UiAS (7.23.1).Что считалось результатом: не «интернет работает», а конкретные наблюдения: состояние монитора, значение
use-doh-server, ответ:resolveна контрольные имена и строка журнала при переходе. Проверки ручные — исполнять RouterOS Script негде, автотестов у набора нет.Замеры пары-заглушки: две независимые российские точки плюс контрольная точка в Германии 26 октября 2026, запросы через DoH и через простой DNS, плюс
curl --resolveс WAN шлюза и из филиальной сети.Чего я не измерял: длительную (часы) недоступность всех эндпоинтов, поведение под нагрузкой, расход ресурсов на слабом железе, работу на прошивках 7.20–7.22. Всё, что не проверено на устройстве, в документации помечено, и в статье тоже.
Что я сделал бы иначе
Не начинал бы с фильтрующего резолвера. Family по умолчанию сбил диагностику: пара-заглушка выглядела как «ну конечно, это фильтр». Фильтрация должна быть осознанным выбором с отдельным предупреждением, а не стартовым значением.
Сразу проверял бы ответ, а не тип. Это главная ошибка первой версии, и она была не в коде, а в критерии: я проверял факт ответа, а не его пригодность.
Не хранил бы состояние в глобалах.
DNSMonitorStateи счётчики живут вне файла, поэтому после обновления скрипта их надо чистить руками, а забывчивость даёт странные переходы. Правильнее — состояние в одном месте и с явной версией схемы.Закреплял бы ссылки за тегом с первого дня.
mainуходит вперёд, и инструкция «скачайте файл из main» через неделю описывает уже другой код.Сделал бы проверку документации частью релиза. Расхождение «в шапке 0.4.0, тег 0.4.1» — не мелочь: по этой шапке люди сверяют, что у них стоит.
Ссылки
Репозиторий: https://github.com/paulmann/mikrotik-doh-failover
История изменений: https://github.com/paulmann/mikrotik-doh-failover/blob/main/CHANGELOG.md
Отказы и обходы, включая разбор пары-заглушки: https://github.com/paulmann/mikrotik-doh-failover/blob/main/docs/troubleshooting.md
Обоснование решений: https://github.com/paulmann/mikrotik-doh-failover/blob/main/docs/architecture.md
Проверки и чек-лист переключения: https://github.com/paulmann/mikrotik-doh-failover/blob/main/docs/verification.md
Обзор версии 0.4.1: https://sysadministrator.ru/mikrotik-doh-failover-v0-4-1/
Документация MikroTik по DNS: https://help.mikrotik.com/docs/spaces/ROS/pages/37748767/DNS
Заключение
Отказоустойчивый DoH на MikroTik собирается, но не настройкой, а скриптом с явным автоматом состояний, гистерезисом и проверкой после каждого переключения. Работает это ровно в тех границах, которые я обозначил: шифрованный канал и проверка сертификата — да; отказ от собственного DoH у клиента — нет; недостижимый адрес в ответе — нет, и это не лечится сменой резолвера.
Главный вывод, который стоил мне больше всего: «резолвер ответил» и «ответ пригоден» — разные вопросы, и второй нельзя проверить типом значения. Как только проверка стала судить содержимое, исчезли и ложные «здоров», и молчаливые откаты в открытый DNS.
Следующий шаг для себя я вижу в двух вещах: убрать зависимость от глобального состояния и научиться отличать «эндпоинт жив, но не разрешает» от «до эндпоинта нет пути» без похода на клиента. Второе пока честно не решено.
Просьба: что улучшить
Если у вас есть опыт с RouterOS или с отказоустойчивым DNS, мне важны конкретные замечания — особенно там, где я упёрся:
Реприоритизация «вбок». Сейчас монитор поднимается вверх по цепочке (с открытого DNS на DoH, с резерва на основной), но не различает «сижу на втором» и «сижу на третьем». Полная перестановка приоритетов стоит ли усложнения? Как бы вы её описали состоянием, а не флагами?
Проба достижимости пары изнутри роутера. Я утверждаю, что
/tool fetchне отличает мёртвый маршрут от отказа HTTP, и потому отправляю человека на клиент. Есть ли способ надёжнее — например:resolveс последующим TCP-коннектом, — который не врёт?DNSSEC. Ответы судятся по содержимому, но подлинность не проверяется: TLS защищает транспорт, а не ответ. Даёт ли DNSSEC на RouterOS что-то практическое, или это ещё один слой, который сломается тише, чем хочется?
Состояние вне глобалов. Куда вы кладёте состояние скрипта на RouterOS, чтобы обновление скрипта его не сбивало? Отдельный файл в
/file, запись в комментарии правила, что-то ещё?Тесты без устройства. Как вы проверяете такие скрипты до выкатки на живой роутер — CHR в виртуалке, ручной чек-лист, что-то третье?
Таймаут пробы. Пять секунд выбраны как компромисс между «дождаться медленного эндпоинта» и «уложиться в интервал». У вас другое значение — и почему?
Если эта публикация вас вдохновила и вы хотите поддержать автора — не стесняйтесь нажать на кнопку
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.