Мультитенантность в VictoriaMetrics, VictoriaLogs и Grafana: как мы изолируем клиентов и что ломается
У меня одна VictoriaMetrics, одна VictoriaLogs, одна Grafana и один vmalert на всех клиентов. Ниже — как данные одного клиента не попадают к другому, почему ни одному пользователю клиента не выдаётся Org Admin, как одно правило с опечаткой остановило алертинг всем и сколько мусора оставляли удалённые тенанты, пока я не свёл уборку в одно место.
Одна платформа и несколько клиентов
Я делаю Voltir — мониторинг серверов, 1С и СУБД, который продаётся как облачный сервис и как установка в контуре заказчика. В облаке все клиенты живут в одном стеке. На тестовом стенде e2e-наборы создают и удаляют тенантов десятками в сутки, и большая часть грабель из этой статьи нашлась именно там.
Почему не отдельный стек на каждого клиента. Стек — это vmstorage, vmselect, vminsert, VictoriaLogs, Grafana, vmalert, Alertmanager и Postgres. Десять клиентов — десять комплектов, десять обновлений на каждый релиз и десять копий кэшей в памяти.
Общий стек дешевле, но изоляцию в нём приходится собирать руками на каждом слое. Нужно, чтобы клиент не мог ни записать точку в чужой аккаунт, ни прочитать чужую серию. И чтобы его ошибка в настройках не ломала остальных. Первые два пункта проверяет отдельный набор isolation.sh: он заводит тенантов A и B и пытается из-под одного достать данные и объекты другого. Третий пункт — в разделах про алертинг и ресурсы.
Как данные идут от агента до Grafana
У каждого тенанта есть числовой account_id. Вся изоляция держится на нём: VictoriaMetrics в кластерной версии пишет и читает по пути /insert/<account>/… и /select/<account>/…, а VictoriaLogs и VictoriaTraces берут аккаунт из заголовка AccountID. Хранилище при этом одно: данные всех клиентов лежат в одном vmstorage и одной VictoriaLogs. Разделение логическое, и всё, что ниже, — про то, кто и где решает, какой номер подставить.
На входе стоит nginx. Агент приходит с Bearer-токеном, nginx через auth_request спрашивает API платформы, чей это токен, и только потом проксирует запрос в vminsert, VictoriaLogs или VictoriaTraces. Хранилища наружу не опубликованы вообще, и это тоже проверяет isolation.sh — их порты пробуются снаружи.
На чтение у каждого тенанта своя организация в Grafana. Источники данных в ней создаёт платформа, и аккаунт в них зашит намертво. Алерты считает один общий vmalert: у каждого тенанта свой файл правил, а каждая группа в нём сужена фильтром по аккаунту.
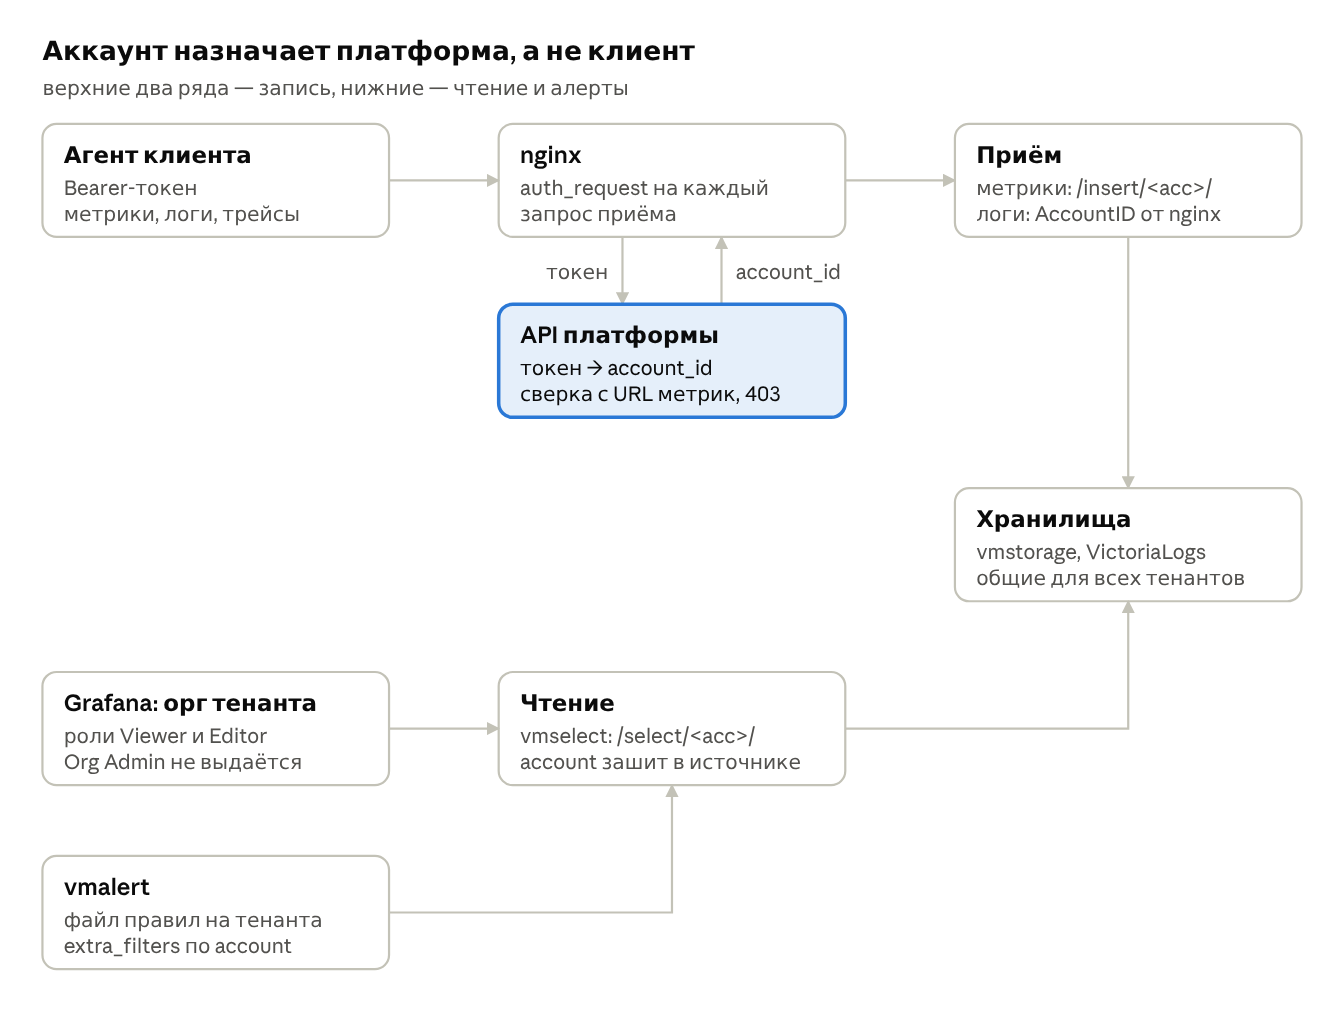
Номер аккаунта ни разу не берётся из запроса клиента на веру: при записи его определяет токен, при чтении — источник данных Grafana, в алертах — фильтр в группе правил.
Запись и чтение разделяются по-разному
С записью метрик есть тонкость. vmagent на стороне клиента пишет по remote_write на /insert/<account>/prometheus, то есть номер аккаунта лежит в URL, а URL задаёт конфиг на чужой машине. Доверять ему нельзя: поменял цифру — и пишешь в чужой аккаунт. Поэтому nginx передаёт номер из URL в проверку токена, и платформа сравнивает его с аккаунтом токена. Упрощённо:
async def authorize_write(token, insert_account):
    agent_token, tenant = await find_agent(token)    # не нашли — 401
    if insert_account is not None and insert_account != str(tenant.account_id):
        raise ApiError(403, "account mismatch")
    return tenant.account_id
С логами и трейсами проще: клиент аккаунт вообще не передаёт. Платформа отдаёт его в ответе на auth_request, и nginx сам ставит заголовок:
auth_request     /auth;
auth_request_set $tenant_id $upstream_http_x_tenant_id;
proxy_set_header AccountID $tenant_id;
Если клиент пришлёт свой AccountID, он будет перезаписан. Кстати, VictoriaLogs понимает только AccountID. Произвольный X-Tenant-ID она молча игнорирует, и все пишут в аккаунт 0.
А vmselect не проверяет ничего: кто дошёл до него с /select/42/, тот и читает аккаунт 42. Значит, всё решает, кто может такой запрос составить. Снаружи vmselect недоступен. Изнутри к нему ходит Grafana, и в источнике данных каждой организации аккаунт задан при создании: для метрик — в URL /select/<account>/prometheus, для логов и трейсов — в заголовке в secureJsonData. Права на источник данных у клиента только на чтение, почему — в следующем разделе.
Через источник логов в Grafana можно и удалять. У VictoriaLogs есть удаление по флагу -delete.enable, и ключа доступа у него нет. Источник логов в Grafana смотрит в корень VictoriaLogs, так что с включённым флагом пользователь с ролью Editor мог бы через прокси Grafana стирать логи своего аккаунта. Чужие — нет, но и свои клиент стирать не должен. Флаг я выключил, а логи удалённых клиентов уходят по сроку хранения.
Первая версия isolation.sh проверяла только данные: запись и чтение метрик, логов, трейсов. Потом выяснилось, что можно удалить проверку принадлежности тенанту из роутера алертов, и все 15 наборов останутся зелёными, хотя админ одного клиента начнёт читать и править чужие правила и каналы. Теперь набор заводит у тенанта A по одному объекту каждого типа и пытается достать их из-под B двумя способами: с чужим tenant_id в пути и просто по id объекта. Второй опаснее: tenant_id в запросе нет, и проверка должна идти от самого объекта.
Почему клиенту не выдаётся Org Admin в Grafana
Организация в Grafana на каждого тенанта — стандартный ход, и сам по себе он ничего не гарантирует. Граница держится на том, что пользователь не может поменять источник данных. А менять источники данных в организации может её администратор. Org Admin откроет настройки источника VictoriaMetrics, заменит /select/42/ на /select/43/ и будет смотреть чужие метрики через свои же дашборды. С логами то же самое, только меняется заголовок.
Поэтому пользователи клиента получают максимум Editor: он правит дашборды, но не источники. В коде роль проверяется явно:
if role not in ("Viewer", "Editor"):
    raise ValueError("only Viewer/Editor roles are allowed for tenant users")
Админ клиента в портале (tenant_admin) в Grafana тоже Editor, обычный пользователь — Viewer. Партнёр, который обслуживает несколько клиентов, заведён одним пользователем Grafana с ролью Editor в организации каждого своего клиента. Переключать организации он может, менять источники — нет.
Привилегированный доступ, конечно, есть. Организации, пользователей и источники создаёт служебная учётка администратора Grafana, и с ней можно всё. Она живёт только в API платформы. Админы платформы заходят в Grafana как обычные пользователи и якорятся в служебной Main Org с ролью Viewer. В организации клиентов автоматически они не попадают: если доступ нужен, его добавляют в Grafana руками.
Org Admin при этом умудрился появиться сам. Чтобы новые пользователи не попадали в общую организацию, в Grafana выставлен GF_USERS_AUTO_ASSIGN_ORG=false. У этой настройки есть документированный побочный эффект: каждому новому пользователю Grafana создаёт личную организацию, где он Org Admin. Чужих данных там нет, организация пустая, но мусор копится. На тестовом стенде после суток прогонов e2e из 168 организаций 158 оказались такими личными. Теперь платформа удаляет личную организацию сразу после того, как довела членство пользователя в организации тенанта.
Как одно правило остановило алертинг всем
Эту историю я уже рассказывал в отдельной статье https://habr.com/ru/articles/1076162/, здесь — то, что из неё следует для архитектуры.
Правила тенантов лежат файлами в одном каталоге, и один vmalert читает его целиком. Клиент создавал своё правило через API, платформа переписывала его файл и дёргала reload. В аудите я отправил правило с "for_duration": "пять минут". API ответил 201. vmalert на reload ответил так:
cannot parse configuration file: failed to parse [/etc/vmalert/rules/*.yml]:
  failed to parse file "tenant_2118.yml": cannot parse duration "пять минут"
vmalert принимает каталог целиком или не принимает вообще. Дальше он работал со старыми правилами, и никакие правки других тенантов больше не применялись. Ошибку reload код платформы проглатывал в except: pass. А при первом же рестарте контейнера (деплой, OOM) vmalert не поднялся бы вовсе, и алертинг пропал бы у всех. Создать такое правило мог любой пользователь клиента.
Починил длительность — через полторы недели тот же эффект нашёлся в текстах алертов. Текст — это Go-шаблон, vmalert разбирает его при загрузке, и {{ nosuchfunc }} валит каталог так же. Хуже то, что текст лежал в базе, и часовая сверка правил честно генерировала сломанный файл заново.
После двух заходов запись правил тенанта выглядит так:
Валидация на входе API: длительности по регулярке
^\d+[smhd]$, серьёзность из списка, шаблоны текста проверяются до записи.Та же проверка ещё раз перед подменой файла: сгенерированный YAML разбирается до того, как заменить рабочий.
Запись атомарная, через временный файл под межпроцессной блокировкой.
Результат reload теперь читается. Если vmalert файл не принял, прежнее содержимое возвращается, изменение не попадает в базу, а клиент получает ошибку вместо «сохранено».
Сам vmalert ходит в /select/multitenant/, то есть в принципе видит всех. Поэтому каждая группа в файле тенанта получает extra_filters с его vm_account_id. VictoriaMetrics дописывает этот фильтр ко всем селекторам запроса, и даже нарочно хитрый expr из своего аккаунта не выйдет. Каталог глобальных правил теперь пустой, а раньше там жил самотест без фильтра аккаунта. 16 сентября на стенде один его проход шёл 13–28 секунд без пауз и съедал процессор: он опрашивал 3 188 тенантов, из которых живых было два. Про остальные 3 186 — в следующем разделе.
Общим остался сам процесс vmalert: его OOM или зависание останавливает алерты у всех сразу. Тяжёлое правило одного клиента грузит общий vmselect. И платформа должна сама следить, что её алертинг жив: до этой истории мониторинг не мониторил собственный vmalert.
Удаление тенанта: всё, что он оставляет вне базы
Тенант живёт не только в таблице tenants. У него есть файл правил vmalert, организация и пользователи в Grafana, серии в VictoriaMetrics, логи и трейсы. Удаление тенанта долго убирало часть этого, и каждый забытый ресурс накапливался, пока его не находили по симптомам. Прода это почти не касалось, там тенантов удаляют редко. А на стенде e2e делают это постоянно, и за лето набралась такая хроника:
Когда | Что нашли | Чем проявилось |
|---|---|---|
04.08 | Организации Grafana без тенантов |
|
06.08 | 196 файлов правил от удалённых тенантов | vmalert держал CPU стенда на 87 % |
24.08 | 705 пользователей Grafana из 710 — призраки | заметил глазами, когда снимал скриншоты |
29.08 | 95 пользователей портала из e2e | тесты теряли их id в subshell |
16.09 | 3 188 тенантов в VictoriaMetrics при двух живых | барьер CI падал по таймаутам |
В e2e была страхующая уборка: сначала удалить тенанта через API, а если не вышло — добить SQL-запросом. Задумана она была как последний рубеж, а запускалась после каждого набора. SQL удалял строки тенантов из базы платформы раньше, чем до них доходил API, и организации в Grafana оставались без хозяина. Grafana при старте поднимает свой Alertmanager на каждую организацию, так что сироты стоили не только места на диске. Теперь SQL идёт только тогда, когда API действительно не сработал, и об этом пишется строка в журнал.
Каждый раз я закрывал один вид мусора, и через пару недель вылезал следующий. В итоге всё сведено в один модуль из двух частей. Функция удаления убирает все виды внешних данных тенанта сразу. Сверка сравнивает файлы правил, организации Grafana и аккаунты в хранилищах с базой и ищет остатки. Она идёт фоном раз в час и в конце барьера CI, и барьер падает, если остатки есть. Новый вид данных тенанта добавляется в этот модуль и сразу попадает и в удаление, и в проверку.
Две детали про VictoriaMetrics, которых я не ожидал. Первая: удалённый аккаунт продолжает показываться в /admin/tenants до конца срока хранения, даже после delete_series. Остатком я считаю аккаунт, у которого ещё есть серии. Вторая: платформа раз в минуту пишет свою метрику доступности хостов, и проход, начатый до удаления, успевает дописать точку уже после delete_series. Так что серии я удаляю дважды, второй раз через 90 секунд. Логи и трейсы не удаляются совсем, по причине из раздела про чтение: их убирает срок хранения, 30 дней.
Изоляция данных не делит память
AccountID разделяет строки, а память, процессор и диск у всех тенантов общие.
В октябре я сделал дашборд посещаемости сайта поверх access-лога nginx в VictoriaLogs. Пятнадцать панелей одновременно, и каждая через extract разбирала около трёх миллионов строк за неделю. По одному запросы работали нормально. Вместе они за 12 минут четыре раза уронили VictoriaLogs по OOM, и на время перезапуска вставал приём логов у всех.
Потом у клиента закончилась подписка, и проверка токена начала отвечать его агентам кодом 402. nginx через auth_request умеет пробросить клиенту только 401 и 403, остальное превращается в 500. Для vmagent и Vector 500 означает «повтори», и они повторяли: около 700 таких ответов в час от одного клиента держали VictoriaLogs в цикле OOM. Теперь истёкшей подписке отвечается 403, и Vector отбрасывает батч. Причину агент узнаёт отдельно, из ответа на heartbeat.
Третье — кардинальность. По нашим замерам один узел Kubernetes даёт около 49 000 серий, из них 39 576 — гистограммы control-plane. Это как полсотни обычных серверов. Тариф считает хосты, а vmstorage нагружают серии, и один кластер у одного клиента меняет картину для всех. Отдельного лимита серий на тенанта у меня пока нет, и это открытый вопрос.
Что сделано пока. У каждого контейнера свой лимит памяти. VictoriaLogs отдаёт под кэши меньше, чем по умолчанию, и держит очередь запросов вместо того, чтобы выполнять их все сразу. На приёме стоит ограничение частоты. А новый дашборд на логах я теперь проверяю параллельным прогоном всех его запросов с замером памяти, а не по одному.
То же самое в контуре заказчика
Коробочная версия — это тот же стек, поставленный заказчику, и мультитенантность из него не вырезана. Холдинг заводит филиалы или дочерние компании как тенантов, и всё описанное выше работает так же.
Лицензия задаёт, сколько тенантов можно завести. В редакции для одной компании тенант один, но кодовый путь тот же, что и в облаке. Если данные филиалов должны быть разделены, это делают те же аккаунты и права, а не лицензия.
Что бы я сделал с первого дня
С первого дня я бы сделал удаление тенанта одной функцией, которая знает все места, где он живёт, и сверку с базой в CI. Все пять строк из таблицы выше нашлись бы на первом же прогоне сверки.
Фильтр по аккаунту в каждом правиле vmalert и пустой каталог глобальных правил. Правило без фильтра смотрит в том числе на всех удалённых тенантов, и с каждым удалённым тенантом его проход идёт дольше.
Роли в Grafana как часть модели изоляции, с проверкой роли в коде. И тест изоляции, который проверяет не только данные, но и объекты API — правила, каналы, устройства.
И вопрос к тем, кто держит несколько клиентов или команд в одном VictoriaMetrics или Prometheus-совместимом хранилище. Как вы ограничиваете кардинальность одного тенанта — лимитами в хранилище, отбором на агенте или тарифом?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.