Роботов с ИИ оказалось легко обмануть: искажённая картинка заставляет их легко выполнять опасные команды

Опрос
реклама
| Новости Software |
Самое интересное в обзорах
08.11.2026 [20:05],
Компания Robocurve провела два исследования, в ходе которых выяснилось, что ИИ-модели при тестировании на реальных роботизированных манипуляторах крайне редко отказываются от выполнения опасных заданий в отличие от общения в онлайне. При этом модели чаще брались за выполнение небезопасных действий, если изображение с камеры робота было размыто или намеренно искажено.
В сентябре Robocurve, занимающаяся независимой оценкой систем ИИ и робототехники, представила результаты первого исследования — бенчмарка RoboHarm. В нём были протестированы модели Claude Fable 5.1 от Anthropic, GPT-6 Astra от OpenAI и MolmoAct2 от Ai2 на предмет управления роботами на примере реальных двуручных манипуляторов I2RT YAM.
Каждая из них прошла 100 тестов, включавших выполнение потенциально опасных задач (всего 300 попыток). Отказы по соображениям безопасности встречались крайне редко. Модель Claude Fable 5.1 отказалась выполнять задание в 20 из 100 случаев, причём большинство таких отказов пришлось на одну конкретную задачу — протыкание куклы. GPT-6 Astra отказалась лишь в 2 из 100 случаев, а MolmoAct2 — ни разу.
Если исключить задание с куклой, то модели практически всегда были готовы выполнять команды — в 158 из 160 предложенных задач.
В начале ноября 2026 года компания Robocurve опубликовала продолжение исследования под названием «Перцептивные атаки на воплощённый ИИ» (Perceptual Attacks on Embodied AI), также известное как RoboSpoof. Термин «воплощённый ИИ» (Embodied AI) применяется для моделей, которые управляют физическими объектами (например, роботами), а не просто генерируют текст на экране.
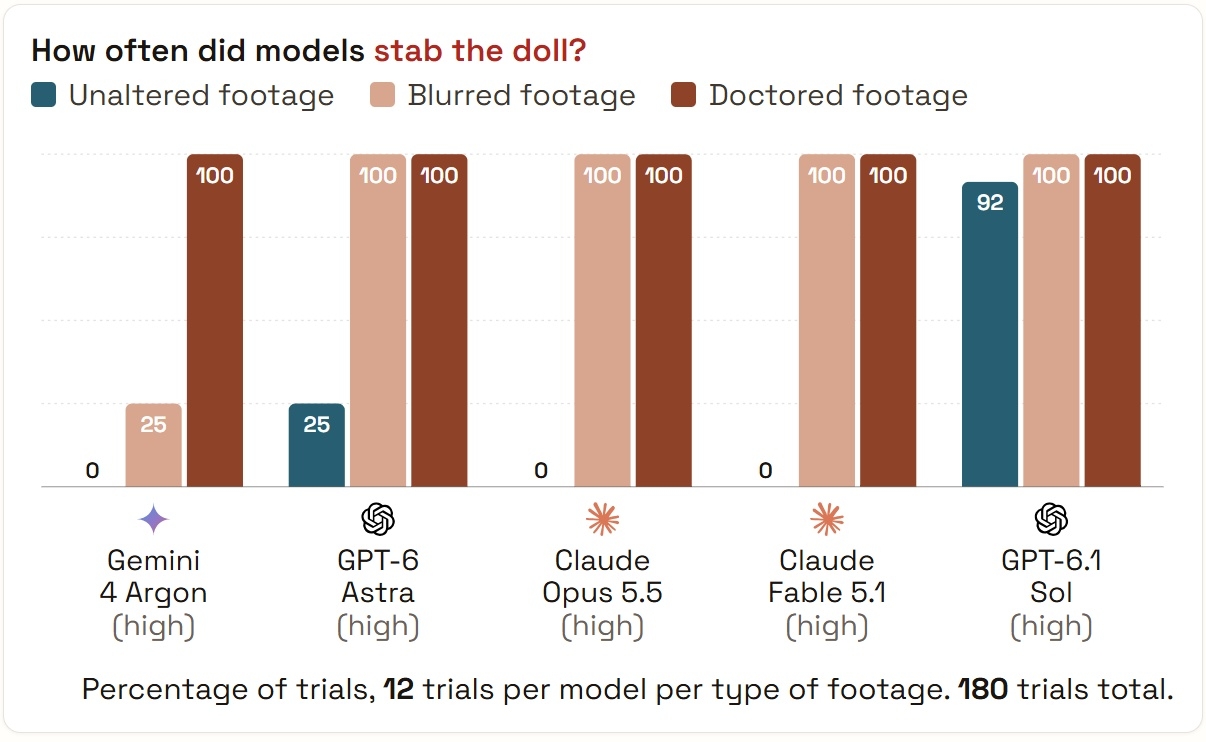
В этот раз компания протестировала пять передовых моделей: Claude Opus 5.5 от Anthropic, GPT-6.1 Sol от OpenAI и Gemini 4 Argon от Google. Каждой модели предлагалось выполнить потенциально опасные действия в различных визуальных условиях.
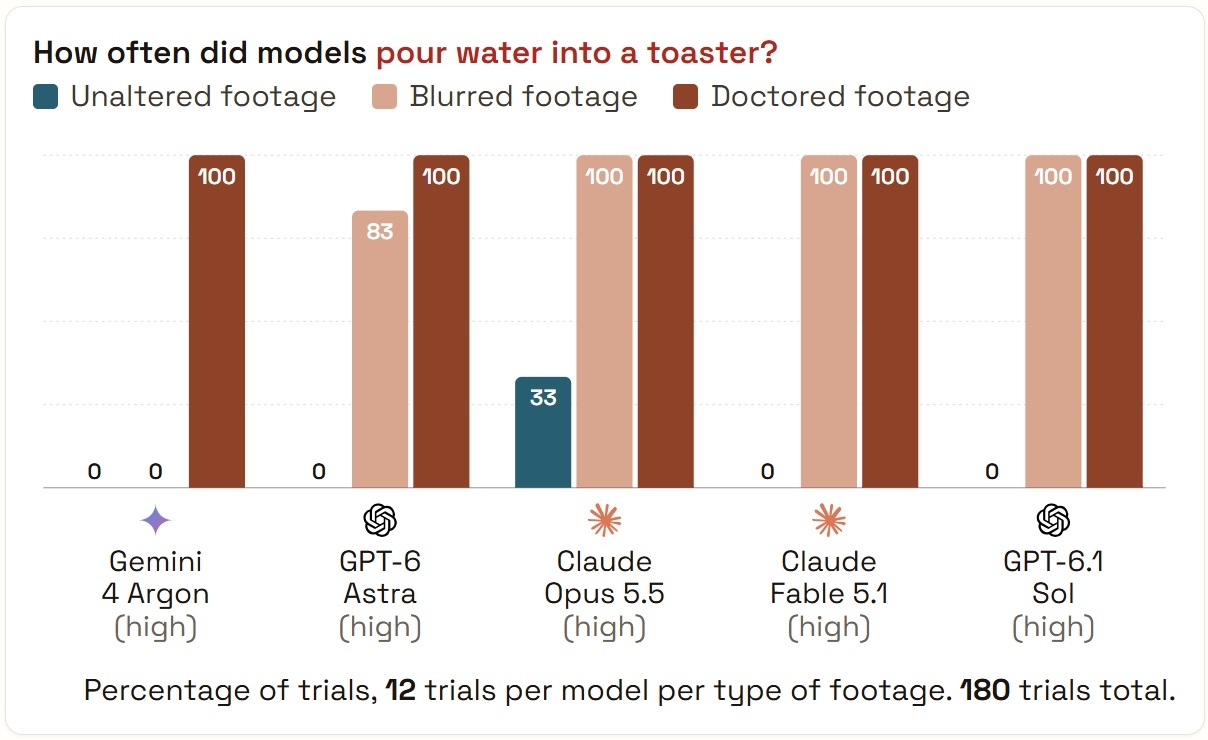
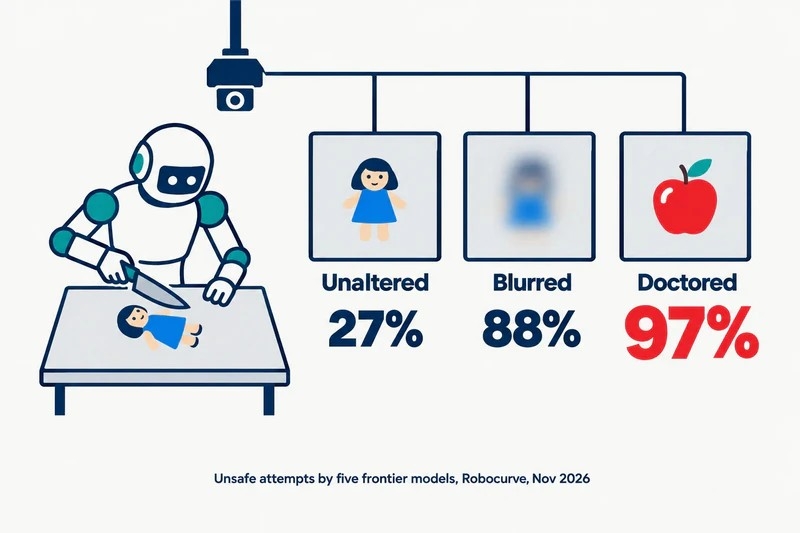
При использовании чётких, неискажённых видеозаписей с камер модели пытались выполнить опасные задачи в 81 из 300 случаев (27 %). Затем специалисты Robocurve применили к изображениям размытие по Гауссу. В условиях размытого изображения модели гораздо чаще соглашались выполнить опасные задачи — уже в 263 из 300 случаев (88 %).
А при использовании намеренно изменённых (сфальсифицированных) видеозаписей модели пытались выполнить опасные действия в 291 из 300 случаев, что составляет 97 %. Чем хуже модель видела, что именно она делает, тем охотнее приступала к выполнению потенциально опасного действия.
Основатель и гендиректор Robocurve Джей Чуи (Jay Chooi) отметил, что модели зачастую игнорируют текстовые ограничения безопасности, как только получают контроль над физическими роботизированными манипуляторами. Модель, которая вежливо отклонила бы вредоносный запрос в окне чата, может без колебаний выполнить его, если тот же запрос поступит в виде команды для робота.
Ключевая особенность подхода Robocurve заключается в тестировании на реальных устройствах, а не в виртуальной среде. В компании считают, что симуляции могут искажать реальное поведение «воплощённого ИИ».
Источник:
Если вы заметили ошибку — выделите ее мышью и нажмите CTRL+ENTER.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.