Вторая память и второй мозг — не одно и то же. Как я собрал 200 тысяч файлов своей жизни и подключил к ним агентов
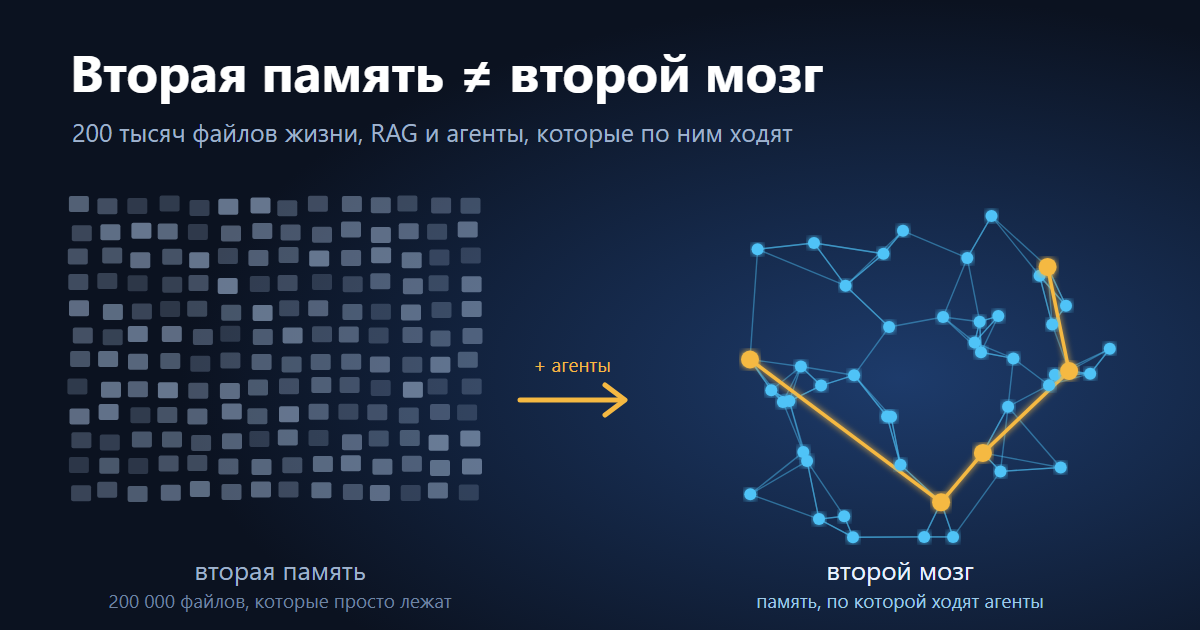
Сейчас модно называть вторым мозгом папку с заметками в Obsidian. Я разбирал гитхабы Андрея Карпатого и других, кто про это пишет, и чаще всего «второй мозг» там - это куча файликов, перелинкованных друг с другом, плюс подключённый к ним Claude Code.
Я думаю иначе.
Есть вторая память, и есть второй мозг. Это разные вещи, и разница между ними - это как раз то, ради которой всё это стоит строить.
Вторая память
Вторая память - это всё, что мимо вас в жизни проходило:
переписки с коллегами, друзьями, жёнами, детьми во всех мессенджерах: Telegram, Slack, Discord, WhatsApp и тд - вся история, насколько глубоко её вообще можно выкачать;
емейлы, все ваши почты;
ваши заметки, статьи, научные материалы;
транскрипции встреч и диктофонных записей.
Вторая память - это способность всю эту информацию сагрегировать.
Я сагрегировал для себя, и теперь мне крайне удобно жить: поверх всего этого построены RAG, retrieval и embeddings, и у меня работает поиск абсолютно по всей моей информации.
По объёму это примерно 200 тысяч файлов и несколько десятков гигабайт.
Но это пока память. Мозгом это ещё не является.
Почему Obsidian - не мозг
Obsidian - это просто визуальное отображение файлов, перелинкованных друг с другом. Внешняя графическая оболочка, сделанная для людей.
Когда файлов больше нескольких тысяч, Obsidian на Windows и на Mac, особенно на слабых компьютерах, начинает жёстко тормозить и может загружаться по полчаса.
И даже если у вас десятки и сотни тысяч файлов и десятки гигабайт данных - это всё ещё просто вторая память. Сколько ни добавляй файлов, сами по себе они ничего не делают.
Что ещё класть в память: диалоги с ИИ и coding-сессии
Это очень важный момент, хотя почему-то его часто пропускают.
Во второй мозг нужно класть не только переписки с людьми, но и все ваши диалоги с искусственным интеллектом. С DeepSeek, с ChatGPT, с Claude, с Mistral - со всеми обычными ЛЛМками, с которыми вы общались с телефона, голосом или с компьютера.
И отдельно - все ваши сессии, которые когда-либо были в Claude Code, Codex, Cursor и так далее.
Зачем?
Каждый раз, когда вы начинаете что-то делать, вы строите не с абсолютного нуля, а опираетесь на свой бэкграунд: кто вы и что вы делаете.
Начинаете изучать новое - опираетесь на свою методологию.
Пишете новые строки кода - опираетесь на свою структуру написания кода.
Поэтому важно, чтобы ИИ знал о вас как можно больше. А знать он может только одним способом - постоянно смотреть на то, что вы уже сделали, написали и обсудили.
Как устроен поиск
Для тех, кому интересна техника. Поиск по памяти у меня - это скрипт brain_ask.py, работает он в два шага:
вопрос
  -> e5-base: dense-поиск по чанкам, top-60, дедуп по файлу
  -> cross-encoder реранкер (mmarco-mMiniLMv2-L12, мультиязычный, русский понимает)
  -> top-12 кусков в контекст агенту
Дистилляция: важно! не заливать в RAG мусор
Ещё один слой, который я поставил, - дистилляция.
Если просто залить в RAG всё подряд, он начинает тонуть в шуме. Поэтому каждая моя сессия, каждая заметка, каждая встреча дистиллируется, условно говоря, до нескольких предложений: о чём это было, какая суть, какую пользу я из этого извлёк.
Так RAG работает качественно и не тащит в ответ кучу мусора.
Масштаб, чтобы было понятно: когда я запустил очередь на дистилляцию, в ней было 4 469 исследовательских чатов, ещё не сжатых в выводы, из них 1 909 с высоким баллом полезности.
Дистилляция идёт порциями, по несколько чатов за проход, и у каждой готовой заметки в шапке стоит ссылка на исходный чат - по ней очередь в следующий раз понимает, что этот чат уже обработан, и не делает работу дважды.
Вокруг второго мозга у меня построено много тулзов, которые нужны только для одного: понимать, когда он ищет не то, а когда находит ровно то, что нужно.
Второй мозг - это агенты поверх памяти
Так вот, второй мозг - это не Obsidian с подключённым к нему кодом. Это что-то посильнее.
Это ваша вторая память, к которой подключены агенты. Они по ней лазают, ползают, собирают нужную информацию и из кирпичиков ваших старых знаний строят новые дома, замки и так далее.
Попробую объяснить на примерах.
Пример 1. Митапы рядом с гостиницей
Я сейчас в Сан-Франциско и хожу по крутым ивентам. Могу задать вопрос своему Claude Code, Codex или Gemini: «Найди мне ивенты, на которые мне сейчас стоит ходить, учитывая мою миссию номер один, как можно ближе к моей гостинице».
Сессия делает recall: а где я живу? И находит это очень быстро, потому что я настроил память так, чтобы на самой её поверхности лежало всё, что произошло со мной за последние две недели. Отель мне бронировала сессия - значит, память знает, где я живу.
Дальше она смотрит на мою миссию - сейчас это - трудоустройство в ИИ-лабораторию. Находит митапы ближе ко мне из тех, на которые я уже зарегистрировался. Плюс она подключена к Luma и Partyful, и если на какие-то подходящие митапы я не зарегистрировался, говорит, что на них стоит зарегистрироваться.
Очень простой, банальный кейс. Но вот так это в принципе и должно работать.
Пример 2. Поиск работы
Мне в поиске работы помогают Claude Code, Codex и Antigravity, подключённые к моей памяти. Без них я был бы как без рук: вряд ли бы я так быстро ориентировался. Но про поиск работы я тут недавно писал отдельную статью.
Пример 3. Парень из Meta, имени которого я не помню
Со мной всегда диктофон, который записывает встречи. Всё автоматически транскрибируется и кладётся в волт. И я могу попросить свой второй мозг: «Посмотри, пожалуйста. Мне кажется, на одном из последних митапов я встречался с парнем из Meta, который работает в подразделении AI alignment. Хочу напомнить ему о себе в твиттере, помню, что мы твиттерами менялись. Но забыл, как его зовут. Точно помню, что он из Австрии, и мы с ним говорили про то, как в Австрии ремонтируют дороги - кладут на брусчатку заплатки из асфальта».
Вот этих якорей более чем достаточно. Агенты пойдут по моей второй памяти, найдут всю информацию про этого парня и отдадут её мне.
Ни имени, ни компании в поиске, ни даты - только Австрия, асфальт и брусчатка. Обычный поиск по файлам тут бессилен. А агент, который умеет ходить по памяти, справляется.
Вот это уже и называется вторым мозгом.
Итого
Вторая память - всё, что прошло через вашу жизнь, собранное в одном месте и доступное поиску.
Второй мозг - та же память плюс агенты, которые по ней ходят и из старого строят новое.
А вы что называете вторым мозгом? Есть у вас агенты, которые ходят по вашей памяти, или пока это папка с заметками?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.