Сутки из жизни G3A1SF: как я учу агента без backprop — днём он живёт, ночью учится
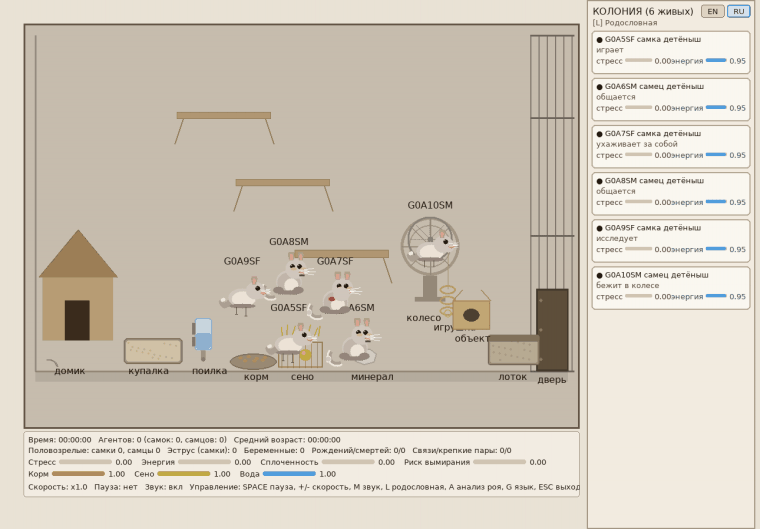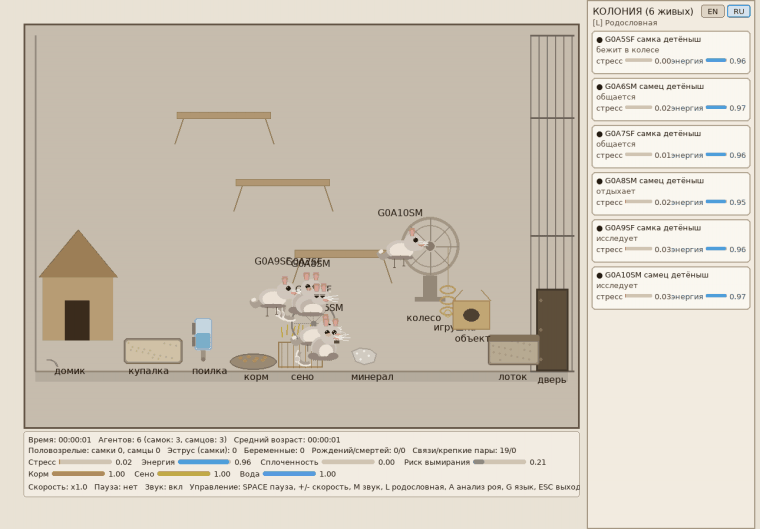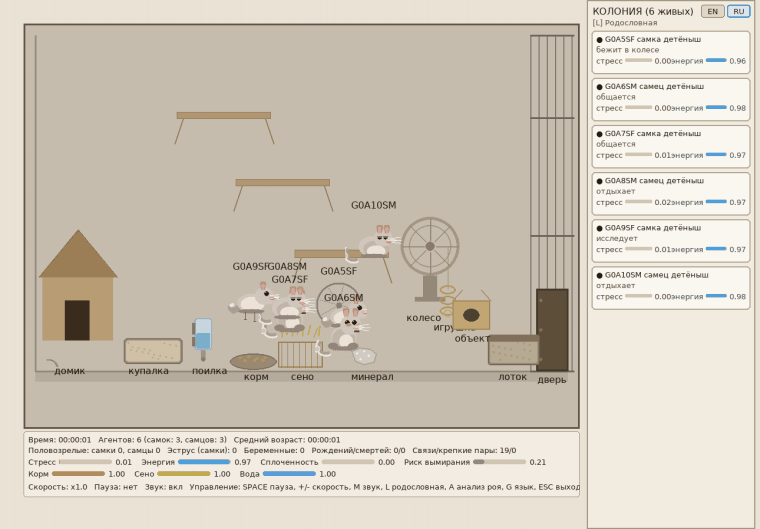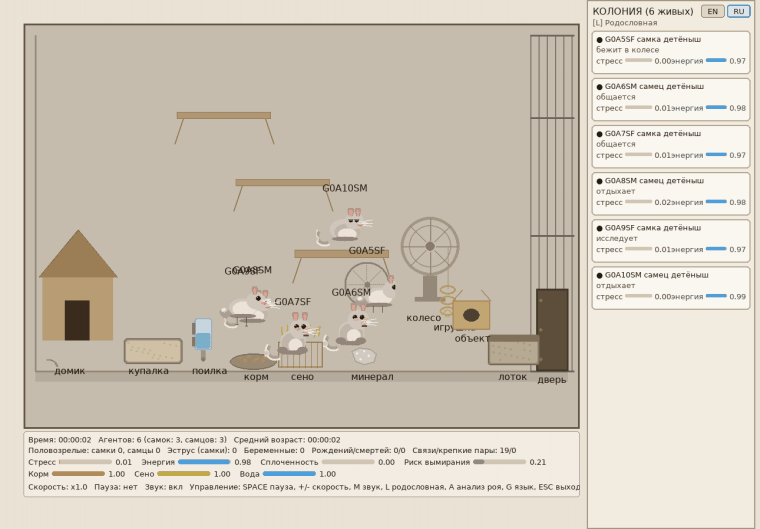
Колония из демо NOWA. Каждый зверёк — отдельный экземпляр одного и того же когнитивного ядра со своей памятью. Подписи вроде G0A5SF расшифровываются как поколение, номер в поколении и пол.
Привет, Хабр. Меня зовут Михаил Бурлаков. Эта статья о проекте, который начался с вопроса, а не с технологии. Что происходит с агентом, который не решает одну задачу, а живёт — долго, в мире, который всё время меняется? Что он запомнит, а что забудет? Как у него будут конкурировать память, настроение и привычка? И можно ли потом, глядя на его поступок, понять, почему он поступил именно так?
Современный ответ по умолчанию звучит так: возьми большую модель, задай функцию потерь и учи градиентом. Для распознавания и генерации текста это работает блестяще. Но у меня был другой предмет — существо, которое учится последовательно, по одному эпизоду. Именно в таком режиме глобальный градиент склонен к катастрофическому забыванию: новое обновление затирает старое. Мне хотелось собрать агента иначе, на тех механизмах, которыми с этой проблемой справляется животное. Днём оно записывает опыт быстро и «начерно», а переписывает долговременную память ночью, во сне. Получилась NOWA-Cognitive — когнитивная архитектура без обратного распространения ошибки, без глобальной функции потерь и без языковой модели в контуре решений.
Код лежит на GitHub: github.com/burlakovmb/NOWA-Bio-Inspired-AI. Это около 125 тысяч строк Python вместе с тестами и демо. Само ядро в src/ обходится стандартной библиотекой. Рассказывать устройство списком модулей скучно, поэтому я проведу вас через одни сутки одного конкретного агента и буду объяснять каждый механизм в тот момент, когда он ей понадобится.
Знакомьтесь: G3A1SF
Нашу героиню зовут G3A1SF. Имя она не выбирала, его выдал генератор колонии по шаблону G{поколение}A{номер}S{пол}: третье поколение, первая в нём, самка. Она родилась в коротком прогоне колонии с зерном генератора 11, о котором я ещё расскажу. Её родители — G2A1SF и G2A2SM, а родословная уходит к шести из восьми основателей.
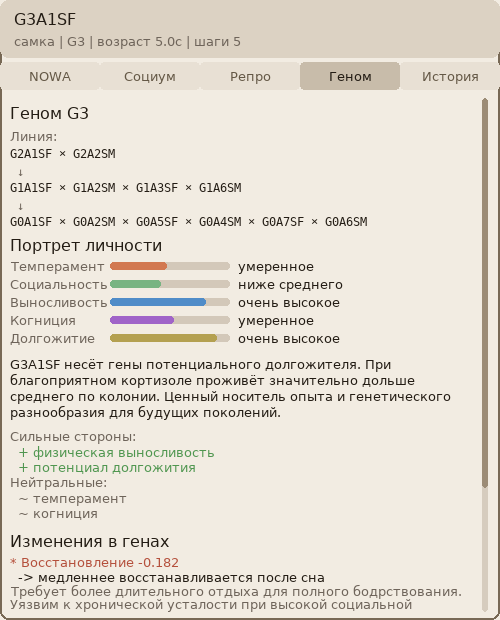
На скриншоте она совсем молода: пять секунд модельного времени, пять шагов. Для рассказа это даже удобно — почти всё, что составит её личность, ей ещё предстоит прожить. Сразу честно предупрежу: эпизоды её «дня» ниже — иллюстрация. Я описываю, что сделали бы с такими событиями модули ядра. Сами события взяты из тех, что реально порождает колония (Demo/Colony chinchillas/src/colony_agent.py): найденный корм, тревожный сигнал испуганного соседа, незнакомец рядом. Логом её реальной жизни это не является. А вот формулы и константы взяты из кода, с путями к файлам.
Утро: как она видит мир и выбирает
Мир приходит к G3A1SF не картинкой, а набором контекстных токенов вроде context:forage и event:found_hay. Первым на них откликается гиппокамп (src/hippocampus.py). Он ищет в памяти похожие эпизоды и активирует их. У молодой особи таких эпизодов почти нет. Так задумано: быстрая память здесь — это черновик, который пишется сразу и без особых церемоний.
Одновременно сдвигается её настроение. В NOWA эмоция — не набор флагов «испугана / довольна», а один непрерывный вектор из восьми осей в диапазоне от −1 до 1: валентность, возбуждение, доминирование, стресс, доверие, любопытство, стабильность и привязанность (AXES в src/affective_space.py). Каждый шаг вектор понемногу возвращается к своей базовой линии и получает толчки из трёх источников — от внешнего мира, от воспоминаний и изнутри:
A(t+1) = baseline + decay · (A(t) − baseline) + внешние + из памяти + внутренние − λ · (A(t) − baseline)
Простыми словами: настроение инерционно, но не бесконечно. Затухание у каждой оси своё. Стресс по умолчанию гаснет быстрее (0.75), доминирование держится дольше (0.97), и эти коэффициенты, как увидим позже, наследуются. Одну деталь я считаю важной: толчок из памяти ограничен 30% от среднего внешнего импульса. Воспоминание может окрасить происходящее, но не может его перекричать.
Теперь ей нужно что-то сделать. Каждое возможное действие — это канал в базальных ганглиях (src/basal_ganglia.py), и каналы соревнуются по схеме «Go против NoGo»:
Go   = давление · (1 + 0.9 · дофамин) + 0.6 · привычка
NoGo = |давление| · (1.2 · кортизол + 0.8 · неприятность)
итог = max(Go − NoGo − порог, 0)
Давление на канал собирает селектор (Agent._extract_selector_pressures) из активированных эпизодов гиппокампа, паттернов коры, памяти намерений, временных цепочек и слоя предсказания. Дофамин усиливает решимость действовать, кортизол и ощущение угрозы её тормозят, привычка добавляет инерцию. Аффект входит сюда же, через линейную матрицу решений: например, склонность к риску растёт с валентностью и доминированием и падает со стрессом (DEFAULT_DECISION_MATRIX). Так у G3A1SF появляются осторожность и скорость реакции, которые подкручивают NoGo и Go. Окончательный выбор делает «таламический» softmax, и его температура растёт с норадреналином: T = T0 · (1 + 0.6 · NE) · …. Встревоженное и возбуждённое животное выбирает более разбросанно — оно исследует.
Обратите внимание: ни один из пяти нейромодуляторов здесь ничего не решает. В докстринге NeuromodulatorState это записано прямо: «Neuromodulators modulate, they do NOT make decisions». Они меняют масштабы и пороги, а выбор остаётся за соревнованием каналов. Этот принцип проходит через всю архитектуру.
Неожиданность: ошибка предсказания вместо градиента
Допустим, G3A1SF пошла за сеном и нашла его — награда +0.85. Что она из этого вынесла? Здесь и проходит главный водораздел с привычным машинным обучением. Никакой функции потерь по всем параметрам нет. Есть локальная величина — насколько результат оказался лучше или хуже ожидаемого. Слой ценности (src/value_layer.py) хранит табличную оценку состояния V(s) и считает классическую TD-ошибку:
δ = r + γ · V(s') − V(s), γ = 0.95
Если δ положительна, мир оказался щедрее ожиданий; если отрицательна — хуже. Эта же δ становится фазическим всплеском дофамина: clamp(0.5 · δ, −0.1, 0.1). Нейробиологам это знакомо — дофамин как ошибка предсказания награды. Теперь представим, что рядом оказался сородич в сильном стрессе. Если его стресс выше 0.7, он подаёт тревожный сигнал: в колонии это событие alarm_call. Сигнал сам толкает стресс слушателя вверх — на 0.3, если сосед знаком, и на 0.15, если нет (_perceive_alarm_calls). Если в таком состоянии исход окажется хуже ожидаемого, срабатывает асимметрия, которую я заложил намеренно: в стрессе отрицательная ошибка усиливается, δ · (1 + 0.35 · стресс). Испуганное животное запоминает плохое сильнее хорошего. Одновременно растут кортизол и норадреналин. Норадреналин реагирует на новизну и на конфликт, причём конфликт сначала проходит через модель передней поясной коры: высокий норадреналин и кортизол его усиливают, серотонин гасит (_compute_effective_conflict_from_state).
Тут я должен поправить красивую формулу «днём не учится, учится только ночью» — её печатает даже мой собственный скрипт быстрого старта. Днём V(s) всё-таки получает маленький онлайн-шаг: V ← V + α · δ с α = 0.03 и мягким потолком 0.15. Величину этого шага регулирует ацетилхолин — модулятор внимания и новизны:
ach_effective = max(0.0, ach_v - ach_baseline_v)
alpha_v = alpha_v * (1.0 + (ach_gain * ach_effective))   # ach_gain = 0.4
Чем непривычнее ситуация, тем пластичнее оценка. И наоборот: если ожидание уже уверенное и стабильное, шаг уменьшается — α · (1 − уверенность · стабильность · 0.8). Зато настоящий «шок предсказания» шаг увеличивает. Важно другое: днём не трогаются веса каналов действий, привычки и паттерны долговременной памяти. Метод update_weights у каналов вызывается только из цикла сна. Днём G3A1SF лишь накапливает материал — эпизоды с запомненной ошибкой предсказания, уровнем ацетилхолина и «шоком», — чтобы ночью было что разбирать.
Ночь: что остаётся, а что уходит
Когда давление сна накапливается (модель «процесс S плюс циркадный процесс C» описана в препринте; амплитуда ритма и хронотип у G3A1SF заданы генами), агент засыпает. Сон в NOWA — не фоновое дообучение, а отдельный вызов SleepManager.sleep_cycle() в src/sleep.py. Именно здесь живёт большая часть смысла проекта.
Сначала сон спрашивает, можно ли вообще переписывать память. Если оценки ценности слишком разбросаны (дисперсия выше 0.25), повтор блокируется целиком. Нестабильный агент не должен закреплять свою нестабильность. Затем каждый дневной эпизод проходит фильтр. Слишком маленькая ошибка предсказания (|δ| < 0.12), слишком шумная, недостаточно заметное событие, нехватка подкреплений или внимания — и эпизод в консолидацию не попадает. Причины отказа считаются отдельно, поэтому после каждой ночи видно, почему что-то не запомнилось. Эпизод с найденным сеном и неудачный эпизод на фоне тревожного сигнала через фильтр, скорее всего, пройдут: оба оказались неожиданными. Рутинная минута у кормушки — нет.
Из прошедших сон выбирает, что именно «проиграть» заново. Приоритет формулируется просто:
приоритет = |δ| · (1 + шок) · (1 − стабильность)
Его стоит прочитать словами. Повторять нужно то, что удивило и что ещё не устоялось; уже понятное повторять незачем. Сверху приоритет подкрепляет ацетилхолин, запомненный при эпизоде. Выборка вероятностная, с бюджетом 32 повтора за ночь и ограничением на повторы одного и того же. Затем повторы выстраиваются по времени, и каждому эпизоду присваивается «причинная глубина» — насколько далеко он стоял от момента награды, в окне из шести шагов. Обновление ценности во сне затухает с этой глубиной (λ^глубина при λ = 0.85 и exp(−глубина/3)). Если G3A1SF сначала пошла к сену, потом нашла его, а потом поела, заслугу получит вся цепочка, но ближайшие к награде шаги — больше.
И только теперь меняются каналы действий. Канал, который привёл к хорошему исходу, получает прибавку к Go и убавку к NoGo пропорционально δ: go += 0.015 · 1.15 · δ, nogo −= 0.015 · 0.85 · δ. При плохом исходе — зеркально. После этого веса обязательно затухают и нормализуются. Спецификация фазы 5.A.2 прямо требует, чтобы многократные подкрепления не уводили веса в насыщение. Похожие эпизоды (сходство не ниже 0.8) сливаются в паттерн коры — так черновик гиппокампа становится долговременным знанием. Из недавних эпизодов собираются временные цепочки. Наконец, всё нестабильное, редко подкреплённое и неактивное забывается: в памяти остаются эпизоды со стабильностью от 0.2, с тремя и более подкреплениями или с высокой активацией.
Нейромодуляторы ночью работают тоньше, чем днём. Дофамин чуть усиливает паттерны коры (strength · (1 + 0.05 · DA)). Серотонин повышает стабильность свежих эпизодов. Высокий кортизол поднимает порог забывания (0.2 + 0.2 · CORT), и после тяжёлого дня агент забывает больше слабых следов. Высокий норадреналин запускает дополнительный проход формирования более длинных цепочек. Сама ночь классифицируется как медленный сон, REM или переходная фаза — по среднему возбуждению, «шоку» и уверенности в отобранных эпизодах. От фазы зависят коэффициенты семантической консолидации. Про код скажу честно: в NeuromodulatorState есть и обобщённые «ручки» вроде get_learning_rate_modifier() и get_forgetting_rate(), но цикл сна ядра использует описанные выше прямые правила, а эти геттеры сейчас вызывает только демо тамагочи.
Если запустить быстрый старт, итог дня и ночи виден в выводе: после пяти эпизодов и одного цикла сна у агента из sixty_seconds.py дофамин поднялся с 0.10 до 0.50, норадреналин — до 0.52, ацетилхолин — до 0.25, а аффект сместился (валентность +0.49, стресс +0.15). Утром это уже немного другое существо.
Наследство: что G3A1SF получила от родителей и что передаст
Почему у G3A1SF стресс гаснет так, а не иначе, и почему она восстанавливается после сна медленнее соседей? Часть ответа записана в её геноме. GenomeVector в src/genome.py — это 39 генов, и каждый задаёт коэффициент какого-то модуля: силу взаимного торможения дофамина и норадреналина, полупериод распада нейромодуляторов, инерцию каждой оси настроения, амплитуду и фазу циркадного ритма, пороги любопытства и общительности, скорость онлайн-обучения, порог консолидации, множитель продолжительности жизни. У каждого гена есть границы, значение по умолчанию и собственная σ мутации:
("nm_da_ne_weight", "neuromodulators", -0.4, 0.0, -0.2, 0.05, "DA to NE inhibition"),
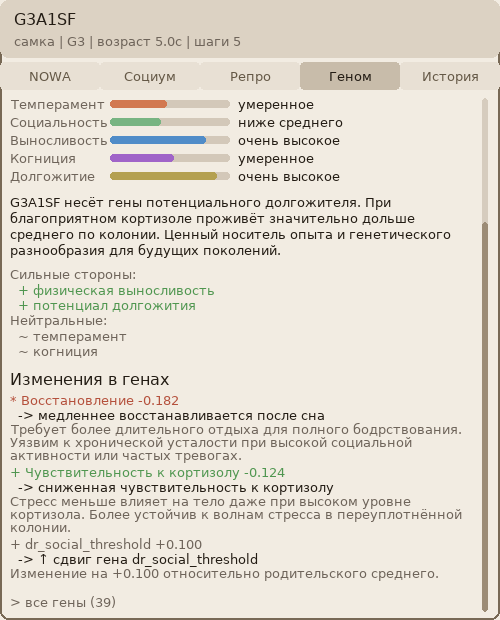
В колонии потомок получает от родителей ровно середину их генов (арифметический кроссовер с alpha = 0.5), а затем каждый ген с вероятностью 5% сдвигается гауссовой мутацией. Значит, всё, чем G3A1SF отличается от «среднего своих родителей», — результат мутаций. Вкладка «Изменения в генах» показывает это прямо: восстановление −0.182 («медленнее восстанавливается после сна»), чувствительность к кортизолу −0.124 («стресс меньше влияет на тело»), порог общительности +0.100.
Геном меняет только параметры, а не схему связей между модулями. Я выбрал это ограничение сознательно, пусть оно и сужает то, что может дать эволюция. Есть и второй канал наследования — эпигеном (src/epigenome.py). Это ограниченный снимок того, что родитель уже консолидировал во сне: до 32 паттернов, 16 действий и 24 профилей ценности. По умолчанию в него попадают следы минимум с двумя подкреплениями. При передаче к силе каждого следа добавляется шум, а если у потомка уже есть свой паттерн для того же контекста, побеждает более сильный. Унаследованный след — подсказка, а не перезапись чужой памяти. В интерфейсе родословная выглядит так:
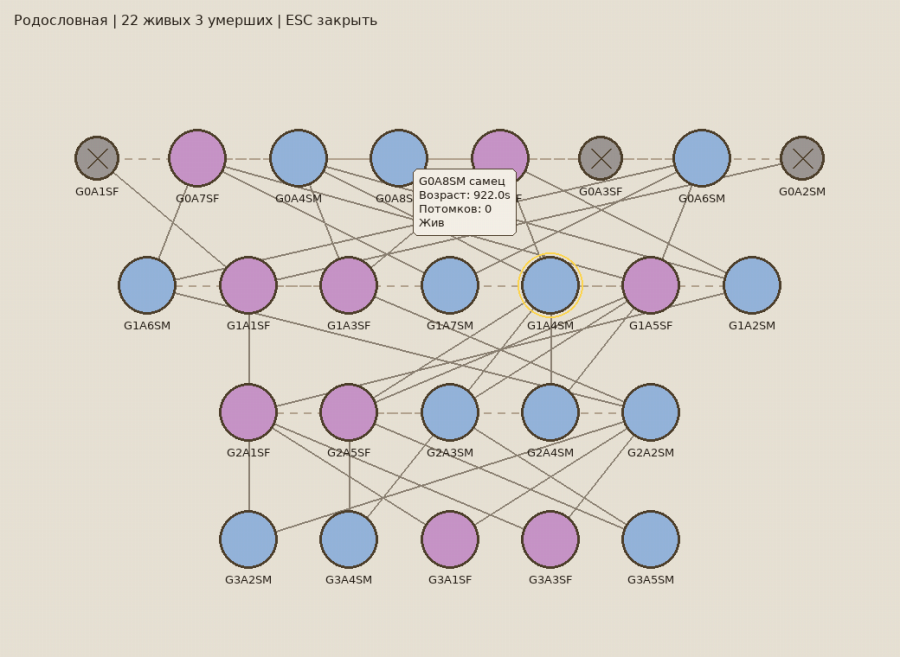
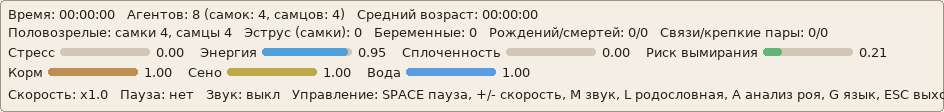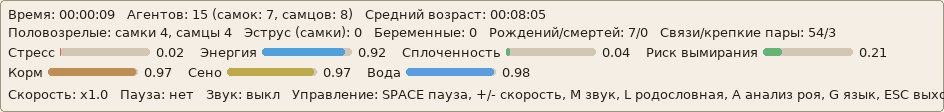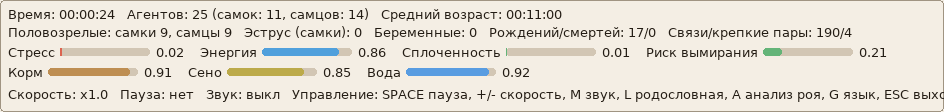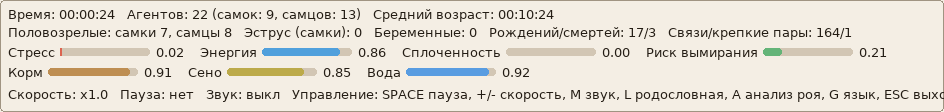
Прогон, в котором родилась G3A1SF, начинался с восьми основателей. За три волны рождений появилось 17 потомков, трое основателей умерли, и в конце жили 22 агента четырёх поколений. Полоса состояния ниже показывает пять срезов: 8, затем 15, 20 и 25 живых, затем 22.
На панели аналитики роя видны тренды по поколениям. Она даже помечает некоторые гены как «находящиеся под отбором»:
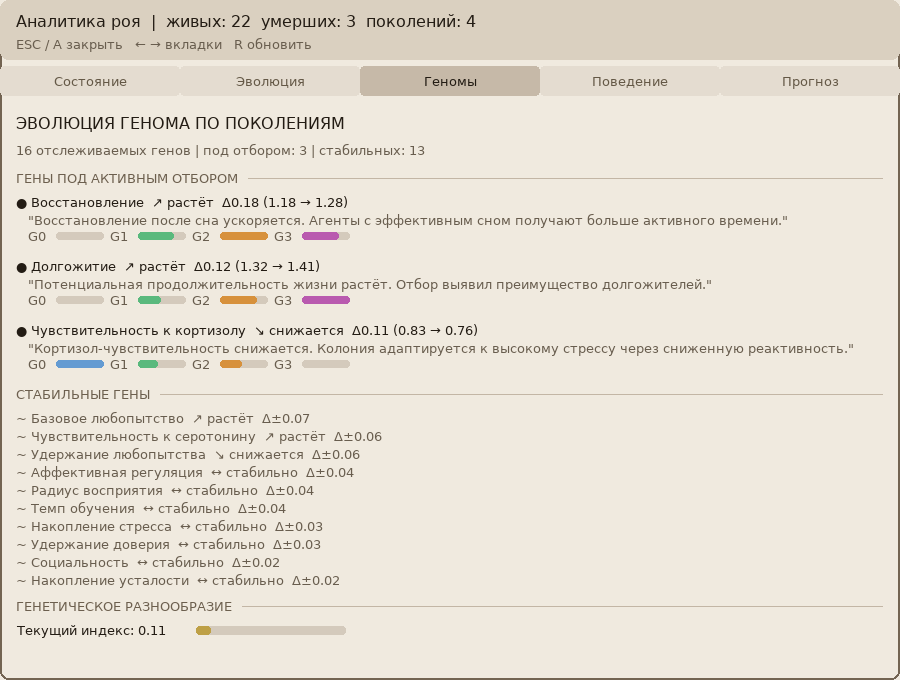
Надпись «под отбором» — эвристика панели по трендам средних значений за четыре поколения, статистикой её считать нельзя. К тому же панель следит за 16 генами из 39. Скриншот показывает, что путь «рождение → геном → эпигеном → родословная» работает от начала до конца. Больше ничего он не доказывает.
Тот же ум в другом теле
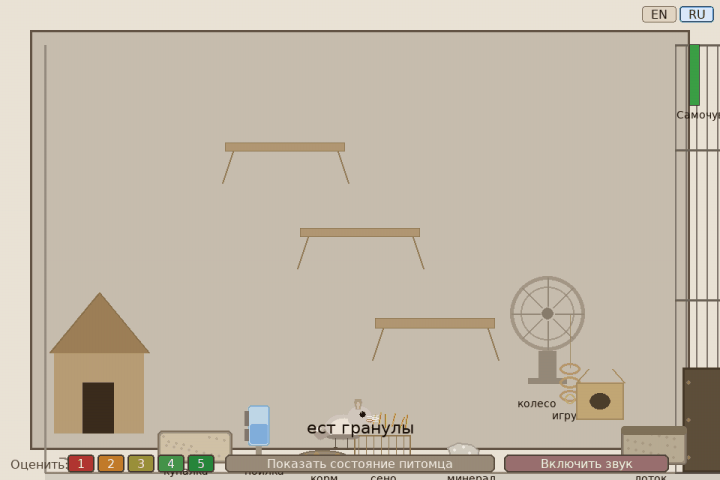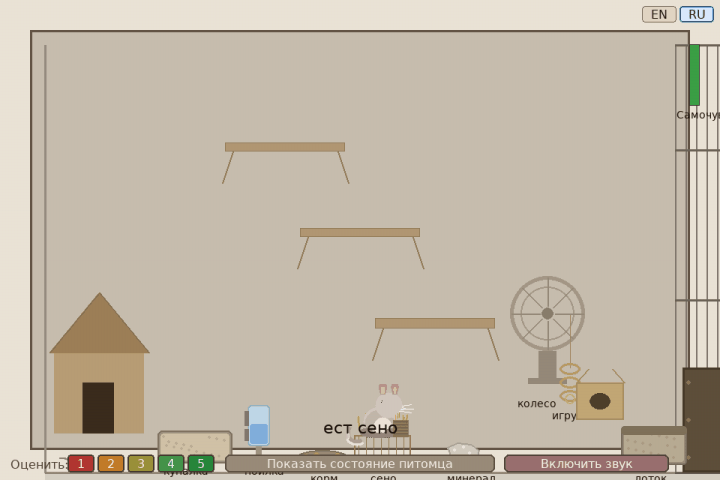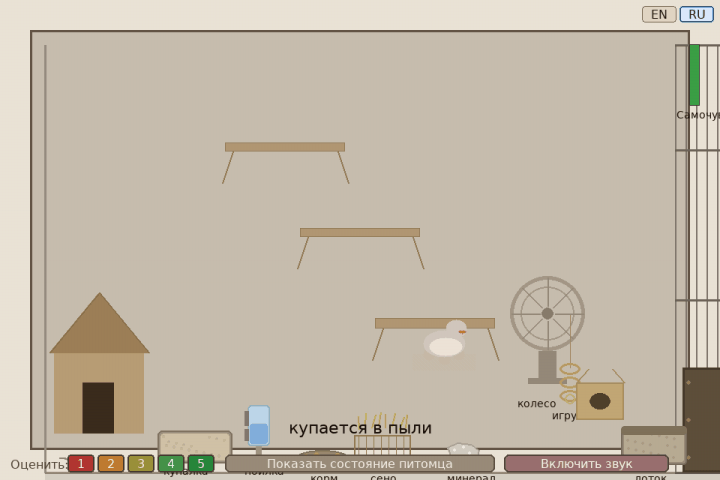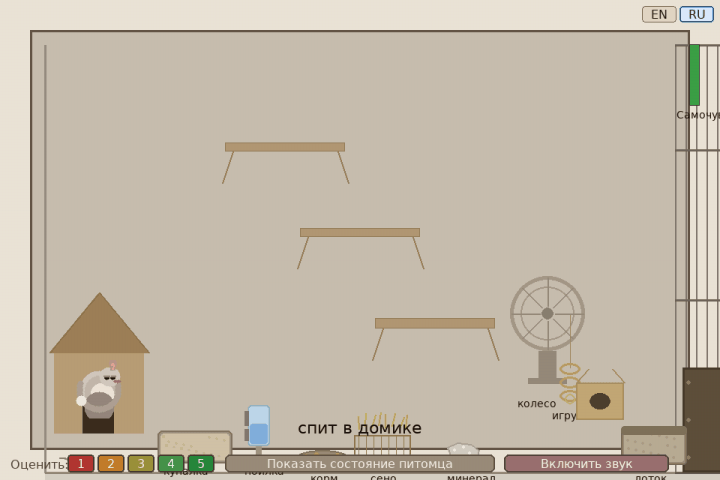
Для меня самое интересное в колонии — не шиншиллы, а разделение ума и тела. Ядро ничего не знает о клетке, сене и колесе. Оно получает токены контекста и возвращает выбор канала. Отсюда следующий шаг: посадить тот же ум в совсем другое тело.
Самое практичное из этих тел — агент на инструментах внешнего MCP-сервера (src/mcp_body/). Инструменты становятся органами: чтение работает как органы чувств, запись — как мышцы. Ум выбирает, какой инструмент применить, а тело собирает аргументы из схемы инструмента, состояния мира и весов, выведенных из того же 8-мерного аффекта (осторожность, неприятие затрат, тяга к новому). Языковая модель не нужна ни на одном шаге. Поскольку мышцы здесь могут, например, оплатить счёт, контур безопасности жёсткий. Каждый новый инструмент получает класс риска по имени: get_/list_ — только чтение, create_/send_ — средняя запись, pay_/transfer_ — высокая, delete_/revoke_ — необратимая. Неоднозначные имена уходят в более опасный класс, а администратор обязан подтвердить класс до выдачи инструмента. Через ApprovalGate проходит любая запись во внешний мир. Чтение выполняется сразу, а всё, что требует согласования, встаёт в очередь и ждёт человека, который может принять, поправить или отклонить. Решение возвращается агенту как обычная награда: +1.0 за принятое, +0.4 за поправленное, −1.0 за отклонённое, −0.2 за просроченное. Получается, человек-согласующий учит агента тем же дофаминовым сигналом, что сено учит шиншиллу.
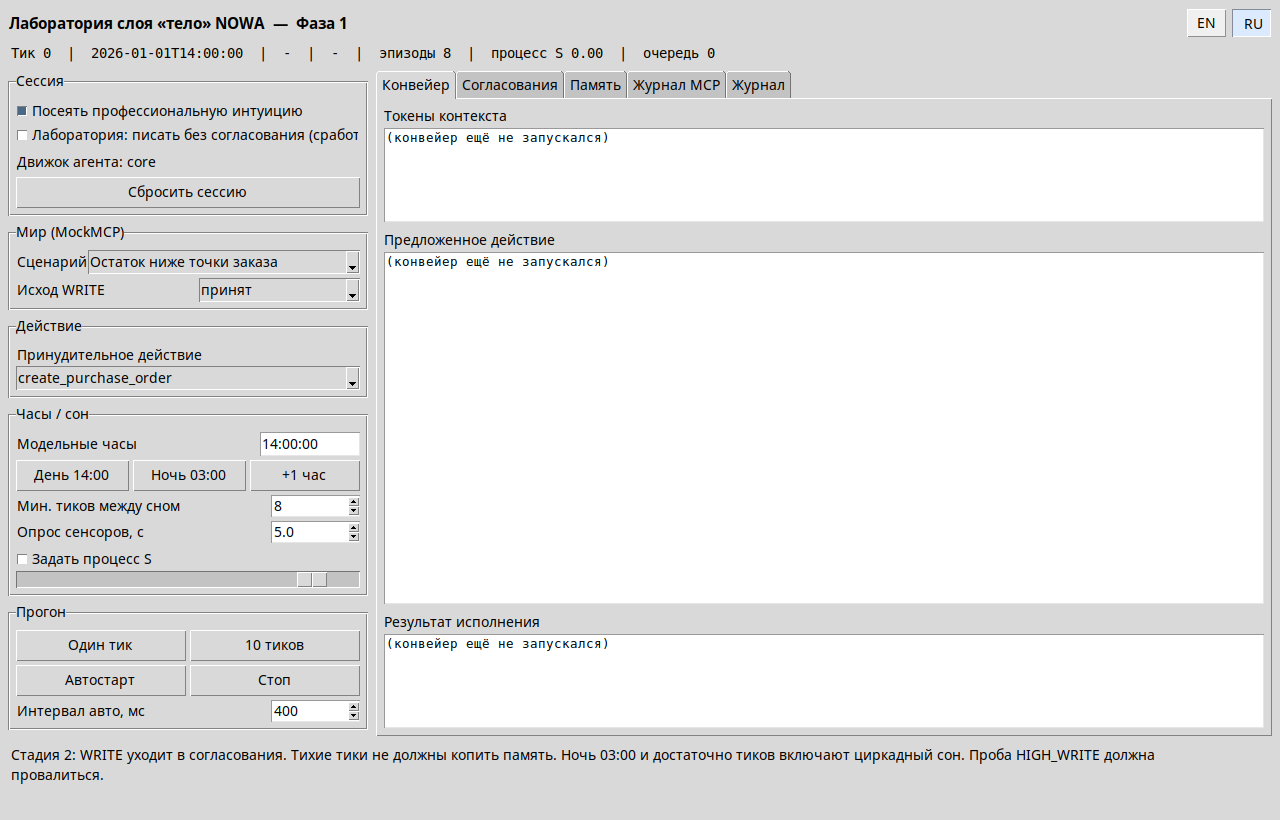
Разобранный пример — закупки в Demo/Virtual company/: песочница с поставщиками и спросом, хост «сотрудников» и конфигуратор ролей. Роль задаётся данными. Деньги, права и лимиты живут в теле, вне когнитивного контура. Сон наступает по расписанию, ночью. Ещё два тела проще. Тамагочи — одна особь с непрерывной визуализацией, на которой удобно наблюдать, как нужда, аффект и привычка сменяют друг друга. Сверка с нормами Уорринер — стенд, а не дом: колония получает слова как стимулы, и средний сдвиг её валентности сравнивается с человеческими оценками Warriner, Kuperman и Brysbaert (2013). Числа корреляции я здесь не привожу намеренно: итог даёт прогон валидатора, а совпадение рангов проверяет аффективное отображение, а не понимание смысла слов.
Чего G3A1SF пока не умеет
Если вы дочитали до этого места, у вас наверняка один вопрос: а насколько это хорошо по сравнению с обычным RL? Честный ответ — я не знаю. Прямого сравнения с PPO или SAC на той же задаче в репозитории нет. Сейчас проверка — правдоподобность поведения и регрессионные тесты, поэтому бенчмарков в статье нет. В препринте (Docs/arxiv_NOWA_ru.md, раздел 6.2) я перечисляю и другие слабые места, и они прямо следуют из рассказанного выше. Награда, новизна и конфликт в колонии заданы эвристически. Эволюция настраивает параметры, но не изобретает новые связи. «Воображение» агента рекомбинирует память и не является обученной моделью мира. Эпигеном — сжатый снимок, а не культура. Тело для MCP проверено инвариантами и в лаборатории, но его ещё никто не ставил рядом с живым оператором на реальной задаче.
Есть и инженерная честность другого рода. Коэффициенты вроде весов в оценке консолидации или множителей 1.15 и 0.85 в обновлении каналов взяты из спецификаций фаз. Это решения, принятые руками, а не подогнанные к данным величины. В Docs/ много лабораторных отчётов по фазам разработки. Они сохранены как журнал, а актуальный контракт задают нормативные спецификации и код. Если вы найдёте место, где документ и код расходятся, — верьте коду и, пожалуйста, напишите мне. Я все же естественный интеллект и иногда правя код мог забыть поправить документацию ;).
Попробуйте прожить с ней сутки сами
Чтобы увидеть всё это вживую, хватит Python 3.10+ без единого внешнего пакета!
git clone https://github.com/burlakovmb/NOWA-Bio-Inspired-AI
cd NOWA-Bio-Inspired-AI
Читать дальше я советую в таком порядке: Docs/START_HERE_NEW.ru.md, затем научное описание Docs/SCIENTIFIC_DESCRIPTION.ru.md и препринт Docs/arxiv_NOWA_ru.md с формализацией и связью с литературой.
Про условия использования. Проект распространяется по лицензии PolyForm Strict 1.0.0: исходники открыты для чтения и запуска, бесплатно для исследований и некоммерческого использования. Публичная лицензия не разрешает распространение и производные работы. Для изменений, распространения и коммерческого использования нужна отдельная лицензия — напишите мне на GitHub, @burlakovmb. Для научного цитирования есть CITATION.cff.
Я начинал с вопроса, что останется от агента после долгой жизни и сможем ли мы понять, почему он стал таким. Буду честен полного ответа у меня нет. Разные прогоны дают разные результаты. Процесс эволюции и поведения агентов непредсказуемы заранее. Но у каждого её будущего поступка есть прослеживаемая причина: эпизод, ошибка предсказания, ночь, которая этот эпизод сохранила, и ген, который сделал эту ночь чуть короче. Мне очень пригодится взгляд со стороны, особенно от тех, кто занимается вычислительной нейронаукой, RL или агентными системами. Где моя модель нейромодуляции наивна? Какой эксперимент был бы честным сравнением с deep RL для существа, которое живёт долго? Где в реальных системах вы видите место для такого «тела» на MCP-инструментах? Пишите в комментариях или в Issues. А если история G3A1SF показалась вам интересной, поставьте репозиторию звезду — так мне проще понять, что её стоит продолжать.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.