От 798 до 16 нс: как оптимизация debounce привела меня в Swift Runtime
Я прочитал статью Side Effect про debounce на Swift Concurrency и решил проверить, какой прирост производительности дает предложенный там подход. Идея простая: вместо того чтобы создавать новую Task на каждое входящее значение, можно использовать одну и ту же Task для всех событий и продлевать время ожидания.
В моем тесте такая замена сократила среднее время выполнения с 798 до 216 нс. Уже хороший результат, но оставалось непонятно, на что уходят эти 216 нс. В большинстве вызовов Task больше не создается: нужно получить текущее время, сохранить новое значение и пересчитать deadline (момент окончания ожидания).
В итоге я дошел до 16 нс. По пути пришлось разобраться, что происходит при выполнении этих нескольких строк Swift-кода: как runtime работает с типами, что компилятор может оптимизировать и почему расположение блокировки в памяти влияет на результат. В статье я покажу, как проверял свои гипотезы и что обнаружил в экспериментах. Надеюсь, этот опыт пригодится тем, кто хочет разобраться в производительности своего Swift-кода.
Сразу обозначу, что именно здесь ускорилось в 50 раз. Оптимизация относится к среднему времени выполнения одного вызова метода отправки значения. В тесте этот метод вызывался 100 000 раз подряд (без пауз). Метод обновляет состояние debounce и возвращает управление, а обработчик вызывается позже, после заданной задержки с момента последнего значения.
В этой статье
Как межмодульная оптимизация влияет на специализацию generic-кода
Как расположение блокировки в памяти влияет на производительность
Переиспользуем одну и ту же Task
Представим поле поиска, в котором мы не хотим отправлять запрос после каждого нажатия на клавиатуре. Для этого используем trailing debounce: после каждого изменения текста откладываем запрос на 500 мс. Если за это время пользователь ничего не ввел, отправляем запрос с последним значением, а если продолжил печатать, то откладываем его еще раз.
Самая простая реализация отменяет предыдущую Task и создает следующую:
task?.cancel()
task = Task {
    do {
        try await Task.sleep(for: dueTime)
        await output(value)
    } catch {
        // Отмененная задача завершается без передачи значения.
    }
}
Это фрагмент реализации с Task на каждое значение. В таком варианте созданные Task будут отменяться, если новые значения поступают раньше, чем истекает задержка debounce. Но создание Task, запрос на ее отмену и обработка этого запроса все равно требуют ресурсов. Отмена в Swift кооперативная: вызов cancel() не означает, что Task сразу завершилась.
Предложенный подход из статьи Side Effect переносит последнее значение и deadline в общее состояние. Первая отправка запускает рабочую задачу. Следующие отправки только меняют состояние. Когда Task просыпается, она проверяет, пора ли вызывать обработчик: если за время сна пришли новые значения, то будет ждать дальше; если после последнего значения прошла заданная задержка, то вызовет обработчик.
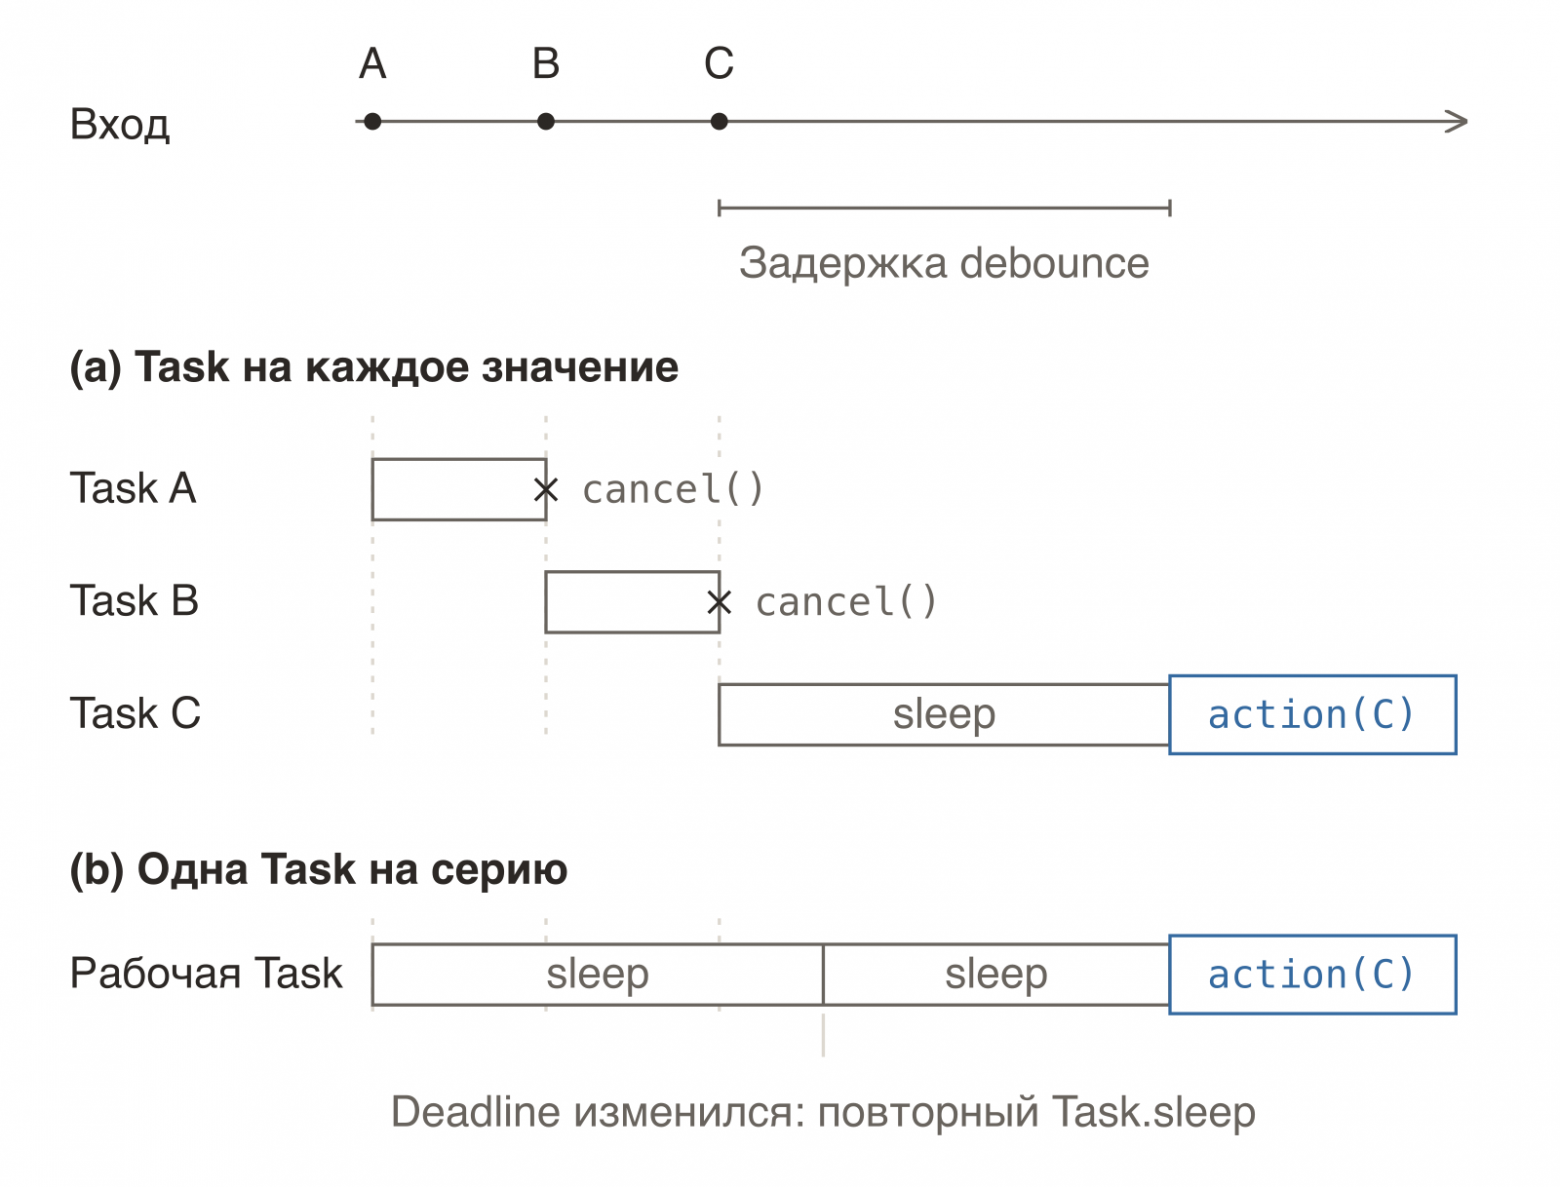
Task. Рабочая задача может проснуться несколько раз, прежде чем передаст последнее значение.Чтобы отложить обработку, достаточно обновить состояние. Прерывать текущий вызов Task.sleep не требуется. Это важная часть экономии: частые входящие события не превращаются в столь же частые действия планировщика.
Реализация emit с переиспользованием Task
Вот метод emit исходной реализации с рабочей задачей:
public func emit(value: T) {
    let (shouldStartWorker, initialDeadline) = stateMachine.apply { machine in
        machine.newValue(value)
    }

    guard shouldStartWorker else {
        return
    }

    let worker = Task { [stateMachine, output] in
        var deadline = initialDeadline

        while true {
            try? await Task.sleep(until: deadline, clock: .continuous)

            let nextStep = stateMachine.apply { machine in
                machine.sleepIsOver()
            }

            switch nextStep {
            case .finishDebouncing(let latestValue):
                await output(latestValue)
                return
            case .continueDebouncing(let newDueTime):
                deadline = newDueTime
            }
        }
    }

    task.set(stored: worker)
}
Во время уже начатой серии большая часть вызовов заканчивается на guard. Машина состояний (конечный автомат) обновляет ожидающее значение и сообщает, что новая Task не нужна.
Результат переиспользования одной Task
Сначала сравним две стратегии: Task на каждое значение и одна рабочая задача на всю серию.
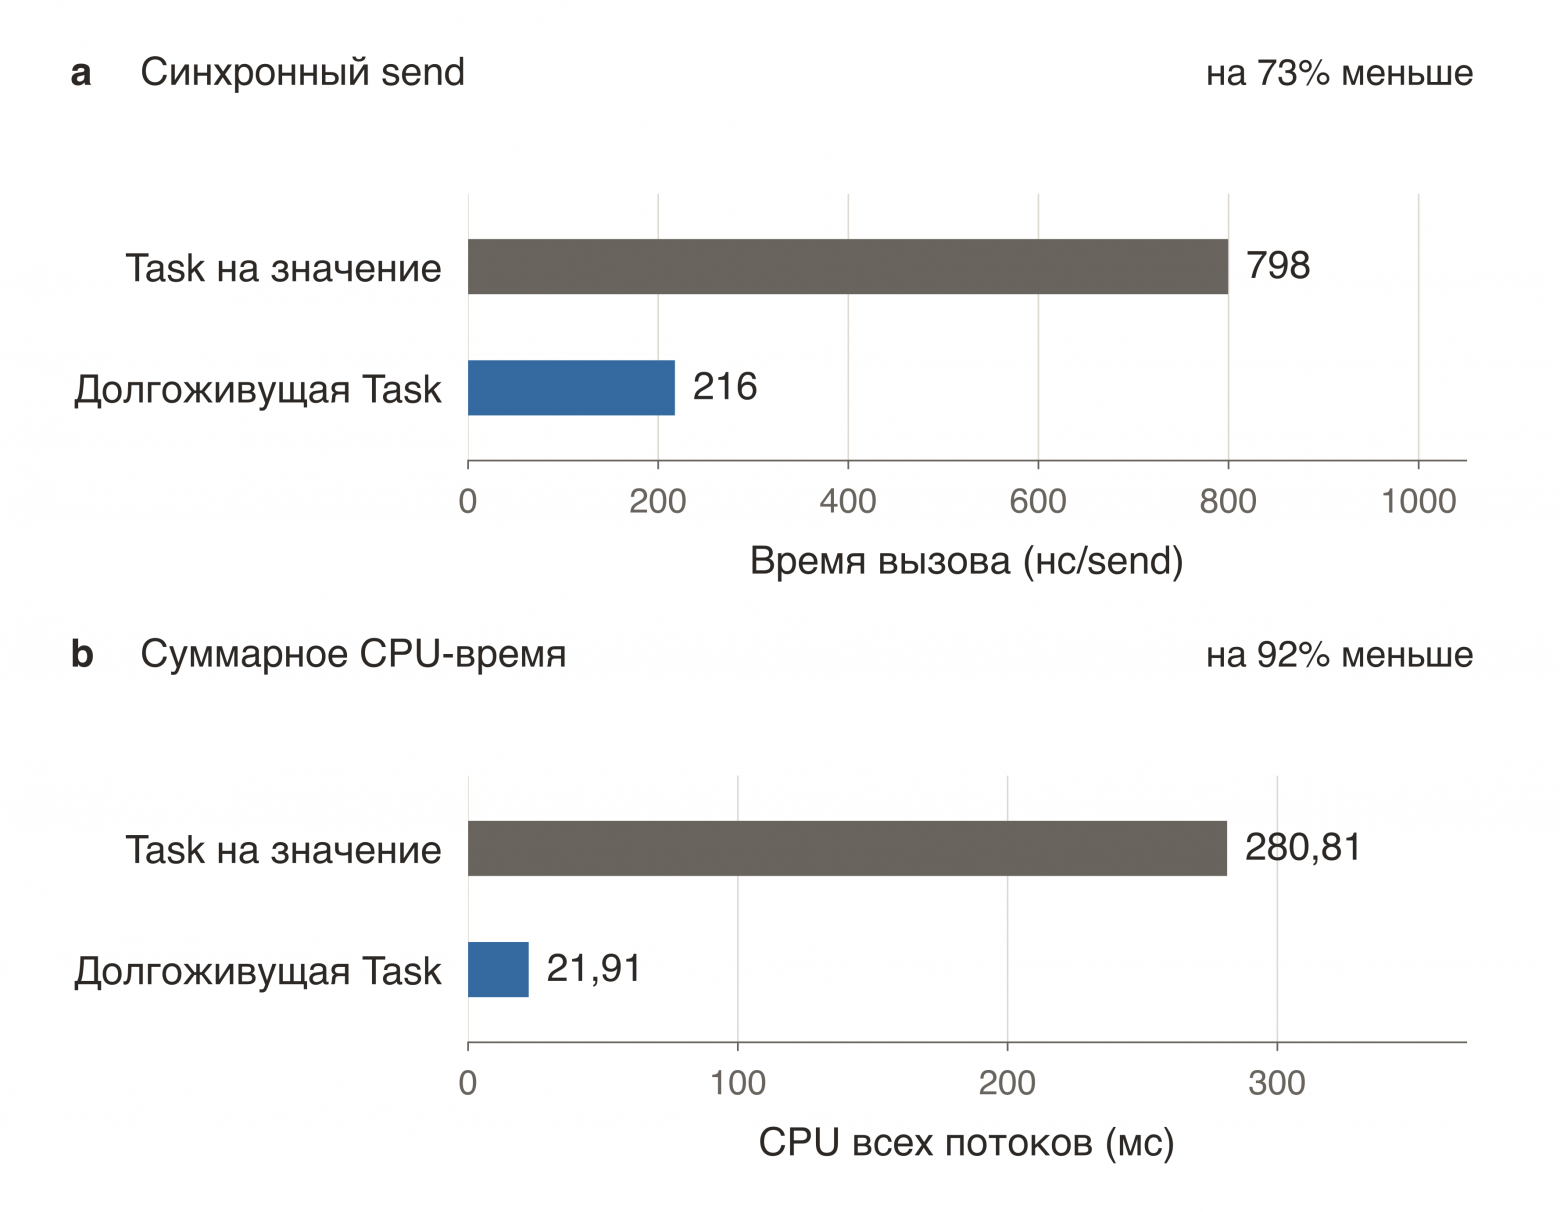
При переходе к одной рабочей задаче среднее время выполнения emit сократилось примерно в 3,7 раза, а CPU-время примерно в 13 раз.
Окружение и условия сравнения
Результаты выше получены 13 октября 2026 года на версии кода из коммита 990cf04.
При сравнении нужно учитывать несколько отличий:
В две исходные реализации я добавил атомарные счетчики созданных
Taskи завершенийTask.sleep. В моей реализации из библиотекиswift-debounceтаких счетчиков нет, поэтому дополнительная работа по подсчету есть только у исходных реализаций.Для модуля
Referencesвключена межмодульная оптимизация (CMO). Но проверка сгенерированного кода показала, что компилятор не создал версииemit, специализированные подInt. Другие оптимизации при этом могли применяться.Реализации по-разному выполняют обработчики: исходная допускает их одновременное выполнение, а
swift-debounceвыполняет их последовательно.
В этом тесте проверяется, что обработчик вызывается один раз и получает последнее отправленное значение.
Переиспользование Task дало заметное ускорение, но оставалось понять, на что уходят 216 нс. Дальнейшие эксперименты проводились на разных нагрузках и версиях прототипа.
Может быть, все дело в блокировке?
В исходной реализации Side Effect общее состояние защищено NSRecursiveLock. При каждом значении мы захватываем блокировку и отпускаем ее, поэтому это было первым местом для проверки.
Я сравнил NSRecursiveLock с os_unfair_lock в двух тестах: при увеличении счетчика под блокировкой и при выполнении всего метода emit.
Операция, один поток |
|
|
|---|---|---|
Захват, увеличение счетчика, освобождение | 17,1 нс | 8,0 нс |
Полный | 188,0 нс | 177,7 нс |
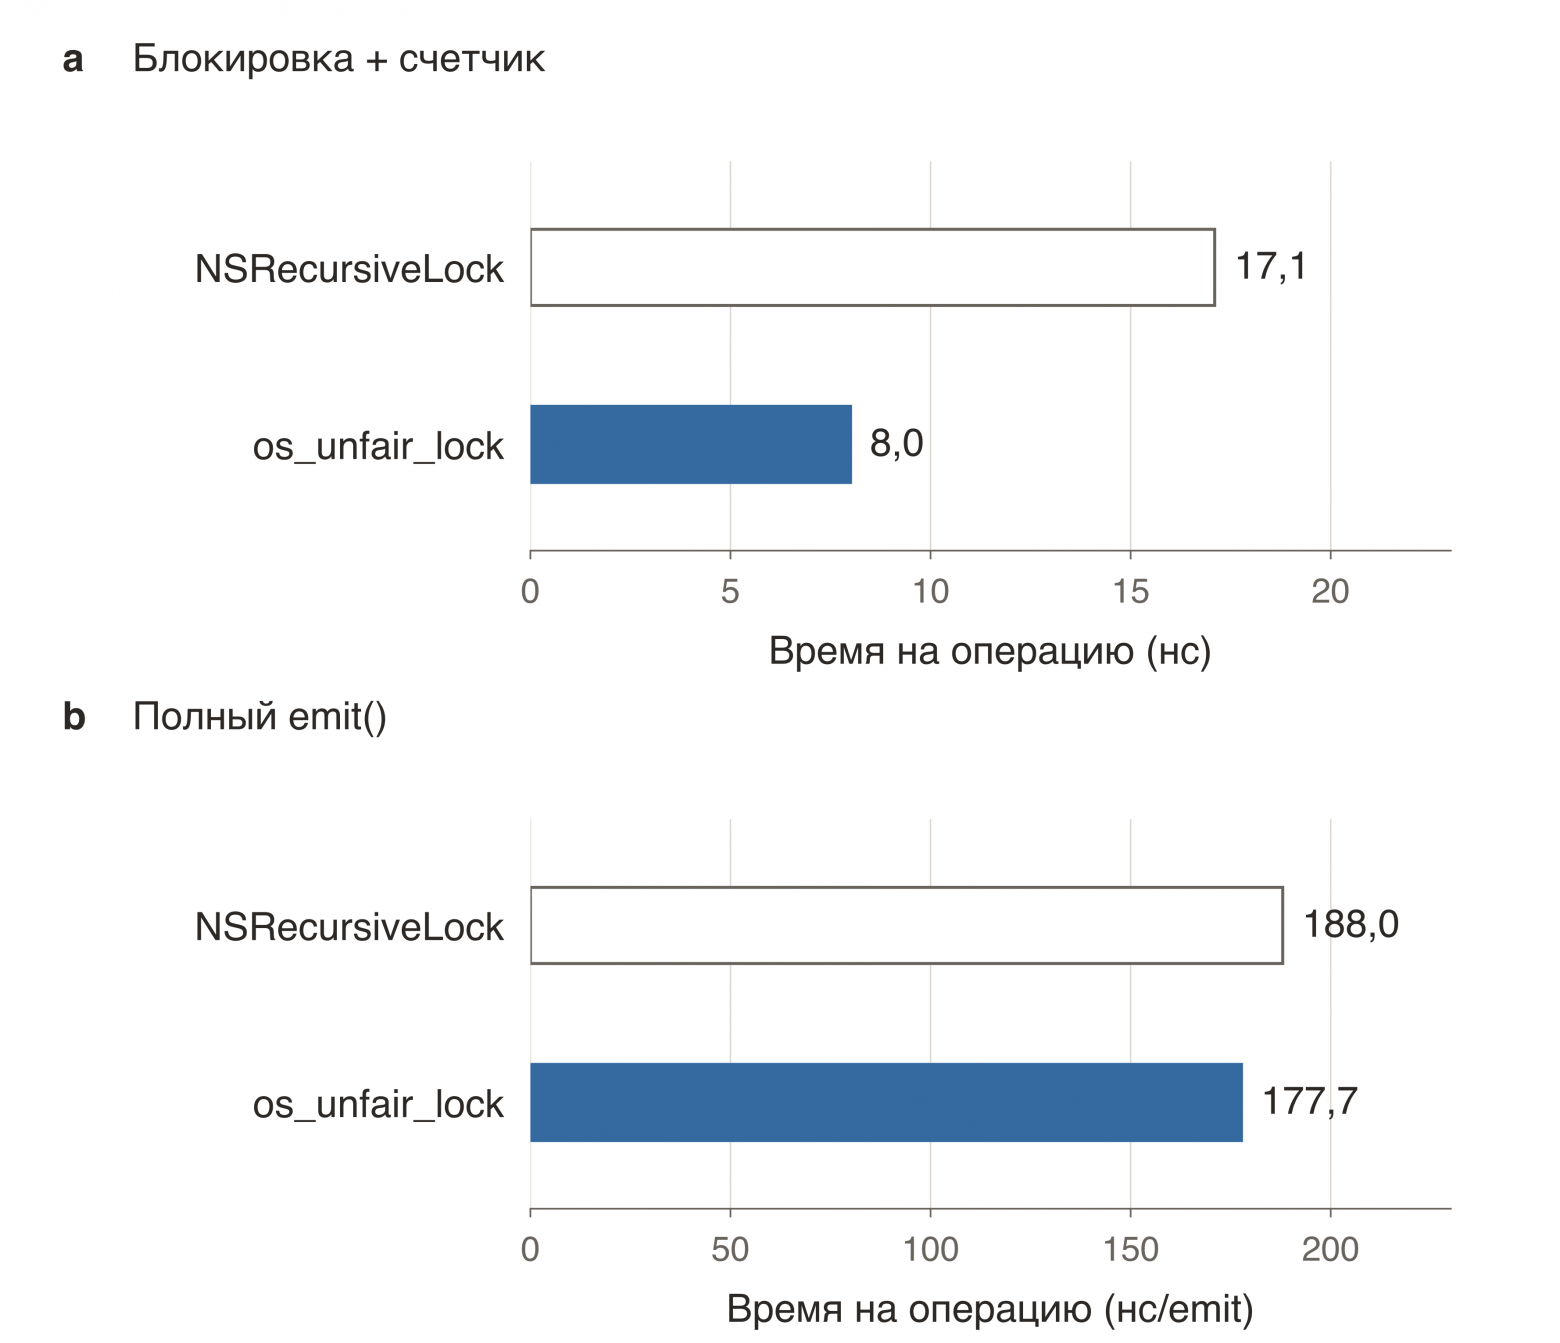
На отдельной блокировке разница выглядит внушительно: почти вдвое. В полном методе выигрыш составил 10,3 нс, около 5,5%. Большая часть стоимости осталась на месте.
Блокировку имело смысл заменить, но оставшиеся затраты одного отправителя она не объясняла. Я перешел к чтению времени и обновлению состояния.
Конкретный тип еще не означает известный layout
При профилировании метода emit я обнаружил вызовы следующих функций Swift Runtime:
type metadata accessor for ContinuousClock.Instant
swift_getGenericMetadata
swift_getTupleTypeMetadata
На первый взгляд странно. deadline хранится в значении конкретного типа ContinuousClock.Instant. В тесте входящее значение тоже конкретное: Int. Откуда работа с метаданными типов?
Компилятор может знать конкретный тип, но не иметь гарантий о его размере и расположении полей в памяти.
Layout типа определяет его размер, выравнивание и расположение полей в памяти. В режиме library evolution библиотека может менять внутреннее устройство типа-значения без @frozen, сохраняя совместимость с уже собранными клиентами. Для этого клиентский код не должен полагаться на текущий размер структуры и смещения ее полей. Атрибут @frozen дает более жесткие гарантии layout, но в определении ContinuousClock.Instant его нет.
В машине состояний deadline хранится внутри enum вместе со значением:
struct DebounceStateMachine<T> {
    enum State {
        case idle
        case debouncing(
            value: T,
            dueTime: ContinuousClock.Instant,
            isValueDuringSleep: Bool
        )
    }
    // ...
}
При новом значении метод получает текущее время, заменяет содержимое enum и возвращает новый deadline. Для замены значения машинному коду, сгенерированному компилятором, нужно определить расположение полей и записать новые данные.
В Swift метаданные типа связаны с value witness table (подробнее о ее роли в generic-коде). В ней есть информация о layout значения и операции копирования, перемещения и уничтожения. Когда layout типа неизвестен при компиляции, сгенерированный машинный код может использовать операции из value witness table для копирования, перемещения и уничтожения значения. Связь метаданных и value witness table описана в документации Swift ABI.
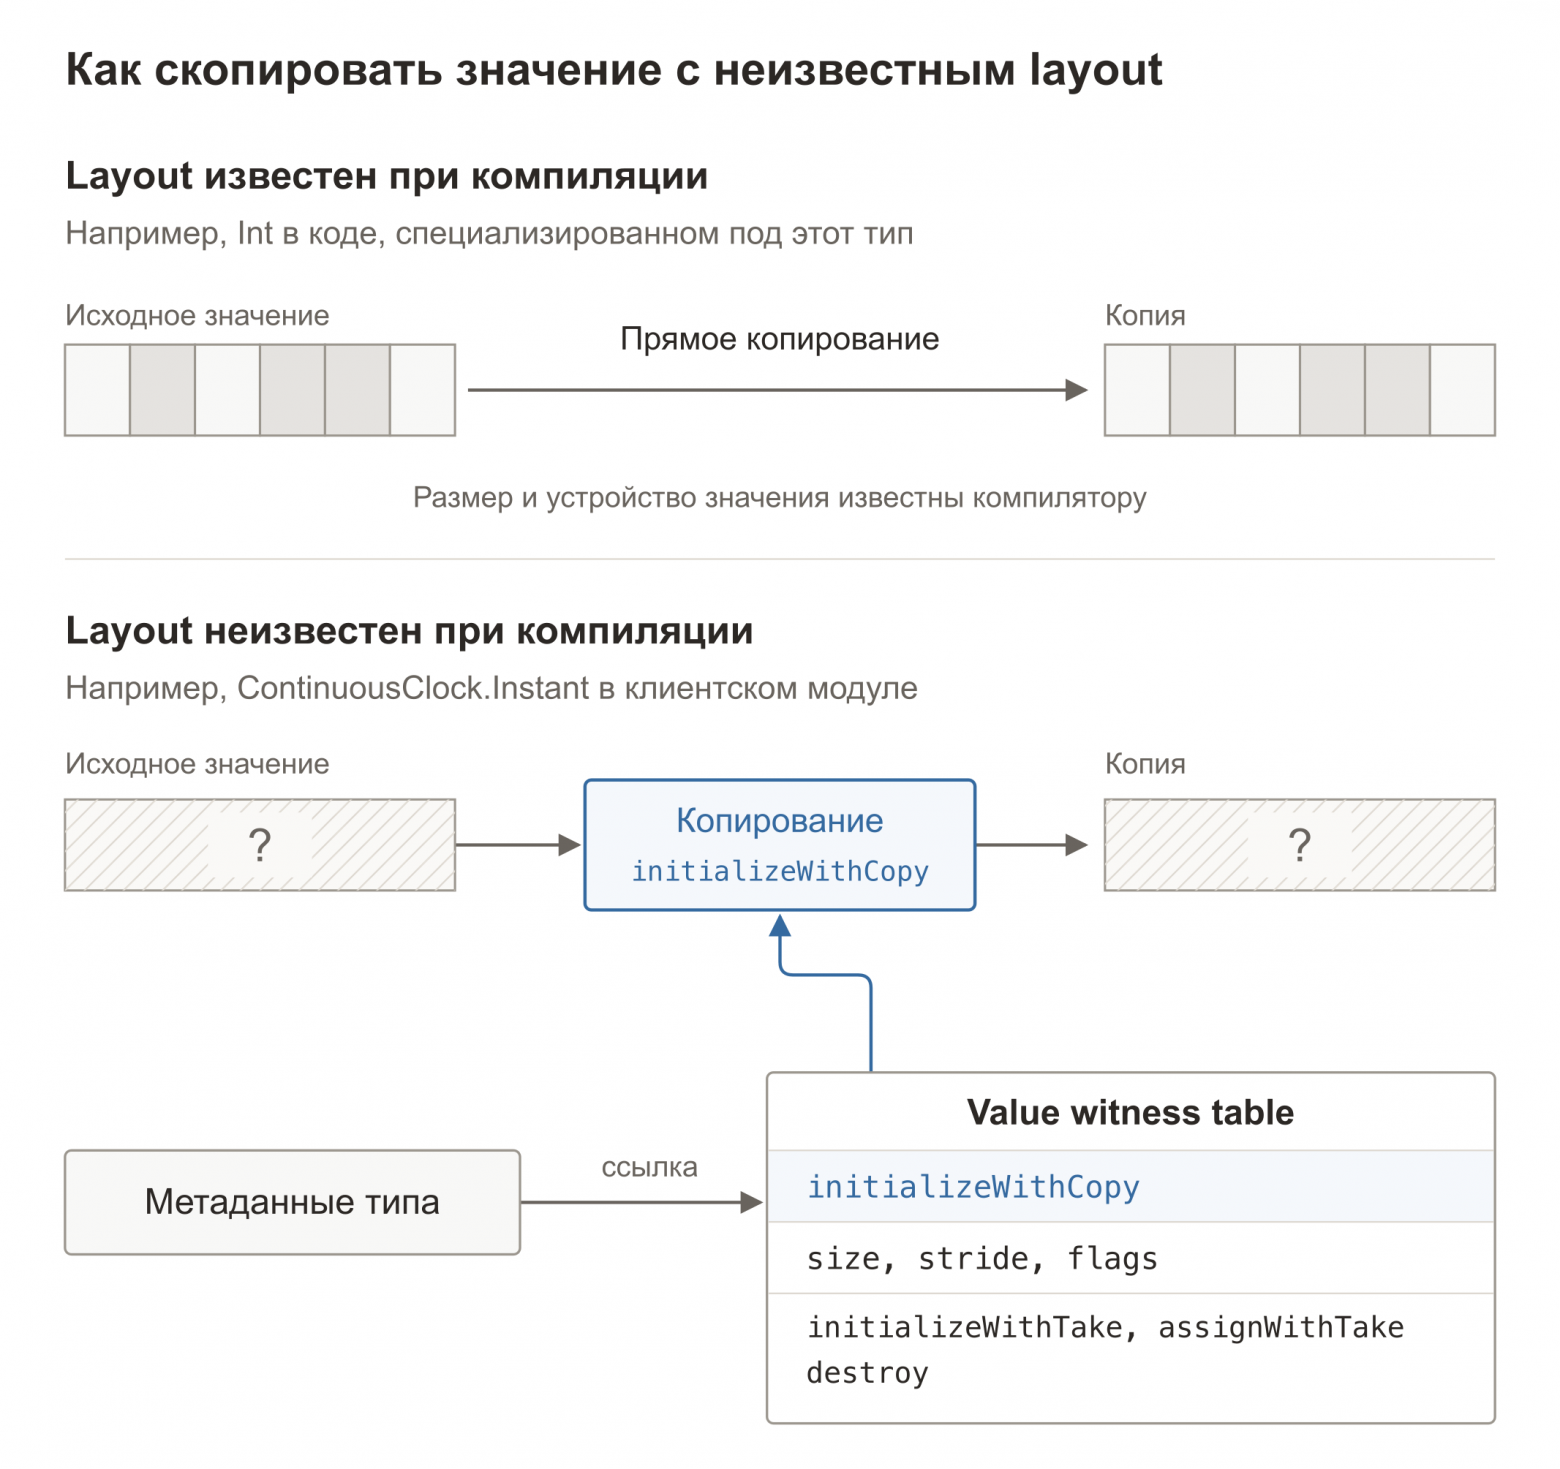
В месте вызова компилятору был известен конкретный тип Int. Однако проверка сгенерированного кода показала, что вызывалась generic-версия LongLivedTaskDebounce.emit(value:), рассчитанная на любой допустимый T.
В версии, специализированной под Int, компилятор может использовать известные размер и расположение входного значения. Layout Instant при этом остается неизвестным компилятору клиентского модуля.
При этом обращение к метаданным не означает, что на каждой отправке создается новый объект или для хранения deadline обязательно выделяется отдельный участок памяти в куче. Метаданные могут переиспользоваться, даже если код продолжает к ним обращаться.
Как профилировать самостоятельно
В репозитории есть режим profile:
cd Benchmarks
swift build -c release
.build/release/Locks profile 10 &
sample "$!" 5 1 -file debounce-sample.txt
Тест работает десять секунд; sample собирает стеки пять секунд с интервалом в одну миллисекунду. В историческом профиле исходная версия с рабочей задачей называется OptimizedDebounce. Состав символов в новом запуске может отличаться от сохраненного профиля.
Заменяем ContinuousClock.Instant на UInt64
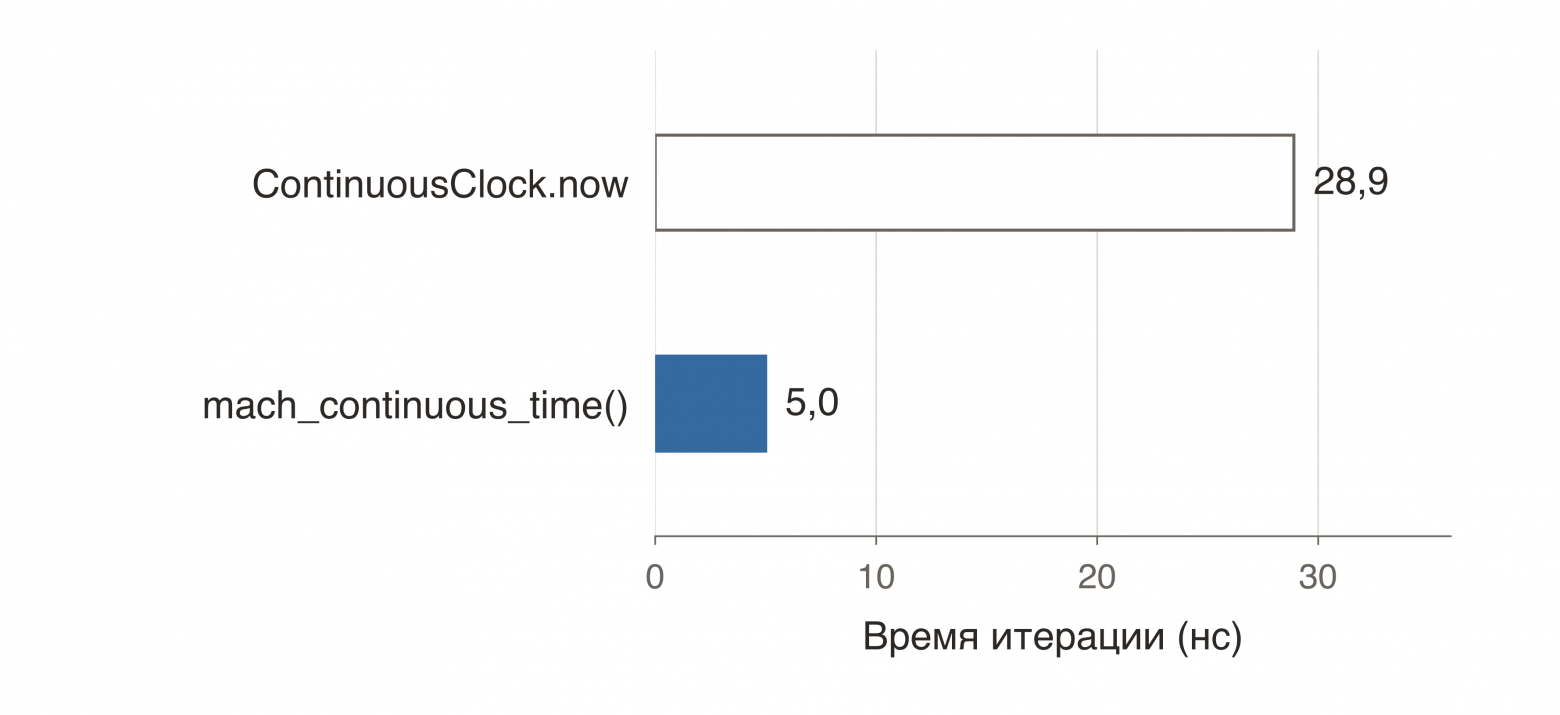
Следующим шагом я решил проверить работу со временем: как мы получаем текущее значение и храним deadline. Сначала сравнил ContinuousClock.now и mach_continuous_time(). Каждый из них вызывался в цикле. Среднее время одной итерации составило 28,9 нс для ContinuousClock.now и 5,0 нс для mach_continuous_time().
Вместо ContinuousClock.Instant я стал хранить deadline в UInt64. На Darwin текущее время теперь получаю через mach_continuous_time(). Значение deadline хранится как обычное целое число, layout которого известен компилятору.
Чтение времени и преобразование тиков
Так выглядит wrapper над часами:
@usableFromInline
enum _MonotonicClock {
    @inlinable
    @inline(__always)
    static func now() -> UInt64 {
        #if canImport(Darwin)
        return mach_continuous_time()
        #else
        var time = timespec()
        clock_gettime(CLOCK_BOOTTIME, &time)

        let secondsInNanoseconds = UInt64(time.tv_sec) &* 1_000_000_000
        return secondsInNanoseconds &+ UInt64(time.tv_nsec)
        #endif
    }
}
mach_continuous_time() возвращает время в тиках, которые не обязательно равны наносекундам. При инициализации заданная задержка debounce переводится в тики. Перед вызовом Task.sleep рабочая задача преобразует оставшееся время обратно в наносекунды. Поэтому при каждом вызове send пересчитывать единицы времени не нужно.
Я одновременно изменил способ получения текущего времени и тип deadline, поэтому по этим замерам нельзя определить, какой вклад внесло каждое изменение. При повторном профилировании я снова обнаружил обращения к метаданным. Теперь они были связаны с полем Value?, в котором сохраняется последнее значение для обработки.
Как межмодульная оптимизация влияет на специализацию generic-кода
Теперь нужно было разобраться с обновлением Value?. В тесте используется Int, но метод emit мог по-прежнему выполняться как общая generic-функция. Я проверил, поможет ли здесь межмодульная оптимизация -cross-module-optimization (CMO). Она позволяет оптимизировать код через границы модулей, в том числе создавать специализированные версии generic-функций.
Для сравнения я собрал каждую реализацию с CMO и без него. В каждом запуске тест примерно три секунды подряд вызывал emit, передавая новые значения, и подсчитывал количество вызовов.
Переработанный прототип с CMO успел выполнить около 258 млн вызовов вместо 28 млн. У исходной реализации с одной рабочей задачей результат почти не изменился: около 16 млн вызовов в обоих случаях.
Реализация | Без CMO, вызовов | С CMO, вызовов |
|---|---|---|
Прототип с | 27 580 000 | 257 900 000 |
Исходная рабочая задача | 15 770 000 | 15 680 000 |
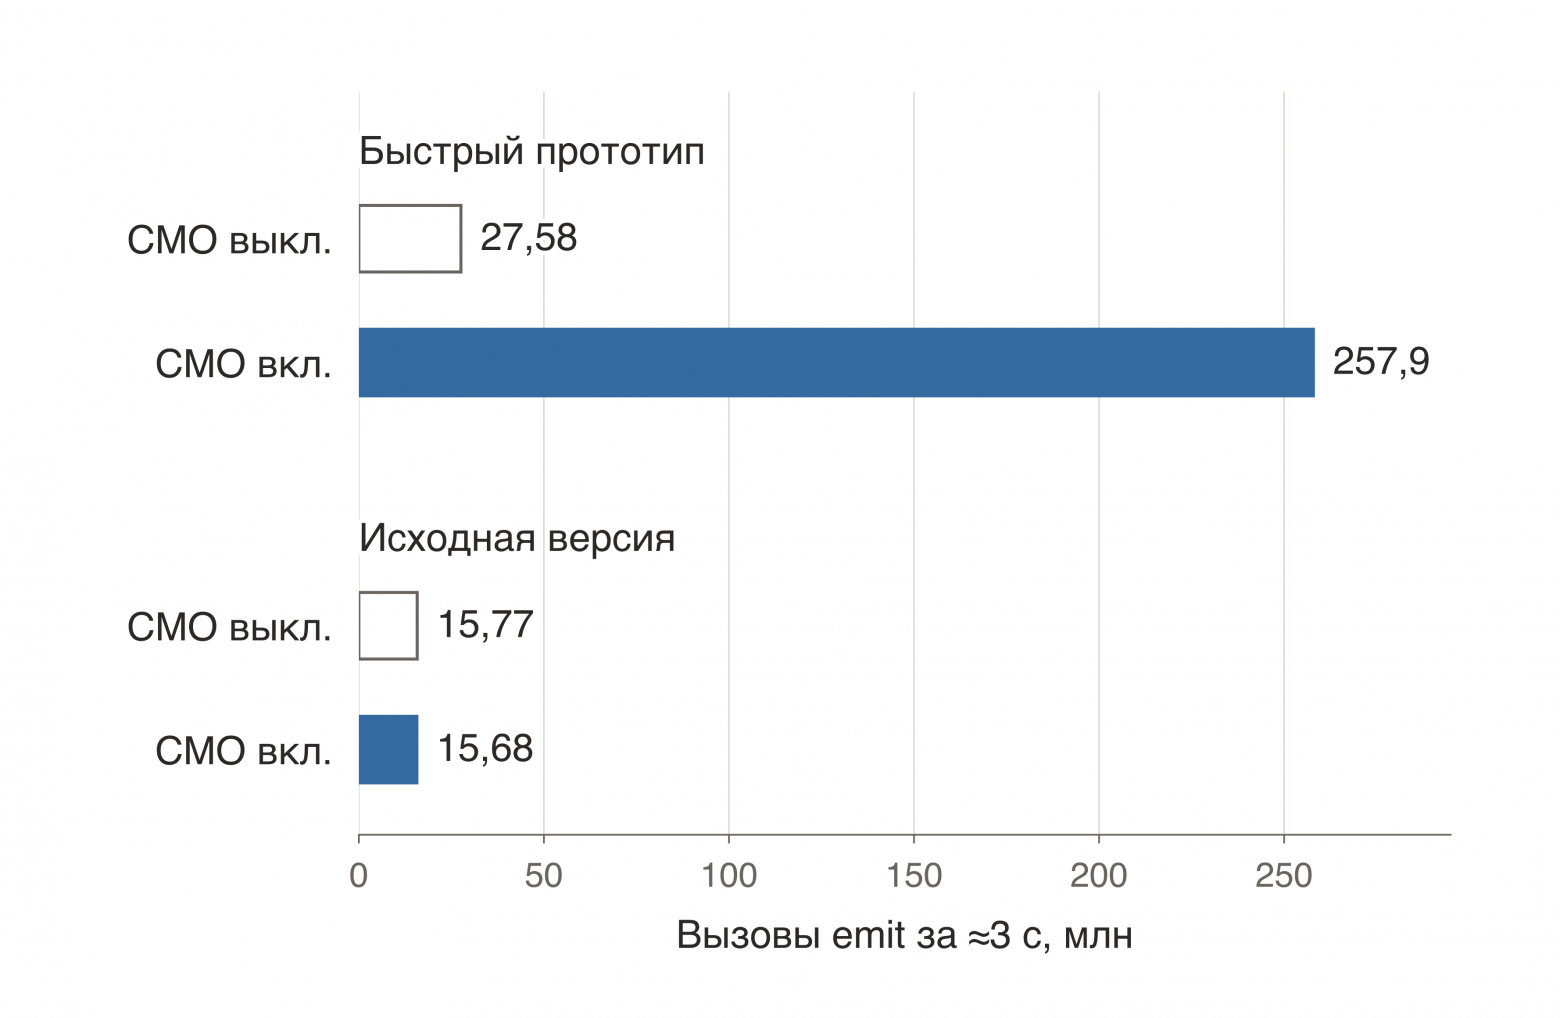
emit. Результаты эксперимента.Это измерение пропускной способности отдельного прототипа, а не еще один множитель, который можно применить к исходным 798 нс.
CMO заметно помог переработанному прототипу, но почти не повлиял на исходную реализацию. Далее, чтобы разобраться в причине, я решил проверил, какой машинный код создал компилятор.
SIL исходной реализации: generic-вызов emit
Ниже фрагмент SIL. Для читаемости я перенес длинные строки и убрал служебные комментарии после инструкций:
// function_ref LongLivedTaskDebounce.emit(value:)
%6 = function_ref @$s10References21LongLivedTaskDebounceC4emit5valueyx_tF :
  $@convention(method) <τ_0_0 where τ_0_0 : Sendable>
  (@in_guaranteed τ_0_0,
   @guaranteed LongLivedTaskDebounce<τ_0_0>) -> ()
%7 = apply %6<Int>(%4, %0) :
  $@convention(method) <τ_0_0 where τ_0_0 : Sendable>
  (@in_guaranteed τ_0_0,
   @guaranteed LongLivedTaskDebounce<τ_0_0>) -> ()
function_ref ссылается на generic-версию emit: в сигнатуре остается параметр типа τ_0_0. Следующая инструкция, apply %6<Int>, вызывает ее с типом Int. Запись <Int> здесь означает передачу конкретного типа в generic-функцию, а не вызов отдельной специализации. Несмотря на включенный CMO, в этом месте вызывается общий метод.
Один из способов оптимизации generic-кода — специализация. Компилятор создает версию функции для конкретного типа. Например, для Debouncer<Int> он может заменить общие операции над Value и Value? операциями над Int и Optional<Int>.
В отдельном эксперименте я сохранил ContinuousClock.Instant, но заменил обертку SafeStorage с NSRecursiveLock на вариант с os_unfair_lock. С включенным CMO компилятор создал специализацию emit под Int. Получается, специализация была возможна и без замены Instant на UInt64.
SIL после замены NSRecursiveLock на os_unfair_lock
Во втором варианте той же проверки я заменил блокировку внутри SafeStorage на os_unfair_lock. ContinuousClock.Instant, алгоритм debounce и параметры компиляции оставил прежними. Теперь вызывающий модуль содержит такой фрагмент:
// function_ref specialized LongLivedTaskDebounce.emit(value:)
%4 = function_ref @$s10References21LongLivedTaskDebounceC4emit5valueyx_tFSi_Tg5 :
  $@convention(method)
  (Int, @guaranteed LongLivedTaskDebounce<Int>) -> ()
%5 = apply %4(%1, %0) :
  $@convention(method)
  (Int, @guaranteed LongLivedTaskDebounce<Int>) -> ()
В комментарии к function_ref появилось specialized, а в сигнатуре вместо параметра типа указаны Int и LongLivedTaskDebounce<Int>. Инструкция apply %4 вызывает именно эту версию emit.
Вызов отдельной функции сохранился: здесь видна специализация, а не подстановка ее тела. Оба варианта собраны с включенным CMO.
Еще одна оптимизация — inlining, то есть подстановка тела функции в место вызова. Она может помочь дальнейшим оптимизациям, но специализация возможна и без нее: компилятор может создать отдельную функцию для конкретного типа и оставить ее вызов.
В swift-debounce я пометил функции, которые вызываются из send, атрибутом @inlinable. Благодаря этому их код доступен оптимизатору при компиляции модуля, использующего библиотеку. Это дает возможность выполнить inlining или специализацию, но не гарантирует их. CMO тоже может сделать тела функций доступными для оптимизации без @inlinable. Подробнее эти механизмы описаны в SE-0193.
Функция send получилась такой:
@inlinable
public func send(_ value: Value) {
    let now = _MonotonicClock.now()

    storage.withLock { state in
        let shouldStartWorker = state.machine.send(value, now: now)

        if shouldStartWorker {
            core.startWorker(&state)
        }
    }
}
Недостаточно сделать доступным оптимизатору только тело send. Операция замены trailingValue: Value? находится глубже, в машине состояний, а доступ к ней проходит через withLock. Если тела этих функций недоступны, оптимизатор не сможет проанализировать обновление состояния через эту цепочку вызовов.
Как оптимизатор видит обновление состояния
Поэтому метод withLock тоже помечен @inlinable:
@inlinable
@inline(__always)
func withLock<Result>(_ body: (inout State) -> Result) -> Result {
    withUnsafeMutablePointers { statePointer, lockElements in
        let lock = lockElements + Self.lockIndex

        _lock(lock)
        defer {
            _unlock(lock)
        }

        return body(&statePointer.pointee)
    }
}
В машине состояний новое значение обновляет deadline и заменяет сохраненное значение, если предыдущий deadline еще не наступил. Ветку else здесь опускаю:
@inlinable
mutating func send(_ value: Value, now: UInt64) -> Bool {
    let newDeadline = _deadline(after: now, adding: interval)

    if let currentDeadline = burstDeadline, now < currentDeadline {
        burstDeadline = max(currentDeadline, newDeadline)

        if edges.contains(.trailing) {
            trailingValue = value
        }
    } else {
        // Начало новой серии опущено.
    }

    if isWorkerActive {
        return false
    }

    isWorkerActive = true
    return true
}
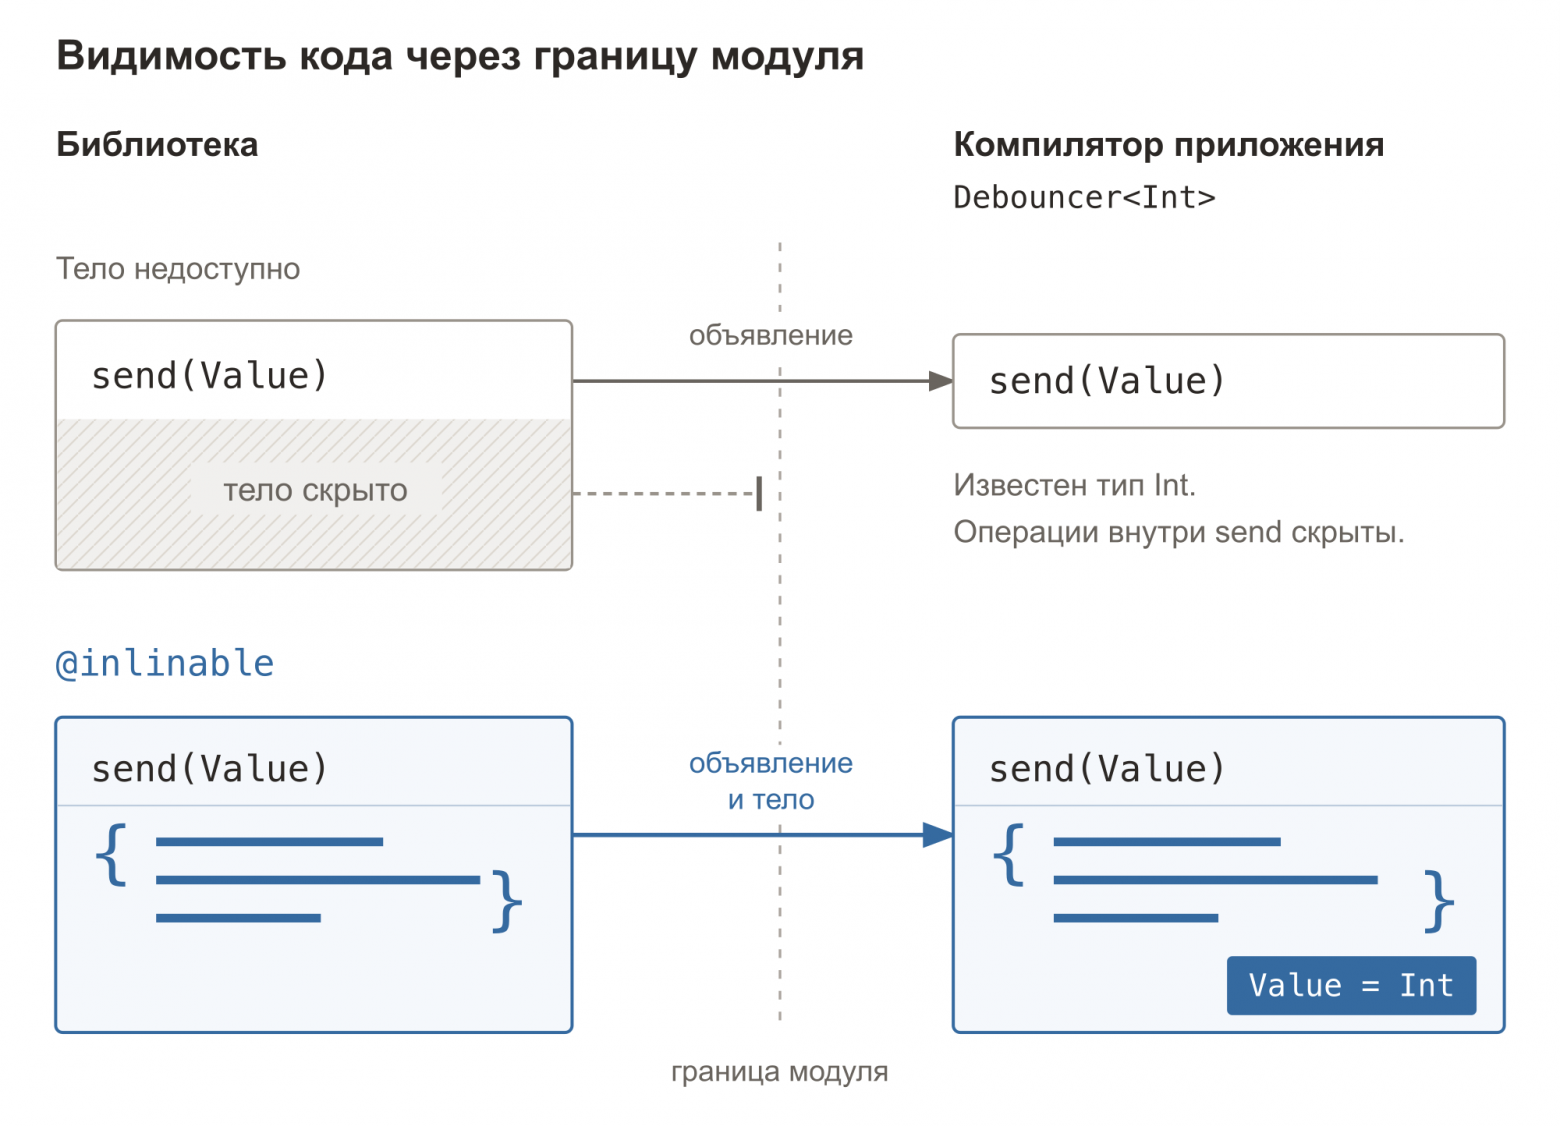
@inlinable открывает тело функции для анализа с учетом конкретного типа Int. Inlining и специализация не гарантированы; CMO тоже может обеспечить доступ к телам функций.Здесь важно различать @inlinable и @usableFromInline. Второй атрибут позволяет ссылаться на internal-декларацию из доступного клиентам тела и делает ее частью ABI. Сам по себе он не раскрывает тело функции для оптимизации.
Метод startWorker, который создает рабочую Task, помечен @usableFromInline. Это позволяет вызывать его из @inlinable-метода send, не открывая тело startWorker для оптимизации. Большинство вызовов send только обновляют состояние и до startWorker не доходят.
Как расположение блокировки в памяти влияет на производительность
На влияние расположения блокировки в памяти я наткнулся случайно, когда уже готовил репозиторий к публикации на GitHub. Я сравнивал несколько способов хранения состояния и блокировки, чтобы выбрать реализацию с поддержкой старых версий iOS.
В одном из вариантов состояние и блокировка размещались в одной аллокации с помощью ManagedBuffer. В другом память для блокировки выделялась отдельно от состояния.
При сравнении обнаружился неожиданный результат: отдельная аллокация для блокировки замедляла отправку значений из одного потока, но ускоряла ее при одновременных вызовах из нескольких потоков.
Я предположил, что при нескольких потоках помогает именно расстояние между блокировкой и состоянием. Чтобы это проверить, я оставил их в одной аллокации, но добавил между ними свободное место (padding размером 128 байт). Так можно было отодвинуть блокировку от состояния, не выделяя для нее память отдельно. В реализации хранилища положение блокировки вычисляется так:
@inlinable
@inline(__always)
static var lockIndex: Int {
    let paddingBytes = 128
    let lockStride = MemoryLayout<_PlatformLock>.stride

    return (paddingBytes + lockStride - 1) / lockStride
}
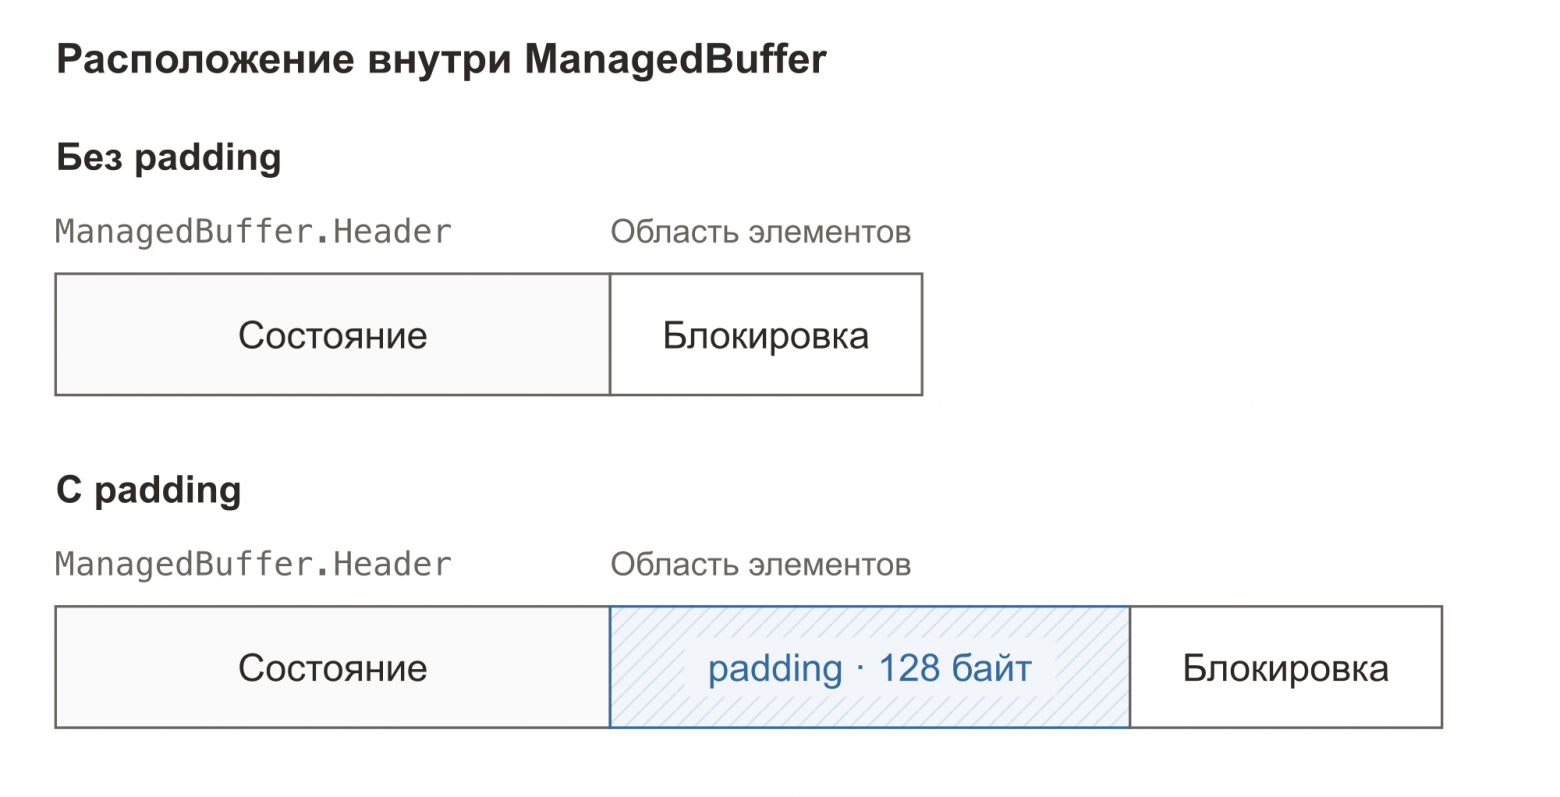
ManagedBuffer. В варианте с padding перед ней зарезервированы 128 байт. Состояние остается на прежнем месте. Размеры блоков показаны условно.При одновременной работе восьми потоков получились такие результаты:
Тест | Без padding | С padding |
|---|---|---|
Захват блокировки, увеличение счетчика и освобождение блокировки | 24,9 нс | 37,1 нс |
Вызов | 79,7 нс | 54,2 нс |
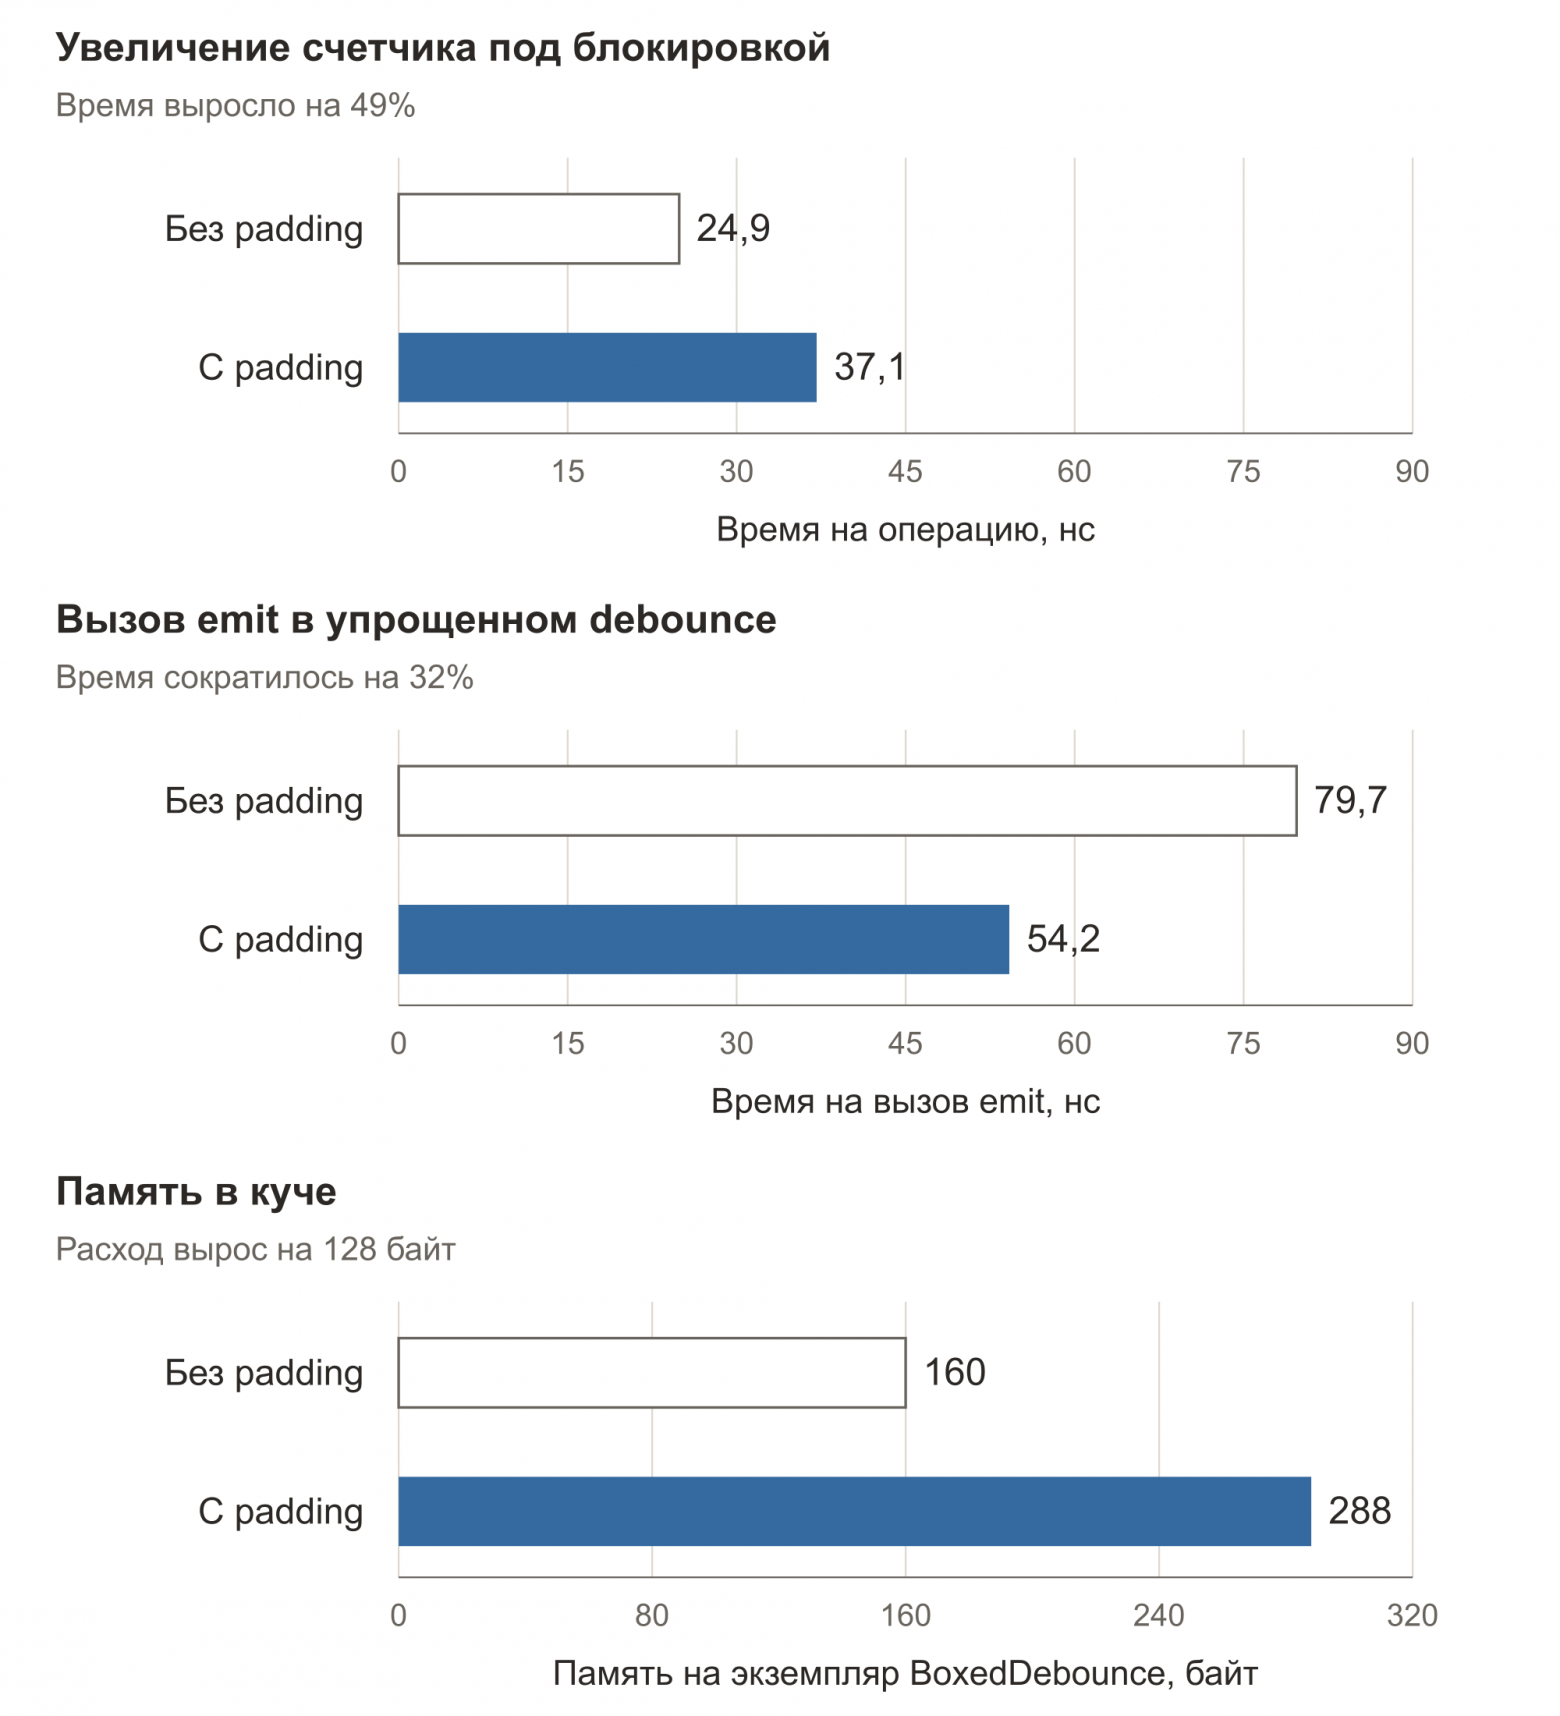
emit. При этом расход памяти вырос со 160 до 288 байт на экземпляр тестового BoxedDebounce. Для времени показаны медианы девяти запусков; в каждом запуске общее время теста делилось на число операций всех потоков. Результаты опыта с хранилищем.В тесте блокировки вариант без padding оказался быстрее: 24,9 нс против 37,1 нс. Но при вызове emit результат получился обратным: с padding 54,2 нс, без него 79,7 нс. Поэтому выбирать расположение блокировки стоит по результатам той операции, которую она защищает.
Возможная причина — это false sharing. Кэш процессора работает с блоками памяти (кэш-линиями). Если блокировка и защищаемое состояние попадают в одну кэш-линию, потоки могут мешать друг другу: один обновляет состояние, а другие в это время пытаются захватить блокировку. Padding позволяет разнести блокировку и состояние, что может уменьшить эти помехи.
Такой случай описан в документации ядра Linux. Он подходит под наблюдаемый результат, но я не проверял эту гипотезу.
Сравнение пяти вариантов хранения и разброс результатов
В тесте сравнивались пять вариантов хранения состояния и блокировки. Во всех использовалась одна и та же упрощенная реализация debounce.
Ниже показано время на один вызов emit: медиана девяти запусков, а в скобках минимальный и максимальный результаты. Память измерялась на экземпляр тестового BoxedDebounce.
Хранилище | Один поток, нс/вызов | Восемь потоков, нс/вызов | Память на экземпляр, байт |
|---|---|---|---|
| 13,2 [13,1–13,3] | 86,8 [77,5–94,3] | 128 |
| 13,1 [13,0–13,2] | 79,7 [73,7–97,7] | 160 |
| 13,2 [13,2–13,3] | 54,2 [51,9–62,6] | 288 |
| 13,1 [13,1–13,2] | 84,6 [71,3–118,8] | 160 |
Отдельная аллокация блокировки | 17,9 [17,8–18,0] | 65,7 [62,7–67,5] | 144 |
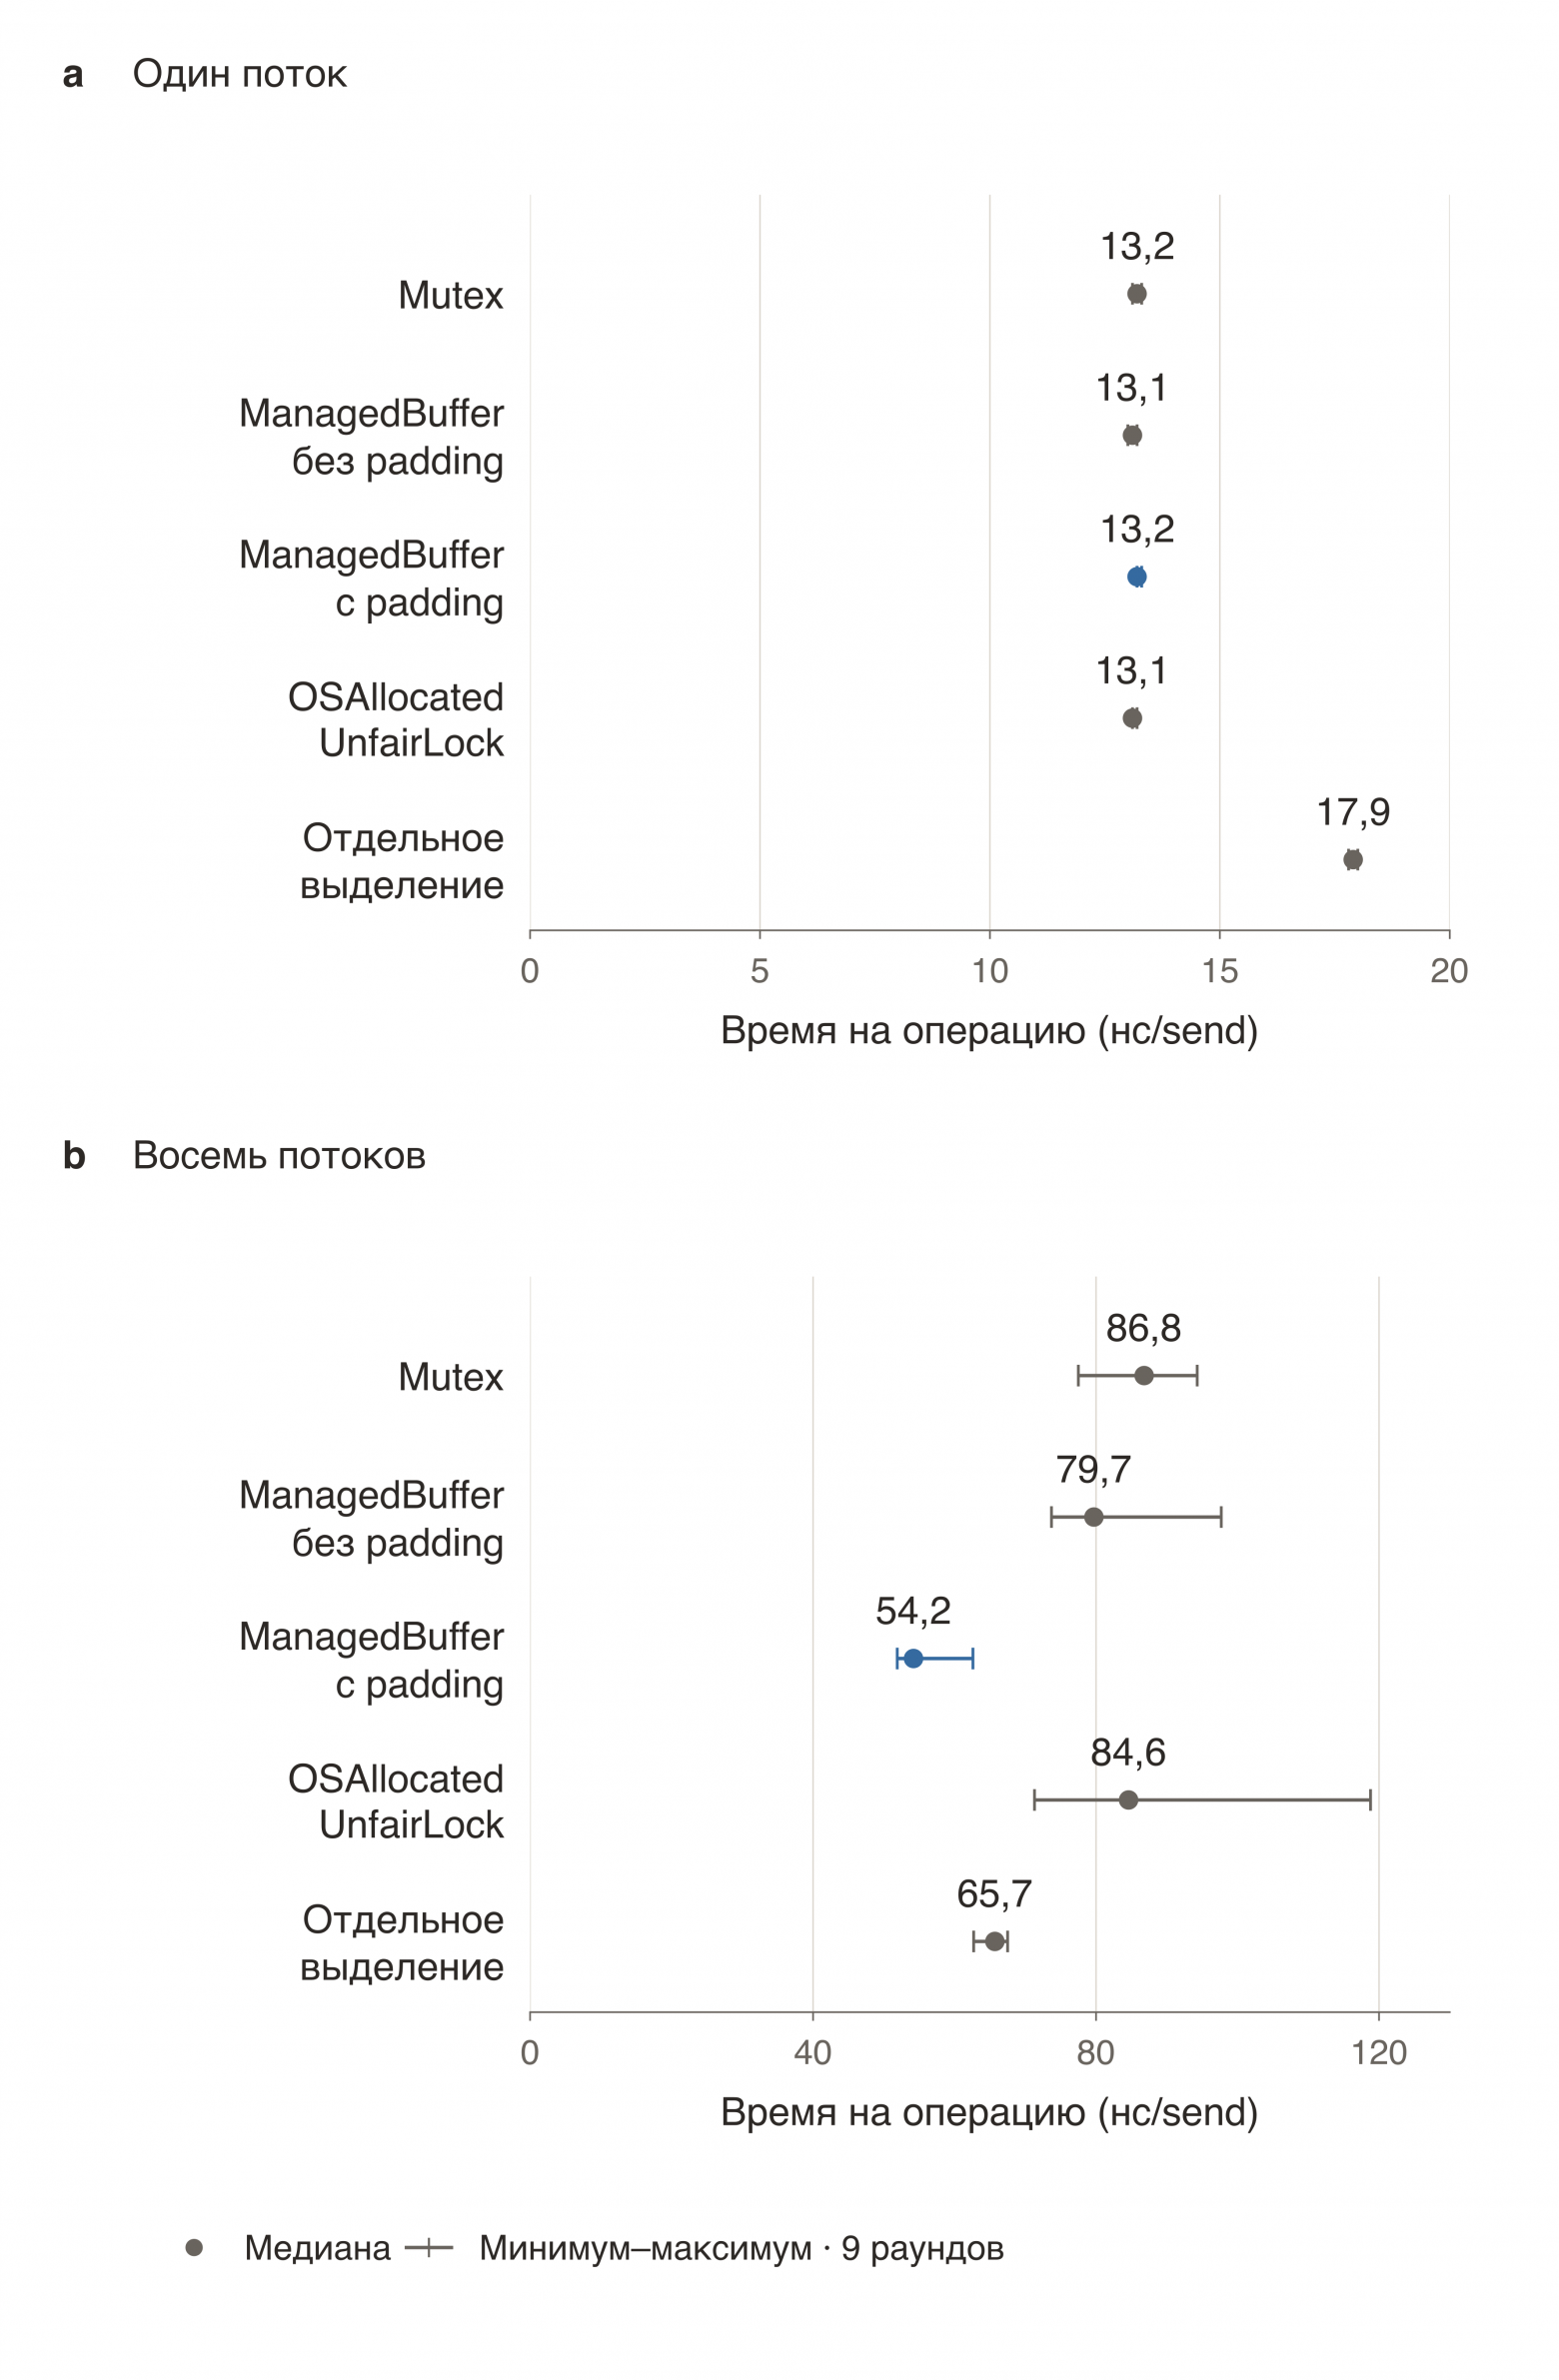
emit, в многопоточном по 100 000 из каждого из восьми потоков. Задержка debounce составляла 20 мс. Перед замерами выполнялся прогрев, затем варианты проверялись по очереди в девяти раундах. Время на вызов рассчитано по общей длительности теста и суммарному числу вызовов. Точка на графике медиана, отрезок минимум и максимум.При работе из одного потока оба варианта ManagedBuffer показали около 13 нс на вызов. При восьми потоках диапазон результатов с padding составил 51,9–62,6 нс, без padding 73,7–97,7 нс. В этих девяти запусках диапазоны не пересекались.
В swift-debounce я оставил вариант с padding. В тестах он ускорил обновление состояния при работе из нескольких потоков, практически не повлияв на результат одного потока.
Что дали оптимизации на практике
Теперь сравним три реализации: новую Task на каждое значение, одну рабочую задачу из статьи Side Effect и swift-debounce.
Реализация | Среднее время одного вызова | Время цикла отправки | CPU-время процесса |
|---|---|---|---|
| 798 нс | 79,82 мс | 280,81 мс |
Одна рабочая задача | 216 нс | 21,61 мс | 21,91 мс |
| 16 нс | 1,57 мс | 1,72 мс |
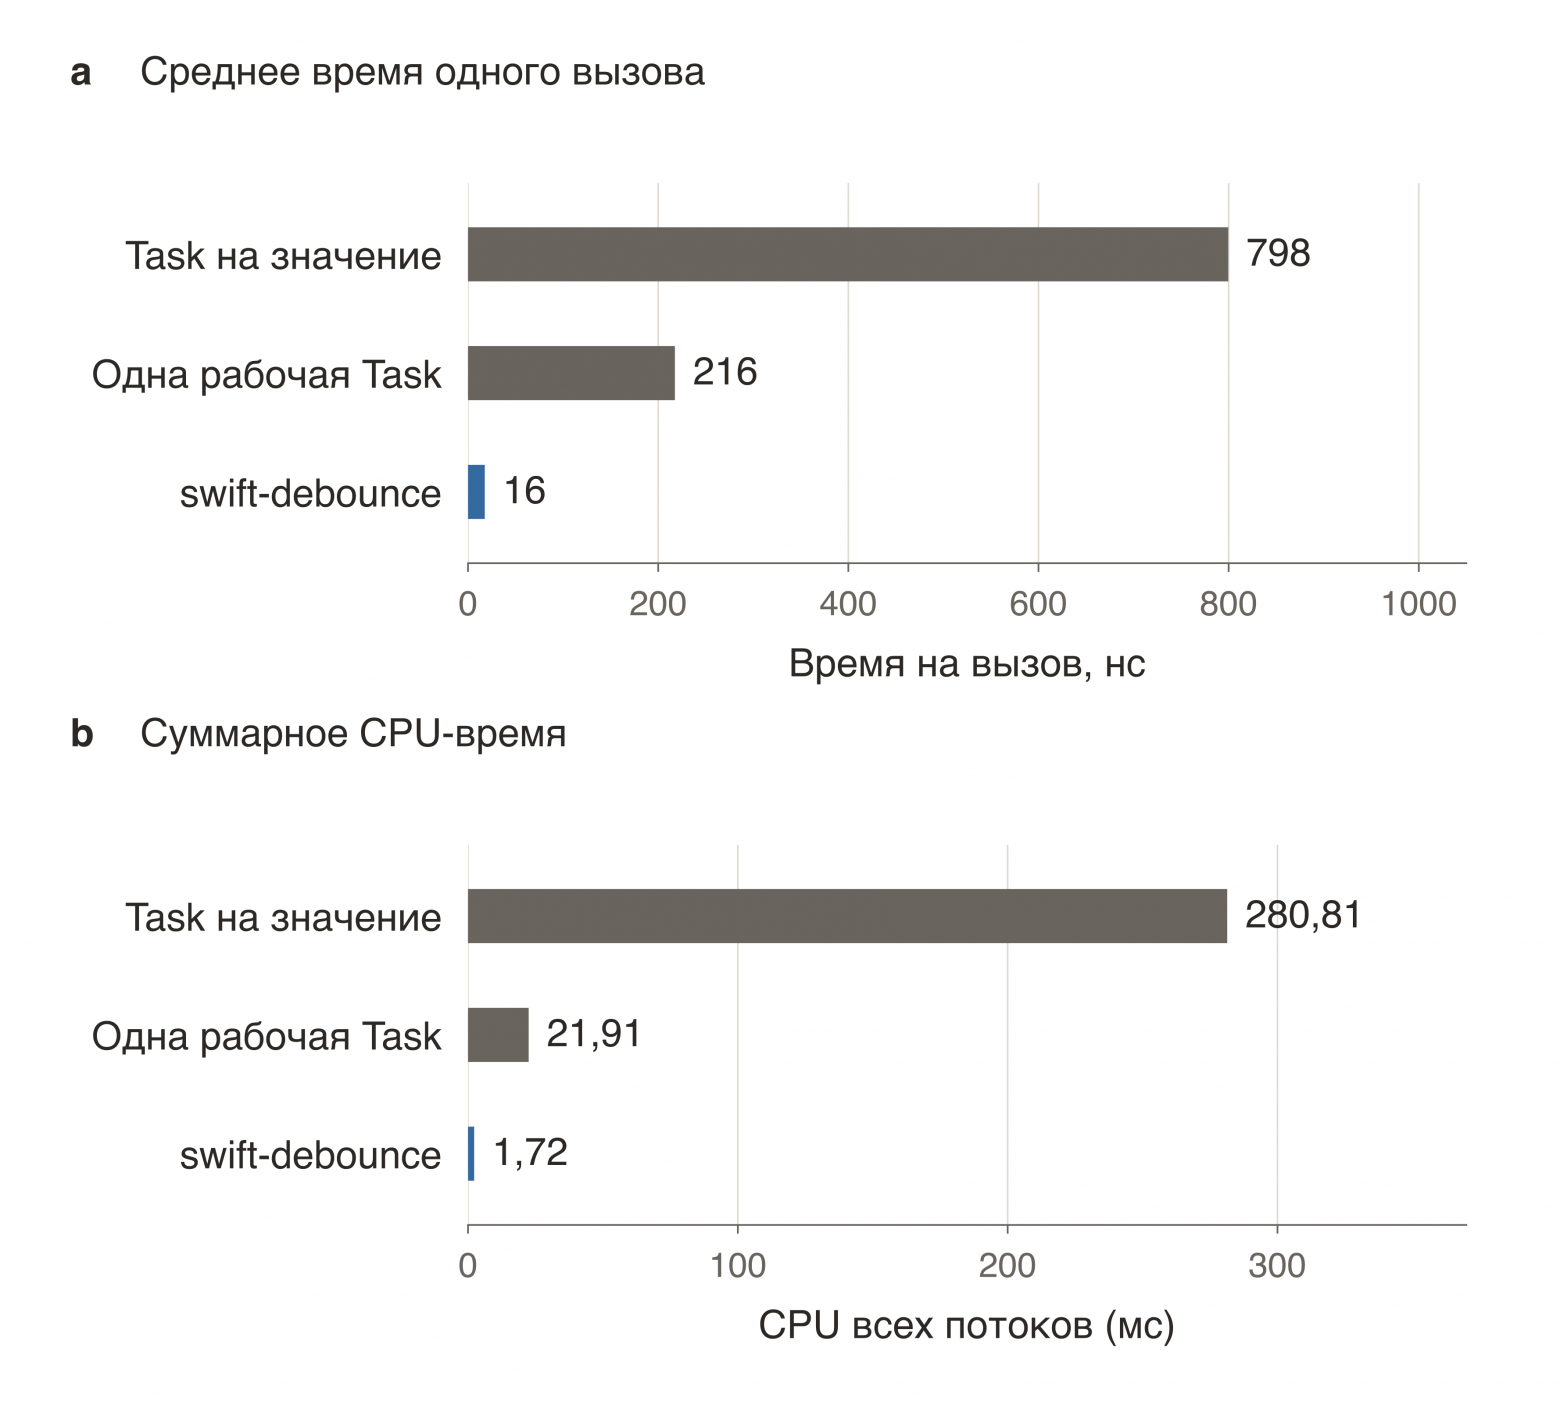
При 100 000 вызовов подряд среднее время выполнения send в swift-debounce составило 16 нс. При 1000 вызовах уже 41 нс: затраты на создание рабочей задачи распределяются на меньшее число вызовов.
Затем я проверил другой сценарий: 200 значений с интервалом 5 мс. Суммарное CPU-время составило 31,10 мс для реализации с новой Task на каждое значение, 21,65 мс для одной рабочей задачи и 21,22 мс для swift-debounce.
Здесь основную экономию дало переиспользование Task. Дополнительные оптимизации send повлияли на суммарное CPU-время гораздо меньше.
Итог
Все началось с простой идеи: перестать создавать новую Task для каждого значения. Уже это сократило среднее время отправки с 798 до 216 нс. Но мне стало интересно, куда уходят оставшиеся наносекунды. Так оптимизация debounce постепенно превратилась в исследование Swift Runtime и работы компилятора.
Больше всего меня удивило, насколько результаты могут расходиться с первоначальными ожиданиями. Я думал, что основная проблема в блокировке, но ее замена объяснила лишь небольшую часть затрат. Позже оказалось, что даже расположение блокировки в памяти влияет на результат, причем отдельный тест блокировки и обновление состояния debounce показали противоположную картину. А чтобы разобраться с остальными затратами, пришлось смотреть уже не только на Swift-код, но и на то, что из него генерирует компилятор.
В итоге в тесте со 100 000 вызовов подряд среднее время выполнения одного вызова сократилось с 798 до 16 нс, то есть примерно в 50 раз.
Для меня самое интересное в этой истории - это сколько всего обнаружилось за несколькими строками обновления состояния. Даже простой на вид метод может привести к вопросам о layout типов, специализации generic-кода и работе процессорного кэша. Получившуюся реализацию я опубликовал в swift-debounce, а код экспериментов и результаты замеров оставил в репозитории с бенчмарками.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.