Как я выгружал 1,8 TB с Яндекс Диска после аварии в дата-центрах
Всем привет!
8-11 октября после атак беспилотников пострадали три дата-центра Яндекса: Сасово, Калуга и Владимир. 11 октября Яндекс отключил в веб-версии Диска скачивание папок, альбомов и нескольких файлов сразу. У меня на Диске 1,8 TB файлов и еще около 160 GB фото в безлимите. Терять это не хочется, так что я сел делать бэкап.
План был простой: rclone, VPS в Нидерландах, Google Drive на 2 TB. На деле почти каждый шаг уперся в какую-то особенность Яндекса. Ниже по порядку: что сломалось, какие цифры получились и как обошел. Скрипты и инструкции выложил на GitHub, ссылка в конце.
rclone получает 410
Обычный путь такой: rclone config, тип yandex, вход через браузер. Авторизация проходит, rclone about показывает объем Диска. А дальше любая попытка прочитать папку заканчивается так:
2026/10/13 06:49:27 ERROR : error listing: [410 - GoneError] Gone (Ресурс больше недоступен.)
Проверил тем же токеном напрямую через REST API. Запрос /v1/disk отвечает 200, а список файлов и скачивание дают 410. То есть приложение rclone Яндекс пускает к сведениям о Диске, но не к файлам.
При этом с токеном Полигона все работает. Полигон это отладочная страница самого Яндекса для REST API, там есть кнопка “Получить OAuth-токен”. Подставил этот токен в rclone и наткнулся на вторую мелочь: backend yandex в rclone 1.75 без refresh_token не стартует.
CRITICAL: Failed to create file system for "yp:": unable to get RefreshToken.
У токена Полигона refresh_token нет. Помогла заглушка и срок действия в далеком будущем, тогда rclone не пытается обновить токен:
[yandex]
type = yandex
token = {"access_token":"<токен Полигона>","token_type":"OAuth","refresh_token":"unused","expiry":"2099-01-01T00:00:00Z"}
Токен Полигона дает полный доступ к Диску и живет примерно год. После выгрузки его лучше отозвать.
Где фото из безлимита
При безлимитной автозагрузке фото с телефона не лежат в папке “Фотокамера”, их видно только в разделе “Фото”. Решил проверить, видит ли их API.
В ответе /v1/disk есть поле photounlim_size, у меня там 162 734 452 732 байта. А сами файлы не достать:
GET /v1/disk/resources?path=photounlim:/
{"error": "DiskAreaDoesNotExistsError", "description": "Specified area \"photounlim\" does not exist"}
WebDAV на /photounlim/ отвечает 404, в плоском списке файлов API их тоже нет. Значит, ни rclone, ни другая программа для бэкапа эти фото не скопирует.
Выход один: перенести их в обычную папку Диска. Тогда они начнут занимать место в тарифе, но станут видны. Проверил на одном видео: used_space вырос на 10 911 965 байт, photounlim_size уменьшился на столько же.
В вебе за раз можно выделить не больше 500 фото, а у меня их около 30 тысяч. Поэтому перенес пару фото руками и посмотрел в сетевом журнале браузера, какие запросы уходят. Веб-версия ходит в https://disk.yandex.ru/models-v2, нужные методы такие:
intapi/photo-init-snapshot                 id снимка раздела "Фото"
intapi/photo-get-snapshot                  кластеры по датам, у каждого счетчик photounlim
intapi/photo-get-clusters-with-resources   файлы кластеров, пути /photounlim/<имя>
mpfs/bulk-async-move                       перенос: [{src, dst, force: 0}]
mpfs/bulk-operation-status                 статус: WAITING, потом DONE
Скрипт yd.js подключается к браузеру и вызывает эти методы через fetch прямо из открытой вкладки. Cookies и TLS остаются браузерные, для Яндекса это обычная работа в вебе.
Пачка из 50 файлов не прошла:
HTTP 400: {"error":{"type":"http","code":400,"message":"Duffman model validation error: Too many items"}}
Пачка из 40 проходит. Перемещения Яндекс выполняет по очереди, выходит примерно 85-120 файлов в минуту. Всего 30 738 фото перенеслись примерно за 6 часов, 49 не перенеслись с ошибкой 500 на стороне Яндекса.
Половина файлов не отдается
Запустил копирование, и за первые 5 минут rclone не скопировал ни байта. Все потоки висели на открытии файлов.
Сделал выборку из 300 случайных файлов и попробовал скачать первые 64 KB каждого через REST. Отдались 146. Через несколько минут повторил на той же выборке, результат тот же, статус сменил один файл. Значит, это не случайные сбои под нагрузкой, а стабильно недоступные файлы.
Скачивание идет по цепочке: запрос ссылки в API, ссылка на downloader.disk.yandex.ru, редирект на узел хранения. Посмотрел, куда ведут редиректы:
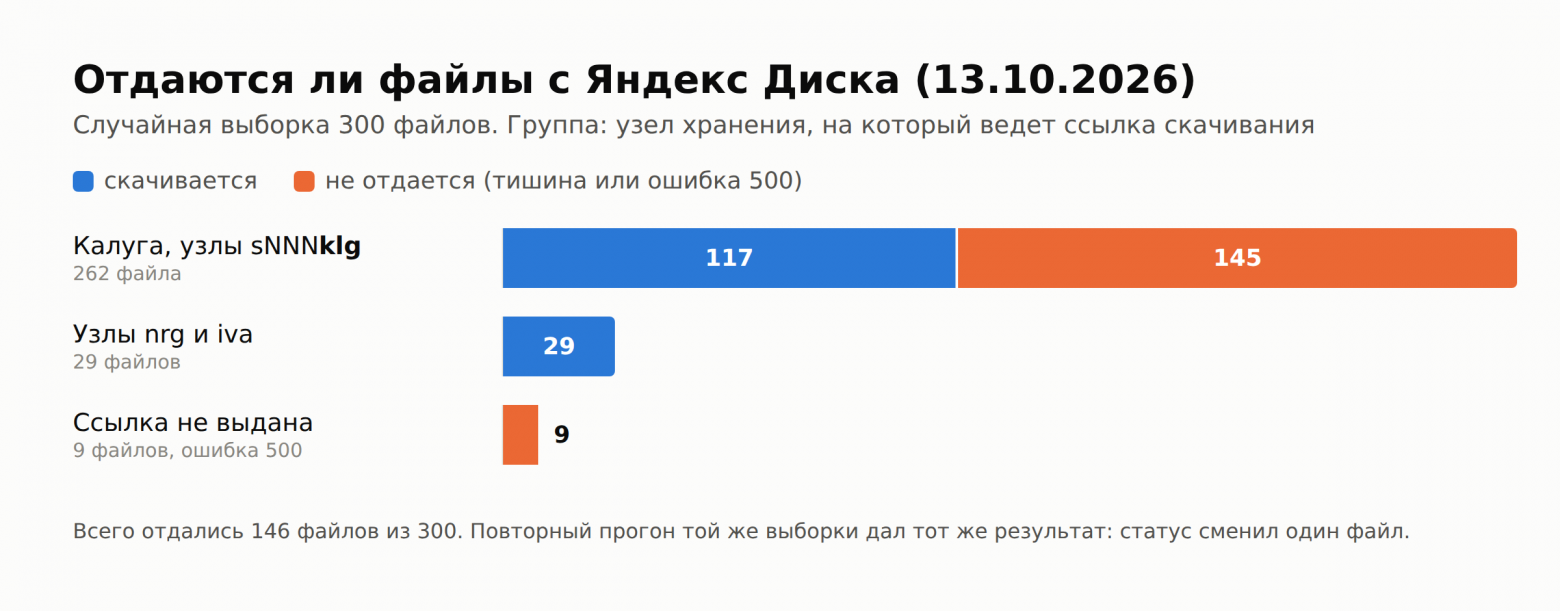
Почти весь мой Диск лежит на узлах с суффиксом klg, скорее всего это Калуга. Из 262 файлов там отдались 117. Узел принимает соединение и молчит, rclone ждет ответа до тайм-аута.
Отсеять мертвые файлы заранее по имени узла не получилось. Из 225 узлов в выборке 31 оказался смешанным: часть файлов с него отдается, часть нет.
О потере данных Яндекс не сообщал. Так что я исхожу из того, что эти файлы сейчас просто недоступны, и докачиваю их повторными запусками.
Как настроил копирование
Сначала пробовал WebDAV. Под нагрузкой он отвечает 503 и рвет соединения. На одних и тех же доступных файлах WebDAV дал примерно 0,2 MB/s на поток, REST примерно 0,8 MB/s. Плюс REST отдает MD5 каждого файла, а WebDAV хешей не отдает, так что дальше все через REST.
По умолчанию rclone ждет ответа 5 минут и повторяет запрос 10 раз. На мертвом файле поток стоит десятки минут, и копирование встает. К тому же к середине дня Яндекс стал выдавать ссылку на скачивание от 1 до 60 секунд, иногда с ошибкой 500. Причем и тогда, когда моя заливка стояла на паузе.
Подобрал такие параметры:
rclone copy yandex: gdrive:Yandex-backup --checksum \
  --transfers 64 --checkers 8 --tpslimit 20 \
  --timeout 60s --contimeout 15s --low-level-retries 2 --retries 1 \
  --drive-stop-on-upload-limit
Мертвый файл теперь отваливается за 1-2 минуты, а доступный, но медленный успевает. Все, что не скопировалось, видно в логе, повторный запуск докачивает только недостающее. Только copy, никакого sync: sync удаляет в копии то, чего нет на Диске.
Крутится это на VPS в Docker. 64 потока занимают около 310 MB памяти и до 40% одного ядра. На крупных файлах выходило до 33 MB/s. Каждую ночь cron запускает копирование заново и подбирает то, что Яндекс успел вернуть.
Для первой заливки сделал фильтр: из логов собирается список мертвых файлов, и повторный проход их пропускает. Так я сначала спас самые важные папки, а не ждал тайм-аутов.
Со стороны Google два момента. Общий client_id rclone для Google Drive в 2026 году выводят из эксплуатации, нужен свой из Google Cloud Console. Приложение в консоли надо перевести в “In production”, иначе токен перестанет работать через 7 дней. Еще Google принимает не больше 750 GB в сутки, так что 1,8 TB заливаются минимум три дня.
Проверка
У Яндекса и у Google Drive есть MD5, поэтому сверка идет без скачивания:
rclone check yandex: gdrive:Yandex-backup --one-way --missing-on-dst missing.txt --differ differ.txt
По самой важной для меня папке с документами вышло так. В ней 5 394 файла, 2 315 уже в Google и совпали по MD5, расхождений ноль. Остальные 3 079 лежат на недоступных узлах и ждут ночных запусков.
А как же приложение Яндекс Диска
С 3 июня 2026 года приложение для Windows и macOS синхронизирует файлы только с подпиской Яндекс 360. Без подписки в нем открываются лишь файлы, которые уже сохранены на компьютере.
Если подписка есть, приложение годится для простой копии на этом же компьютере. Но это двусторонняя синхронизация: удалилось на Диске, удалится и у вас. Списка того, что не скачалось, оно не показывает, сверки по MD5 в нем нет. Для фото из безлимита у него, правда, есть своя опция “Копировать фото и видео на компьютер”.
Что получилось
Файлы Диска копируются в Google Drive через REST с токеном Полигона, копия сверяется по MD5.
Фото из безлимита перенесены в обычную папку, 30 738 из примерно 30 800.
Примерно половина файлов пока недоступна, их подбирает ночной запуск.
Все это собрал в репозиторий: скрипты подключения и копирования для Windows и Linux/macOS, yd.js для безлимита, вариант для VPS и инструкции по шагам. Проверял на Windows PowerShell 5.1, в WSL и на VPS.
https://github.com/KenGuru66/yandex-disk-rescue
Если у кого-то файлы с калужских узлов начали отдаваться, напишите в комментариях. Интересно понять, восстанавливает Яндекс хранилище или нет.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.